影刀RPA飞书CRM集成教程:用影刀+飞书搭建零代码客户管理系统——从数据采集到自动跟进
影刀RPA飞书CRM集成教程:用影刀+飞书搭建零代码客户管理系统——从数据采集到自动跟进
我第一次做客户管理的时候,用Excel记客户信息,记录多了之后找人找半小时,跟进日期经常忘记。后来用影刀+飞书多维表格搭了一套客户管理系统,所有客户信息自动入库,到期自动提醒跟进,整个流程省了80%的重复手工操作。这篇文章就讲这套系统怎么搭。
一、认识飞书多维表格
飞书多维表格不是普通的在线表格,你可以把它理解成"轻量级数据库"。它支持字段类型(文本/数字/日期/单选/多选/附件/人员等)、视图切换(表格/看板/日历/甘特图)、表单收集、自动化规则、权限管理等。
用飞书多维表格做CRM的好处:
- 不用自己搭数据库(省掉数据库安装、建表、连接那些麻烦事)
- 飞书自带通知功能(客户状态变化了自动通知负责人)
- 手机端可以直接查看和编辑,出差也能用
- 完全免费(1000条记录以内,够个人和小团队用了)
影刀操作飞书多维表格的方式有两种:
- 飞书开放平台API:用HTTP请求指令直接调飞书的OpenAPI接口。需要先在飞书开放平台创建应用、获取tenant_access_token。适合复杂场景,比如批量操作。
- 影刀自带的飞书指令:影刀内置了一些飞书相关的指令,比如"发送飞书消息"、"操作飞书多维表格"等。适合简单场景,不需要申请API权限。
本文以API方式为主,因为API方式最灵活,学会了之后所有飞书产品都能操作。
二、元素定位——XPath和CSS的基础应用
虽然我们主要用API操作飞书数据,但CRM的数据来源可能是各种网页(企查查、天眼查、招聘网站等),所以元素定位的基础要牢。
XPath 6种写法速查:
//tag[@属性='值']——精确属性定位//tag[text()='文本']——精确文本定位(文本固定场景专用)//tag[contains(@属性,'部分值')]——模糊属性定位(最常用,因为URL或者class经常是动态的)//父/子——相对路径定位(定位到某个元素下面的子元素)(//tag[@属性='值'])[N]——位置索引(注意括号)//tag[@属性1='值' and @属性2='值']——多条件组合
CSS选择器 8种语法速查:
#id值——id选择器.class值——class选择器[属性='值']——属性选择器父 子——后代选择器(空格隔开)父 > 子——直接子元素:nth-child(N)——位置伪类.class1.class2——多class*——通配符(慎用,匹配太多会慢)
实际场景举例:从天眼查抓取企业信息
// 抓取企业名称
//h1[@class='company-name']/text()

// 抓取法人代表(用contains模糊匹配)
//span[contains(@class,'legal-person')]/text()

// 抓取第3条股东信息(用位置索引)
(//div[@class='shareholder-item'])[3]//span[@class='name']/text()
从天眼查抓数据有个坑:页面上的元素class名经常带空格(比如 class="company-name active"),用XPath的contains()远比精确匹配稳。我第一次用@class='company-name active'定位,换了个页面就失效了,后来改成contains(@class,'company-name')就好了。
三、变量与数据类型——CRM数据结构的基石
CRM的数据是结构化的,变量类型选择直接影响后续处理。
列表是CRM里用得最多的数据类型。客户列表、跟进记录列表、订单列表——全部是列表。一个典型的客户数据在影刀里是这样的:
customer = {
    "公司名称": "某某科技有限公司",
    "联系人": "张三",
    "电话": "13800138000",
    "行业": "电商",
    "跟进状态": "已联系",
    "下次跟进日期": "2024-06-15",
    "备注": "对方说下个月再联系"
}
一个字典就是一个客户,多个客户就是一个列表:
customer_list = [customer1, customer2, customer3, ...]
这种结构的好处是后续写入飞书多维表格的时候,可以直接用ForEach列表循环逐条写入。
JSON的转换也很重要。飞书API返回的数据是JSON格式,比如查询一条多维表格记录返回的是:
{
  "code": 0,
  "data": {
    "items": [
      {
        "record_id": "recxxxx",
        "fields": {
          "公司名称": "某某科技",
          "跟进状态": "已联系"
        }
      }
    ]
  }
}
你要用"JSON转字典"指令把它转换成影刀的字典类型,才能操作里面的值。
我第一次处理飞书API返回的数据时,直接打印了整个JSON对象,屏幕刷了上百行,根本找不到我要的数据。后来养成了习惯:先用"获取字典值"指令取到data.items,再用ForEach循环逐个打印fields里的关键字段。
四、流程控制——客户自动分派和跟进提醒
拼多多店群自动化报活动上架!
流程控制在CRM里主要用在两个场景:客户自动分派、跟进到期提醒。
客户自动分派:批量导入客户之后,根据行业、地区、规模等条件自动分派给不同的销售人员。
# 伪代码逻辑
for 每个客户 in 客户列表:
    if 客户["行业"] == "电商":
        分派给 销售A
    elif 客户["地区"] == "华南":
        分派给 销售B
    else:
        分派给 销售C
在影刀里用"If条件判断"指令实现。注意:If条件判断是可以嵌套的,比如"行业是电商 AND 规模>100人"这种多条件判断。
跟进到期提醒:每天自动检查哪些客户的"下次跟进日期"到了今天,把名单列出来发飞书消息。
# 伪代码逻辑
今天 = 获取当前日期()
到期客户列表 = []
for 每个客户 in 全部客户:
    if 客户["下次跟进日期"] == 今天:
        到期客户列表.append(客户)

if 到期客户列表不为空:
    发送飞书消息(到期客户列表)
影刀获取当前日期的指令是"获取当前时间",保存为一个日期变量。但有个坑:有些API返回的日期格式是时间戳(比如 1718323200000),需要转换一下才能跟"获取当前时间"的结果做比较。
While循环在CRM里也有用——比如轮询飞书API查询某条记录的状态变化,直到状态变成"已完成"才退出循环。但While循环一定要加最长循环次数保护,避免API返回的数据不对导致死循环。我在第900次采集中吃过这个亏——循环条件一直不满足,流程卡了半小时都没退出。
五、网页自动化——从企业信息网站采集客户数据
CRM的数据来源往往是各种网页:企查查、天眼查、智联招聘、展会网站等等。网页自动化的能力决定了你能采集到多少客户数据。
等待策略(3种):
- “等待元素出现”:等页面加载出目标元素(最常用,超时时间建议设10秒)
- “等待页面加载完成”:等整个页面加载完(不够精确,有些页面加载完了但内容还在异步渲染)
- “固定等待”:硬等N秒(最不推荐,但如果前两种都不管用,这是最后的保底方案)
弹窗处理(5步标准流程):
- 打开网页后,立刻判断是否有弹窗(用"判断元素是否存在"指令)
- 如果存在 → 点击关闭按钮
- 如果找不到关闭按钮 → 点弹窗外的空白区域
- 如果弹窗是"登录/注册"弹窗 → 判断是否需要登录,不需要就直接关掉
- 如果弹窗怎么都关不掉 → 刷新页面试试
有个"盲点弹窗"新手很容易漏掉:浏览器的"通知权限"弹窗。这个弹窗不是网页弹出来的,是浏览器的系统弹窗,用影刀的网页指令关不掉。解决办法:在"启动浏览器"的启动参数里加上 --disable-notifications,一劳永逸。
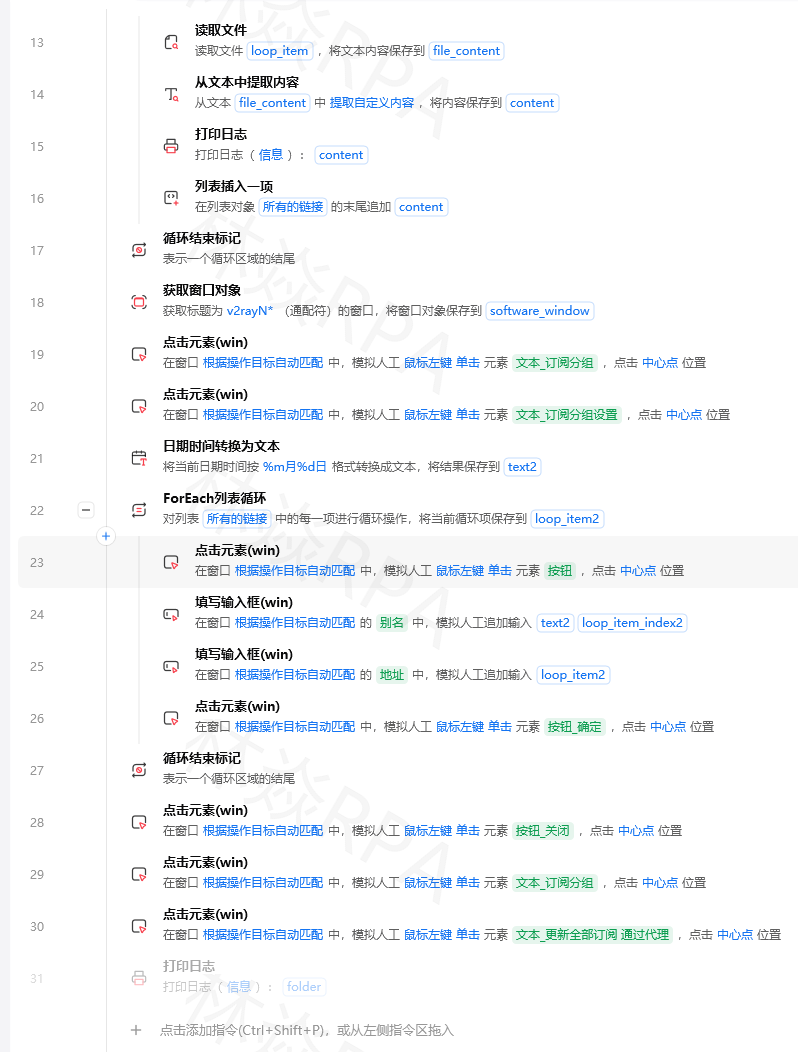
翻页:采集客户列表的时候,往往要翻很多页。不确定总页数的情况用disabled class判断——在"翻到下一页"之后,判断"下一页"按钮的class里有没有disabled,如果有就说明已经到最后一页了,退出循环。
# 伪代码
while True:
抓取当前页的客户数据
点击"下一页"
等待500毫秒
next_button = 获取下一页按钮的属性("class")
if "disabled" in next_button:
break # 已经到最后一页了
我第一次写翻页逻辑的时候,判断条件写的是"下一页按钮不存在",结果有些网站的"下一页"按钮在最后一页也存在,只是变成灰色不可点击。判断逻辑不对,循环就一直跑,直到超时报错。
六、数据处理——批量导入客户到飞书多维表格
数据采集完了,要批量写到飞书多维表格里。
飞书API写入一条记录:
POST https://open.feishu.cn/open-apis/bitable/v1/apps/{app_token}/tables/{table_id}/records
Headers:
  Authorization: Bearer {tenant_access_token}
Body:
{
  "fields": {
    "公司名称": "某某科技有限公司",
    "联系人": "张三",
    "电话": "13800138000",
    "行业": "电商",
    "跟进状态": "待联系",
    "下次跟进日期": 1718323200000
  }
}
这里有3个关键点:
1. tenant_access_token的获取。飞书API调任何接口都需要先获取token,token有效期2小时,过期要重新获取。在影刀里,每次批量写入之前都重新获取一下token(省得token过期了报错你还不知道)。
获取token的API:
POST https://open.feishu.cn/open-apis/auth/v3/tenant_access_token/internal
Body: {"app_id": "你的app_id", "app_secret": "你的app_secret"}
返回的tenant_access_token就是后面要用的token。
2. 批量写入的频率控制。飞书API有频率限制(一般是每秒10次),如果你一口气发500条请求过去,后面200条全部返回429(请求太频繁)。在影刀里,每条写入之后加一个"等待200毫秒"的指令,就能避开限流。
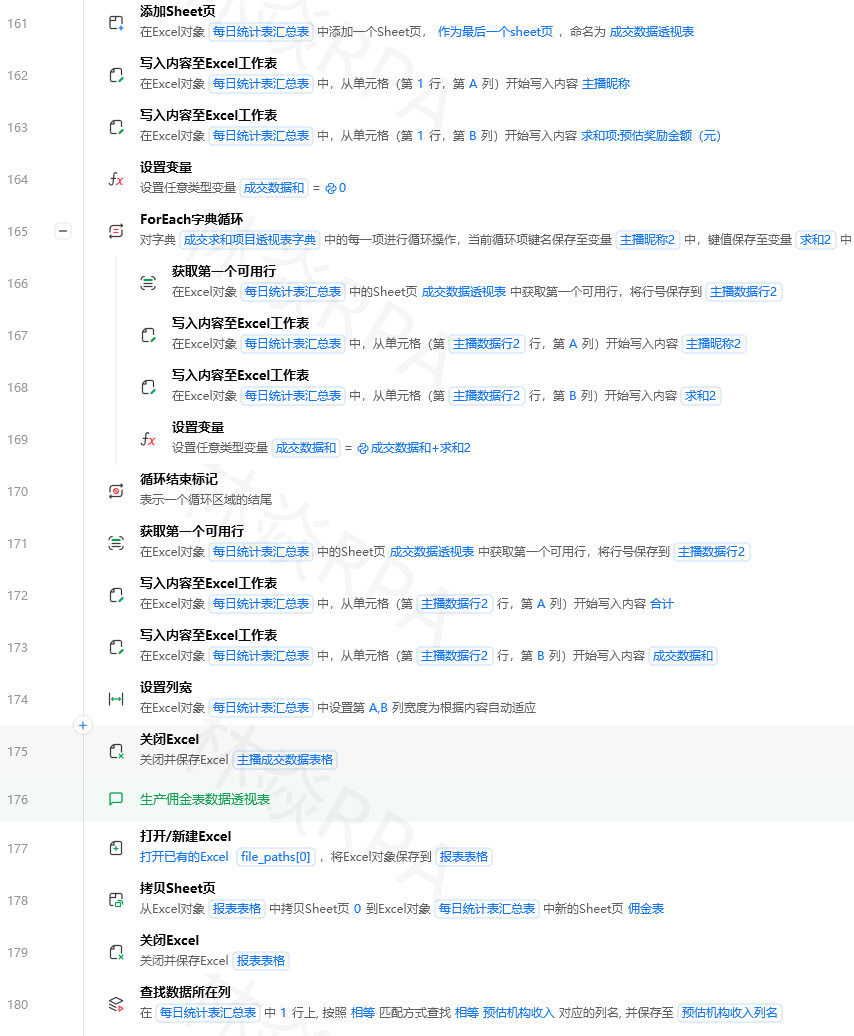
3. 日期格式转换。影刀的日期变量格式是2024-06-15,但飞书多维表格的日期字段存的是时间戳(1718323200000)。写入之前要转换一下。用Python做转换最方便:
def main(args):
from datetime import datetime
date_str = args.get('date', '')
dt = datetime.strptime(date_str, '%Y-%m-%d')
timestamp = int(dt.timestamp() * 1000)
return {'timestamp': timestamp}
常见报错:
- “app not exists”:app_token填错了
- “table not found”:table_id填错了
- “invalid field”:字段名跟飞书多维表格里定义的不一致(大小写也要一致)
- “Token expires”:token过期了,重新获取
- “Rate limited”:请求太频繁,加等待
七、鼠标键盘图像自动化——登录飞书/处理验证码
调飞书API需要app_id和app_secret,前提是你已经在飞书开放平台创建了应用。创建应用的流程需要手动登录飞书管理后台,这个过程不能用API,要用图像识别或者模拟操作。
如果你需要自动登录飞书管理后台(比如定时刷新token),流程是这样的:
- 用"启动浏览器"打开
https://open.feishu.cn/ - 用"点击网页元素"点"登录"按钮
- 用"填写输入框"填入手机号
- 如果有验证码——用"OCR文字识别"识别验证码图片中的数字
- 用"填写输入框"填入验证码
图像识别在登录场景的用法:有时候登录按钮是一个图片,没有文字标识,元素捕获不到。这时候用"图像识别"——先截取登录按钮的图片,保存为模板图片,然后用"wait_appear"指令等这个图片出现在屏幕上,出现之后用"click"指令点击。
# 影刀图像识别指令的参数
wait_appear(image_path="C:/templates/login_btn.png", timeout=10)
click(image_path="C:/templates/login_btn.png")
锚点9位置是指:图片被找到之后,点击目标图片的哪个位置——可以选左上、中上、右上、左中、正中、右中、左下、中下、右下这9个位置。再加偏移量微调。我一般用"正中"再加少量偏移。
图像识别的坑:屏幕分辨率变了之后,之前保存的模板图片可能识别不到。我遇到过——在公司电脑上保存的登录按钮模板,回家换了个分辨率不同的笔记本,识别失败了。解决办法:模板图片尽量截取有明显特征的部分(比如蓝底白字的按钮),避免截整块区域。
八、进阶技能——HTTP请求+Python协同+OCR+ADB
HTTP请求在CRM里的高级应用:
除了飞书API,CRM可能还要对接其他系统: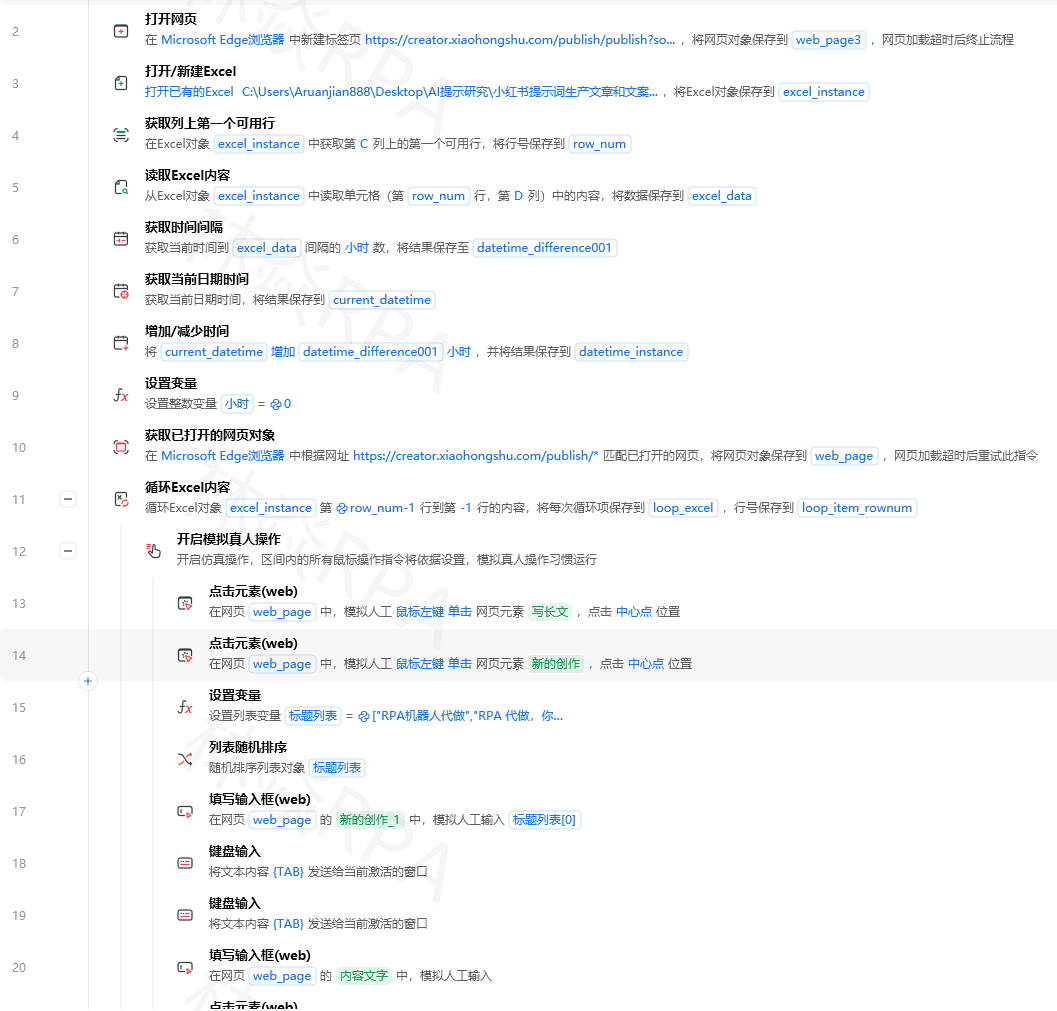
- 企业微信通知(用法跟飞书类似,也是Webhook)
- 短信通知(比如阿里云短信服务API)
- 邮件发送(飞书邮箱API或者SMTP)
影刀的"HTTP请求"指令支持GET、POST、PUT、DELETE,支持自定义Headers,支持JSON/表单/纯文本请求体。一个完整的HTTP请求在影刀里的配置:
请求方式:POST
URL:https://open.feishu.cn/open-apis/bitable/v1/apps/xxx/tables/xxx/records
请求头:{"Authorization": "Bearer " + token, "Content-Type": "application/json"}
请求体:{"fields": {...}}
请求体格式:JSON(默认就是JSON)
Python协同在CRM里的应用:
数据清洗——比如从天眼查抓到的"注册资本"是"5000万人民币",你要提取出"5000"这个数字,用影刀指令得拼好几条,用Python一行正则就搞定了:
import re
def main(args):
    text = args.get('capital', '')
    match = re.search(r'(\d+)万', text)
    if match:
        return {'amount': int(match.group(1))}
    return {'amount': 0}
去重——如果从多个数据源采集客户,可能有重复的。用Python的pandas做去重非常方便:
import pandas as pd
def main(args):
    customers = args.get('customers', [])
    df = pd.DataFrame(customers)
    df = df.drop_duplicates(subset=['公司名称'])
    return {'unique_customers': df.to_dict('records')}
OCR在CRM里的应用:
拍了张名片,想自动提取名片上的姓名、电话、公司。流程:
- 把名片照片传到电脑上
- 用"OCR文字识别"指令识别照片上的文字
- 用正则表达式从识别结果里提取关键信息
但OCR识别名片的效果取决于照片质量。我第一次试的时候,随手拍的模糊照片,OCR只识别出了70%。后来加了"对焦+水平拍摄"的要求,准确率提到了95%以上。
ADB手机自动化(如果你的CRM要操作手机端应用):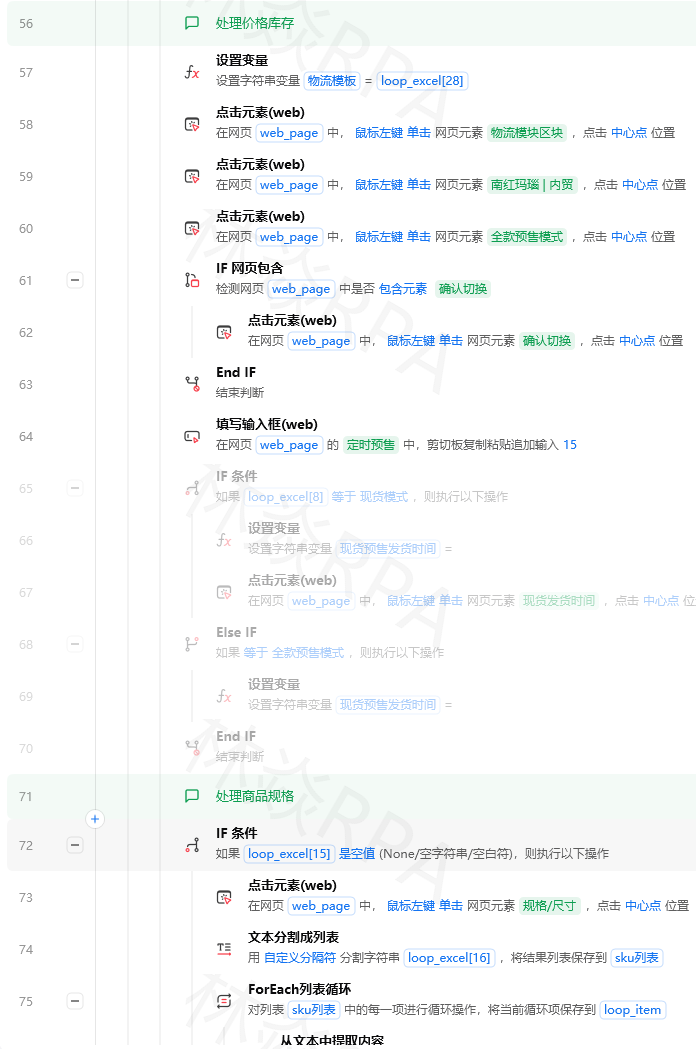
- 手机开启USB调试,用数据线连接电脑
- 在影刀里用"connect_adb_device"连接手机
- 用坐标点击、输入文本、截图等指令操作手机
- 操作完用"disconnect_adb_device"断开连接
ADB手机自动化在CRM里最常用的场景:自动给微信好友发跟进消息。但操作之前要确认合规——微信官方是禁止自动化操作的,风险自己评估。
九、平台实战——多数据源采集客户
TEMU店群矩阵自动化运营核价报活动
CRM的数据来源可以很多,讲3个最典型的:
天眼查/企查查采集:
- 打开搜索页,输入关键词(比如"电商"),搜索
- 翻页抓取每页的企业列表(名称、行业、注册资本、电话等)
- 点进每家企业的详情页,抓取更多信息(法人代表、参保人数、专利数量)
- 写入飞书多维表格
坑点:天眼查对频繁访问有反爬,爬了大概50页就会弹验证码。解决办法:每次翻页之后加5-10秒的随机等待,模拟人类浏览速度。
智联招聘/前程无忧采集(采集招聘岗位信息来判断哪些公司在招人,潜在客户线索):
- 搜索"电商运营主管""新媒体运营"等岗位
- 抓取公司名称、公司规模、岗位要求
- 如果有公司规模>100人且正在大规模招聘,标记为"A类潜在客户"
- 写入飞书多维表格,标记"市场部待跟进"
展会网站采集:
- 展会网站往往有"参展商列表"页面
- 直接抓取公司名称、展位号、联系方式
- 这种数据的质量比天眼查高,因为都是近期活跃的企业
十、系统联动——飞书消息通知+定时任务+邮件
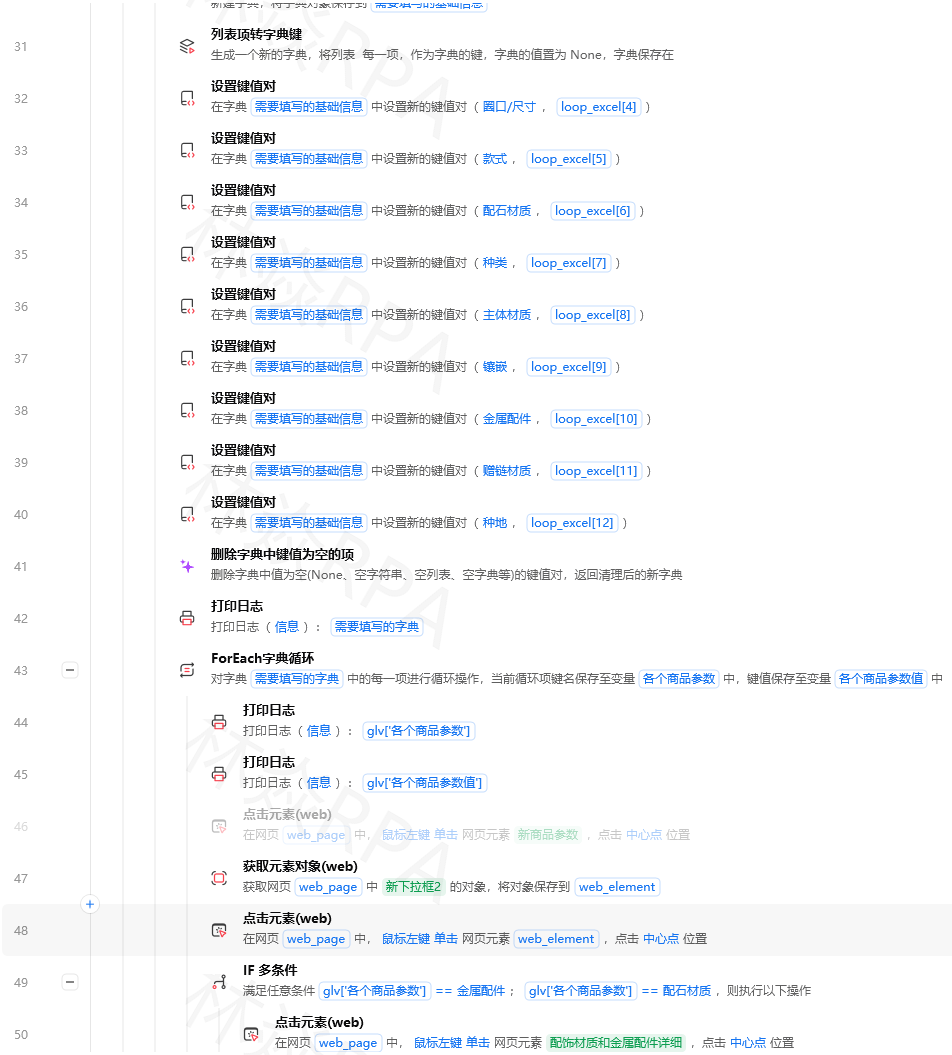
CRM系统的核心是"自动"——数据自动入库,到期自动提醒,状态变化自动通知。
飞书消息通知的3种场景:
- 新客户入库通知:每导入一条新客户,发一条消息到CRM群
- 跟进到期提醒:每天早上9点,发"今日待跟进客户"列表到每个销售的飞书上
- 异常报警:数据采集失败或者API调用失败,发消息通知技术负责人
消息格式建议用飞书的"富文本消息"(支持标题、颜色、链接),比纯文本好看太多。
定时任务配置:
- 客户数据采集:每天早上7点跑(上班前数据已就位)
- 跟进到期检查:每天早上9点跑(上班第一件事看到待跟进提醒)
- 报表生成:每周一早上8点跑(生成上周CRM数据报表)
邮件通知:有些场景不适合用飞书(比如给客户发邮件),用影刀的"发送邮件"指令或者直接调飞书邮箱API。
十一、工程化与规范——版本控制、子流程、调试
CRM系统往往是多人协作的,工程化规范就很重要。
子流程封装:把可复用的逻辑封装成子流程。
- "获取飞书Token"子流程(输入:app_id, app_secret,输出:token)
- "写入客户到多维表格"子流程(输入:客户数据,输出:是否成功)
- "发送跟进提醒"子流程(输入:到期客户列表,输出:是否发送成功)
命名规范:变量名见名知意。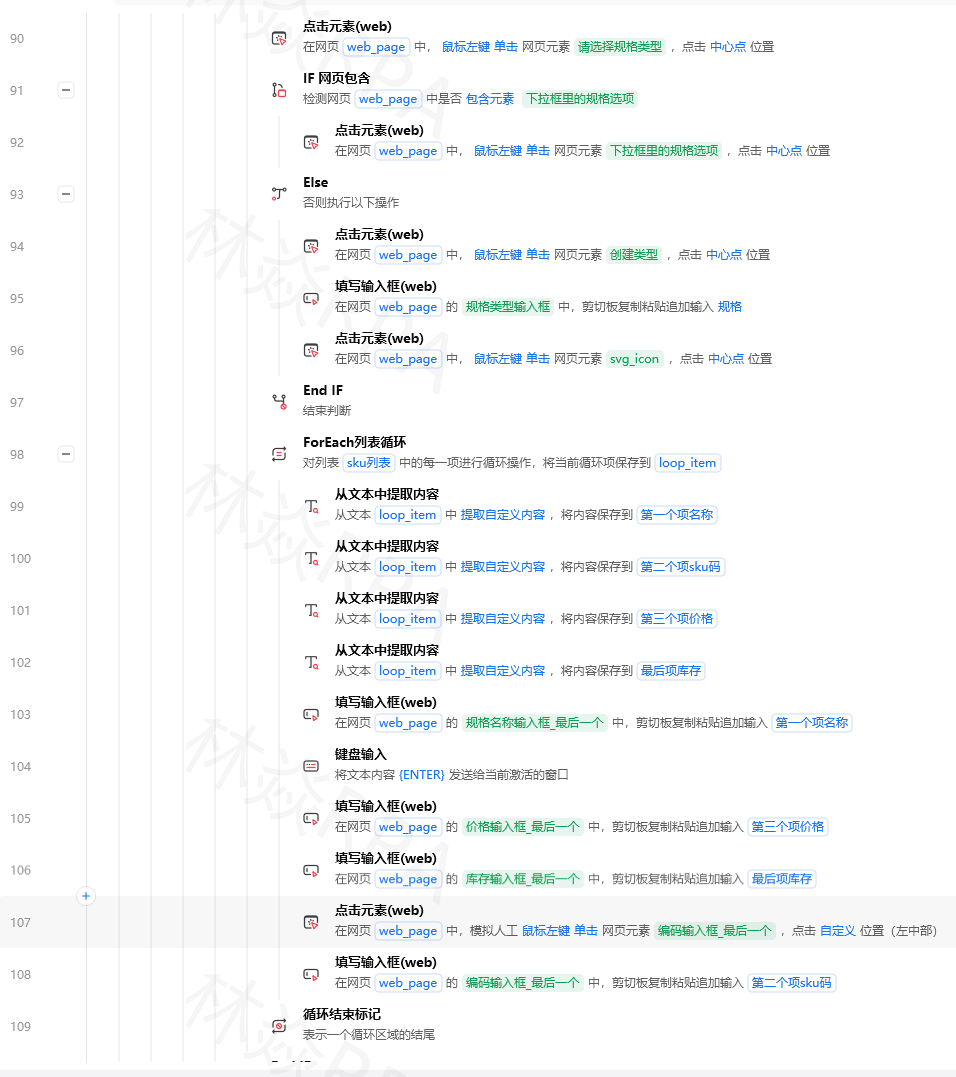
- 好:
customer_list、today_followup_list、feishu_token - 坏:
a、temp、list1、data(过段时间自己都忘了是什么)
调试技巧:
- 在每条HTTP请求之后,立刻打印响应状态码和响应体(用"调试输出"指令)
- 批处理跑数据的时候,每处理100条打印一次进度
- 异常处理(Try-Catch)里一定要打印报错信息,别只写"忽略错误"
版本选择:
- 社区版:免费,适合个人和中小企业,功能足够用
- 创业版:299/年,多了批量操作和定时任务的高级功能
- 企业版:按需报价,多了权限管理、多人协作、审计日志等功能
做CRM系统,社区版足够了。如果团队超过5个人且需要权限管理,再考虑升级到创业版或企业版。
十二、速查表——CRM场景常见报错
| 报错信息 | 原因 | 解决方案 |
|---|---|---|
| Token expires / 401 | 飞书token过期(有效期2小时) | 重新获取token |
| Rate limited / 429 | 请求频率超限 | 每条操作间隔200-500ms |
| app not exists | app_token填错 | 去飞书开放平台确认app_token |
| invalid field | 字段名与表格定义不一致 | 确保大小写和字段名完全一致 |
| 列表越界 / IndexError | 翻页判断条件不对导致无限循环 | 用disabled class判断最后一页 |
| 元素定位失败 | 页面结构变化 / iframe里 | F12检查HTML,确认是否有iframe |
| Can not convert Array to String | 列表类型填到了字符串参数 | 用列表转文本指令 |
| 日期偏移8小时 | 时区问题 | 手动加减8小时,或者用Python的pytz库 |
这套CRM系统搭建完,你会发现一个规律:所有"数据采集+数据入库+到期提醒"类的项目,逻辑几乎一样。影刀的价值就是让你把这个规律用流程图固化下来,以后遇到类似需求,改几个参数就能复用。
#影刀RPA #RPA教程 #飞书 #CRM #多维表格 #自动化 #企业协作 #客户管理
作者:林焱
一站式 AI 云服务平台
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)