
JVS-Rules 实战指南:市场运营人员如何零代码自主配置营销规则(含决策流调试与审计追踪)
为什么传统规则管理在技术协作中失效?
当营销活动策略(如新客满减门槛、VIP豁免条件、地域补贴范围)需小时级响应时,‘提 Jira → 开发排期 → 测试 → 发版’的闭环平均耗时 72 小时——这本质是将业务决策节奏强行耦合到应用发布周期,造成客户体验断点与归因失真。
更深层问题在于规则资产的不可见性:
- 规则逻辑散落在 Java 服务代码、SQL 脚本或 Excel 表格中;
- 同一客户分层逻辑在 CRM、商城、短信平台各自实现,口径不一致;
- 审计要求‘判断可解释、过程可追溯、责任可定位’,但缺乏结构化执行上下文。
技术瓶颈早已突破,真正的障碍是协作范式未对齐:高频业务判断权必须下沉至运营侧,而非由开发代行。
JVS-Rules 的技术定位:企业级规则中枢,非低代码表单工具
JVS-Rules 不是轻流或简道云式的流程型低代码平台,而是面向微服务架构设计的企业级规则中枢。其核心能力体现在:
- 解耦逻辑与实现:规则以可视化决策流(Decision Flow)、决策表(Decision Table)、评分卡(Scorecard)等标准范式建模,业务人员用‘注册时长≤7天’‘首单金额≥99元’等业务语言表达逻辑,无需接触 Java 代码、HTTP 协议或 CI/CD 流程;
- 统一服务化暴露:所有规则封装为标准化 RESTful API(如
POST /api/v1/decision/flow/marketing-eligibility),支持营销系统、CRM、客服工单等多系统并发调用同一决策流; - 跨系统逻辑复用:同一套‘高价值客户识别’规则,可通过路由规则(Routing Rule)动态分发至不同下游系统,避免各系统重复编码导致的逻辑漂移。
技术人员职责收敛为:
- 对接并校验数据源(CRM 用户表、订单库、行为埋点 API);
- 封装可复用函数(如 getRegionTier(cityName)、calculateActiveDropRate(userId, days=30));
- 提供异常兜底策略(如降级返回默认值、触发人工审核队列);
- 维护 API 网关与监控告警。
三步完成一次生产环境规则变更(实操级)
整个过程在浏览器端完成,无需重启服务,保存即生效,平均耗时 < 3 分钟。
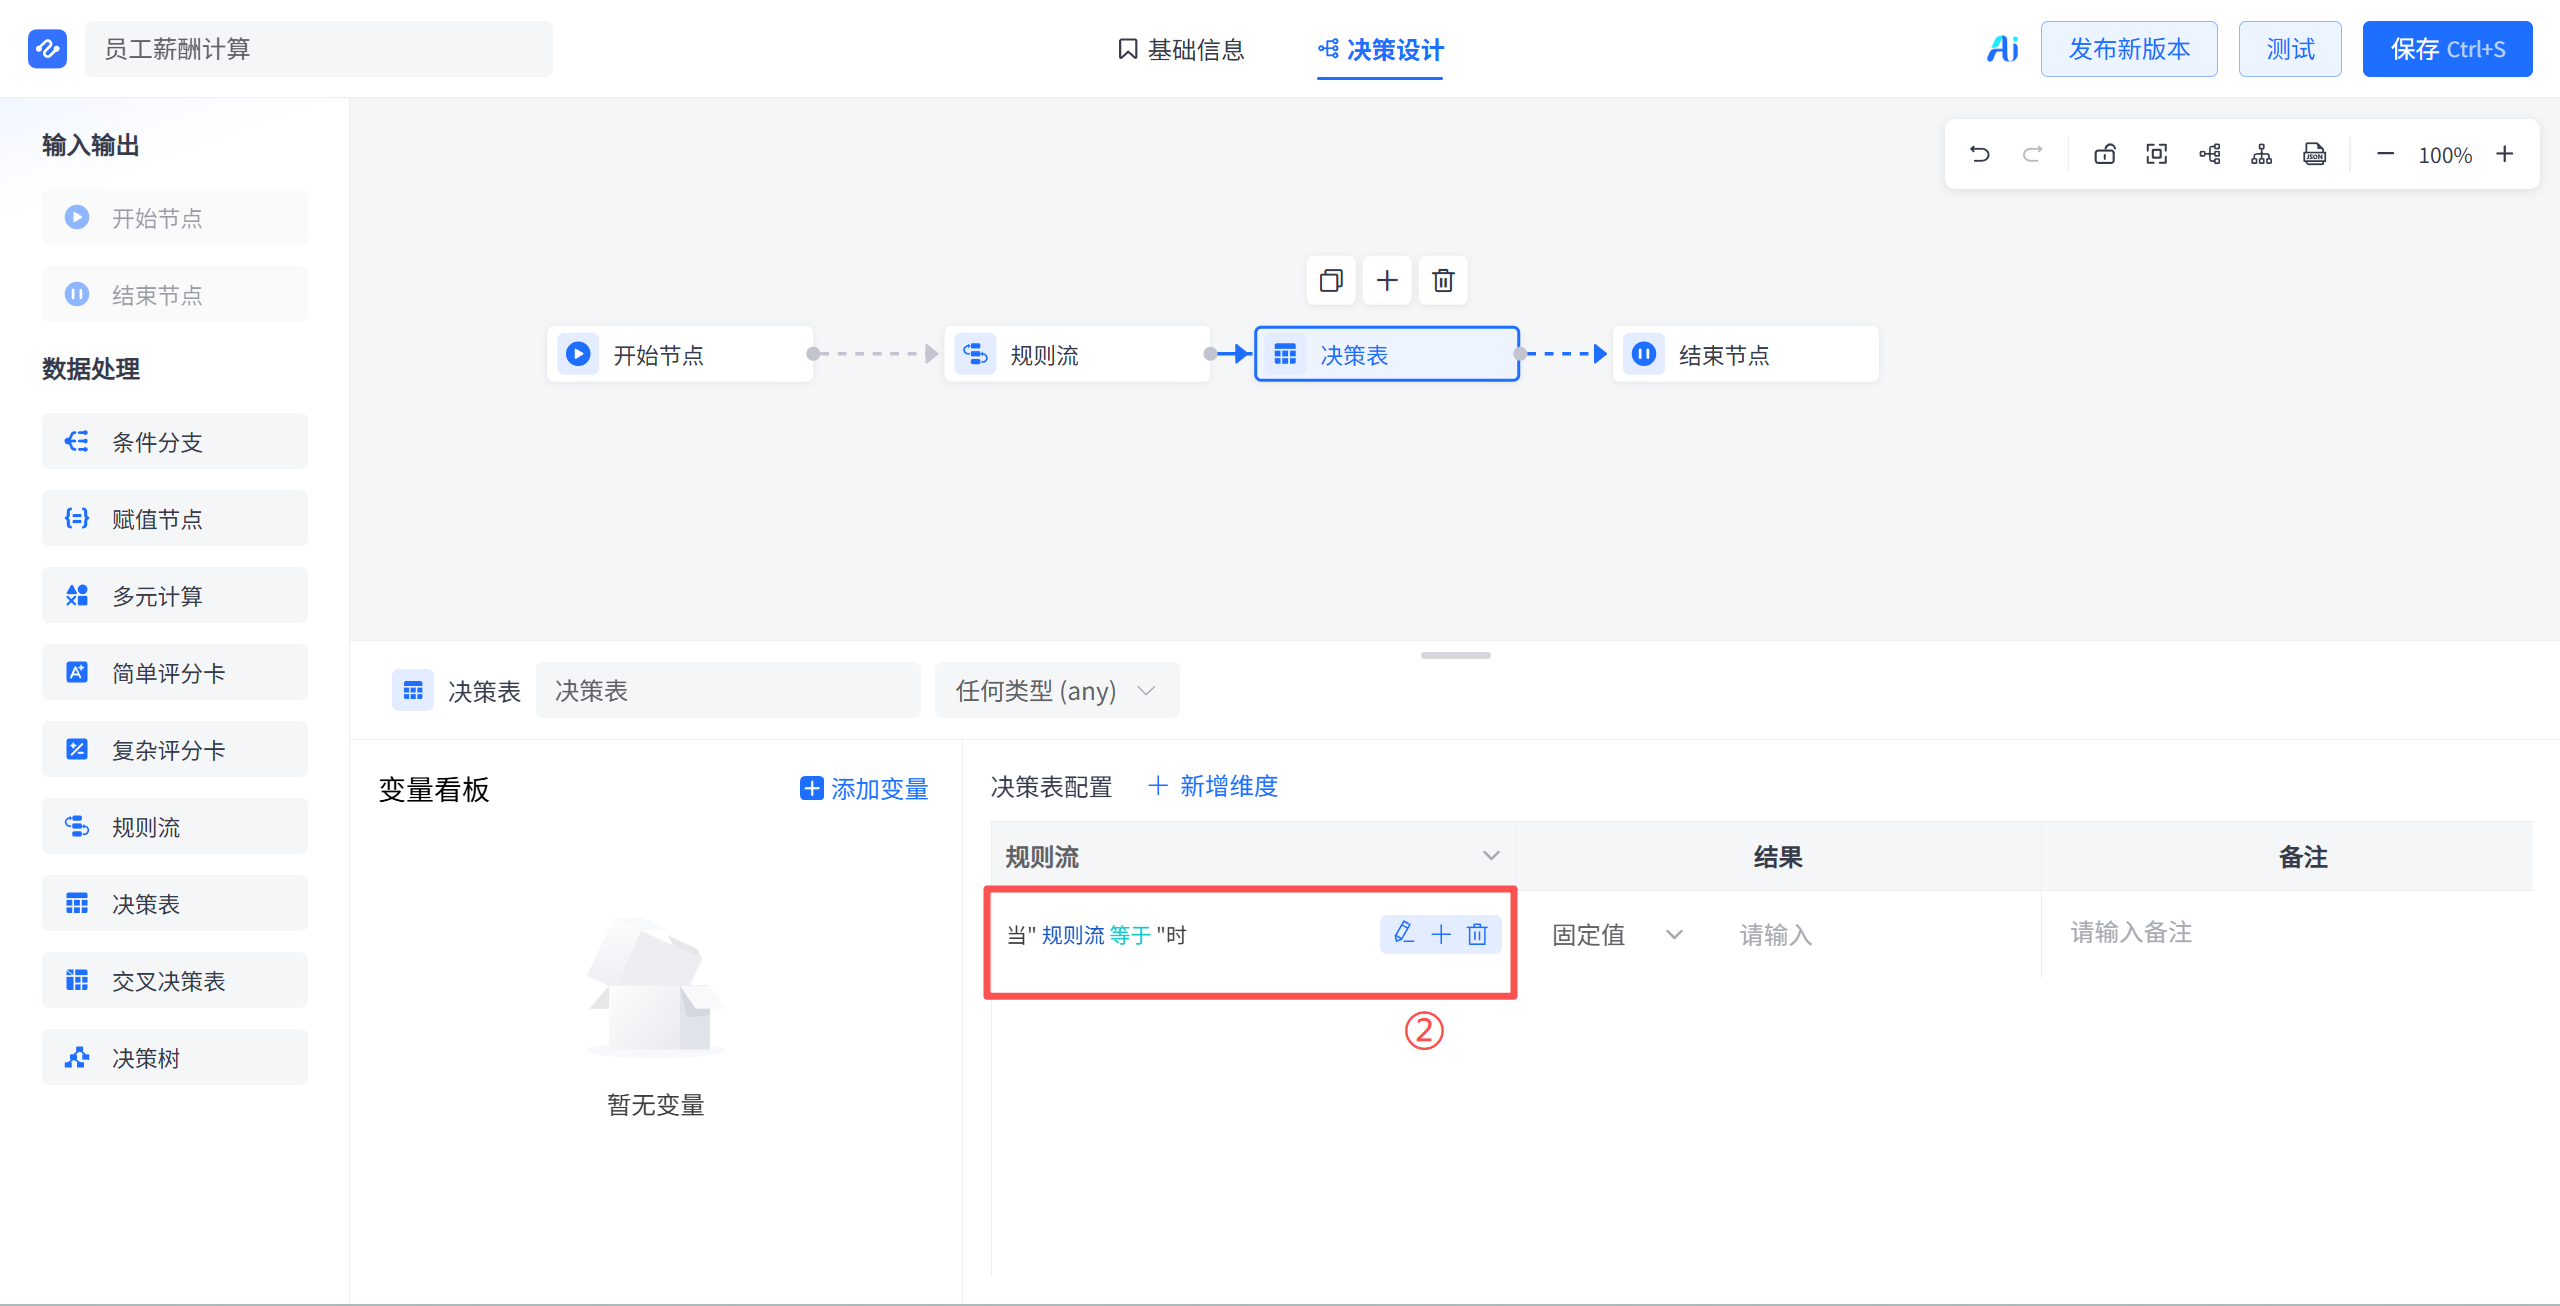
第一步:识别并映射可量化业务变量
聚焦真实业务语义,不关心底层字段名。例如调整‘大促新客满减资格’,只需确认以下变量及其取值逻辑:
- 注册时长:取自用户主数据 user.registered_at,计算 now() - registered_at ≤ INTERVAL '7 days';
- 首单金额:关联订单库,取 order.amount WHERE order.status = 'PAID' AND order.user_id = ${userId} ORDER BY created_at LIMIT 1;
- 地域限制:调用 region-service/api/v1/tier?city=${city} 获取城市等级,匹配‘一线城市’枚举值。
✅ 关键点:所有变量均通过预置数据源连接器或 SQL 查询片段声明,业务人员仅选择/填写参数,不写 SQL 或改代码。
第二步:选择匹配复杂度的决策范式
根据逻辑结构选择对应建模方式,系统自动生成可执行规则引擎 DSL(如 Drools DRL 或自研规则字节码):
- 多条件组合(AND/OR 为主)→ 决策表:
- 行为:设置会员等级、近7天下单频次、所在城市Tier;
- 结果:是否发放满减券、券面额、有效期;
- 优势:交叉条件一目了然,支持批量导入导出 CSV。
- 存在优先级或互斥路径 → 条件分支(If-Else Chain):
- 示例逻辑:
```
IF 用户为 VIP THEN 免除地域限制
ELSE IF 近30天活跃下降 ≥40% THEN 触发人工复核
ELSE 按普通规则执行
```
- 优势:路径清晰,便于合规审查‘豁免依据’。
- 需完整解释判定路径 → 决策树:
- 每个节点标注判断依据(如‘因近30天活跃下降40%’),叶子节点输出结论 + 置信度;
- 调用 API 返回结果中自动包含 explanationPath 字段,供前端展示或审计使用。
第三步:在线调试与灰度发布
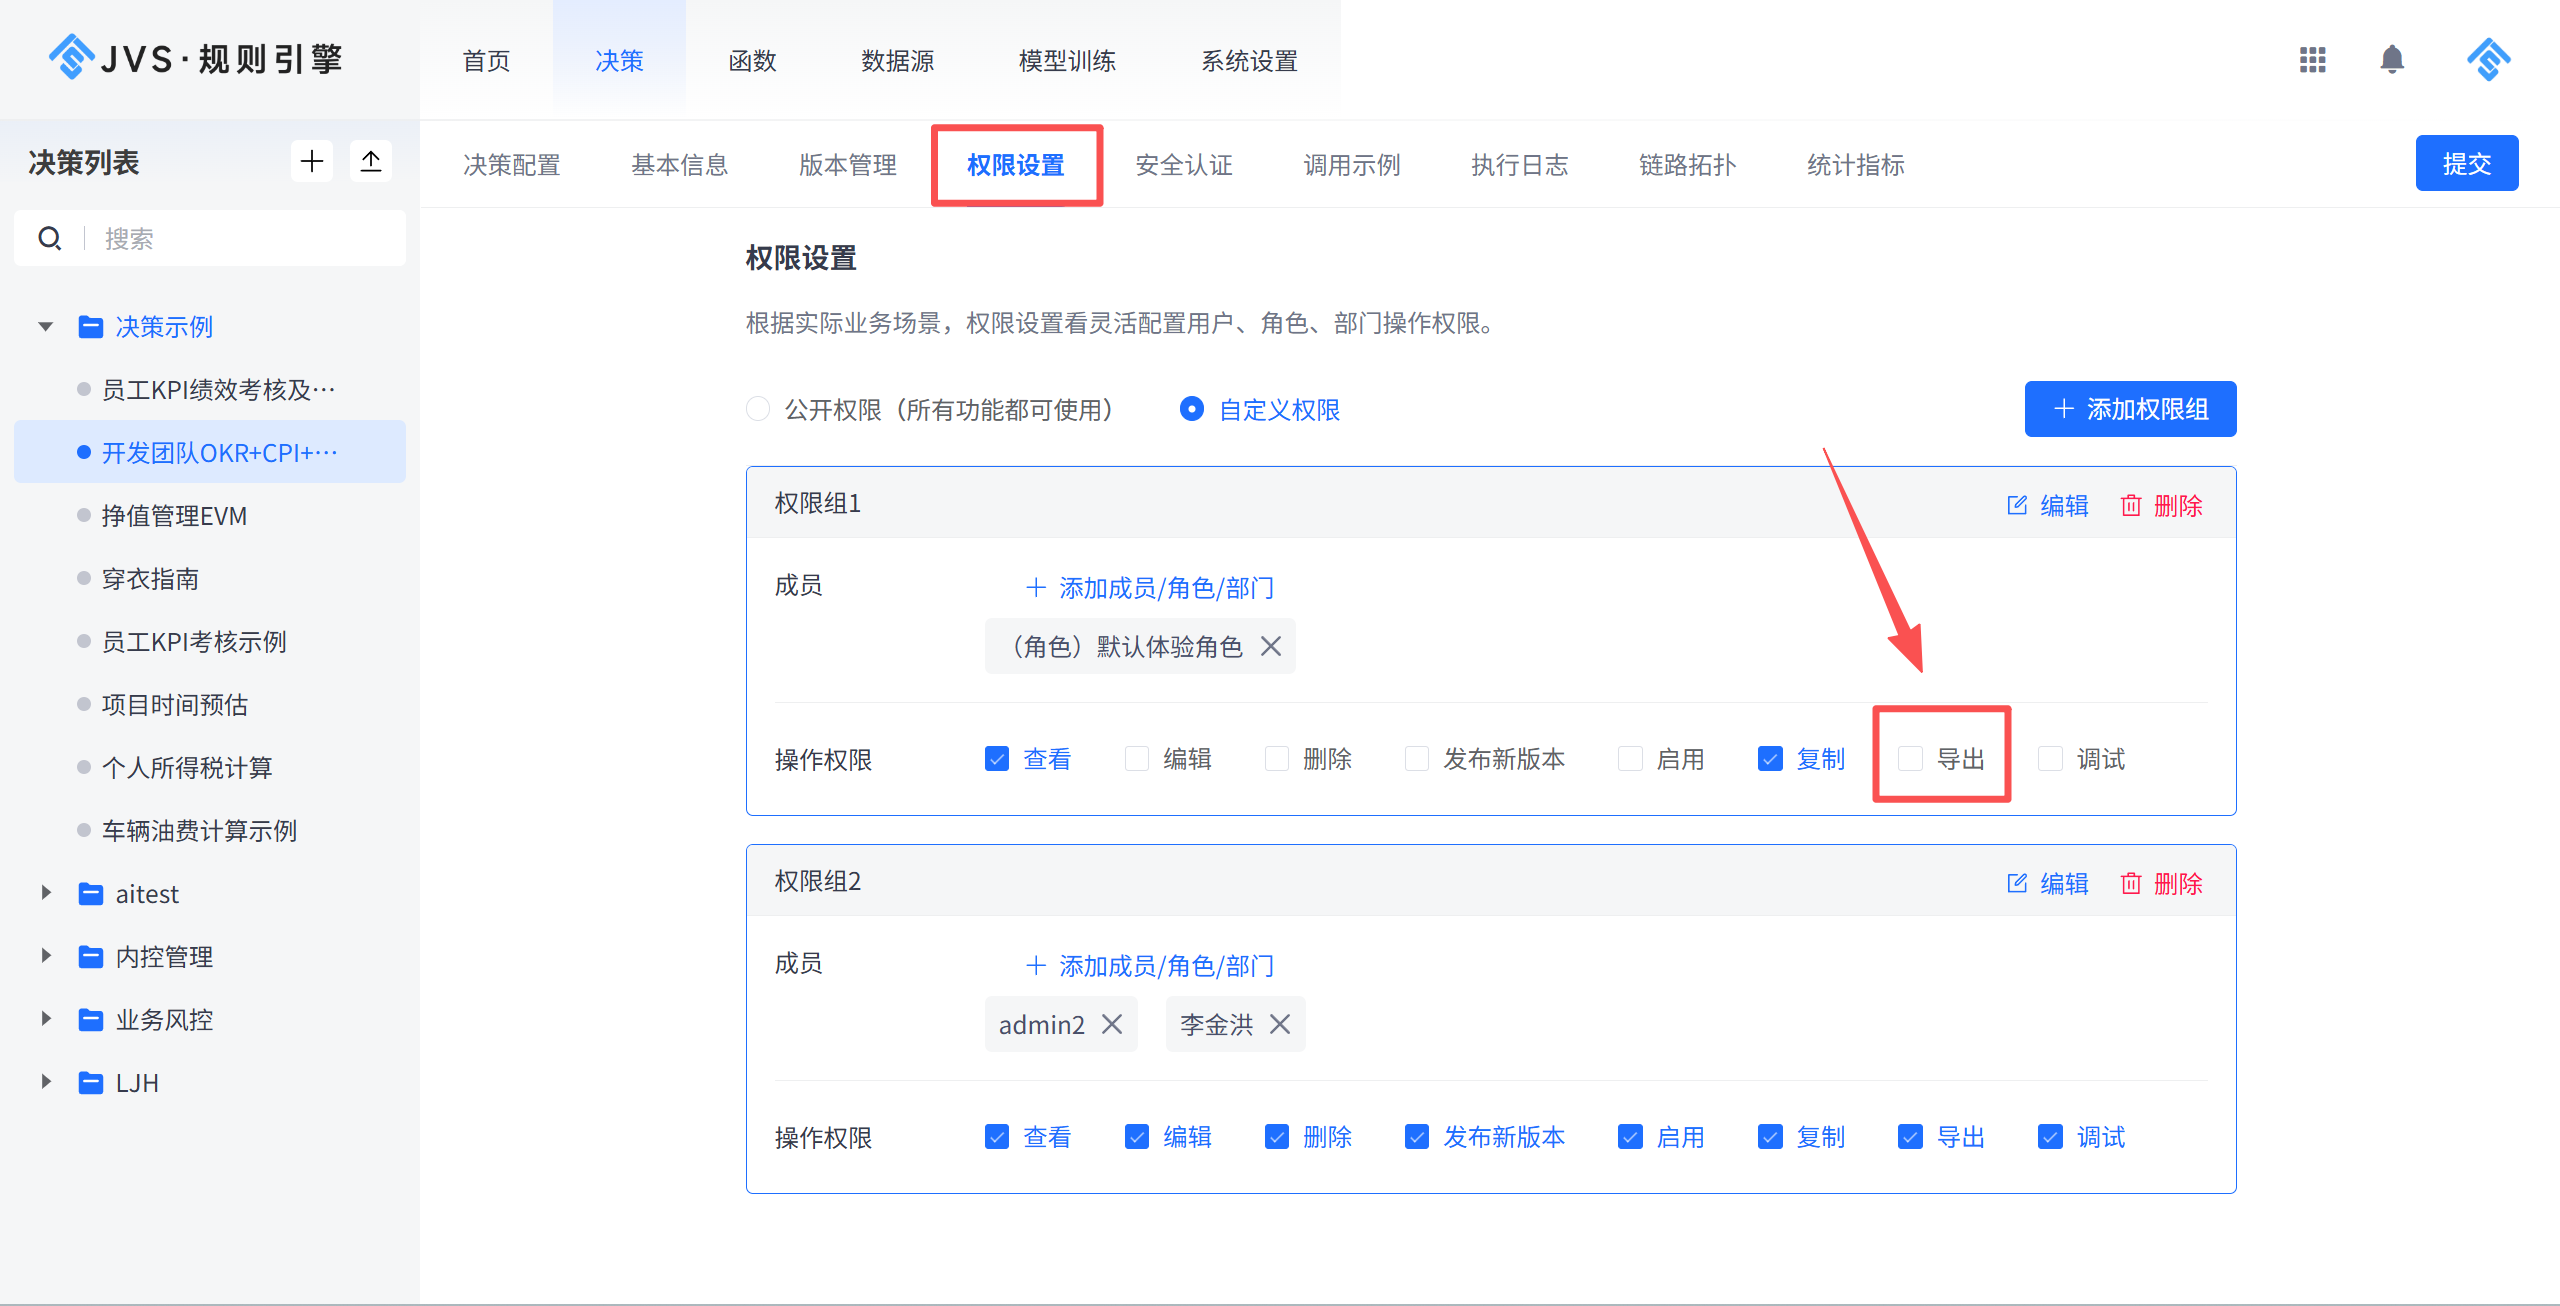
- 调试阶段:输入真实客户 ID 或订单号,系统实时模拟执行:
- 显示每一步输入数据(如 user.registered_at = '2024-05-01');
- 标注命中规则节点与未命中原因(如‘条件 [首单金额≥99] 不满足,实际值=85’);
- 输出耗时(毫秒级)、调用外部服务返回值(如 region-service: {tier: 'Tier1'});
- 发布阶段:
- 点击‘发布’后,新版本自动加载至规则运行时容器;
- 原有流量无缝切换,无服务中断;
- 自动生成变更快照:包含版本号、操作人、时间戳、diff 差异(JSON Patch 格式)、执行上下文样本。
可靠性保障:从日志到权限,构建可审计的规则基础设施
全链路执行日志:让‘为什么这样判’可验证
每次规则调用生成结构化执行日志(JSON),包含:
- 触发节点路径(如 /flow/marketing-eligibility → node[check-region]);
- 输入原始数据(脱敏后,如 user.id = 'u_8a9b...');
- 调用函数名及入参(如 function: getRegionTier, args: ['Shanghai']);
- 外部 API 请求/响应(含 HTTP 状态码与 body 片段);
- 最终决策结果与置信度(如 {"eligible": true, "reason": "VIP exemption applied", "confidence": 0.98})。
该日志同时推送至 ELK 与审计数据库,支持按客户 ID、规则 ID、操作人多维检索,满足金融监管‘可追溯、可定位、可解释’要求。
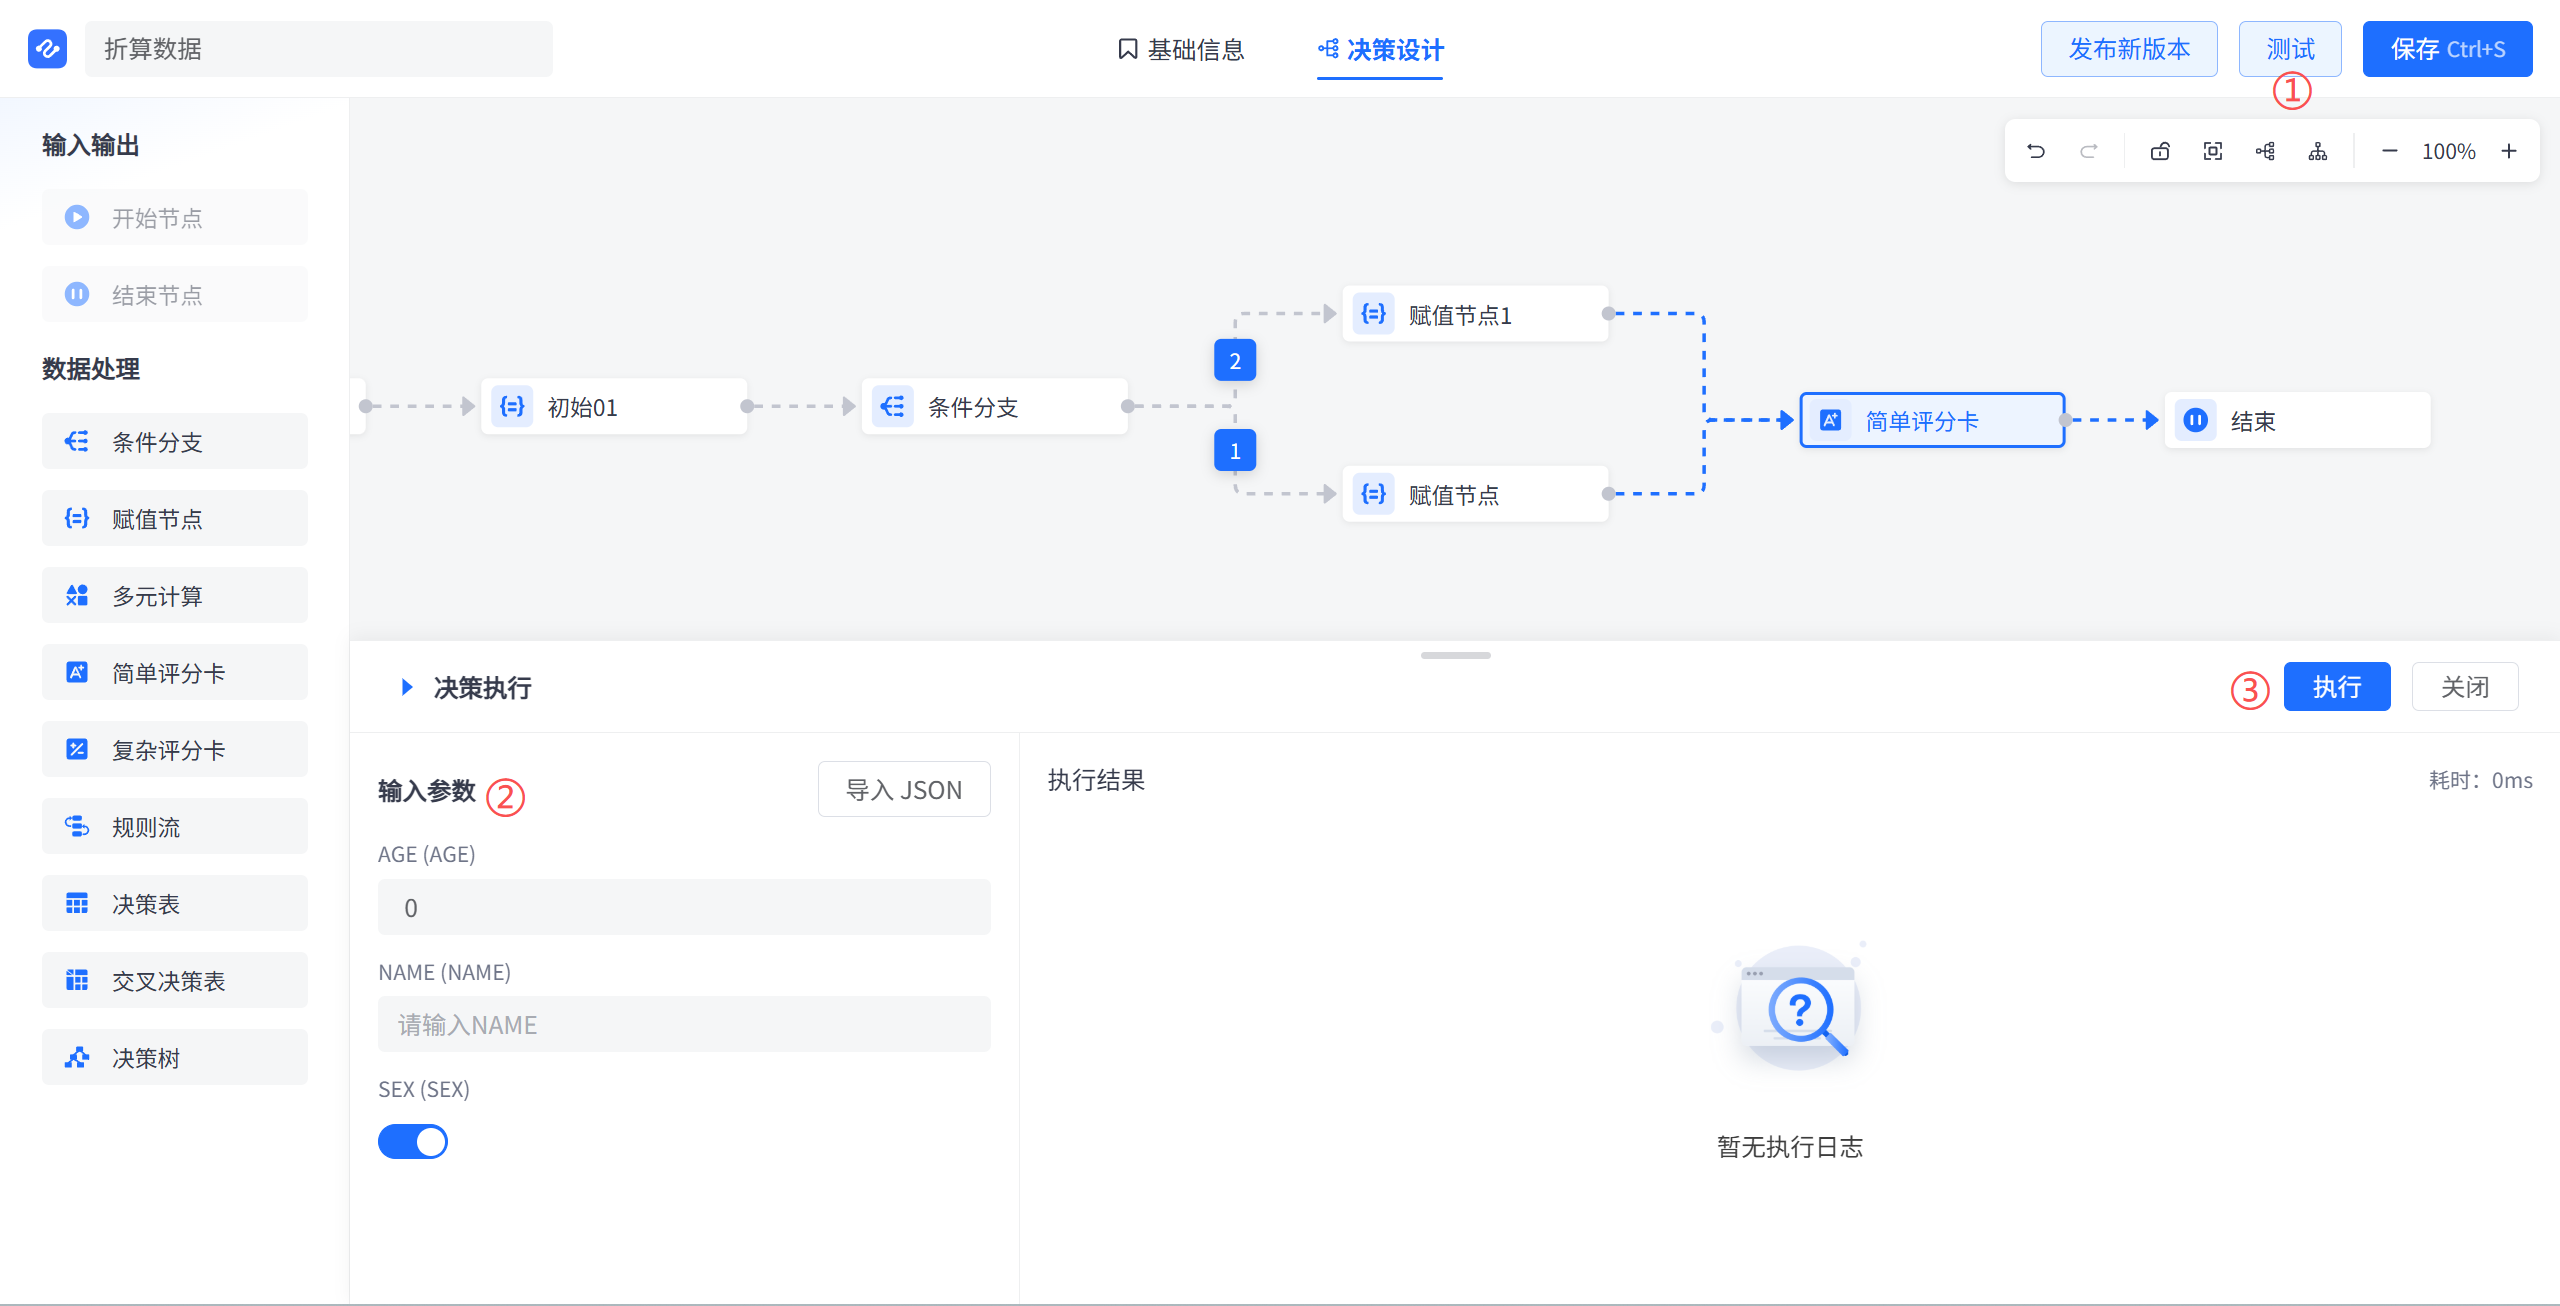
规则资产治理:导入导出 + 细粒度权限
- 支持规则包(Rule Package)JSON 导出/导入,实现 dev → test → prod 环境迁移、跨项目复用;
- 基于 RBAC 控制编辑与导出权限:
- 普通运营角色:仅可编辑‘营销活动类’规则;
- 合规专员:可查看全部规则执行日志,但无编辑权限;
- 黑名单策略等敏感规则:仅限安全管理员角色创建与导出。
数据质量锚定:多源实时校验
规则判断质量依赖输入数据可信度。JVS-Rules 提供:
- 多数据源连接器(JDBC、REST API、Kafka Topic);
- 内置 SQL 查询编辑器(支持子查询、JOIN、窗口函数),用于口径对齐(如统一‘活跃用户’定义为 COUNT(DISTINCT event_date) ≥ 3 IN LAST 7 DAYS);
- 数据新鲜度监控:自动检测字段延迟(如 user.last_login_at 超过 2 小时不更新则告警);
- 规则启用前强制校验:若关键字段缺失率 > 5%,禁止发布。
总结:规则能力如何真正融入研发与运营主流程
JVS-Rules 的落地不是替代开发,而是重构协作契约:
- 业务侧沉淀可复用的判断逻辑资产(决策流、决策表),形成组织级知识库;
- 技术侧专注数据管道建设、函数能力封装与稳定性保障;
- 通过标准化 API 和路由规则,实现‘一次配置、全域生效’——营销系统调用 /decision/flow/eligibility,即可同步完成资格校验、权益匹配与客户分层,消除多系统逻辑不一致。
这种模式已在多个电商大促场景验证:规则平均迭代周期从 72 小时压缩至 3 分钟内,审计问题响应时间从天级降至分钟级,且 100% 变更具备可回溯快照。

一站式 AI 云服务平台
更多推荐
 5
 0
- 0


 已为社区贡献12条内容

所有评论(0)