
用华为云码道优化跨端阅读器:从大文件卡顿到章节跳转与续读体验升级
一键开通华为云码道 CodeArts 代码智能体:
Developer Events_Developer Alliance-Huawei Cloud
一、为什么这次不从零做 Demo,而是让 AI 接手一个已有项目?
最近体验华为云码道 CodeArts 代码智能体时,我没有选择重新生成一个只有几个页面的小 Demo,而是把一个已经具备较完整功能的跨端阅读器项目交给了码道。
这个阅读器最初使用 HTML、CSS、JavaScript 开发,并通过 Capacitor 封装 Android 版本,已经具备电子书导入、书架管理、TXT 阅读、PDF 阅读、阅读进度保存、书签笔记、全文搜索、朗读、阅读统计等功能。
项目功能已经不少,但随着代码逐渐增加,也开始出现一些典型的“第二阶段问题”:
功能能用,但体验还有明显的优化空间。
例如导入较大的 TXT 文件后,内容解析和页面渲染可能出现等待;章节较多时,跳转后的定位体验还不够顺畅;阅读器同时存在 Web 和 Android 两套运行场景,修改代码后还需要考虑构建、同步和测试流程。
所以这次我给华为云码道的任务,不再是简单的:
“帮我写一个阅读器。”
而是:
先理解一个已有项目,再找出真正影响使用体验的问题,在不破坏已有功能的前提下进行优化,并完成可验证的工程交付。
这也是我这次最想测试 CodeArts 代码智能体的地方。
二、项目介绍:一个可以在浏览器和 Android 上运行的跨端阅读器
项目名称暂定:
ReadFlow / FlowReader 跨端阅读器
【最终名称可根据 AtomGit 仓库名称修改】
项目主要面向 TXT、PDF 等本地阅读场景,希望做到:
-
文件导入后可以直接进入书架管理;
-
TXT 自动分析章节;
-
阅读位置自动保存;
-
支持章节跳转和继续阅读;
-
支持书签、笔记和搜索;
-
支持 PDF 文件阅读;
-
支持朗读;
-
支持阅读时间、阅读进度等统计;
-
同一套前端代码既可以运行在浏览器,也可以通过 Capacitor 打包为 Android 应用。
目前项目的核心技术栈为:
| 模块 | 技术 |
|---|---|
| 页面开发 | HTML / CSS / JavaScript |
| Web 运行 | Browser |
| Android 封装 | Capacitor |
| TXT 阅读 | JavaScript 文件解析 |
| PDF 阅读 | PDF 渲染模块 |
| 数据保存 | 浏览器本地存储 |
| 版本管理 | AtomGit |
| AI 辅助开发 | 华为云码道 CodeArts 代码智能体 |
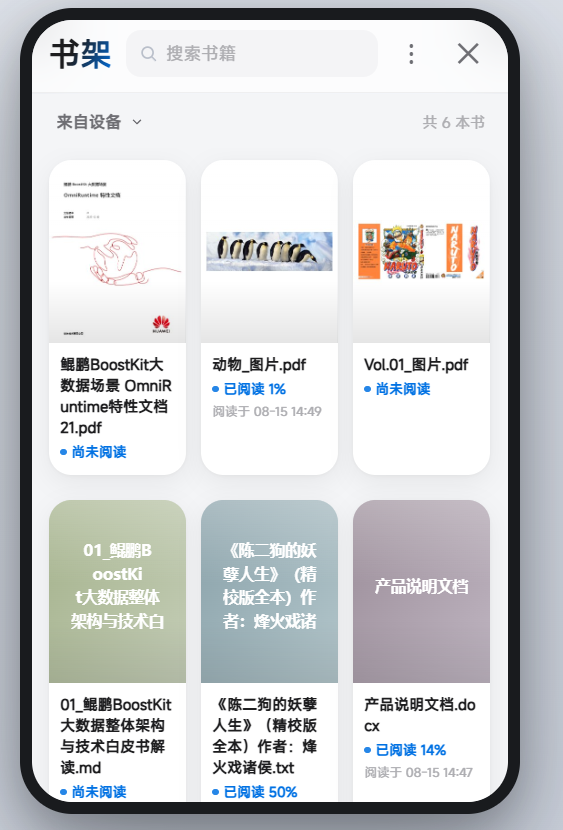
项目优化前的阅读器首页
三、这次真正要解决的问题是什么?
我没有直接让 Agent “自由发挥”,而是先把问题拆成了不同优先级。
第一阶段并不追求一次重构整个阅读器,而是优先解决对实际使用影响最大的部分。
3.1 统一项目的构建、同步和测试流程
跨端项目和普通网页项目的区别之一,是修改前端代码之后,往往还需要同步到 Android 工程。
如果开发过程中每次都靠手工记住:
npm run build
npx cap sync android
很容易出现“网页代码已经是新的,但 Android 工程还是旧版本”的情况。
因此第一步是希望码道检查项目现有的 package scripts、Capacitor 配置以及测试流程,把常用操作统一起来。
目标不是做一个很复杂的 CI/CD,而是先让项目拥有一个更可靠的开发闭环:
修改代码
   ↓
执行测试
   ↓
构建 Web
   ↓
同步 Android
   ↓
运行验证
对于 AI 修改已有项目而言,这一步非常重要。
因为如果没有稳定的验证流程,即使 Agent 写出了代码,也很难判断它是否影响了项目原本的功能。
3.2 大 TXT 文件不应该一次性“全部塞进页面”
第二个重点是 TXT 阅读性能。
小文件通常感觉不明显,但当 TXT 文件达到几 MB、几十 MB,甚至包含上千个章节时,如果每次进入阅读器都:
读取完整文件
→ 解析完整文本
→ 构造大量 DOM
→ 一次性显示
页面压力会快速增加。
因此这次优化的核心思路之一,是把:
“整个文件就是一个页面”
逐步调整为:
“文件负责存储,章节负责组织,当前阅读窗口负责显示”。
也就是说,即使一本书非常大,用户真正需要立即看到的,也只是当前章节以及附近少量内容。
这样既可以降低页面瞬间需要处理的数据量,也为后续继续阅读、章节跳转和搜索定位提供统一的基础。
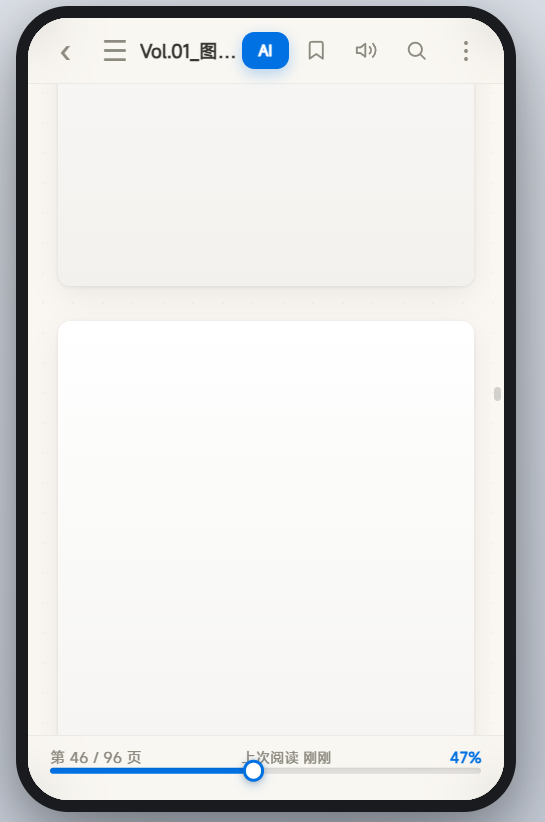
优化前滑动页面效果——会出现加载过慢加载不出来现象
3.3 章节跳转不仅要“跳过去”,还要保证阅读位置正确
阅读器里还有一个很容易被忽略的问题:
章节列表能点击,并不代表章节跳转体验已经完成。
例如用户:
第 15 章阅读到 63%
        ↓
退出应用
        ↓
重新进入
        ↓
继续阅读
理想状态应该恢复到原来的章节和位置。
而如果用户主动从目录进入第 30 章,则应该进入第 30 章对应的位置,而不是继续使用旧章节的滚动进度。
因此这次我希望码道把:
-
章节索引;
-
当前章节;
-
当前阅读位置;
-
自动恢复;
-
主动章节跳转;
-
搜索结果跳转;
这些原本相对分散的逻辑重新检查一遍。
目标不是单独修一个按钮,而是让不同入口最终走向相对统一的“阅读定位逻辑”。
四、先让华为云码道理解项目,而不是立即修改代码
进入华为云码道 CodeArts 后,我首先关联自己的 AtomGit 项目。
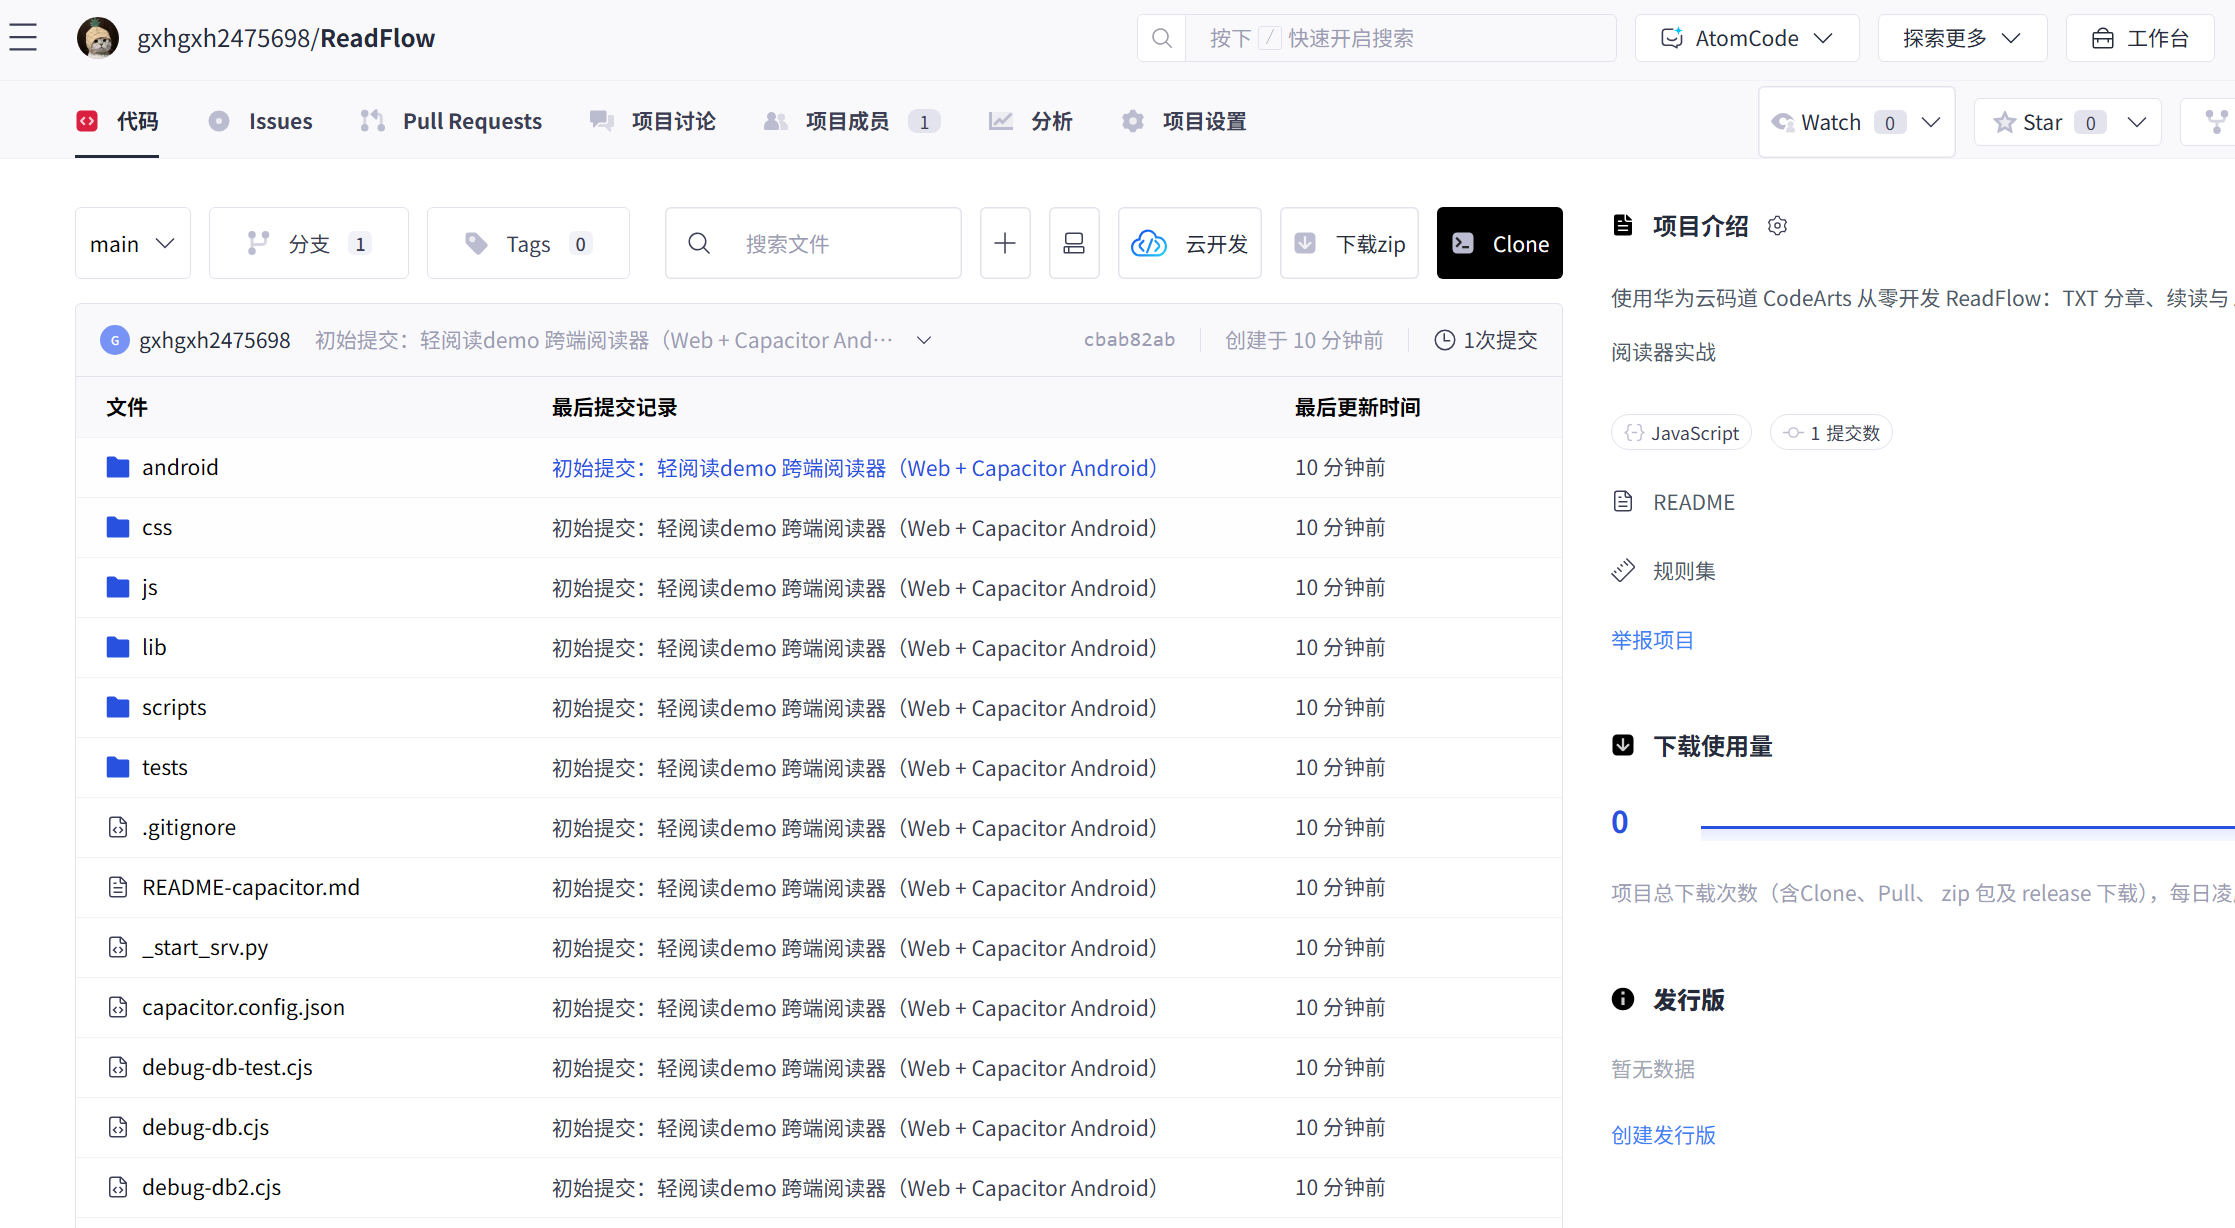
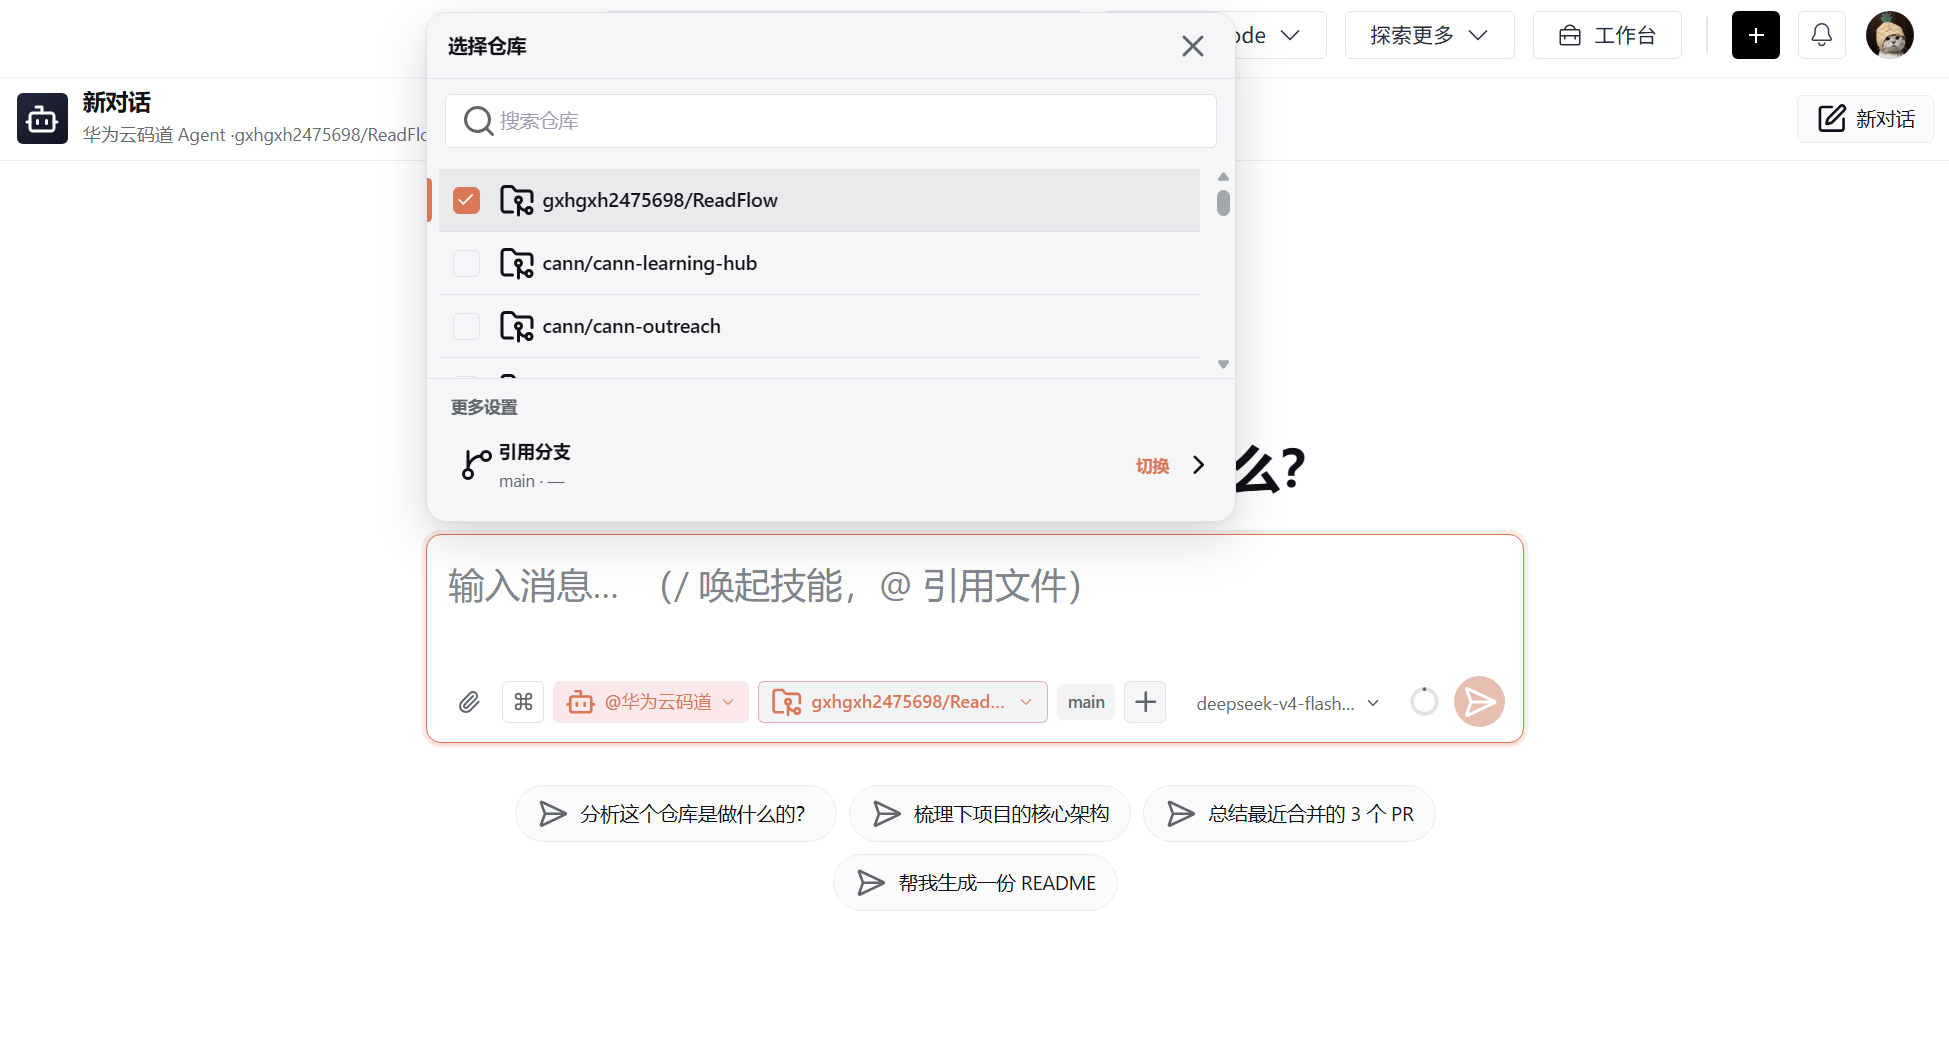
第一轮我没有直接要求修改代码,而是先让 Agent 做项目分析。
提示词的大致思路如下:
请先分析当前仓库中的跨端阅读器项目,暂时不要修改代码。

重点分析:

1. 项目的目录结构和技术栈;
2. TXT 文件从导入到阅读页面显示的完整数据流;
3. TXT 章节解析逻辑;
4. 阅读进度保存和恢复逻辑;
5. 章节跳转和搜索结果定位逻辑;
6. Web 与 Capacitor Android 的构建、同步流程;
7. 当前是否存在大文件一次性读取、一次性渲染、
   重复解析或不必要 DOM 更新的问题;
8. 当前自动化测试覆盖哪些模块。

最后请给出:

- 当前架构总结;
- 可能的性能瓶颈;
- 可以优化但风险较低的部分;
- 修改可能影响的文件;
- 推荐的实施顺序。

这一轮只分析,不修改代码。
这里我觉得是整个过程比较重要的一点:
面对已有项目,我更倾向于先让 AI “读懂”,然后再让它“动手”。
如果一开始只告诉它“帮我优化性能”,它很容易修改过多文件,甚至改变原来的数据结构。
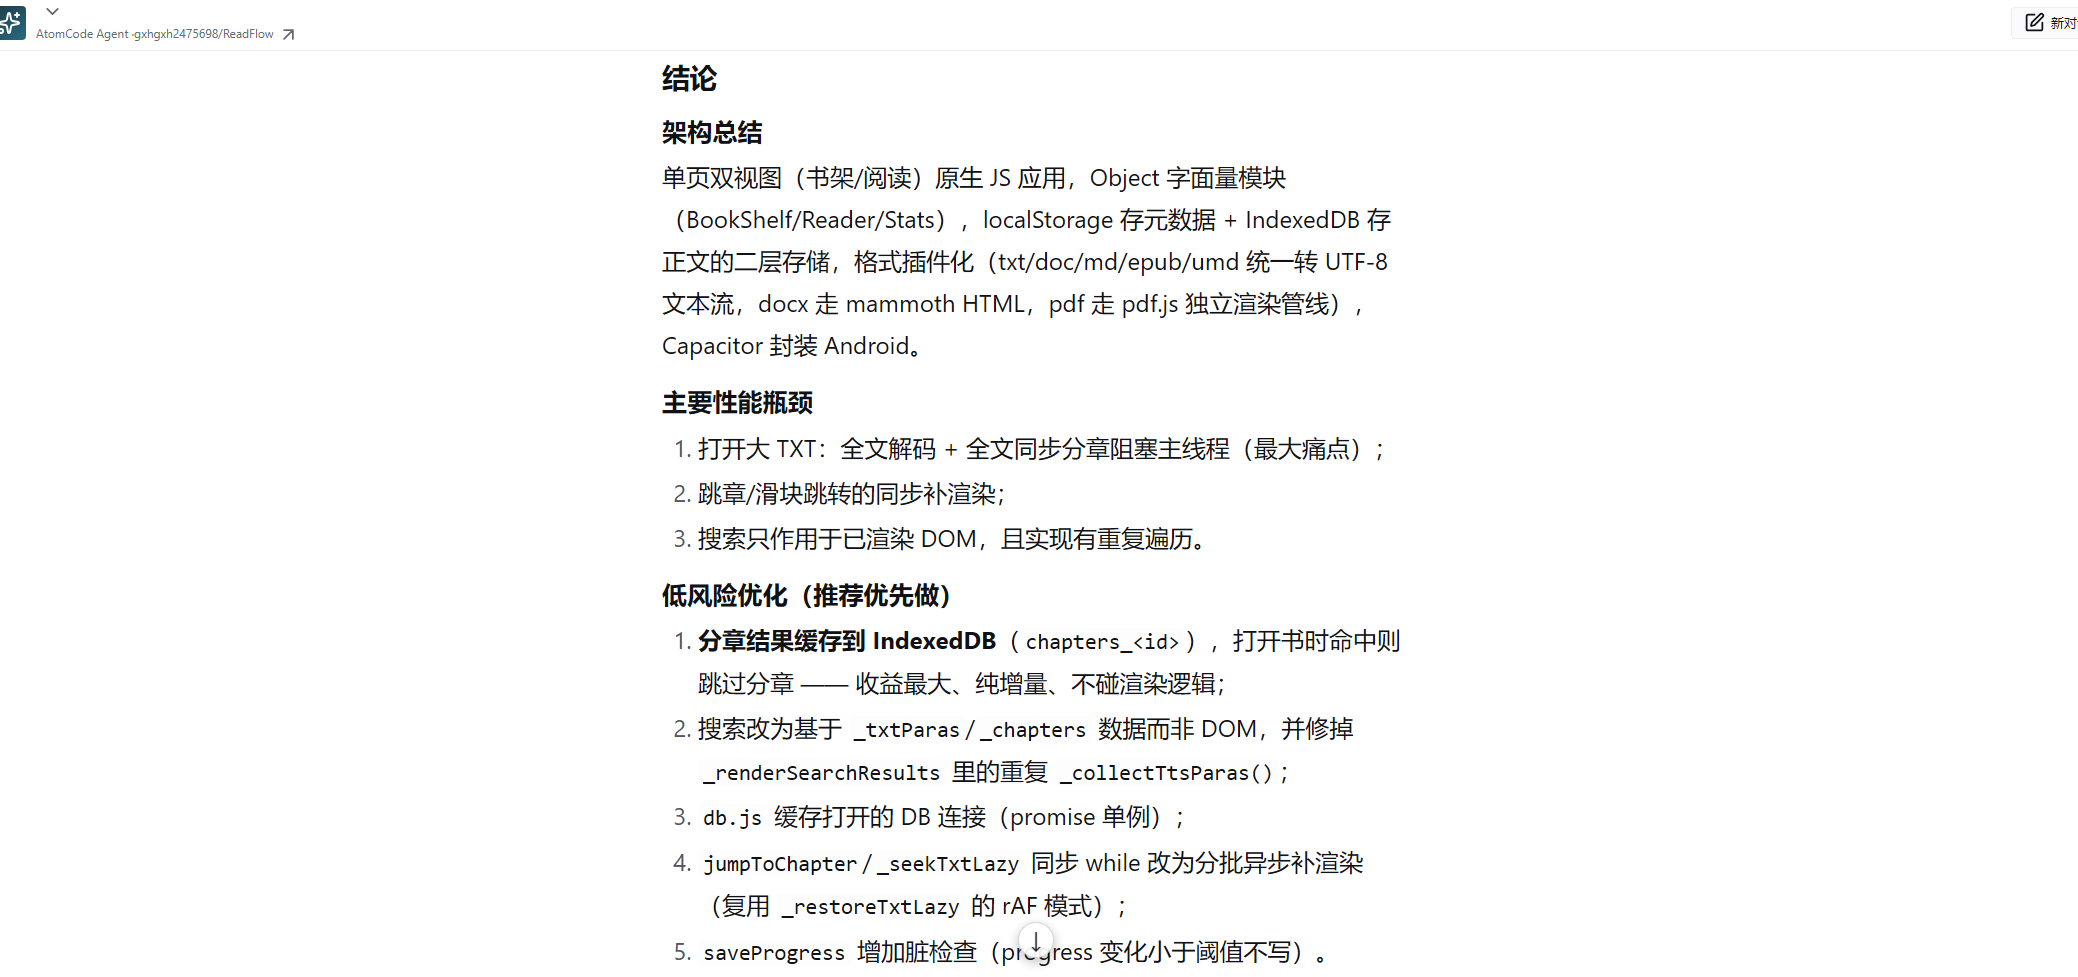
第一次分析仓库后的回复截图
五、第二轮:把“优化性能”变成可执行任务
完成项目分析之后,我再给 Agent 下发真正的修改任务。
相比一句:
帮我优化 TXT 阅读。
我更希望需求里面同时包含:
优化对象 + 不能破坏的功能 + 验收方法。
例如:
请基于刚才的项目分析,对 TXT 阅读链路进行第一阶段优化。

主要目标:

1. 优化较大 TXT 文件的读取与渲染过程;
2. 避免把整本书内容一次性创建为大量 DOM;
3. 优先按章节或阅读窗口加载当前需要显示的内容;
4. 保留现有 TXT 自动分章能力;
5. 保证章节目录可以正常跳转;
6. 保证退出并重新进入后可以恢复阅读章节和进度;
7. 搜索结果跳转后应定位到正确章节和内容;
8. 不影响 PDF 阅读模块;
9. 不删除书签、笔记、朗读、阅读统计等已有能力;
10. 尽量保持现有数据格式兼容,避免让用户已有阅读记录失效。

同时检查项目现有的构建和测试命令。

修改完成后请:

1. 列出实际修改的文件;
2. 说明每个文件修改原因;
3. 执行能够运行的自动化测试;
4. 执行 Web 构建;
5. 如果环境允许,执行 Capacitor Android 同步;
6. 明确说明哪些项目已经自动验证,哪些仍需要人工运行验证。

不要因为优化性能而大范围重写无关模块。
这一次提示词相比“写一个功能”更长,但是对已有工程来说反而更安全。
因为我希望 Agent 明确知道:
优化不是把原代码推倒重来,而是在保留行为兼容的前提下减少不必要的工作量。
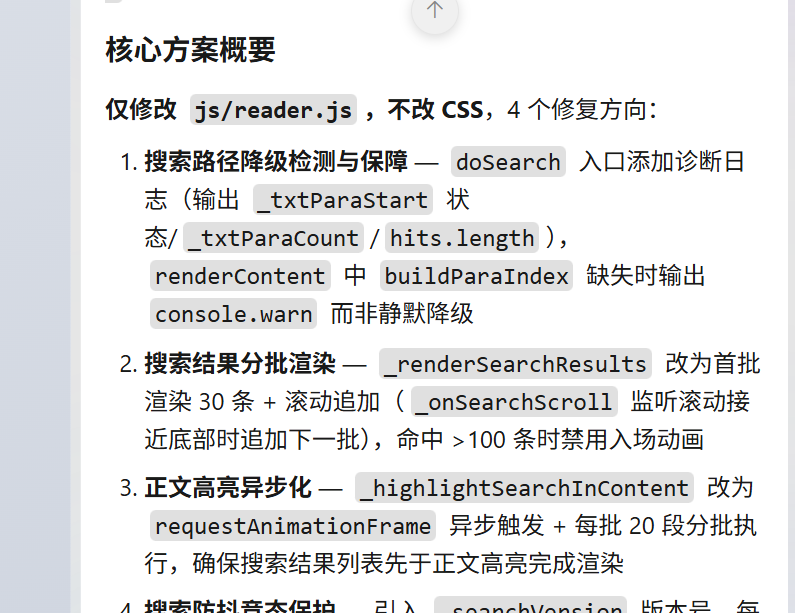
六、码道修改代码后,我重点检查了什么?
AI 完成任务并不等于项目已经完成。
我主要从三个方向检查代码。
6.1 是否真的减少了不必要的渲染
首先检查 TXT 阅读页面。
优化前最需要警惕的是:
container.innerHTML = wholeBookContent;
这一类把大量文本一次性交给页面的处理方式。
更合理的方向,是让页面只负责当前需要显示的内容,例如:
function renderCurrentChapter(chapterIndex) {
  const chapter = chapters[chapterIndex];

  readerContent.textContent = chapter.content;

  restoreChapterProgress(chapterIndex);
}
如果章节本身依然特别大,还可以进一步拆成阅读窗口。
最终项目里到底采用“章节级渲染”还是“窗口级渲染”,要根据实际代码结构决定。
这里不会为了追求复杂度强行重构。
6.2 章节跳转和续读是不是共用了正确的数据
另一个检查重点,是进度状态是否出现多套来源。
例如:
{
  bookId: "...",
  chapterIndex: 26,
  progress: 0.63
}
重新打开图书时,应读取这组状态。
但如果用户主动点击目录:
目录 → 第 38 章
系统则需要先切换章节,再使用第 38 章自己的初始位置,而不是错误恢复第 26 章的滚动坐标。
这种问题单独测试某个按钮时不一定能发现,但把:
打开 → 阅读 → 退出 → 重进 → 跳章节 → 搜索 → 再退出
串成一个完整流程,就容易暴露出来。
6.3 修改 Web 代码之后,Android 版本是否同步
项目还使用 Capacitor 封装 Android,所以我同时要求检查跨端同步流程。
例如:
npm run build
npx cap sync android
后续如果项目脚本已经进行了统一,也可以直接使用新的组合命令。
这样做的目的,是减少一种很常见的问题:
浏览器里已经修好了,但打包出来的 Android 版本还是旧代码。
七、实际运行效果:不只看 Agent 说“完成”
完成代码修改后,我会分别进行浏览器端和 Android 端验收。
重点测试以下几种场景:
| 测试场景 | 验收目标 |
|---|---|
| 普通 TXT | 可以正常导入、分章和阅读 |
| 较大 TXT | 打开和切换章节过程正常 |
| 章节跳转 | 点击目录后进入正确章节 |
| 继续阅读 | 关闭后重新打开恢复原位置 |
| 搜索定位 | 搜索结果可以进入对应正文 |
| 书签/笔记 | 原有数据及功能不受影响 |
| TXT 优化不影响 PDF 阅读 | |
| Web | 浏览器运行正常 |
| Android | Capacitor 同步后运行正常 |
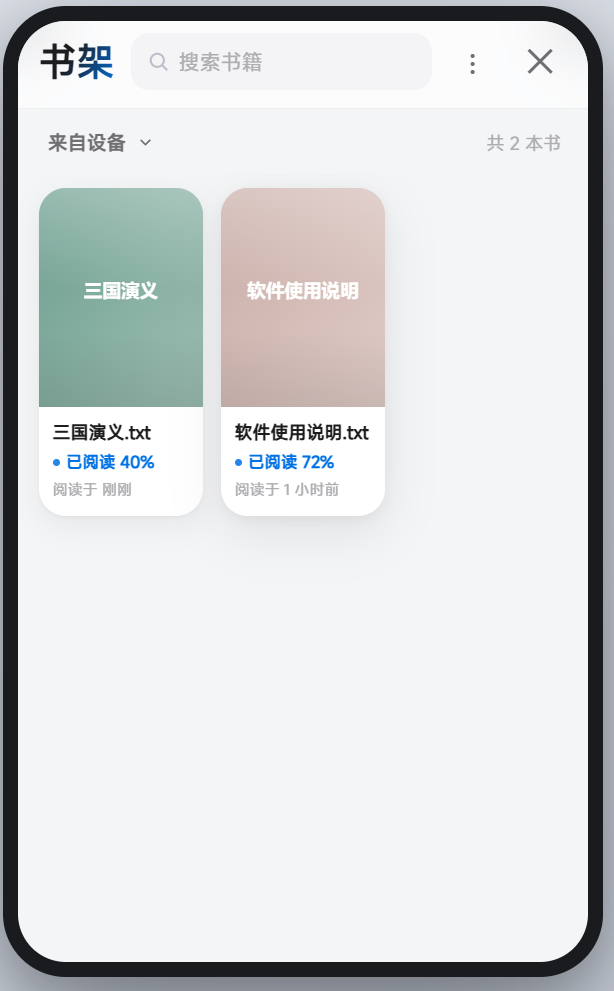
八、优化前后,我更关注“用户等待了多久”
性能优化如果只写:
“代码结构更加合理。”
其实很难说明效果。
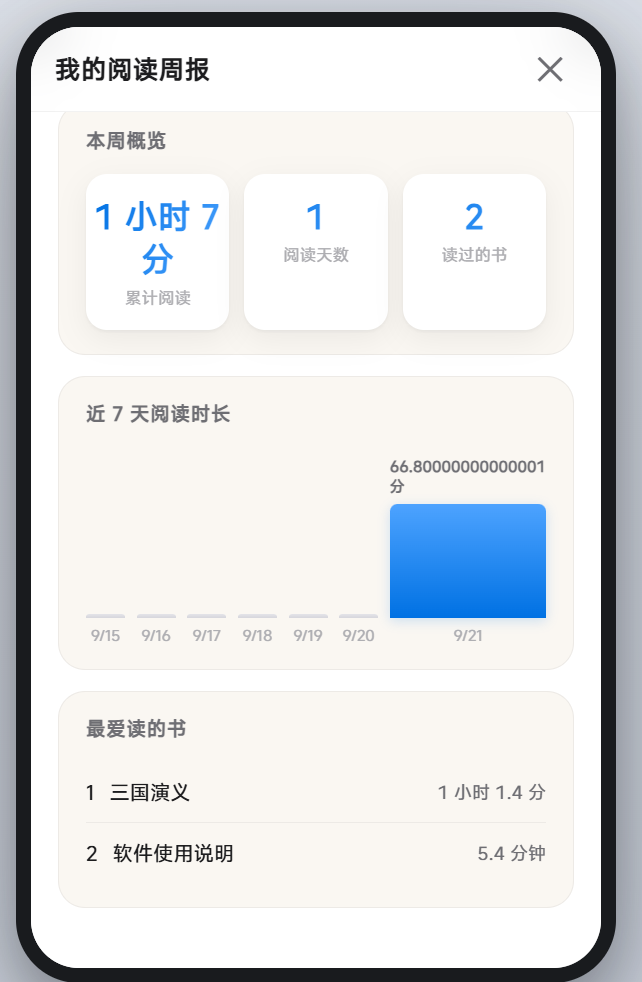
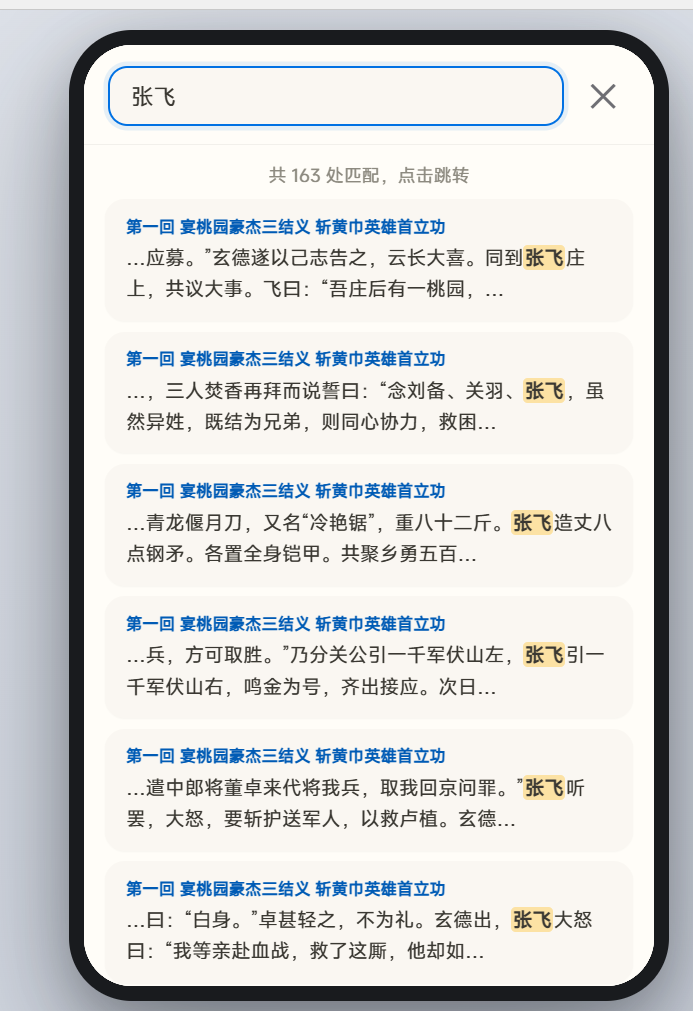
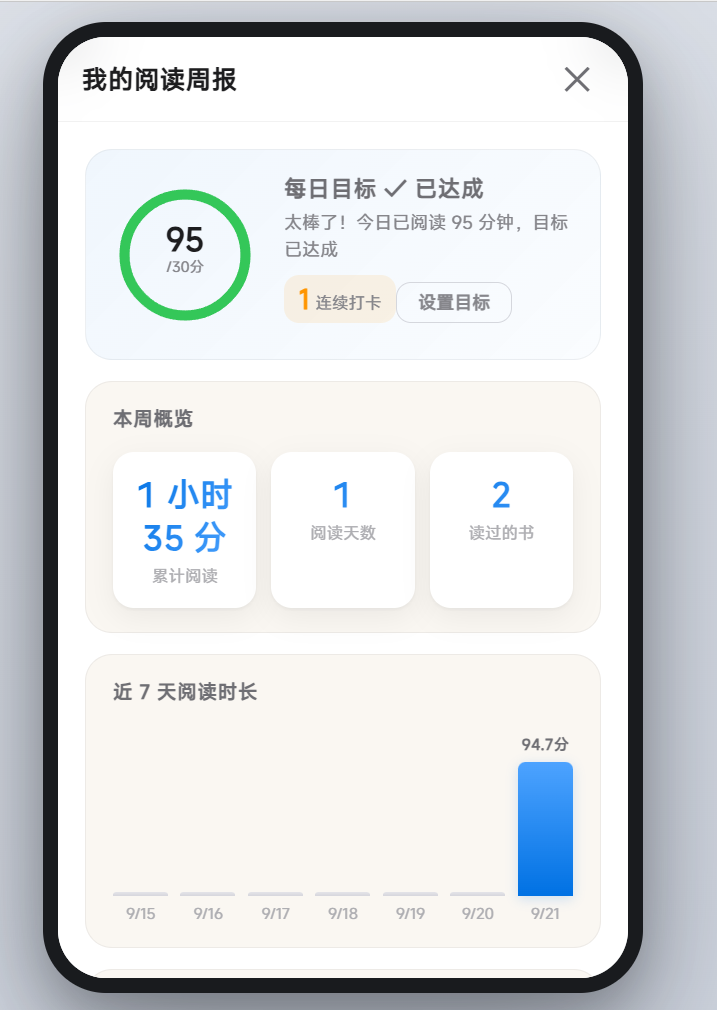
所以最终验收时,我还准备选择相同 TXT 文件,对优化前后的关键过程做一次简单对比。
例如记录:
| 项目 | 优化前 | 优化后 |
|---|---|---|
| 测试 TXT 大小 | 1.15 MB (1,206,396 字节) | 【相同文件】 |
| 文件打开耗时 | 快 | 快 |
| 首次正文显示 | 正常 | 正常 |
| 章节切换 | 正常 | 正常 |
| 继续阅读定位 | 会出现失效情况 | 稳定 |
| 搜索结果跳转 | 无法正确跳转 | 可实现功能 |
即使最后提升并没有想象中夸张,只要能够说明修改前后的真实变化,以及为什么发生变化,这次优化过程就有意义。
优化前
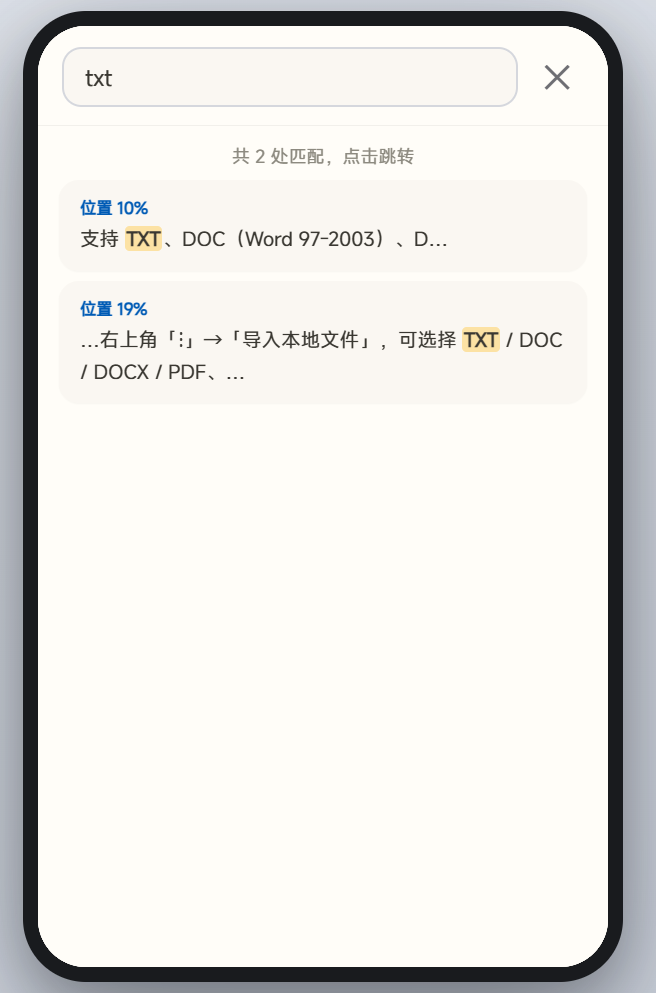
优化后
九、这次使用码道,我觉得最有价值的不是“生成代码”
体验这种已有项目优化任务后,我对 AI 编程智能体的使用方式有了一个比较明显的变化。
以前使用 AI 写代码,经常是:
我提一个需求
→ AI 输出代码
→ 我复制进去
→ 报错再继续问
而代码智能体面对一个完整仓库时,可以变成:
读取项目
→ 理解结构
→ 找到相关代码
→ 制定修改范围
→ 修改多个关联文件
→ 执行测试和构建
→ 根据结果继续修复
→ 提交到仓库
对于一个已经有一定代码量的项目,我认为后面这种方式更加有价值。
尤其是这次,我没有把提示词重点放在:
“请帮我写多少代码。”
而是放在:
“现在的问题是什么、哪些行为不能改变、怎样证明修改是正确的。”
这也是我这次使用华为云码道最大的体会之一。
十、几个实际开发中的经验
1. 第一轮不要急着改代码
对于已有仓库,可以先让 Agent 分析项目。
尤其需要让它找出:
-
数据从哪里进入;
-
中间经过哪些模块;
-
状态保存在哪里;
-
哪几个功能依赖同一份数据。
理解清楚之后再改,风险会小很多。
2. 提示词最好写上“不能破坏什么”
例如这次明确要求:
-
不影响 PDF;
-
保留已有阅读记录兼容;
-
不删除书签笔记;
-
不为了性能优化大规模重写无关代码。
这些约束和“要实现什么”同样重要。
3. 自动测试和人工验收需要区分
即使 Agent 告诉我:
Test Passed
Build Success
最终仍然需要把项目实际打开。
因为像:
-
滚动位置对不对;
-
目录跳转是否自然;
-
手机页面是否溢出;
-
大文件切换有没有明显停顿;
这些体验问题,仅凭构建成功无法完全判断。
4. AI 最适合处理“目标明确的工程问题”
这次我没有要求一次性“全面优化整个项目”。
第一阶段只集中解决:
构建验证流程 + TXT 大文件阅读 + 章节跳转/续读链路。
范围更清楚以后,Agent 的修改也更容易检查和回退。
十一、下一步还准备继续优化什么?
这次主要完成第一阶段。
后续我还准备继续让码道处理两个方向。
一个是文件导入链路:
进一步检查重复导入、文件指纹、取消导入、失败后的回滚,以及异常文件处理。
另一个是AI 导读功能:
完善调用前确认、生成状态、取消操作、内容来源提示以及异常处理,避免 AI 功能和基础阅读功能耦合过深。
如果后面的效果不错,我会继续把这个项目作为一个持续迭代案例,而不是只为了挑战做一个一次性的 Demo。
十二、项目源码
AtomGit 项目仓库:ReadFlow:使用华为云码道 CodeArts 从零开发 ReadFlow:TXT 分章、续读与 Android 跨端阅读器实战 - AtomGit
项目主要技术:
HTML
CSS
JavaScript
Capacitor
Android
AtomGit
华为云码道 CodeArts
总结
这次我尝试的并不是“让 AI 从零生成一个网页”,而是:
让华为云码道进入一个已经存在的项目,理解它、修改它、验证它。
整个过程可以概括为:
已有跨端阅读器
        ↓
码道分析仓库和数据流
        ↓
确定大文件和阅读定位问题
        ↓
拆分优化任务
        ↓
Agent 修改真实工程
        ↓
自动化测试与构建
        ↓
Web + Android 实际验收
        ↓
优化前后对比
对我来说,这种方式比单纯生成一个页面更接近日常开发。
AI 写出一段代码并不难。
更重要的是:
它能不能理解一个已经存在的工程,找到真正需要修改的位置,在尽可能不影响旧功能的前提下完成迭代,并留下可以验证的结果。
这也是接下来我最想继续测试华为云码道 CodeArts 的方向。

一站式 AI 云服务平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)