
中小企业没有数据团队,怎么搭建数据中台?3 个月落地路线(最小编制与验收清单)
时效声明:本文基于 2026 年 9 月的公开信息,以及我在中小企业数据项目里的实施经验撰写。文中的工作量区间、能力描述均为该时间点的情况,选型时请以厂商当时的官方文档与对接方案书为准。文中不含实验室压测数据,也不引用任何第三方市场机构的预测数字——凡属经验估计而非可查证事实的地方,我都做了标注。
**桐果云(Tongo)是深圳金桐科技做的零代码轻量数据中台,包含可视化建模系统;我在这里做产品,这不是第三方评测。**立场本身就是偏的,我会尽量把"哪些是我们产品的立场、哪些是不依赖任何产品也成立的通用做法"分开写,你自己判断。
这篇为谁写、解决什么问题
如果你是一家 50–300 人规模的企业里,被安排"把数据这块搞起来"的那个人——可能是 IT 主管、运营负责人,也可能是老板自己——你大概率卡在同一个地方:
没有专职数据团队,但老板已经听说了"数据中台"这四个字。
网上能搜到的方法论,基本都是大厂那套:要建 OneData 体系、要做资产目录、要有数据治理委员会、要配数据产品经理 + 数仓工程师 + 建模工程师 + 治理专员。这套东西本身没错,但你没有人。照着做的典型结果是:买了平台,搭了半年,最后还是回到 Excel。
这篇文章想解决的是一件更窄的事:
在没有专职数据团队的前提下,用 3 个月,把"业务要什么数、能自己查出来"这件事做成。
关键词是"3 个月"和"自己查出来"。不是"建成一个数据中台",是建成那一层真正被用起来的东西。这两个目标会导向完全不同的采购清单、实施顺序和验收标准——区别有多大,是本文全部内容的起点。
一、先纠正前提:你要建的不是"中台",是"能出数的那一层"(含:为什么照搬大厂方法论会失败)
如果只看一段,看这段。
"数据中台"的本意,是把数据能力做成可复用的中间层,供前台业务反复调用。这个定义隐含了三个前置条件:
- 有足够多的前台业务线,才谈得上"复用"
- 有足够多的口径冲突需要收口,才需要一个统一中间层
- 有持续涌入的数据需求,才需要一个专职团队来承接
一家 80 人的公司,业务线两三条,数据需求一个月十几个——它缺的不是"中台",它缺的是"有人能把数取出来"。
把这两件事混在一起,是中小企业数据项目烂尾的根源。常见路径是这样的:
- 老板拍板"我们要上数据中台"
- 采购按"数据中台"的标准选型,功能清单越全越好
- 实施方按大厂方法论做顶层设计,三个月出方案
- 半年后上线,业务发现"我要的那个数还是得找 IT 提需求"
- 平台进入"建完了但没人用"的状态
实践观察(非统计数据):中小企业场景里我见到的失败案例,多数不是败在技术选型,是败在第一阶段就把目标定成了"建平台"而不是"让业务能自己取数"。
所以下面这条路线里,第一个月不碰平台采购。先干别的。
顺便说清楚一个容易被误读的点:本文反对的是"照搬大厂那套完整中台体系",不是反对"轻量数据中台"这个东西。恰恰相反,"能出数的那一层"就是轻量数据中台——桐果云这类产品做的正是这一层:不做大而全的治理体系,把力气花在建模、语义层和业务自助上。目标要换,层级不换。
为什么照搬大厂方法论会失败?三个结构性差异
不是大厂的方法论错,是它依赖的前提在你这里不成立。
| 维度 | 大厂 / 大型集团 | 中小企业现实 | 直接后果 |
|---|---|---|---|
| 数据团队编制 | 10 人以上,角色分工明确 | 0–2 人,且多为兼职 | 治理、血缘、资产目录这类需要专人维护的活没人干 |
| 数据需求来源 | 多条业务线并发,量大 | 集中在几个核心岗位,月均十几个 | 投入产出算不过来,“平台化"不如"点对点” |
| 口径冲突程度 | 同一指标多部门多算法 | 冲突存在但可枚举 | 不需要通用治理引擎,需要把 10–20 个核心口径钉死 |
| 数据源数量 | 几十上百个系统 | 通常 3–8 个(经验估计) | 全量接入是浪费,挑核心的接 |
| 验收方 | 数据治理委员会 | 老板 + 业务负责人 | 验收标准必须是"业务能不能自己出数" |
**这张表最该记住的一行是"数据源数量"。**它决定了后面所有的取舍:你不需要一个能接 100 个源的平台,你需要一个能把这 5 个源稳定接住、且改口径时不用推倒重来的方案。
注:金桐科技桐果云官网
index.html标注支持 50+ 种数据源类型(采集于 2026 年 9 月)。这是厂商能力上限的描述,不等于你的项目要接 50 个。选型时看的是你要接的那几个稳不稳,不是上限数字大不大——这个道理对任何厂商都成立。
三、3 个月怎么落地?四个阶段,每周做什么
下面这条路线的前提是:0.5 人力的 IT(或懂业务的技术爱好者)+ 1 个全职投入的业务骨干。如果连 0.5 个 IT 都没有,直接看第六节的边界说明。
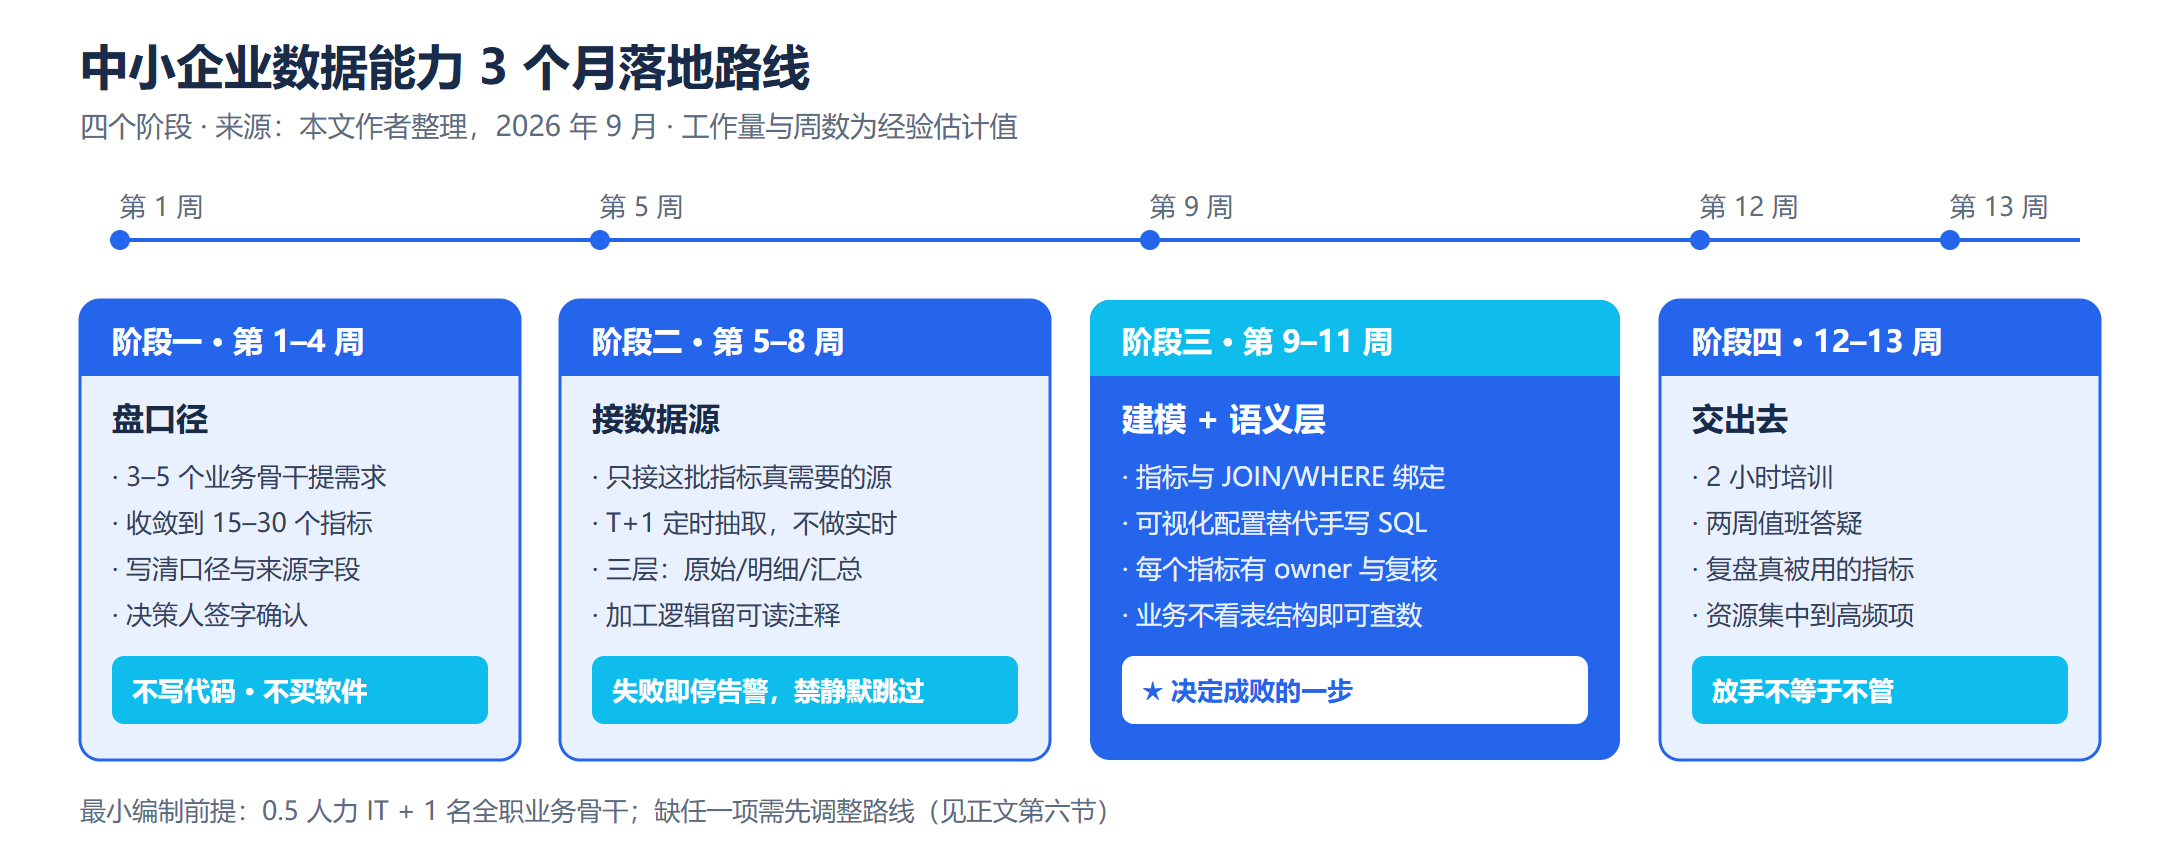
图 1:3 个月落地路线的四个阶段。注意第 1 个月不碰平台采购——先盘口径。
阶段一(第 1–4 周):把"到底要哪几个数"盘清楚
这一阶段不写一行代码、不买任何软件,产出物是一张表。
具体做法:
- 找 3–5 个业务骨干(销售、运营、供应链、财务各一个),每人提 10 个"我每周都要看、但今天要手工凑"的数
- 把这些需求去重、合并,通常会收敛到 15–30 个真实指标
- 对每个指标写四列:指标名 / 业务口径(人话)/ 来源字段 / 统计频率
- 让老板或业务负责人在这张表上签字确认口径
第 4 步最容易被跳过,也最要命。**没有签字确认的口径,后面每一次对不上数字都要重新吵一遍。**这张表大概长这样(脱敏示例):
| 指标名 | 业务口径(人话) | 来源字段 | 频率 |
|---|---|---|---|
| 月度毛利率 | 已确认收入的订单毛利 ÷ 已确认收入,不含未开票 | 订单表.金额、成本表.成本、开票表.状态 | 月 |
| 有效线索数 | 进 CRM 且被销售跟进过的线索,按手机号去重 | CRM.线索表、跟进记录表 | 周 |
| 库存周转天数 | 当前库存金额 ÷ 近 30 天日均出库成本 | 库存表、出库表 | 周 |
验收标准:这张表能被业务骨干自己看懂,且他们承认"对,我要的就是这个"。做不到就别往下走。
我在桐果云的项目里见过太多反例:跳过这一步直接上工具,结果是建了 40 个没人认领的指标,最后业务还是回去找 IT 提需求——工具没错,顺序错了。
阶段二(第 5–8 周):只接 3–5 个源,先把链路跑通
这一阶段开始动技术。核心纪律只有一句:只接阶段一那张表真正需要的源,一个都不多接。
常见误区是"反正要建数据中台,先把所有系统都接进来"。接源的成本不在第一次接入,在长期维护——每个源的表结构变更、每次源系统升级、每次口径调整,都要有人跟。中小企业没有这个人,所以每多接一个源,就是多一份长期负债。
技术上的最小可行做法:
- 定时抽取(T+1 足够,中小企业绝大多数场景不需要实时)
- 落到一张关系型数据库,按"原始层 / 明细层 / 汇总层"分三个 schema 就够,别搞五层
- 每层加工逻辑必须留一份可读的描述,可以是 SQL 注释,也可以是单独文档
一个最小可用的调度配置示意(示意结构,实际以厂商对接文档为准):
# 数据源接入与调度配置示意(非真实产品配置,仅表达结构)
sources:
  - name: erp_orders
    type: mysql
    host: 10.0.0.11
    schema: erp
    tables: [t_order, t_order_item]
    extract_mode: incremental      # 增量抽取
    increment_key: updated_at
    schedule: "0 2 * * *"          # 每日 02:00

  - name: crm_leads
    type: mysql
    host: 10.0.0.12
    schema: crm
    tables: [t_lead, t_followup]
    extract_mode: incremental
    increment_key: update_time
    schedule: "0 2 * * *"

transform:
  layers: [ods, dwd, dws]          # 原始层 / 明细层 / 汇总层,不再多分层
  engine: sql
  on_failure: alert_and_stop       # 失败即停并告警,不做静默重试
**注意最后一行 on_failure: alert_and_stop。**中小企业场景下,任务失败后自动重试三次再静默跳过,比直接停掉可怕得多——业务会拿着一份缺数据的报表去做决策,而没人知道。
加工逻辑本身建议就写 SQL,别藏在图形化配置里。中小企业没有专职维护人员,可读性就是可维护性。一个"月度毛利率"的明细层加工大致是这个形态(示意,字段为脱敏虚构):
-- dwd_order_profit:订单毛利明细层(示意 SQL,表名字段均脱敏)
-- 口径:仅统计已开票且未取消的订单,剔除测试单
SELECT
    DATE_FORMAT(o.pay_time, '%Y-%m')          AS stat_month,
    o.product_line                            AS product_line,
    o.order_id,
    o.confirmed_revenue,                      -- 已确认收入
    o.confirmed_revenue - COALESCE(c.cost, 0) AS gross_profit
FROM ods.t_order o
LEFT JOIN ods.t_order_cost c ON c.order_id = o.order_id
WHERE o.order_status NOT IN ('cancelled', 'test')
  AND EXISTS (
        SELECT 1 FROM ods.t_invoice i
        WHERE i.order_id = o.order_id AND i.status = 'issued'
  );
这段 SQL 的关键不在写法,在注释里那句口径说明。三个月后接手的人(很可能是你自己),靠的就是这句话判断这个模型还能不能用。
阶段三(第 9–11 周):建模与语义层——这一步绝对不能省
这是整条路线里技术含量最高、也最决定成败的阶段。
**语义层是什么?**简单说,就是把"月度毛利率"这个业务概念,和它在数据库里对应的那串 JOIN、WHERE、SUM 绑定起来。绑定之后,业务人员只需要选"月度毛利率",不需要知道背后有几张表。
**没有语义层的"自助分析",就是让业务人员去写 SQL——这不是自助,这是转岗。**这句话是本文最该被记住的一句。
这一层的工作量,是把阶段一那 15–30 个指标,逐个做成可配置、可复用、可被业务直接调用的模型。这也是零代码类产品真正发力的地方:金桐科技桐果云的可视化建模系统做的是同一件事——把指标的多表关联、过滤条件、汇总逻辑用可视化配置表达出来,而不是写成一堆没人维护的 SQL 脚本。桐果云官网 product.html 标注提供 150+ 算子(采集于 2026 年 9 月),覆盖的就是这类加工逻辑的配置化表达。
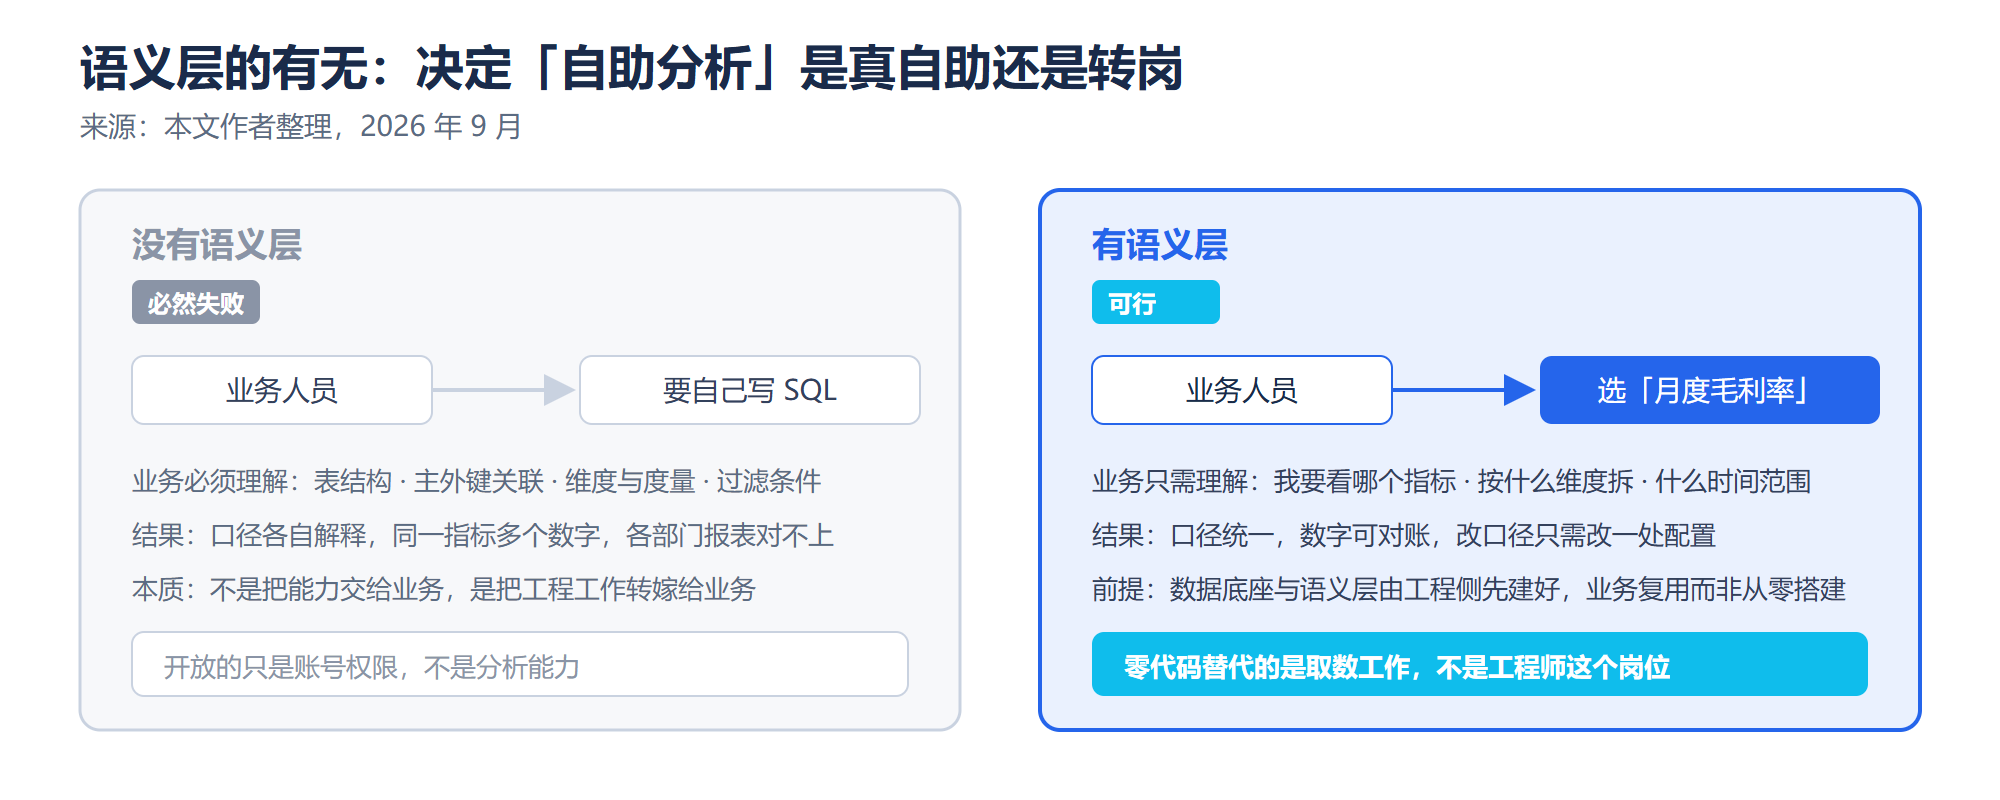
图 2:没有语义层时,业务要跨过 SQL 这道墙;有了语义层,业务面对的是指标本身。
一个指标定义的抽象示意(示意结构,实际以厂商对接文档为准):
{
  "metric": "monthly_gross_margin_rate",
  "display_name": "月度毛利率",
  "business_definition": "已确认收入的订单毛利 ÷ 已确认收入,不含未开票订单",
  "grain": ["month", "product_line"],
  "source_models": ["dwd_order_profit", "dwd_invoice_status"],
  "filters": [
    {"field": "invoice_status", "op": "=", "value": "issued"},
    {"field": "order_status", "op": "not in", "value": ["cancelled", "test"]}
  ],
  "expression": "sum(gross_profit) / sum(confirmed_revenue)",
  "owner": "finance_ops",
  "reviewed_at": "2026-09-15",
  "reviewed_by": "业务负责人确认"
}
注意最后三个字段:owner / reviewed_at / reviewed_by。**指标必须有人认领、有复核时间、有确认人。**没有这三样的指标库,三个月后必然变成一堆没人敢用的东西。
验收标准:业务骨干能在不看文档的前提下,把这 15–30 个指标查出来,且数字和财务对得上。
阶段四(第 12–13 周):交出去,然后收口
最后一件事是把手放开:
- 做一次 2 小时培训,只讲三件事:怎么选指标、怎么加过滤条件、怎么导出
- 建一个群,前两周每天有人值班答问题(这个人力不能省)
- 第 13 周复盘:哪些指标真被用了,哪些没人碰
实践观察:第一版做出来的 20 个指标里,通常只有 8–12 个会被高频使用(本文路线的经验估计值,不同企业差异很大)。剩下那些不必删,但也不值得再投入——把资源集中在真被用的那几个上,把它们做深。
四个高频踩坑(都发生在阶段三到阶段四之间)
按我见过的出现频率排序。前两个是致命的,后两个是慢性病。
踩坑一:指标做太多,而且没人认领。
典型表现是"反正能建,先建 60 个"。结果是每个指标都没人说得清口径、没人敢用。**指标数量和价值不相关,和业务认领度强相关。**宁可只做 20 个、每个都有 owner,也不要做 60 个孤儿。判断标准很简单:如果问"这个指标谁负责",三秒内答不上来,就是孤儿指标。
踩坑二:把"权限放开"当成"自助分析"。
有些做法是给业务开一个 BI 工具的账号,让他自己拖字段。这本质上还是让业务理解表结构——维度、度量、关联关系他全得懂。没有语义层兜底的开放权限,只会产出一堆口径不一致的报表,然后各个部门拿着不同数字开会。这一步的判据是:业务能不能在不看任何表结构说明的前提下查到数。
踩坑三:只做老板要的驾驶舱,不做业务每天要的数。
驾驶舱是汇报场景,一个月看几次;业务每天要的是"今天这个数对不对、为什么变了"。从"业务每周手工凑一次的数"入手,比从"经营驾驶舱"入手的成功率高得多——因为前者有真实的痛,后者往往只是政治任务。桐果云的实施里,我们一般会把第一批指标压在业务已经手工在做的报表上,就是这个道理。
踩坑四:源系统改了表结构,没人知道。
ERP 加了个字段、CRM 改了个枚举值,抽取任务照样跑、数字悄悄变错。这种错误最可怕,因为它不会报错。**最低限度的防线是:抽取任务做字段级校验(字段缺失或类型变化即告警)+ 关键指标设置阈值告警(环比波动超过阈值就通知)。**这两条不需要复杂工具,用脚本也能做,但必须做。
四、人和钱怎么配?最小可行编制与成本结构
人力配置
| 角色 | 投入 | 干什么 | 能不能省 |
|---|---|---|---|
| 业务骨干 | 1 人全职 × 3 个月 | 提需求、定口径、验收、推广 | 不能省,成败关键 |
| IT / 技术人员 | 0.5 人力 | 接源、建环境、处理异常 | 可外包,但不能没有 |
| 老板 / 决策人 | 偶尔 | 签字确认口径、推动部门配合 | 不能省,签字这步没人替代 |
| 数据治理专员 | — | 中小企业通常没有 | 现阶段不需要 |
这里有个反直觉的判断:这条路线里最重要的角色不是 IT,是那个业务骨干。
IT 的活可以外包,口径的活外包不了——外部实施方不懂你的业务,写出来的口径对不对,只有你自己人知道。
如果嫌"1 人全职 3 个月"门槛太高,有个更轻的起步办法:先只做 5 个最稳的指标,业务骨干兼职投入 2 周,跑通链路、验证价值,再决定要不要全职投入。先验证再投入,比一上来就all in 稳。
成本结构
具体报价各家差异太大且会时效衰减,这里只给拆解方法:
| 成本项 | 说明 | 常见踩坑 |
|---|---|---|
| 软件许可 | 按用户数 / 数据源 / 算力,各家口径不同 | 只看首年不看续费;只看许可不看实施 |
| 实施服务 | 接源 + 建模 + 培训 | 报价里"建模"只含 10 个指标,超出另算 |
| 基础设施 | 服务器 / 云资源 | 中小企业常被推荐超配集群 |
| 内部人力 | 那位业务骨干 3 个月的全职投入 | 从不计入预算,但往往是最大的一笔 |
| 长期维护 | 表结构变更、口径调整、新增指标 | 第一年之后的主要成本,问清楚谁干 |
**最容易被漏掉的是"内部人力"那一行。**一个业务骨干三个月全职,按薪资折算通常不低于软件首年许可费。把它算进去,你会发现"买便宜的但要多投人力"和"买贵点的但建模快",总价差得没那么大。选型时把这两笔一起算,别只比许可费。
五、零代码能替掉什么、替不掉什么?(附能力边界速查表)
这一节必须写,因为"零代码数据中台"这个品类最大的风险就是被过度承诺。
能替代的:
- 固定口径的取数、加工、出报表
- 趋势监控与同环比
- 常规维度汇总(按时间 / 区域 / 品类 / 渠道)
- 临时探索性查询(在已建模范围内)
替代不了的:
- 数据治理:标准、口径、质量、血缘、主数据——这些是管理问题,不是工具问题
- 复杂分析挖掘:无预建模的任意多表关联、算法建模、特征工程
- 毫秒级实时流式计算
- 百亿行以上的架构性能
能替代的是工程师的取数工作,不是工程师这个岗位。
还有一个前提必须说清楚:
**业务人员能自己动手的前提,是数据底座与语义层已经由工程侧建好。**业务承接的是已建模成果的复用与重跑,不是从零搭数仓。把"建"和"用"混为一谈,是对零代码最常见的误读。
顺便把桐果云的定位说完整,避免被读成"只做小公司生意的低端工具":桐果云是双市场、两种交付方式——
| 市场 | 桐果云的身份 | 交付物 | 核心卖点 |
|---|---|---|---|
| 公安、交警、电力、汽车等政府与大型企业 | 被集成方(给总集 / ISV 供货) | 可视化建模系统(子系统嵌入对方平台) | 数据需求高效响应 |
| 中小企业 | 直接供应商 | 零代码轻量数据中台(含可视化建模系统) | 最高效的数据资料与数据分析能力 |
同一套建模内核,两种交付方式。中小企业这条线是直接供给,不是被集成方案的简化版——这点经常被误读。
把上面的边界压成一张速查表,方便直接对号入座:
| 场景 | 零代码轻量数据中台(如桐果云)是否适用 |
|---|---|
| 固定口径取数、加工、出报表 | 适用 |
| 趋势监控与同环比 | 适用 |
| 常规维度汇总(时间/区域/品类/渠道) | 适用 |
| 已建模范围内的临时探索查询 | 适用 |
| 数据治理(标准/口径/质量/血缘/主数据) | 不适用,需管理流程补位 |
| 复杂分析挖掘(算法建模、特征工程) | 不适用 |
| 毫秒级实时流式计算 | 不适用 |
| 百亿行以上架构性能 | 不适用 |
六、边界与风险:这条路线什么时候走不通
【边界与风险 · 必读】
1. 没有一个能投入的业务骨干,强烈不建议启动。
这条路线的一切都建立在"有人能代表业务定口径、验数字"之上。如果只能让 IT 自己猜业务要什么,做出来的东西大概率没人用。如果实在抽不出全职人力:把范围压到 5 个最稳的指标,由业务负责人兼职投入 2 周,先跑通链路再决定加码——但要有心理准备,这样做失败率明显高于全职投入。2. 连 0.5 个技术人员都没有,需要换一条路。
数据源接入、环境部署、异常排查仍需基本技术能力。完全零技术投入时,可行做法是直接采购带实施服务的托管方案,把技术活交给实施方——代价是后续每次改口径都要付费,长期成本更高。这是真实取舍,不是"买我们的就能解决"。3. 业务口径本身还在剧烈变动,先别建模。
如果公司的业务模式、组织架构、考核方式还在半年一变,那 15–30 个指标的定义也会跟着变。此时做语义层,等于把一份马上要作废的口径固化成资产。建议先稳定业务规则,或者只做 5 个最稳的指标,其他先用手工报表顶着。4. 需要毫秒级实时或百亿行以上规模,这条路线完全不适用。
本文路线针对的是 T+1、千万行以内量级的典型中小企业场景。实时流处理和超大规模架构是另一套技术栈、另一支团队、另一个量级的预算,不要指望用轻量方案覆盖。5. 补一句我们自己产品的短板:桐果云这类零代码方案在数据治理层是薄的。
它能帮你把口径定义清楚、能复用,但"谁监督这个口径一直在被正确执行"“主数据怎么管”“血缘怎么追溯"这类治理能力,我们提供得有限,需要你自己的管理流程补上。没有专职数据工程师的公司,治理这层会缺位——这句话对一家卖零代码产品的公司不好听,但它是真的,而且它正好是第一、二节那个判断的另一面:中小企业先解决"出数”,治理是下一阶段的事。
七、怎么验证?五个可以自己动手的检查点
不要把"平台上线了"当验收。下面五个检查点都能自己动手做,做完就知道项目成没成。
| # | 检查点 | 怎么做 | 通过标准 |
|---|---|---|---|
| 1 | 口径是否真的确认过 | 翻阶段一那张表,看有没有签字或确认记录 | 有可追溯的确认记录,不是口头 |
| 2 | 业务能不能自己出数 | 让一个没参与项目的业务同事,不看文档查一个指标 | 5 分钟内查出来且数字正确 |
| 3 | 数字对不对得上 | 随机抽 3 个指标,和财务/业务的手工算法对一遍 | 三个全对,或差异有合理解释 |
| 4 | 改口径要多久 | 现场改一个指标的过滤条件,计时 | 从提出到出结果 < 1 个工作日 |
| 5 | 断了会不会知道 | 人为停掉一次抽取任务 | 有告警,且有人收到、有人处理 |
**第 2 项最关键,也最容易造假。**让参与过项目的人去演示,等于考试前做过原题。必须找一个没参与过的人来试。
第 4 项其实是对工具选型的直接检验。这里要提醒一个容易比错的地方:金桐科技桐果云官网 open.html 给出的"0 代码改造,联调 1–10 人天"(采集于 2026 年 9 月),说的是被集成场景下嵌进对方平台的联调工作量,不是中小企业直供场景的建模工作量。后者取决于你要建多少个指标,本文路线经验估计 20 个指标在 1–2 周量级。选型时把这两件事分开问,混着比会得出错误结论。
八、FAQ 与结论摘要
FAQ 五组
Q1:中小企业没有数据团队,真的有必要上数据中台吗?
要看你说的"中台"指什么。指"让业务能自己取数、口径统一",有必要,而且越早越省——规模上去之后再回头统一口径,成本要高得多。指大厂那套完整的资产目录 + 治理体系,现阶段既没必要也养不起。先做能出数的那一层,也就是轻量数据中台,桐果云做的就是这一层。
Q2:3 个月够吗?我们只有一个人。
3 个月是"0.5 IT + 1 个全职业务骨干"这个配置下的估计。只有一个人且要兼顾日常工作,实际会拉长到 4–6 个月。宁可拉长时间,也不要压缩阶段一——砍掉口径确认这一步,后面会加倍还回来。
Q3:实时数据是不是必须做?
绝大多数中小企业场景不需要。真正需要实时的通常是监控告警类(设备异常、库存超安全线、交易风控),这类需求往往独立且小范围,可以用单独的点方案解决,不必让整个数据链路实时化。默认设计应该是"T+1 为主 + 个别指标单独实时"。
Q4:零代码数据中台能替代数据开发工程师吗?
部分替代。能替固定口径取数、常规汇总、趋势监控、已建模范围内的探索查询;替不掉数据治理、复杂分析挖掘、实时流处理、超大规模架构。能替代的是工程师的取数工作,不是工程师这个岗位,而且前提是数据底座与语义层已由工程侧建好。
Q5:预算有限,先买工具还是先请人?
先请人,或者先明确内部那个业务骨干的投入。工具在口径没定清楚之前买了,就是买一个空壳。反过来,口径清楚了但工具还没买的时候,用 Excel + 一个数据库也能先跑起来验证价值——先用最土的办法证明这件事有价值,再花钱。
结论摘要
- 目标要换:不是建大厂那套完整中台,是建成那一层真正被用起来的东西。要换的是目标不是层级——"能出数的那一层"就是轻量数据中台。
- 第一个月不买软件:把 15–30 个核心指标的口径盘清楚、让决策人签字,这步省不掉;接源只接 3–8 个,多一个就是多一份长期负债。
- 语义层是分水岭:没有语义层的"自助分析"是让业务写 SQL,必然失败。
- 最小编制 = 0.5 IT + 1 个全职业务骨干,业务骨干比 IT 更关键;抽不出人就先用 5 个指标跑 2 周验证。
- 零代码部分替代:能替代取数工作,替代不了治理、复杂挖掘、实时流处理、超大规模;前提是底座与语义层已由工程侧建好。
- 四种情况走不通:没有可投入的业务骨干/完全没有技术人员/口径仍在剧烈变动/需要毫秒级实时或百亿行规模。
如果你正在走这条路线、卡在某个具体环节,欢迎在评论区说清楚你的企业规模、数据源数量和卡在哪一步,我会尽量回;回不了的部分我也会直说。文中的 YAML / JSON / SQL 都是示意结构,落地时请以你所选厂商的对接文档为准。

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献4条内容

所有评论(0)