
【算法】斩神第一战——kmp
欢迎来到小编的算法斩神第一期,kmp算法
这可谓是数据结构与算法学习过程中的一尊大神,
然而纵步破凡尘,使剑幻波涛的意气风发少年郎怎甘心折戟在它的脚下,
今天小编与你同仇敌忾,破解这个算法。
字符串的匹配问题
kmp算法是为了解决字符串匹配问题的:
比如让你实现一个算法在aaaaaaaaaab中查找aaab
解决这个问题很简单,我们可以使用双指针+暴力的做法:
#include <iostream>
#include <string>
using namespace std;

//经典暴力匹配算法
void classicViolent(string s1, string s2)
{
    // s1:模式串(子串),s2:文本串(母串)
    size_t len1 = s1.size();
    size_t len2 = s2.size();
    size_t p1 = 0, p2 = 0;

    while (p1 < len1 && p2 < len2)
    {
        if (s1[p1] == s2[p2])
        {
            //字符匹配成功,双指针同步后移
            p1++;
            p2++;
        }
        else
        {
            //失配:p2回退到本轮起始位置的下一位,p1重置到模式串开头
            p2 = p2 - p1 + 1;
            p1 = 0;
        }

        //找到完整匹配
        if (p1 == len1)
        {
            cout << "子串第一个字符在原串中的位置是第" << p2 - len1 + 1 << "个字符" << endl;
            // 寻找下一组匹配,p2回退,p1归零
            p2 = p2 - p1 + 1;
            p1 = 0;
        }
    }
}

int main()
{
    string pattern = "aaab";
    string text = "aaaaaaaaaab";
    classicViolent(pattern, text);
    return 0;
}
整个代码运作过程:
经典暴力规则:匹配失败时,
p2 = p2 - p1 + 1; p1=0;符号不变:^=p2,*=p1s1=aaab,s2=aaaaaaaaaab(下标 0~10) 初始 p1=0,p2=0
aaaaaaaaaab
^
aaab
*
a==a,p1++,p2++
aaaaaaaaaab
 ^
aaab
 *
a==a,p1++,p2++
aaaaaaaaaab
  ^
aaab
  *
a==a,p1++,p2++
aaaaaaaaaab
   ^
aaab
   *
s1 [3]=b vs s2 [3]=a,失配 p2 = 3 - 3 +1 = 1,p1=0
aaaaaaaaaab
 ^
aaab
*
aaaaaaaaaab
 ^
aaab
*
a==a,p1++,p2++
aaaaaaaaaab
  ^
aaab
 *
a==a,p1++,p2++
aaaaaaaaaab
   ^
aaab
  *
a==a,p1++,p2++
aaaaaaaaaab
    ^
aaab
   *
s1 [3]=b vs s2 [4]=a,失配 p2 = 4 -3 +1 =2,p1=0
aaaaaaaaaab
  ^
aaab
*
你能看到:每次匹配到第 4 位(b)失配,p2 只回退 1 位,从头重新比对连续 3 个 a! 大量重复比对相同的 a,这就是暴力低效的根源。 一直重复这个过程,直到:
aaaaaaaaaab
         ^
aaab
*
p1=0,p2=9,a==a → p1++,p2++
aaaaaaaaaab
          ^
aaab
 *
p1=1,p2=10,a==b?不,继续: p2=7 开始的一轮:
aaaaaaaaaab
       ^
aaab
*
p1=0,p2=7 a==a → p1++,p2++
aaaaaaaaaab
        ^
aaab
 *
p1=1,p2=8 a==a → p1++,p2++
aaaaaaaaaab
         ^
aaab
  *
p1=2,p2=9 a==a → p1++,p2++
aaaaaaaaaab
          ^
aaab
   *
p1=3,p2=10 b==b ✅ p1==4,匹配成功! 输出:子串第一个字符在原串中的位置是第 8 个字符。
一种全新的解决字符串匹配的全新思路
可以看到,这个算法的效率非常低,当出现示例中的极端情况,算法的时间复杂度直接干到O(n*m),有没有一种高效的方式实现字符串的匹配呢?
答案是有的。有一些聪明绝顶的人给出了这样的一种做法:
首先我们下一个定义:长的串叫文本串,较短的那个串叫做模式串。
首先将模式串s1和文本串s2拼接,使用分隔符分开,前面加上空格,得到_s1#s2:(空格用_表示,#是s1,s2中都未出现过的字符)
就本题目而言就是str=_aaab#aaaaaaaaaab
这里我们要引入一个概念:最长真公共前后缀border:
对于一个字符串 S,它的border(最长真公共前后缀),是满足下面两个条件的最长子串:
- 这个子串既是 S 的前缀,同时又是 S 的后缀;
- 真:该子串不能等于字符串S本身(不能是整个字符串)。
简单一句话概括:border 是一个字符串最长的、不等于自身的公共前后缀。
比如:aba的border是a
aaaabaa的border是aa
ababcab的borer是ab
a只有一个字母故没有border
这个概念是干什么吃的?不要芳,先看看大佬们后面是怎么操作的。
开辟一个大小和s一样的数组index,
前提约定:采用1-based 下标,
index数组就是前缀函数(border 数组)。index[k]:字符串前缀str[1…k]的最长真前后缀长度(border 长度)。
我们先手动模拟一遍
|
i |
str[1..i](前缀) |
str[i](当前字符) |
index[i](border) |
说明 |
|---|---|---|---|---|
|
1 |
a |
a |
0 |
单字符,无真前后缀 |
|
2 |
aa |
a |
1 |
前缀"a"=后缀"a" |
|
3 |
aaa |
a |
2 |
前缀"aa"=后缀"aa" |
|
4 |
aaab |
b |
0 |
前缀都以a开头,后缀以b结尾,无匹配 |
|
5 |
aaab# |
# |
0 |
#仅出现一次,前后缀不可能相等 |
|
6 |
aaab#a |
a |
1 |
后缀"a"=前缀"a";#阻断更长的border越过模式串 |
|
7 |
aaab#aa |
a |
2 |
后缀"aa"=前缀"aa" |
|
8 |
aaab#aaa |
a |
3 |
后缀"aaa"=前缀"aaa",已达模式串最长border |
|
9 |
aaab#aaaa |
a |
3 |
前缀中不含"aaaa"(第4位是b),border保持3 |
|
10 |
aaab#aaaaa |
a |
3 |
文本串a再多,前缀仍是aaab#...,border封顶3 |
|
11 |
aaab#aaaaaa |
a |
3 |
同上 |
|
12 |
aaab#aaaaaaa |
a |
3 |
同上 |
|
13 |
aaab#aaaaaaaa |
a |
3 |
同上 |
|
14 |
aaab#aaaaaaaaa |
a |
3 |
同上 |
|
15 |
aaab#aaaaaaaaaa |
a |
3 |
同上 |
|
16 |
aaab#aaaaaaaaaab |
b |
4 |
后缀"aaab"=前缀"aaab",border=4=模式串长度 → 匹配成功! |
假设我们已经掌握了计算index数组(前缀函数 /border 数组)的方法,接下来我们来看index数组是如何在字符串匹配问题中发挥作用的。
我们构造拼接串:str = " " + 模式串 + "#" + 文本串,并计算出整个拼接串对应的index数组。 遍历index数组,只要发现某个位置i满足 index[i] == m(m为模式串长度),就代表:拼接串前缀str[1…i]的最长相等真前后缀长度等于模式串长度。 这意味着这个前缀的末尾,完整匹配上了模式串,也就是在文本串部分找到了目标子串。
哦豁然开朗了,但是index数组计算会不会很复杂?
接下来我们推导:如何由这个下标i,算出模式串在原始文本串里起始位置,这里要使用到一点动态规划的思想。
前缀函数获取推导
约定:
m:模式串长度i:拼接串str中,index[i]==m对应的下标(也就是匹配成功位置,拼接串中模式串匹配结束的尾字符下标)- 拼接串结构:
str[0]占位空格 +str[1]~str[m]模式串 +str[m+1]分隔符#+str[m+2]开始是文本串
当index[i]=m,说明在拼接串下标i的位置,完成了整段模式串的匹配。 文本串在拼接串中是从m+2开始存放的。 拼接串中本次匹配的起始位置 = i - m + 1 这个起始位置落在拼接串的文本串区域内,减去文本串在拼接串里的偏移量m+1(空格 + 模式串 +# 一共占 1+m+1 = m+1 个字符),得到文本串内部起始下标:
(n = (i - m + 1) - (m+1) = i - 2m)
结论:模式串在原始文本串中的起始下标为 i-2*m
举个例子: 模式串aaab,m=4;拼接串匹配成功位置i=16。 n = 16 - 2*4 = 8 表文本串中下标 8 的位置,是模式串aaab的首字符,和我们前面表格结果完全吻合。
这样一个新颖的算法让我们也理解到了str拼接过程的原因:
空格是为了方便计算n的下标,#是一个两个串中都不会出现的字符,这样可以有效的将整个str[0...i]的border约束在模式串部分。
接下来我们要推导 next 数组(index 数组)的状态转移方程:
我们已知 index[i-1] 代表前缀 str[1…i-1] 的最长 border 的长度。 这个最长 border 对应的子串就是 str[1 … index[i-1]],它的下一个字符是 str[index[i-1] + 1]。
-
情况 1:如果当前字符
str[i] == str[index[i-1]+1]即当前字符和str[0...i-1]的border的下一个字符相同,说明我们可以直接在str[1…i-1]的最长 border 后面接上str[i],构成str[1…i]的最长 border。 于是:index[i]=index[i-1]+1 -
情况 2:如果
str[i] !=str[index[i-1]+1]不能直接延长最长 border。真的就没救了吗?str[0...i]的border是没有的吗?显然是不正确的,如果次长的真公共前后缀b的下一个字符和str[i]相同,是不是就意味着str[0...i]的border就是b和其之后那个字符的组合。 -
所以我们需要回退:去找
str[1…i-1]str[0...i-1]的次长 真公共前后缀,,然后继续进行如同情况1的比对操作。 -
次长 真公共前后缀怎么找 ,我们可以知道border的boder就是我们要找的答案:
-
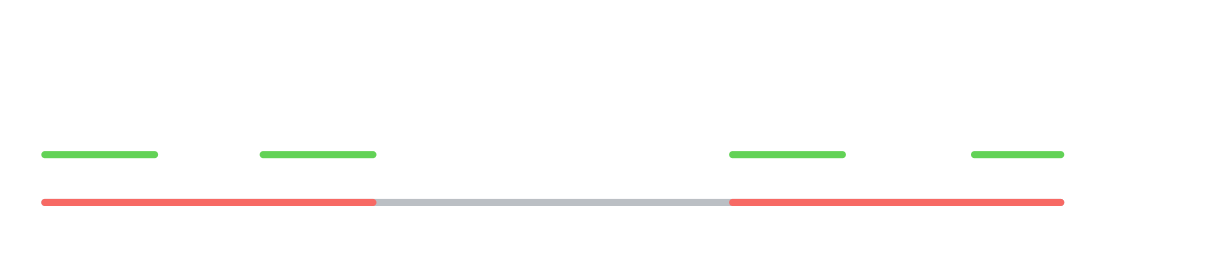
我们来证明一下,假如红色部分是整个str(用灰色表示)的border,绿色部分是红色部分的border,如果绿色部分不是str的次长的真公共前后缀,如果存在一个比绿色部分长但比红色部分短的str的真公共前后缀的话,由对称性必然会出现这种情况(使用灰色虚线表示假设的次长的真公共前后缀):
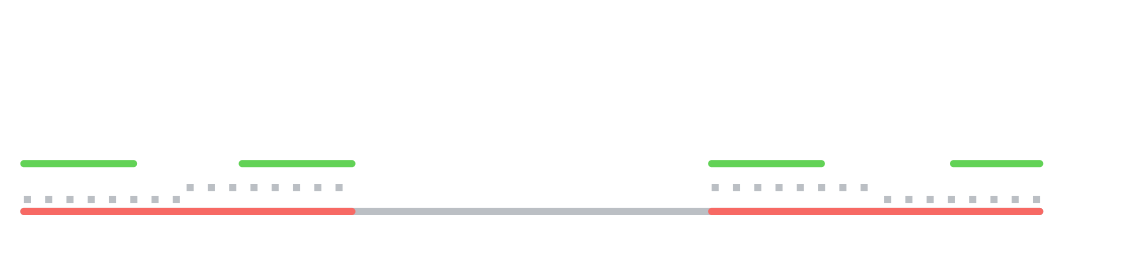
那么border的border还是绿色部分吗?显然变成了灰色虚线部分了。与已知条件矛盾,所以boder的border就是次长的,border的border的border就是str第三长的。
得到性质:一个字符串所有 border 可以依次递归:最长 border 的 border,就是原串的第二长 border;再取 border 就是第三长,以此类推。 也就是令
j = index[index[i-1]],j就是次长 border 长度。
现在拿这个次长 border——j=index[j] ,其下一个字符 str[j+1] 和 str[i] 再次比较:
- 如果相等:
index[i] = j + 1 - 如果不等:继续递归回退
j = index[j],不断拿新的str[j+1]和str[i]比对。
不断循环这个回退操作,直到两种出口:
- 找到某个
j,满足str[j+1]==str[i],则index[i]=j+1; - 一直回退到
j=0(没有 border 了),此时如果str[1] != str[i],说明找不到任何相等的真前后缀,index[i]=0。
一句话概括递归回退逻辑: 当最长 border 无法继续扩展时,就递归取 border 的 border,尝试用更短的前缀匹配,直到找到可以扩展的前缀,或者缩短到 0。
这样我们就得到了找一个串的index数组的方法:
vector<int> get_next(string  s)
{
    vector<int> index(s.size());
    //index[0]是空格的border长度,index[1]是长度为一的字符串border的长度,没有意义,全为0
    for (int i = 2; i < s.size(); i++)
    {
        int j = index[i - 1];
        while (j && s[i] != s[j + 1])j = index[j];
        if (s[i] == s[j + 1])j++;
        index[i] = j;
    }
    return index;
}
这里我们也可以进行一次小优化,因为我们看到每次循环后index[i]=j,每次i++后进入循环时又把j=index[i-1],这不是多次一举?所以我们可以改成:
vector<int> get_next(string  s)
{
	vector<int> index(s.size());
	//index[0]是空格的border长度,index[1]是长度为一的字符串border的长度,没有意义,全为0
	for (int i = 2,j=0; i < s.size(); i++)
	{
		while (j && s[i] != s[j + 1])j = index[j];
		if (s[i] == s[j + 1])j++;
		index[i] = j;
	}
	return index;
}
我们完整实现这个版本的算法
#include<iostream>
#include<vector>
#include<string>
using namespace std;
vector<int> get_next(string s)
{
	int n=s.size();
	vector<int> index(n,0);
	for(int i=2, j=0;i<n;i++)
	{
		while(j&&s[j+1]!=s[i])j=index[j];
		if(s[j+1]==s[i])j++;
	    index[i]=j;
	}
	return index;
}
void kmp1(string context,string mod)
{
	string str=" "+mod+"#"+context;
	int m=mod.size();
	int n=context.size();
	vector<int> index=get_next(str);
	for(int i=1;i<index.size();i++)
	{
		if(index[i]==m)cout<<i-2*m<<endl;
	}
}
int main()
{
	string str1,str2;
	cin>>str1>>str2;
	kmp1(str1,str2);
	return 0;
}
可以看到,index 数组的构建过程本质上是动态规划,它成功削去了暴力算法的一层循环,整体时间复杂度优化到 (O(m+n))。
但 KMP1 拼接版本在空间上仍有优化余地。我们观察 index 数组的使用过程:文本串对应的 border 值只需要临时计算、用来判断是否匹配,计算完成后就可以丢弃;而模式串对应的 border 数组才是需要反复复用的核心。
基于这个思路,我们可以优化空间开销:只预先计算并保存模式串的 border 数组,为了区分,后续我们把这个数组命名为next数组。在遍历文本串时,动态计算 border,每算出一个值,判断它是否等于模式串长度。如果相等,直接输出匹配位置;如果不相等,直接舍弃这个临时值,不再额外开辟数组存储全部文本串的 border,省去后续遍历数组查找匹配项的步骤。
这一空间优化后的版本,就是大名鼎鼎的标准 KMP 算法。我们在 KMP1 的基础上改造:
不再真正拼接两个字符串(不过我们依然可以在脑海里想象拼接的形式,方便沿用前面 border 的思路来理解)。为了统一下标、简化位置推导,依旧给模式串和文本串的开头都添加一个占位空格。
我们对文本串逐个字符遍历的过程,逻辑上等价于 KMP1 中在虚拟拼接串上求解 border。区别仅在于不再完整保存整个拼接串的 index 数组,因此匹配成功后的下标计算公式也需要相应调整。
约定:
- m:模式串长度
- i:添加占位空格后的文本串里,匹配成功时模式串末尾字符对应的下标
当 (j=m),代表完整匹配。此时在带前置空格的文本串中,模式串首字符的下标: (t=(i-1)-(m-1)+1 = i-m+1)
(t=(i-1)-(m-1)+1=i-m+1)
- i:添加前置空格后的文本串中,匹配成功时模式串末尾字符的下标
- (i-1):匹配尾字符的前一个下标,作为向前回溯的起点
- (m-1):模式串去掉首字符后剩余的字符数量
- ((i-1)-(m-1)):从尾字符前一位向前回溯 (m-1) 个位置,得到模式串首字符前面一格的下标
- (+1):向后偏移 1 位,定位到模式串首字符的下标
(t=(i-1)-(m-1)+1 = i-m+1)
kmp模板
#include<iostream>
#include<vector>
#include<string>
using namespace std;
vector<int> get_next(string s)
{
	int n=s.size();
	vector<int> index(n,0);
	for(int i=2, j=0;i<n;i++)
	{
		while(j&&s[j+1]!=s[i])j=index[j];
		if(s[j+1]==s[i])j++;
	    index[i]=j;
	}
	return index;
}
void kmp2(string context,string mod)
{
	int len=mod.size();
    context=" "+context;
	mod=" "+mod;
	vector<int> next=get_next(mod);
	for(int i=1,j=0;i<context.size();i++)
	{
		while(context[i]!=mod[j+1]&&j)j=next[j];
		if(context[i]==mod[j+1])j++;
		if(j==len)cout<<i-j+1<<endl;
	}
}
int main()
{
	string str1,str2;
	cin>>str1>>str2;
	kmp2(str1,str2);
	return 0;
}

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)