
从 ERP 变更记录到企业微信实时通知:标准工时变更通知系统工程复盘
Engineering Case Study · RCA · Postmortem · T100 · 企业微信 · OAuth · Nginx · 事件驱动
脱敏说明:本文对真实域名、IP、据点名、项目路径、开发者姓名/UserID、数据库名称和业务标识进行了替换。架构、数据关系、接口安全、故障原因与解决逻辑保持不变。
一、背景:ERP 里有变更记录,但缺少“主动通知”
现有系统已经能够查询 ERP 中的料件标准工时变更记录,但用户只有主动打开后台菜单才能发现变化。新需求是:ERP 一旦产生标准工时变更,就通过企业微信自建应用通知相关人员,同时提供可点击的移动 H5 页面查看详情。
第一个关键决策是:不要在 T100 里再开发一套 H5,也不要让 ERP 直接负责企业微信发送。 T100 只负责产生业务事实;通知、去重、权限、失败重试、H5 和企业微信集成都放在现有若依/MES 系统中。
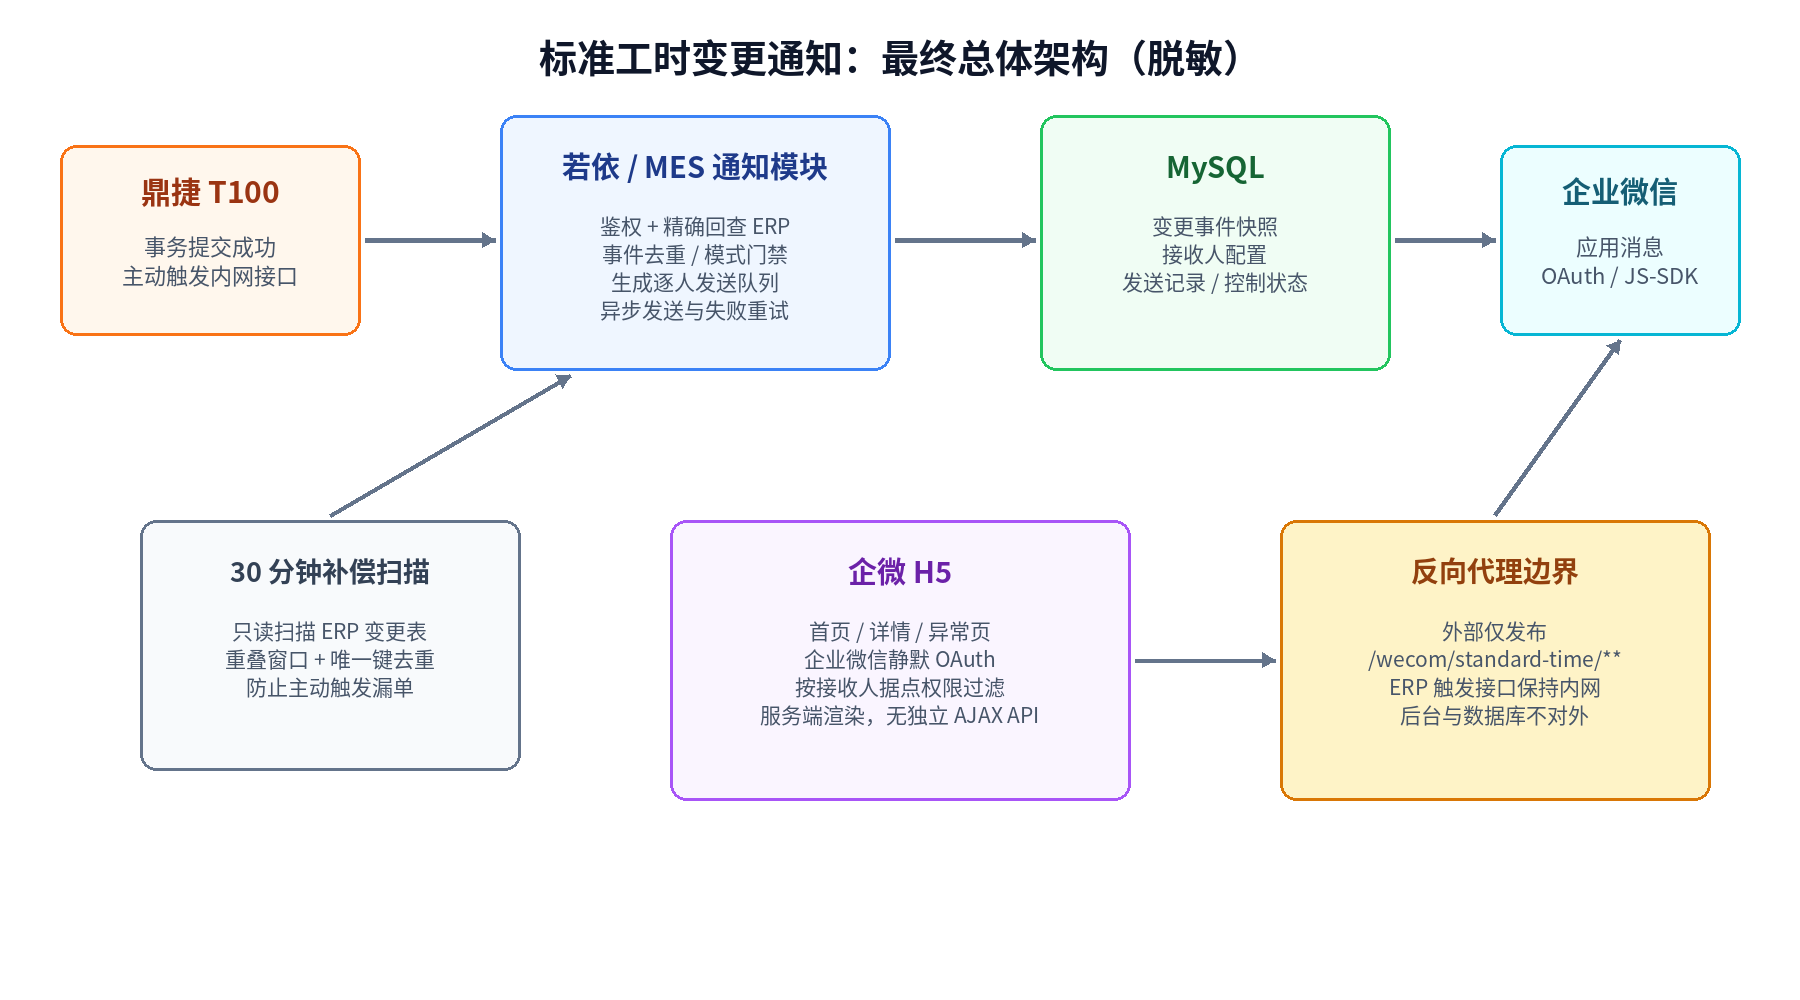
图 1:最终总体架构
二、目标与约束
| 维度 | 约束 / 目标 |
|---|---|
| ERP 侵入 | 尽量只读;主动触发仅在事务提交成功后通知,不在 ERP 保存事务中同步等待企微发送。 |
| 实时性 | 主动事件为主;保留低频补偿扫描,防止接口失败或漏触发。 |
| 幂等 | ERP 重复调用、补偿扫描重复命中,都不能重复推送同一业务变更。 |
| 可靠性 | 事件先落库,再异步发送;发送失败可重试、可人工重发。 |
| 权限 | 企微 H5 不复用后台 Shiro 会话,而使用企业微信 OAuth 身份,并按通知接收范围限制据点数据。 |
| 网络 | ERP、数据库和管理后台继续内网;公网/跨网只开放 H5 最小路径。 |
| 上线风险 | SHADOW → TEST → PROD 分阶段启用,禁止一步到正式发送。 |
| 安全 | Secret 不下发前端;Trigger 使用 IP 白名单、时间戳、请求 ID 和 HMAC-SHA256。 |
三、架构演进:从轮询到“事件驱动 + 补偿扫描”
第一版采用 30~60 秒轮询 ERP 变更记录表,使用“据点 + 料号 + 变更序号”作为业务唯一键,并通过重叠时间窗口防止边界漏数。这种方案改动小、适合先跑通影子模式。
随着需求明确,最终将主通道调整为:ERP 在事务提交成功后主动调用内网 Trigger API。通知系统再回查 ERP 获取真实数据,而不是直接相信请求体传来的工时值;原轮询则降级为每 30 分钟左右执行的补偿扫描。
为什么不完全删除扫描? 因为主动回调本身也可能失败。低频扫描相当于第二条可靠性通道:事件驱动解决实时性,补偿扫描解决漏单。
四、数据模型:事件和发送结果必须分开
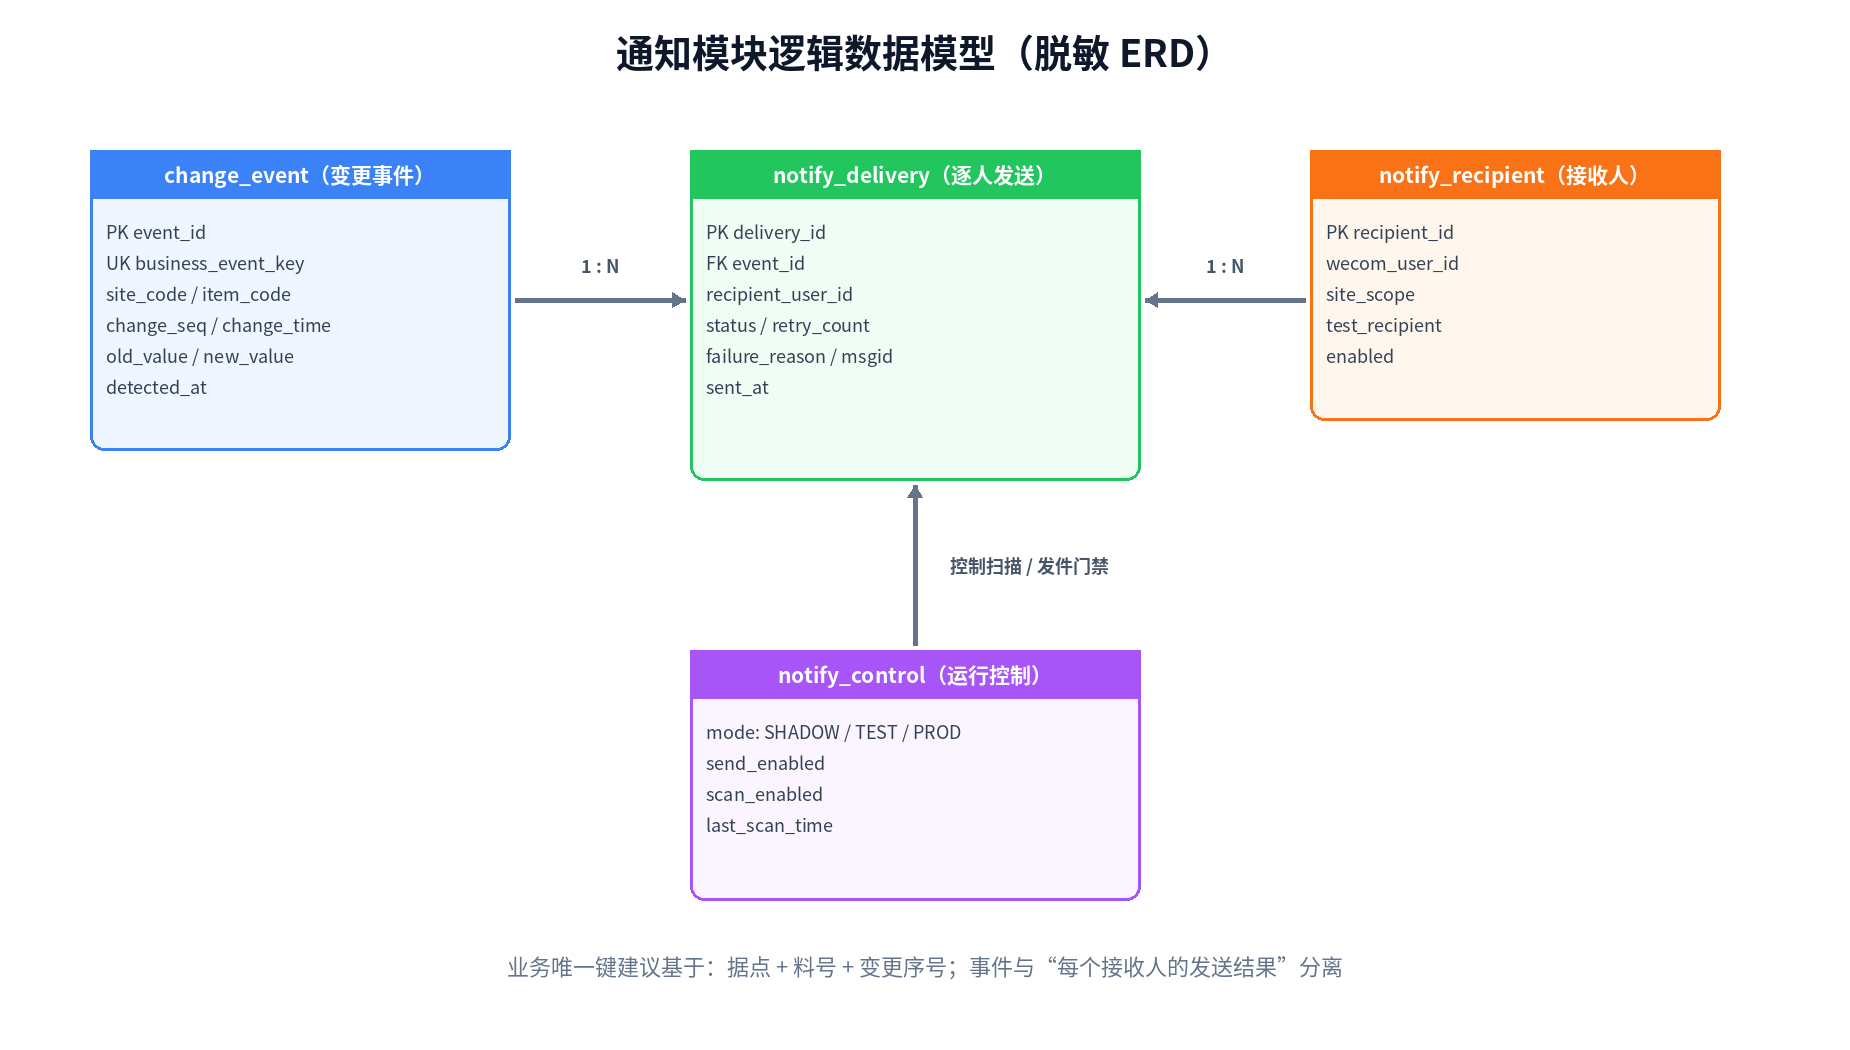
图 2:通知模块逻辑 ERD
核心建模原则是把“ERP 发生了一次业务变更”和“这次变更向每个接收人发送的结果”拆开。一个事件可以对应多条 delivery,这样才能正确表示 A 已发送成功、B 失败待重试,而不是给整个事件设置一个粗粒度的 sent=true。
| 逻辑实体 | 职责 | 关键字段/约束 |
|---|---|---|
| change_event | 保存 ERP 变更快照及检测信息 | 业务唯一键、据点、料号、变更序号、旧值/新值、变更时间 |
| notify_delivery | 记录每个接收人的发送状态 | event_id、recipient、status、retry_count、failure_reason、msgid、sent_at |
| notify_recipient | 维护企微接收人及数据范围 | WeCom UserID、据点范围、测试接收人、启用状态 |
| notify_control | 保存运行模式与发送门禁 | SHADOW/TEST/PROD、发送总开关、扫描开关、扫描水位 |
五、ERP 主动触发的完整执行流程
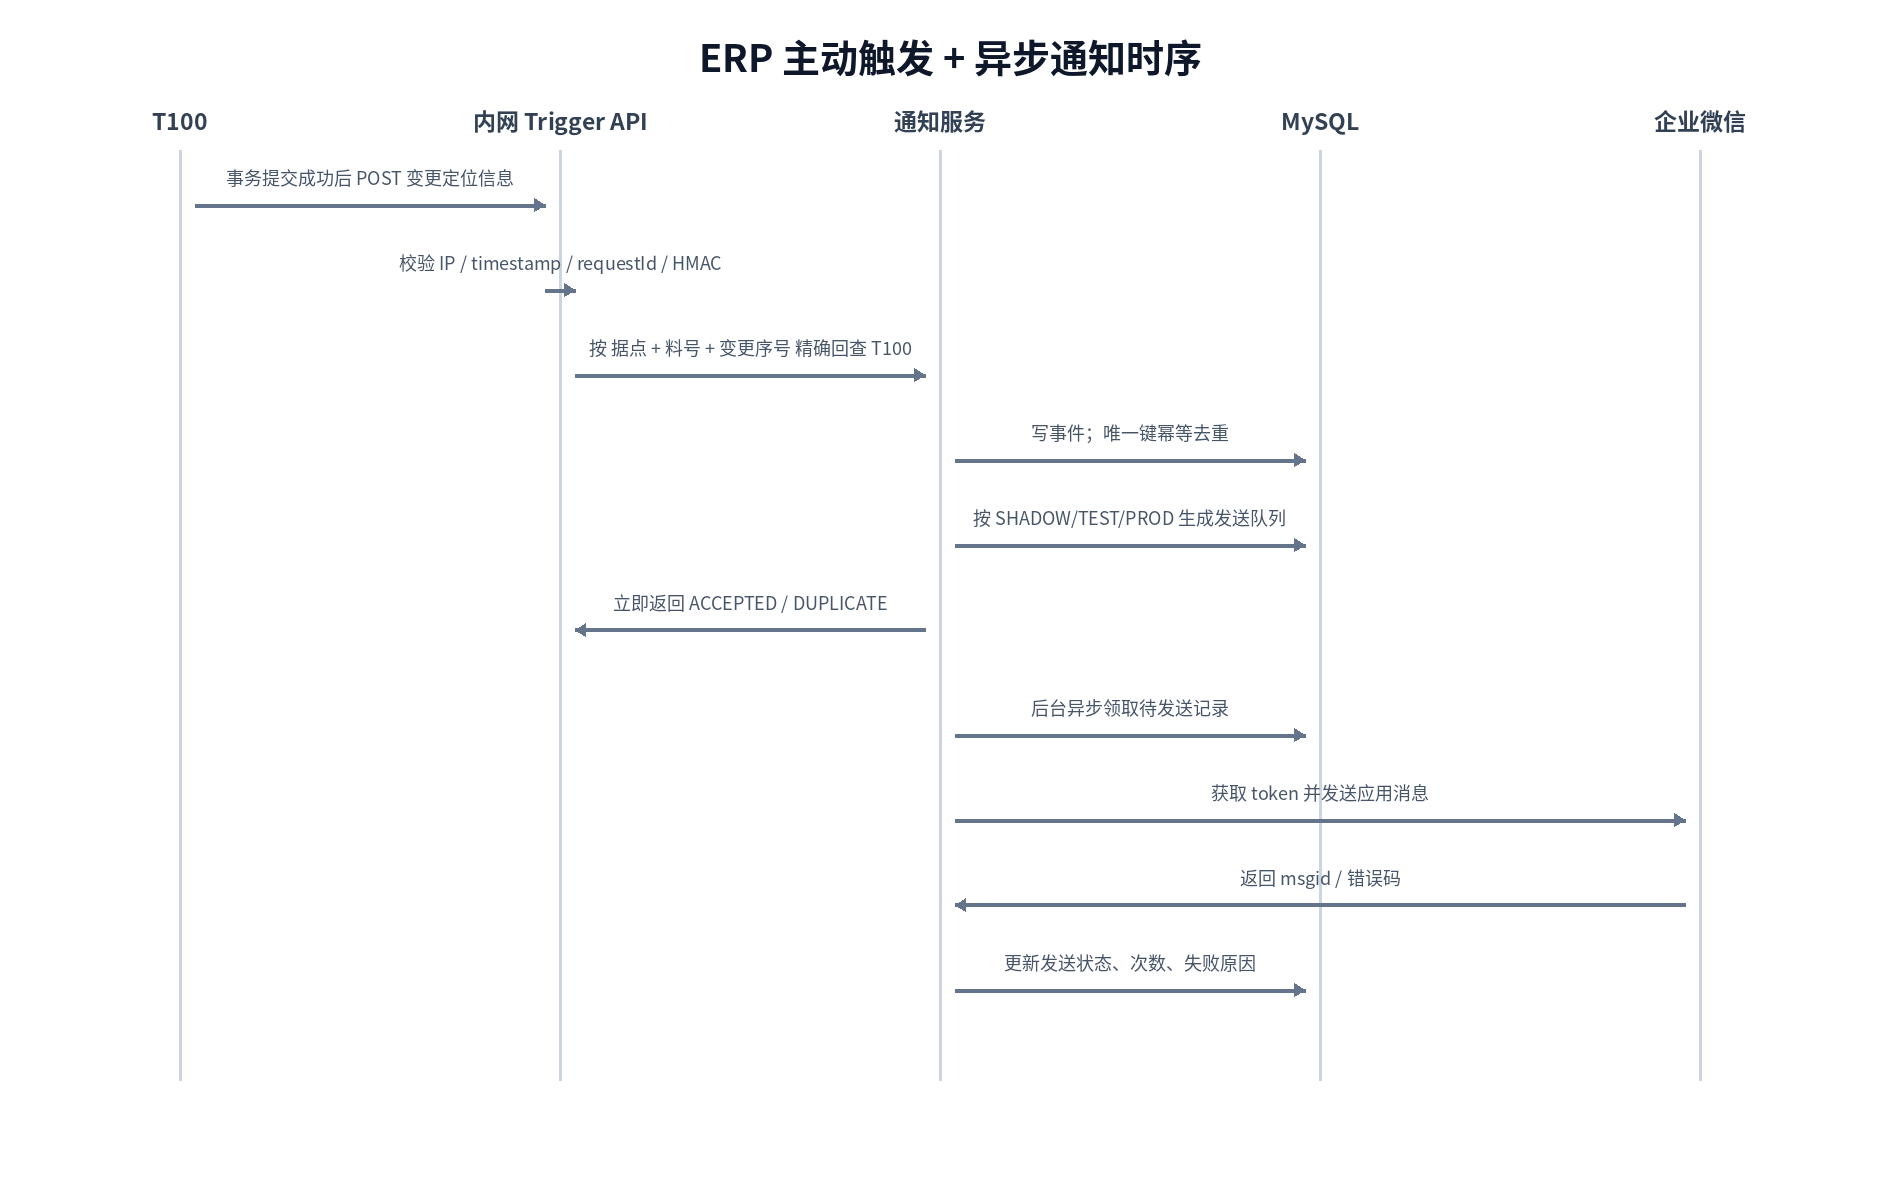
图 3:ERP 主动触发 + 异步发送时序
Trigger API 只传“定位信息”
POST /internal-api/standard-time/change

{
  "siteCode": "SITE_A",
  "itemCode": "ITEM-001",
  "changeSeq": 3,
  "changeTime": "2026-09-12 10:20:30"
}
后端真正认定的业务数据来自对 T100 的精确回查。这样可以避免 ERP 调用方传错新旧工时、费用等业务字段,也让通知系统以 ERP 已提交数据为事实来源。
Trigger 安全
X-Erp-Timestamp: <unix-seconds>
X-Erp-Request-Id: <unique-request-id>
X-Erp-Signature: HMAC-SHA256(timestamp + "\n" + requestId + "\n" + rawBody)
接口默认关闭,只有明确启用、共享密钥满足要求、来源 IP 在白名单且签名/时间戳/请求号校验通过时才接受。重复请求由请求幂等与业务事件唯一键共同兜底。
六、企业微信 H5:为什么不用现有后台页面
后台 PC 页面依赖原系统账号和 Shiro Session,直接塞进企业微信会遇到登录态、移动端体验和权限来源的问题。因此单独实现了服务端渲染的移动 H5:首页、详情和异常页面。
H5 使用企业微信静默 OAuth:用户进入页面 → 跳转授权 → 回调后端 → 用 code 换取 WeCom UserID → 写入 Session → 再依据接收人配置判断 SITE_A / SITE_B / ALL 数据范围。页面本身无需再次输入后台用户名密码。
当前仍存在一个设计债:PC 后台的据点权限来自系统部门/权限,而企微 H5 的据点权限来自独立接收人表。两套权限模型可能不一致。后续更理想的做法是建立“企微 UserID → 员工/系统账号 → 部门 → 据点权限”的统一身份映射。
七、内网系统如何安全给企业微信访问
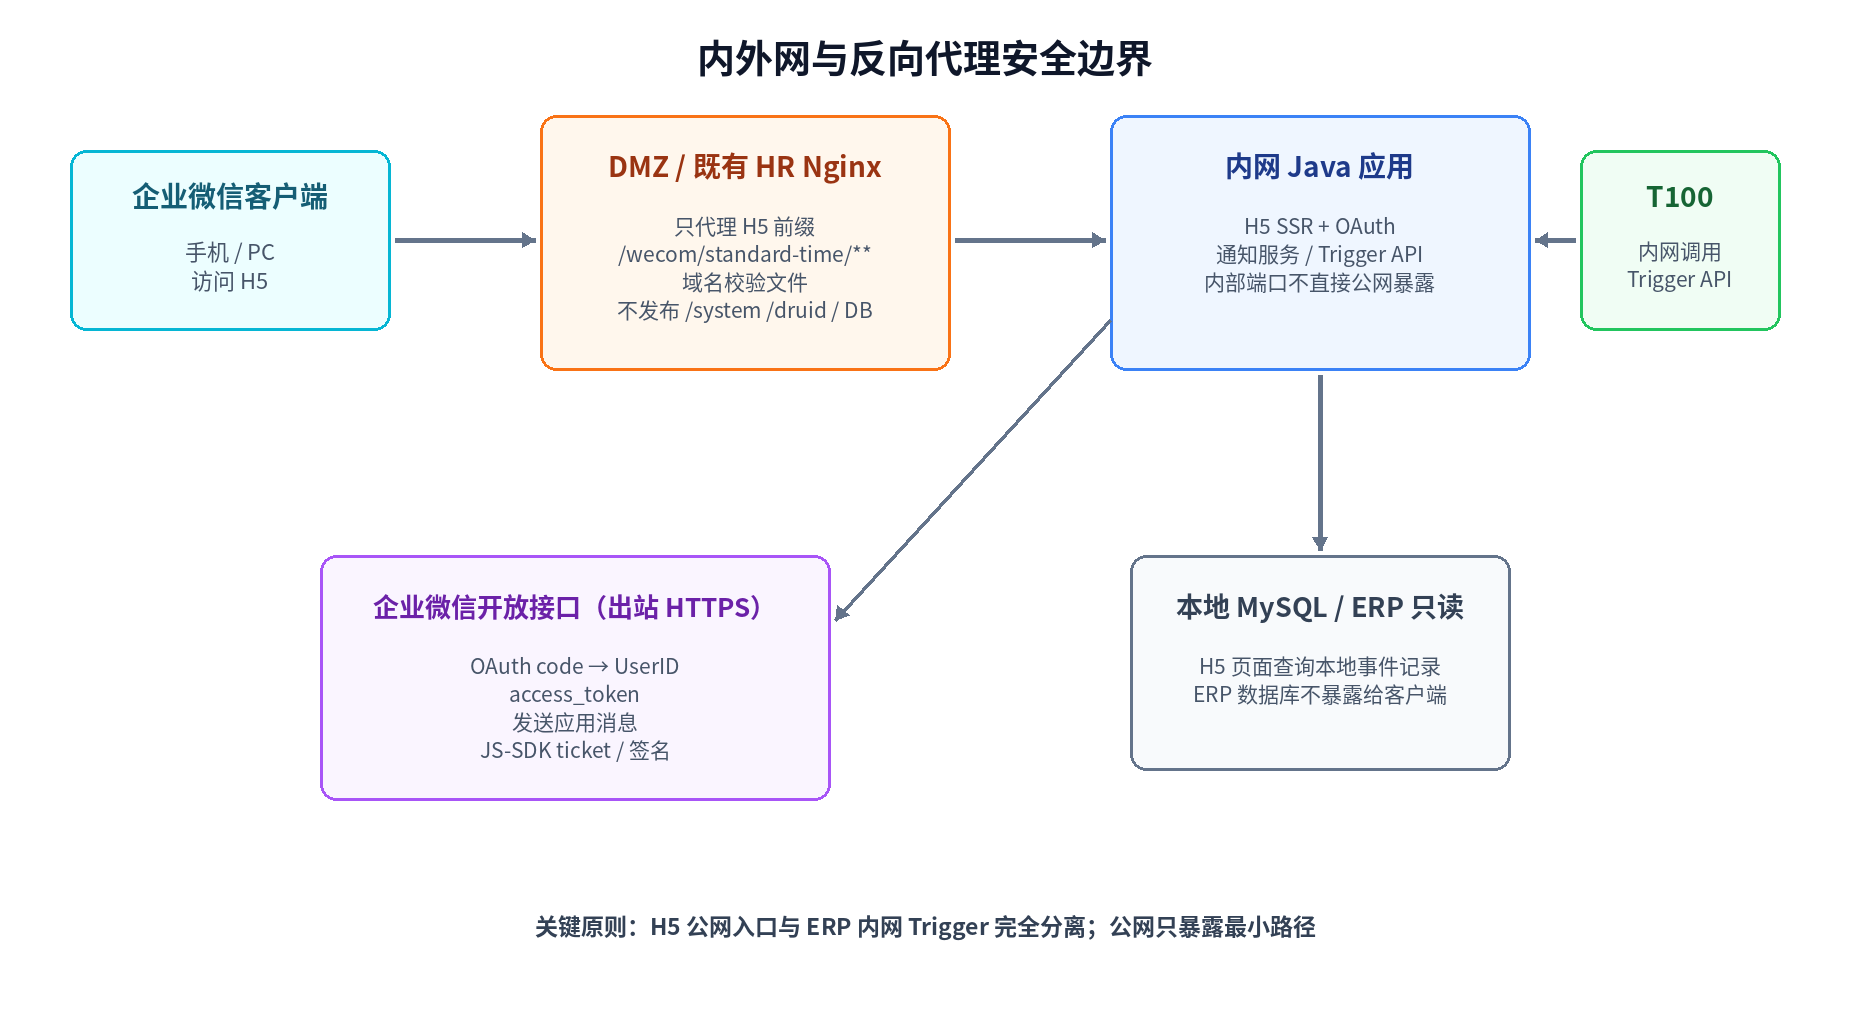
图 4:内外网与反向代理安全边界
系统主体部署在内网,不应该为了 H5 把整个后台、数据库或应用端口暴露出去。最终采用已有 HR/门户 Nginx 作为反向代理入口,只新增独立路径片段,将 /wecom/standard-time/** 转发到内网 Java 服务。
用户手机只访问 H5;H5 由 Java 服务端查询本地通知记录并渲染完整 HTML。手机不会直接访问 T100 Oracle。与此同时,ERP 主动触发接口保持内网,不加入 H5 的公开代理范围。
入站与出站要分清:H5 是外部 → 内部的受控入站;发送消息、OAuth 换 UserID 等是 Java → 企业微信开放接口的出站 HTTPS。两者的网络和防火墙策略完全不同。
八、上线策略:为什么要 SHADOW → TEST → PROD
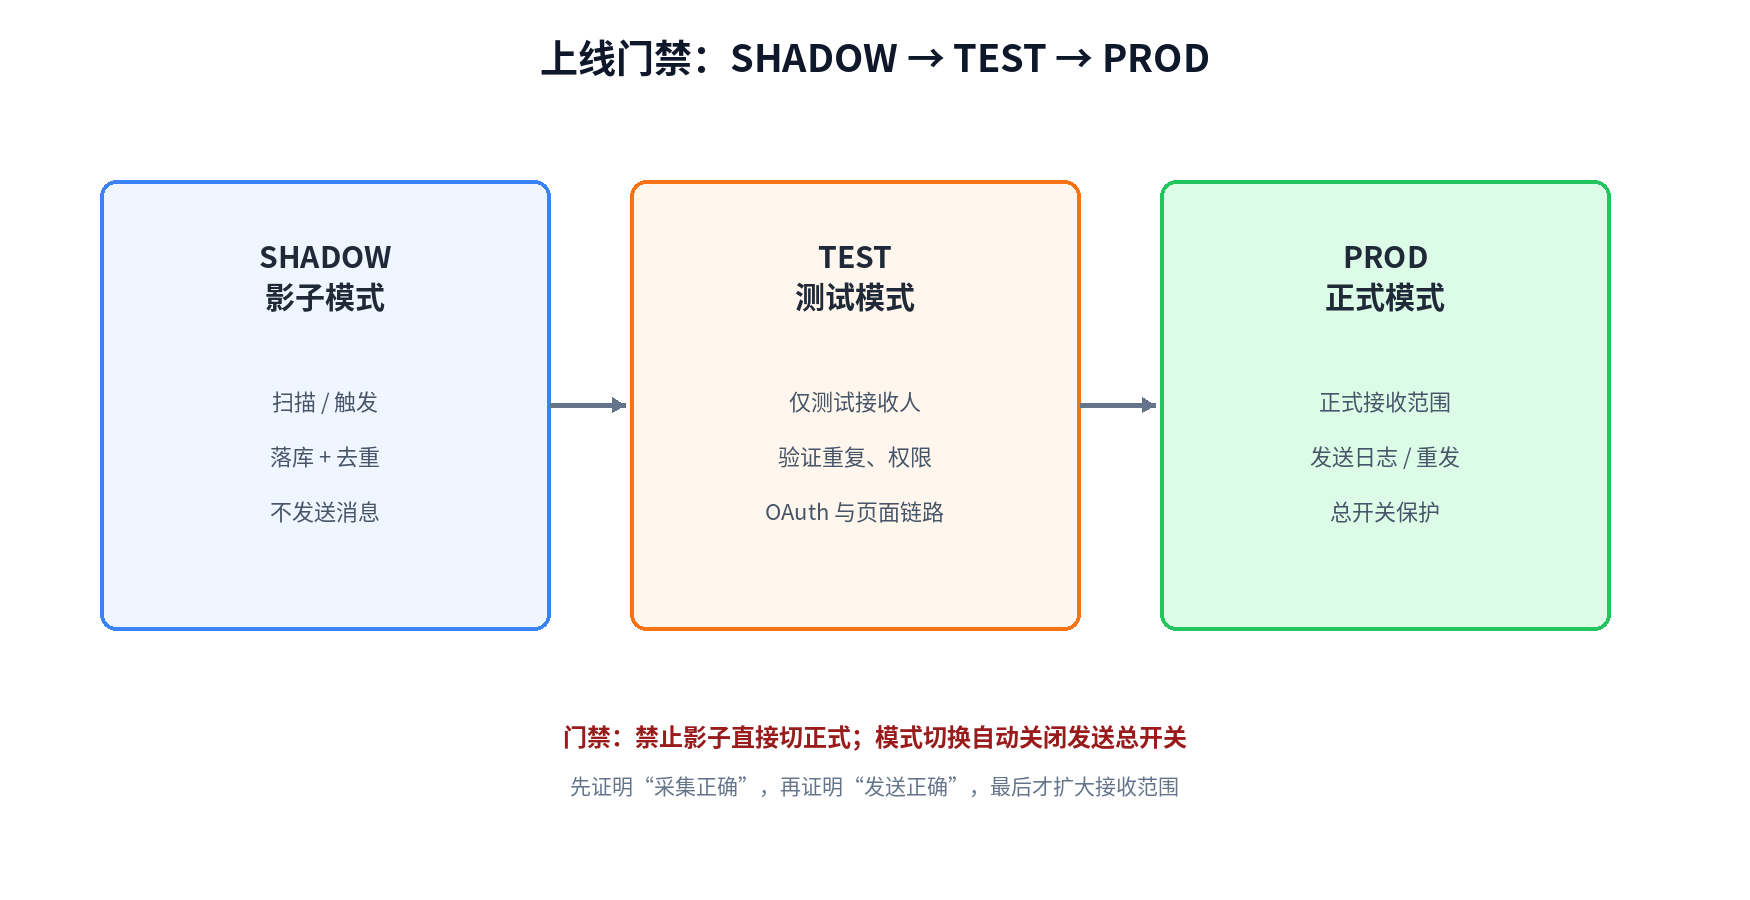
图 5:三阶段上线门禁
通知类功能最危险的不是“程序报错”,而是程序工作得太积极:一次去重缺陷就可能把全公司刷屏。因此上线流程必须先验证采集,再验证发送,再逐步扩大接收范围。
| 阶段 | 行为 | 验收重点 |
|---|---|---|
| SHADOW | 只扫描/接收 Trigger、落库、去重,不发送 | 是否漏采、重复采集、业务唯一键是否稳定 |
| TEST | 只给少量测试账号发送 | 文本卡片、OAuth、据点权限、失败重试、详情页 |
| PROD | 正式接收范围 + 发送总开关 | 监控、重发、限速、熔断、运营配置 |
九、Troubleshooting / RCA:真实踩坑过程
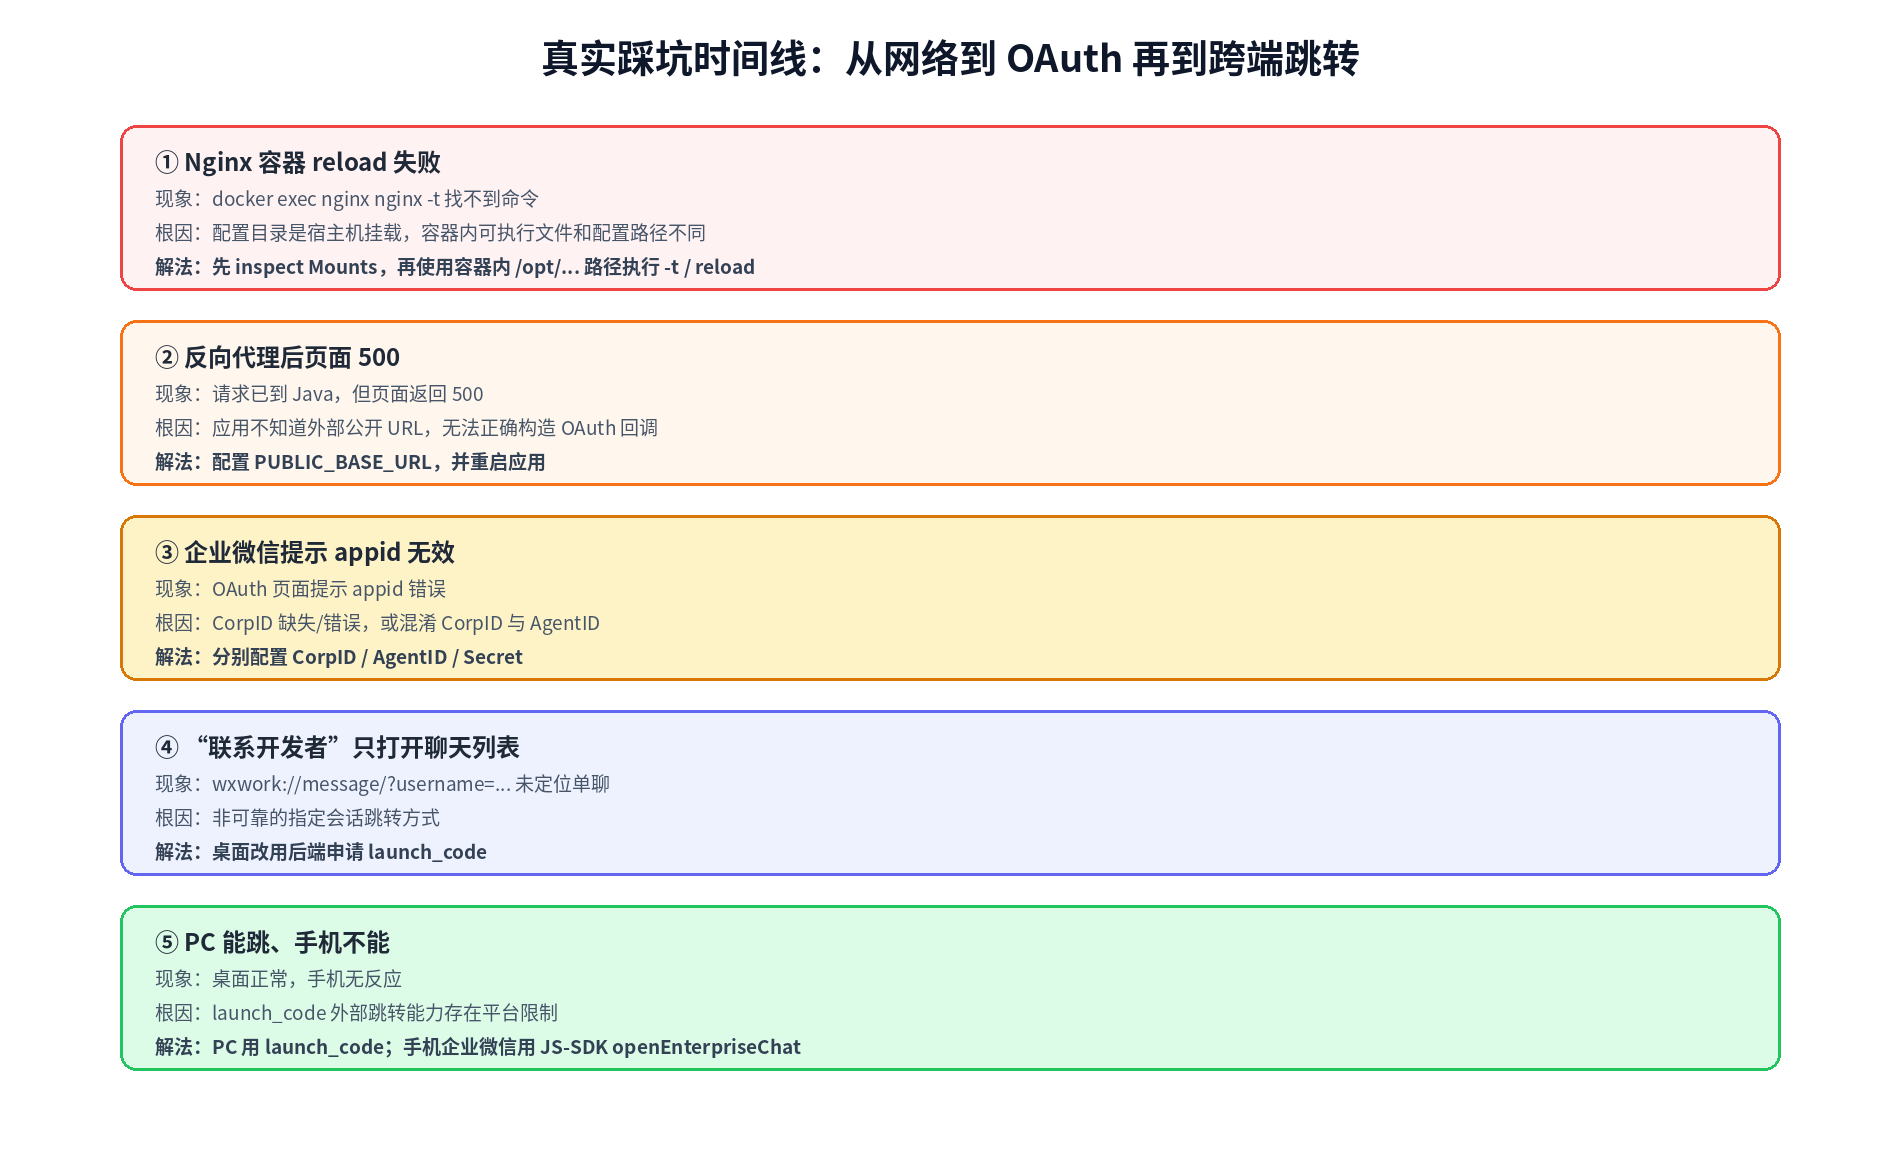
图 6:真实踩坑时间线
问题 1:Nginx 明明是 Docker,为什么宿主机路径和容器路径对不上
Symptoms:在宿主机看到配置目录,执行 docker exec nginx nginx -t 却提示容器内找不到 nginx。
Investigation:通过 docker inspect 查看 Mounts,发现宿主机配置目录被挂载到了容器内另一个路径;同时 nginx 可执行文件也不在 PATH。
Root Cause:把“宿主机卷路径”和“容器内运行路径”当成了同一个命名空间。
Resolution:宿主机继续编辑映射卷文件,但 include、-c 和 nginx 二进制都使用容器内路径,再执行 -t 和平滑 reload。
Lesson:遇到容器化 Nginx,第一步不是猜路径,而是 inspect 挂载和实际启动命令。
问题 2:反向代理已经通了,为什么页面还是 500
Symptoms:外部请求已经能到 Java 服务,但 H5 返回 500。
Root Cause:OAuth 需要构造对外回调 URL,而应用只知道内网地址,没有配置公开基地址。
Resolution:配置脱敏后的 PUBLIC_BASE_URL=https://hr.example.com 并重启。
Verification:入口应从 500 变成 302 跳转企业微信 OAuth;这反过来也证明 Nginx 代理本身已经成功。
问题 3:企业微信提示 appid 无效
Root Cause:企业 CorpID 缺失、错误,或误把 AgentID 当成 CorpID。
Resolution:明确拆分 CorpID、AgentID、Secret 三种配置,并全部由服务器环境/密钥管理注入。
问题 4:PC 能联系开发者,手机为什么不行
最初用 wxwork://message/?username=...,只能打开聊天列表;随后改为后端申请 launch_code,桌面端可以进入指定单聊,但手机端仍无法工作。继续查明后发现,这是平台能力差异,不是参数写错。
最终实现双通道:桌面端使用 launch_code;手机企业微信使用 JS-SDK 的 openEnterpriseChat。统一入口在服务端做环境分流,避免把平台差异散落到三个页面。
这个问题体现了一个重要原则:跨端能力不能只在 PC 验证后就假设移动端等价。 企业微信、浏览器 Deep Link、JS-SDK 的支持矩阵必须在设计阶段明确。
十、可靠性设计
| 机制 | 解决的问题 |
|---|---|
| 业务唯一键 + 数据库唯一约束 | ERP 重复事件、补偿扫描重叠窗口不会重复落库 |
| requestId 幂等 | 同一 Trigger HTTP 请求重复重试时可识别 |
| 事件先落库 | 企业微信故障不会让业务事件丢失 |
| 逐人 delivery | 局部发送失败可单独重试 |
| 失败重试 / 人工重发 | 临时网络、token、限流异常可恢复 |
| 限速 + 45009 熔断 | 防止限流时持续轰炸企业微信接口 |
| 30 分钟补偿扫描 | 主动 Trigger 漏调用时仍能最终发现事件 |
| SHADOW / TEST / PROD 门禁 | 控制上线风险和错误通知影响面 |
十一、5 Whys:为什么不让 T100 直接发企业微信
| Why | 分析 |
|---|---|
| 为什么不让 ERP 直接调企微? | ERP 应专注交易事实,不应该承担外部消息通道细节。 |
| 为什么通知要先落本地库? | 消息发送是外部副作用,会超时、限流和失败,需要可重试状态。 |
| 为什么要独立 H5? | ERP/后台页面的登录态与移动端体验不适合直接复用。 |
| 为什么还要补偿扫描? | 事件回调也不是绝对可靠,需要第二条恢复路径。 |
| 根因 | 把“业务事实产生”和“通知副作用”解耦,才能同时保证 ERP 稳定、通知可靠与后续可运维。 |
十二、验证与发布
实现阶段完成了全模块 Maven 编译、Mapper XML 解析与差异格式检查;ERP Trigger 改造后再次使用 Java 8 完成 Maven 编译验证。部署初期没有直接调用真实企微或修改运行中的生产环境,而是从影子模式开始。
真正发布时建议保留以下验证链:ERP 创建一笔标准工时变更 → Trigger 返回 ACCEPTED → event 仅落一条 → TEST 接收人收到一条消息 → 点击详情通过 OAuth → 只能看到授权据点 → 重复 Trigger 返回 DUPLICATE → 临时禁用 Trigger 后由补偿扫描最终补到同一事件且不重复发送。
十三、Lessons Learned
1. 事件驱动不是“不要定时任务”。 主通道用事件获得实时性,低频扫描用来弥补分布式调用的不可靠。
2. 通知系统必须持久化。 不能把“调一次企业微信 API”当成完成;事件、接收人、每次发送结果都要可审计。
3. 内网应用对外发布要做路径级最小暴露。 为一个 H5 页面开放整个后台,是最不划算的安全交换。
4. OAuth 公开地址是部署契约的一部分。 反向代理后,应用必须知道用户真正访问的外部 URL。
5. 身份和数据权限应最终统一。 企微接收人表与后台部门权限长期并存会产生授权漂移。
6. PC 与移动端的“同一个企微功能”可能需要完全不同的技术通道。 不能依靠单一 Deep Link 覆盖所有客户端。
十四、后续优化
| 优先级 | 优化项 | 原因 |
|---|---|---|
| P0 | 把所有 CorpID / AgentID / Secret / Trigger Secret 移到环境变量或密钥服务并轮换 | 避免源码或配置默认值泄露 |
| P0 | 对 Trigger、发送队列、OAuth、补偿扫描建立统一监控指标 | 当前能重试,但还需要可观测性 |
| P1 | 统一企微 UserID 与内部员工/系统账号映射 | 消除 H5 与后台据点权限两套规则 |
| P1 | T100 侧优先采用“自定义待发送表 + 重试任务” | 把“事务提交成功”和“通知触发最终成功”联系得更稳 |
| P1 | 正式入口切换到标准 HTTPS 443 | 减少端口、可信域名和移动端兼容问题 |
| P2 | 把现有企微发送能力抽象成通用 Notification Platform | 考勤、标准工时等应用复用 token、重试、熔断与审计,但保持不同 Agent 配置隔离 |
十五、总结
这次功能从一个“ERP 变更后发条企业微信”的小需求,逐步演进成了一个完整的事件通知子系统:ERP 只产生事实,若依负责事件持久化和发送编排,企业微信负责触达与身份入口,Nginx 负责最小化的网络暴露。
真正有价值的不是最后那条消息能不能发出去,而是系统已经具备了幂等、重试、补偿、权限、分阶段上线、内外网隔离和跨端适配这些工程能力。未来如果再接“BOM 变更、价格变更、审批状态变更”等 ERP 事件,这套结构可以直接迁移,而不需要重新造一套通知链路。
一句话总结:把 ERP 的“变化”建模成可靠事件,把企业微信当成可失败的外部副作用;先持久化事实,再异步触达,最后用补偿和审计保证系统最终可解释、可恢复。
CSDN 说明:本文示意图均为带中文字体的 PNG,通过 Base64 直接内嵌普通 <img>;正文使用行内样式,适合在浏览器打开后复制到 CSDN 富文本编辑器。

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)