
c语言面试高频知识点
C语言面试通关秘籍:高频考点深度解析与实战
C语言作为编程界的常青树,其面试考点往往集中在内存管理、指针操作、底层原理等方面。根据这张思维导图,我们将面试内容划分为六大板块。让我们逐一击破。
一、数组和指针
这部分是C语言面试的“重灾区”,特别是复杂的类型声明。
1、指针数组
指针数组即存放指针的数组。例如:
int* p1,*p2,*p3; //声明指针变量
int* arr = {p1,p2,p3};//arr是指针数组,存放3个int*
2、数组指针
数组指针即指向数组的指针变量。例如:
int arr = {1,2,3,4,5};
int (*p)[5] = &arr;//p是一个指针变量,指向的数组存放5个int
int (*p)[5] = arr;//是错的!!!
很多人误以为数组名就是首元素地址,这个说法并不严谨。C 语言里数组名在大多数表达式会隐式转换成首元素地址,但sizeof(arr)和&arr是两个例外。arr和&arr打印出来地址数值一样,但是类型不同:arr隐转后是int*,代表首元素地址;&arr是int (*)[5]数组指针,代表整个数组的地址。数组指针赋值时,不能直接写p=arr,必须写p=&arr。指针加减的偏移量,由指针的类型决定。
3、函数指针
函数指针即指向函数的指针变量。例如:
int Add(int a,int b)
{
    return a+b;
}

int (*P)(int,int) = &Add;//*p是一个指向函数的指针变量,函数的返回值是int,参数是(int,int)
4、函数指针数组
函数指针数组即数组里存的是函数指针。(C++虚函数表即函数指针数组)。例如:
int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }

int main() {
    // 函数指针数组
    int (*ops[2])(int, int) = {add, sub};
    printf("%d\n", ops[0](10, 5)); // 输出 15
    return 0;
}
代码解析:
int (*ops[2])(int, int) = {add, sub};
*ops是一个函数指针数组,数组的容量是2,存放的函数的返回值是int,需要接收的参数是:(int,int)。
printf("%d\n", ops[0](10, 5)); // 输出 15
ops[0](10, 5):拿到ops第0号元素,即int add(int a,int b),传递参数(10,5)。
5、const和指针
const如果放在*的左边,修饰的是指针指向的内容,保证指针指向的内容不能通过指针来改变,但是指针变量本身的内容可变。例如:const int * p;const如果放在*的右边,修饰的是指针变量本身,保证了指针变量的内容不能修改,但是指针指向的内容,可以通过指针改变。例如:int* const p;
例如:
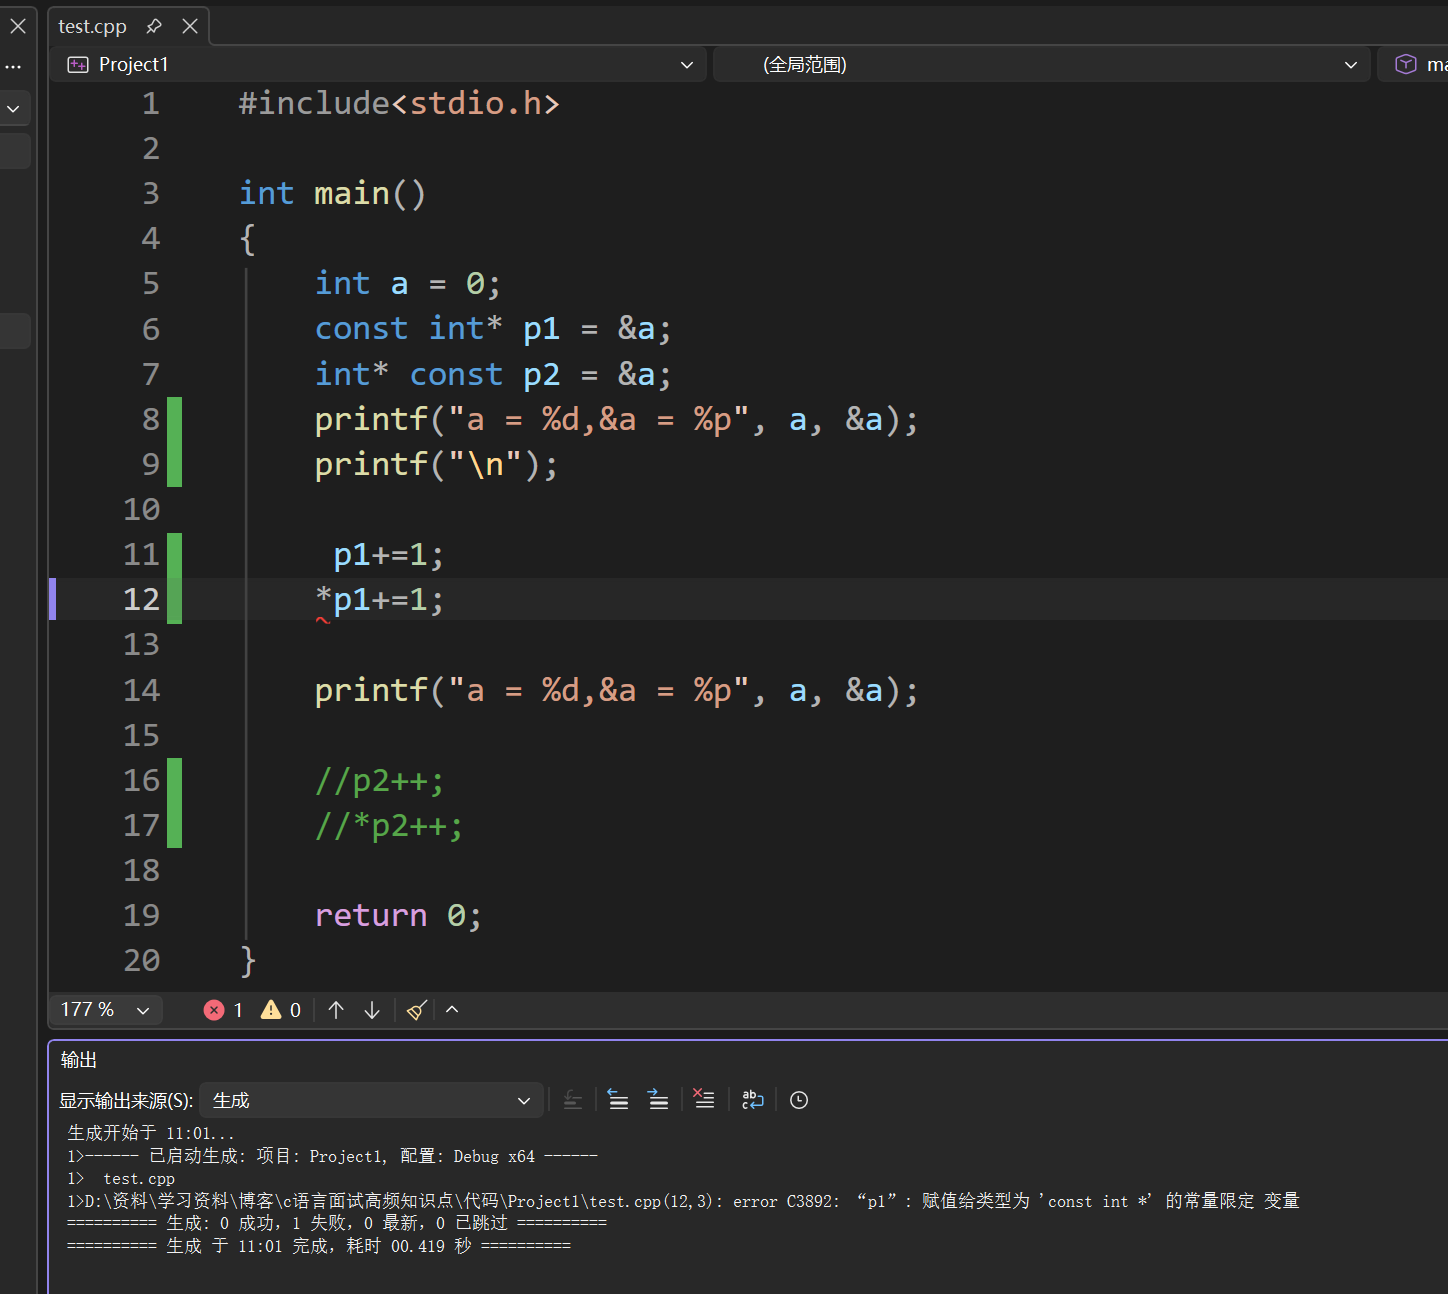
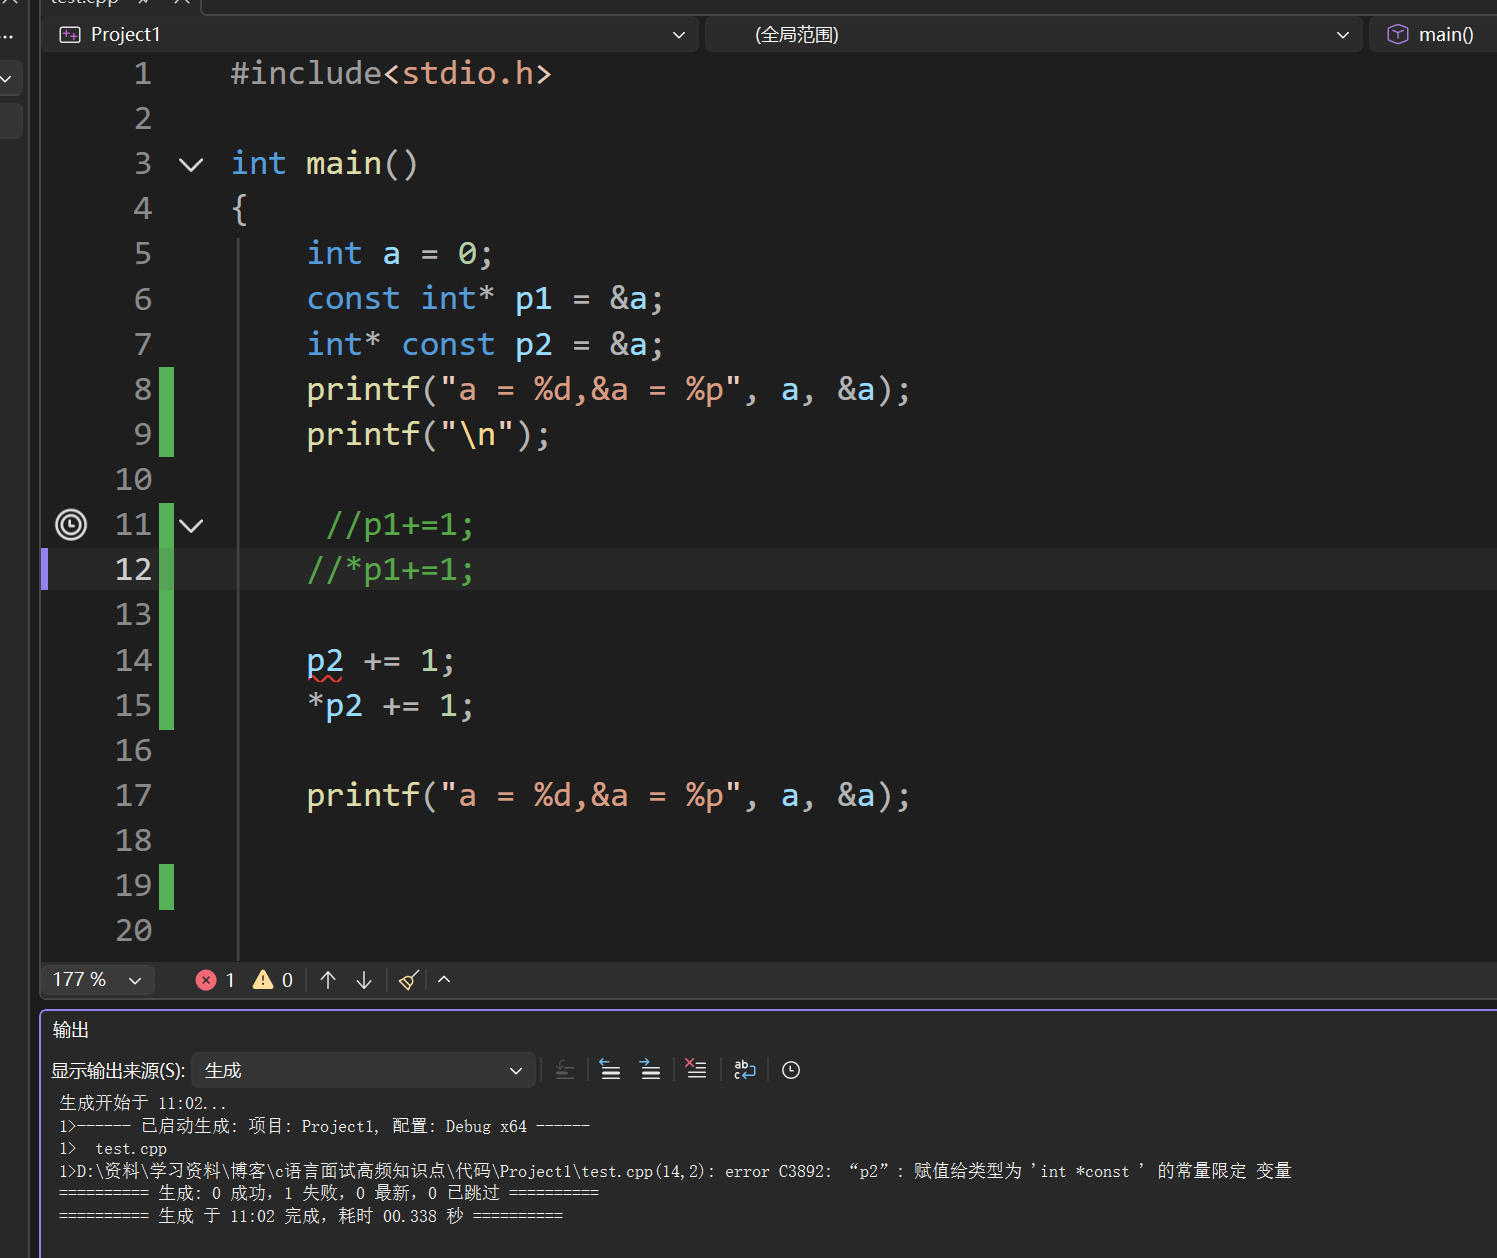
从图中可以看出结果和我们得出的结论一致。所以在项目中,某些不会改变的参数就可以使用const修饰来防止该变量被误改,提升程序的健壮性。
6、sizeof 和指针和数组
sizeof:操作符,计算变量/类型所占内存大小(包括\0),编译时确定。
- 数组名在
sizeof(数组名)中代表整个数组,算出数组总字节大小。 - 指针变量,
sizeof得到的是指针本身的大小(32 位机器 = 4 字节,64 位机器 = 8 字节) - 数组名传参到函数里会退化成为指针,在函数内部
sizeof就变成指针大小。
例如:
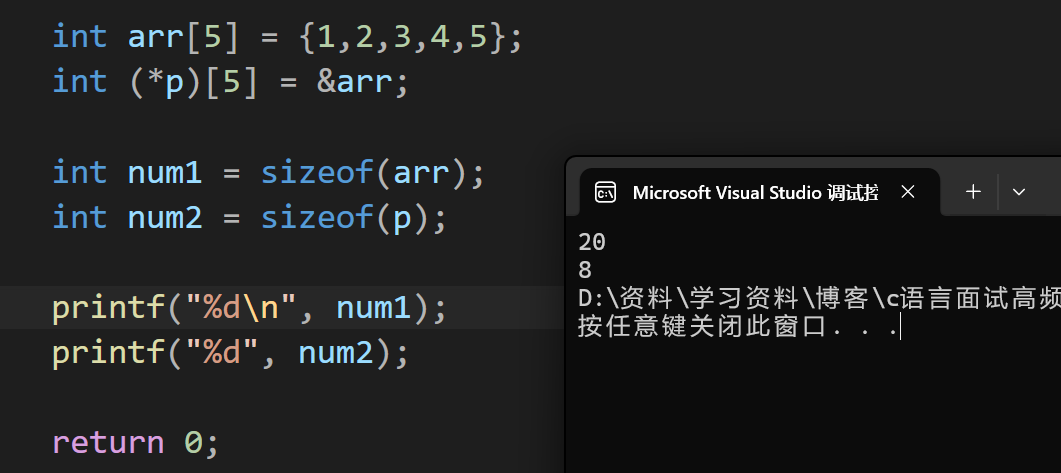
图中,arr数组一共有5个int类型数据,一共20字节,一个指针大小为8字节。
7、strlen 和指针和数组
-
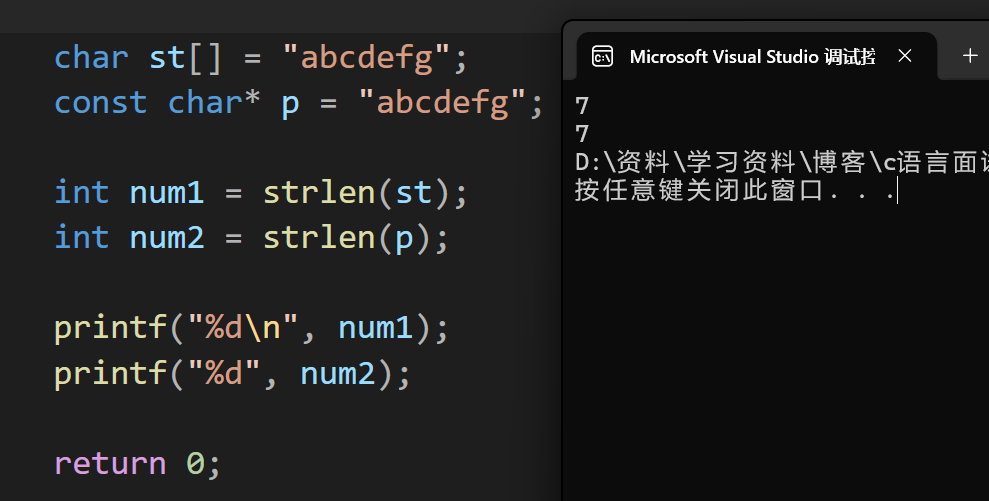
strlen接收的是地址,不管你传的是字符数组名,还是char*指针,都会当成地址去遍历。 -
sizeof编译期求内存大小;strlen运行期扫描内存。 -
扫描时遇到
'\0'就停止。
例如:
8、回调函数
通过函数指针调用的函数。如果把函数的指针(地址)作为参数传递给另一个函数,当这个指针被用来调用其所指向的函数时,我们就说这是回调函数。
二、库函数的模拟实现
1. memcpy
memcpy 不处理内存重叠,按字节从前往后拷贝。
#include <stddef.h>

void *my_memcpy(void *dest, const void *src, size_t n)
{
    if (dest == NULL || src == NULL || n == 0)
        return dest;

    char *d = (char *)dest;
    const char *s = (const char *)src;

    while (n--)
    {
        *d++ = *s++;
    }
    return dest;
}
要点:
- 参数用
void *,内部转成char *按字节拷贝。 - 返回
dest,支持链式调用。 - 不处理重叠内存,重叠时行为未定义。
2. memmove
memmove 需要处理内存重叠。判断 dest 和 src 的相对位置:
- 若
dest < src或dest >= src + n:不重叠或 dest 在前,从前往后拷。 - 否则:dest 在 src 后面且重叠,从后往前拷,避免覆盖。
#include <stddef.h>

void *my_memmove(void *dest, const void *src, size_t n)
{
    if (dest == NULL || src == NULL || n == 0)
        return dest;

    char *d = (char *)dest;
    const char *s = (const char *)src;

    if (d < s || d >= s + n)
    {
        // 从前往后拷贝
        while (n--)
        {
            *d++ = *s++;
        }
    }
    else
    {
        // 从后往前拷贝
        d += n - 1;
        s += n - 1;
        while (n--)
        {
            *d-- = *s--;
        }
    }
    return dest;
}
要点:
- 核心是判断重叠方向,决定拷贝顺序。
- 比较
d < s时,严格来说跨对象指针比较是 UB,但工程实践中常见;更严谨可用uintptr_t比较。
更严谨的写法:
#include <stdint.h>

void *my_memmove(void *dest, const void *src, size_t n)
{
    if (dest == NULL || src == NULL || n == 0)
        return dest;

    char *d = (char *)dest;
    const char *s = (const char *)src;

    if ((uintptr_t)d < (uintptr_t)s || (uintptr_t)d >= (uintptr_t)s + n)
    {
        while (n--) *d++ = *s++;
    }
    else
    {
        d += n - 1;
        s += n - 1;
        while (n--) *d-- = *s--;
    }
    return dest;
}
3. strstr
在 haystack 中查找首次出现 needle 的位置,返回该位置指针;找不到返回 NULL。
暴力实现
#include <stddef.h>

char *my_strstr(const char *haystack, const char *needle)
{
    if (haystack == NULL || needle == NULL)
        return NULL;

    if (*needle == '\0')
        return (char *)haystack;

    const char *h = haystack;

    while (*h)
    {
        const char *p1 = h;
        const char *p2 = needle;

        while (*p1 && *p2 && *p1 == *p2)
        {
            p1++;
            p2++;
        }

        if (*p2 == '\0')
            return (char *)h;

        h++;
    }
    return NULL;
}
要点:
needle为空串时返回haystack(C 标准规定)。- 外层遍历 haystack 每个起点,内层逐字符比较。
- 时间复杂度 O(m*n),m 为 haystack 长度,n 为 needle 长度。
KMP 实现(进阶)
如果面试要求优化,可以手写 KMP:
#include <stdlib.h>
#include <string.h>

static void build_next(const char *pat, int *next, int len)
{
    next[0] = -1;
    int i = 0, j = -1;
    while (i < len - 1)
    {
        if (j == -1 || pat[i] == pat[j])
        {
            i++;
            j++;
            next[i] = j;
        }
        else
        {
            j = next[j];
        }
    }
}

char *my_strstr_kmp(const char *haystack, const char *needle)
{
    if (haystack == NULL || needle == NULL)
        return NULL;

    int n = (int)strlen(haystack);
    int m = (int)strlen(needle);

    if (m == 0)
        return (char *)haystack;
    if (n < m)
        return NULL;

    int *next = (int *)malloc(sizeof(int) * m);
    if (!next)
        return NULL;

    build_next(needle, next, m);

    int i = 0, j = 0;
    while (i < n && j < m)
    {
        if (j == -1 || haystack[i] == needle[j])
        {
            i++;
            j++;
        }
        else
        {
            j = next[j];
        }
    }

    free(next);

    if (j == m)
        return (char *)(haystack + i - m);
    return NULL;
}
要点:
next数组记录最长公共前后缀。- 匹配失败时
j = next[j],主串指针i不回退。 - 时间复杂度 O(n+m)。
三、自定义类型
1、内存对齐
-
规则:
- 第一个成员在偏移量为0处。
- 其他成员要对齐到对齐数(编译器默认对齐数与成员自身大小的较小值)的整数倍地址。
- 结构体总大小为最大对齐数的整数倍。
- 嵌套结构体对齐到自己的最大对齐数整数倍。
-
示例:
struct S
{
    char c;   // 偏移0,大小1
    int i;    // 对齐数4,偏移4,大小4 (浪费3字节)
    double d; // 对齐数8,偏移8,大小8 (浪费0字节)
};
// 总大小:8的倍数,故为16字节
2. 联合体、共用体
-
概念:所有成员共用同一块内存空间,大小等于最大成员的大小。
-
应用:判断大小端。
union U
{
    int i;
    char c;
};
// 如果u.i=1,u.c为1则是小端,为0则是大端
3. 位段(网络报文的报头不常考)
-
概念:结构体成员后面加冒号和数字,指定占用的比特位数。
struct S { int a : 2; // a占2个比特位 int b : 5; // b占5个比特位 }; -
注意:位段的内存分配依赖编译器,可移植性差。
四、数据存储
1. 整形的存储规则(原反补)
- 原码:直接二进制表示。
- 反码:符号位不变,其余取反。
- 补码:反码+1。
- 内存存储:计算机内存中一律存储补码。
2. 为什么要存补码?
- 统一了0的表示(+0和-0在补码中都是全0)。
- 正数的原反、补、码一样,而负数的补码是自己的反码+1,而计算机又只有加法器,那么就可以利用加法来实现减法。例如:
a-b,可以写成a+(-b),也就是a的反码加上b的反码。
3. 大小端如何判断?
-
大端:低位字节存高地址。
-
小端:低位字节存低地址。
-
代码判断:
int check_sys()
{
    int i = 1;
    return *(char *)&i; // 返回1是小端,0是大端
}
4. 浮点数的存储
- 遵循IEEE 754标准。
- 公式:
(-1)^S * M * 2^E。 - 32位
float:1位符号,8位指数,23位尾数。 - 64位
double:1位符号,11位指数,52位尾数。
5. 类型提升和截断
-
提升:参与运算时,短整型(char, short)会自动提升为int。
-
截断:将长类型赋值给短类型时,直接截取低位。
char c = 300; // 300的二进制是 1 0010 1100,截断后为 0010 1100,即44
五、编译、链接
1. 宏(考察很多,轻松实现宏函数)
-
概念:预处理阶段的文本替换。
-
示例:写一个宏求两个数的最大值。
#define MAX(a, b) ((a) > (b) ? (a) : (b))
// 必须加括号,否则会有优先级问题
2. 编译链接的过程
-
预处理:展开头文件、宏替换、去注释、条件编译。生成
.i文件。 -
编译:语法分析、词法分析、语义分析、生成汇编代码。生成
.s文件。 -
汇编:将汇编代码转为机器码。生成
.o文件(目标文件)。 -
链接:合并段表、符号表合并与重定位。生成可执行文件。
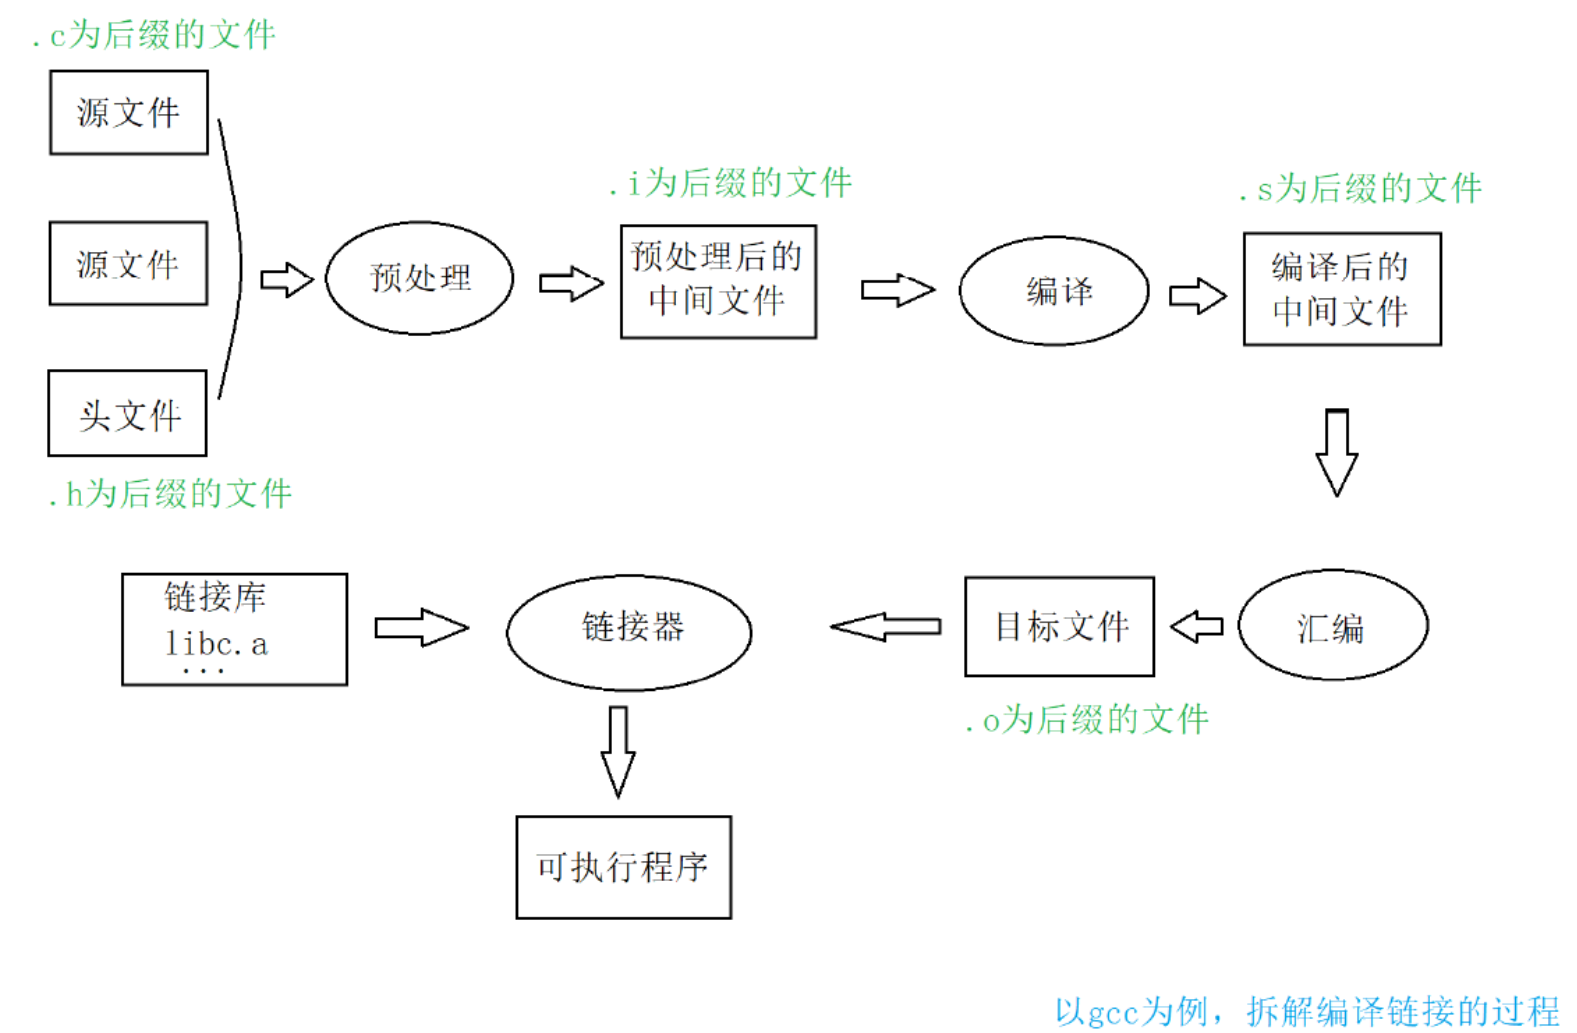
3. 条件编译
-
常用指令:
#ifdef,#ifndef,#endif,#if,#elif,#else。 -
应用:防止头文件重复包含。
#ifndef __TEST_H__
#define __TEST_H__
// 头文件内容
#endif
2. 编译链接的过程
-
预处理:展开头文件、宏替换、去注释、条件编译。生成
.i文件。 -
编译:语法分析、词法分析、语义分析、生成汇编代码。生成
.s文件。 -
汇编:将汇编代码转为机器码。生成
.o文件(目标文件)。 -
链接:合并段表、符号表合并与重定位。生成可执行文件。
[外链图片转存中…(img-fSQLKLTT-1790504346561)]
3. 条件编译
-
常用指令:
#ifdef,#ifndef,#endif,#if,#elif,#else。 -
应用:防止头文件重复包含。
#ifndef __TEST_H__
#define __TEST_H__
// 头文件内容
#endif
如有错误,恳请指出。

一站式 AI 云服务平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)