
【KMP算法-上篇】匹配失败之后,KMP 凭什么敢一次跳过一大段
给两个字符串 S1 和 S2,问 S1 里有没有 S2,有的话返回它出现的最左位置,没有就返回 -1。
这个问题叫字符串匹配。
最直接的做法,是把 S1 的每个位置都当成起点试一遍。
拿 S1 = “ABCD”、S2 = “CD” 来说:
从 0 位置开始,A 对 C 对不上,换 1 位置;
B 对 C 还是对不上,换 2 位置;
这次 C 对 C、D 对 D 都对上了,返回 2。
要是 S2 是 “CDE”,整个 S1 里找不出这一段,返回 -1。
这个做法好懂,代价是慢。
每换一个位置,S2 都得从 0 开始重新比一遍,前面那趟配出来的结果,帮不上后面那趟。
S1 有 n 个字符,S2 有 m 个字符,最坏情况下,从每个位置开始都要往后比 m 次,两边一乘就是 O(n × m)。
举个极端的例子,S1 是一长串 a,S2 是 “aaf”。
每个 a 当起点时,都要先对上两个 a,再在第三个字符上对不上,然后换下一个 a,把 S2 的前两个 a 重新对一遍。
KMP 算法换了个思路,它能把时间压到 O(n + m),靠的是 S1 的比对位置只往前,从不回头。
代价是先把 S2 加工一遍,加工出来的结果叫 next 数组。
这篇讲两件事:
next 数组长什么样,拿着它匹配时两个比对位置怎么走。
它自己怎么算出来,留到下一篇。
接下来都用这两个串:S2 = “AABAABCAABAABT”,S1 = “AABAABCAABAABXA”。
next 数组只看 S2
算它的时候,用的全是 S2 自己的字符,跟 S1 没关系。
S2 的每个位置对应一个数,这个数说的是:
它前面那段字符串里,前缀和后缀相等的最大长度。
前缀从头开始取,后缀到末尾结束。
这里有两个地方容易搞混:
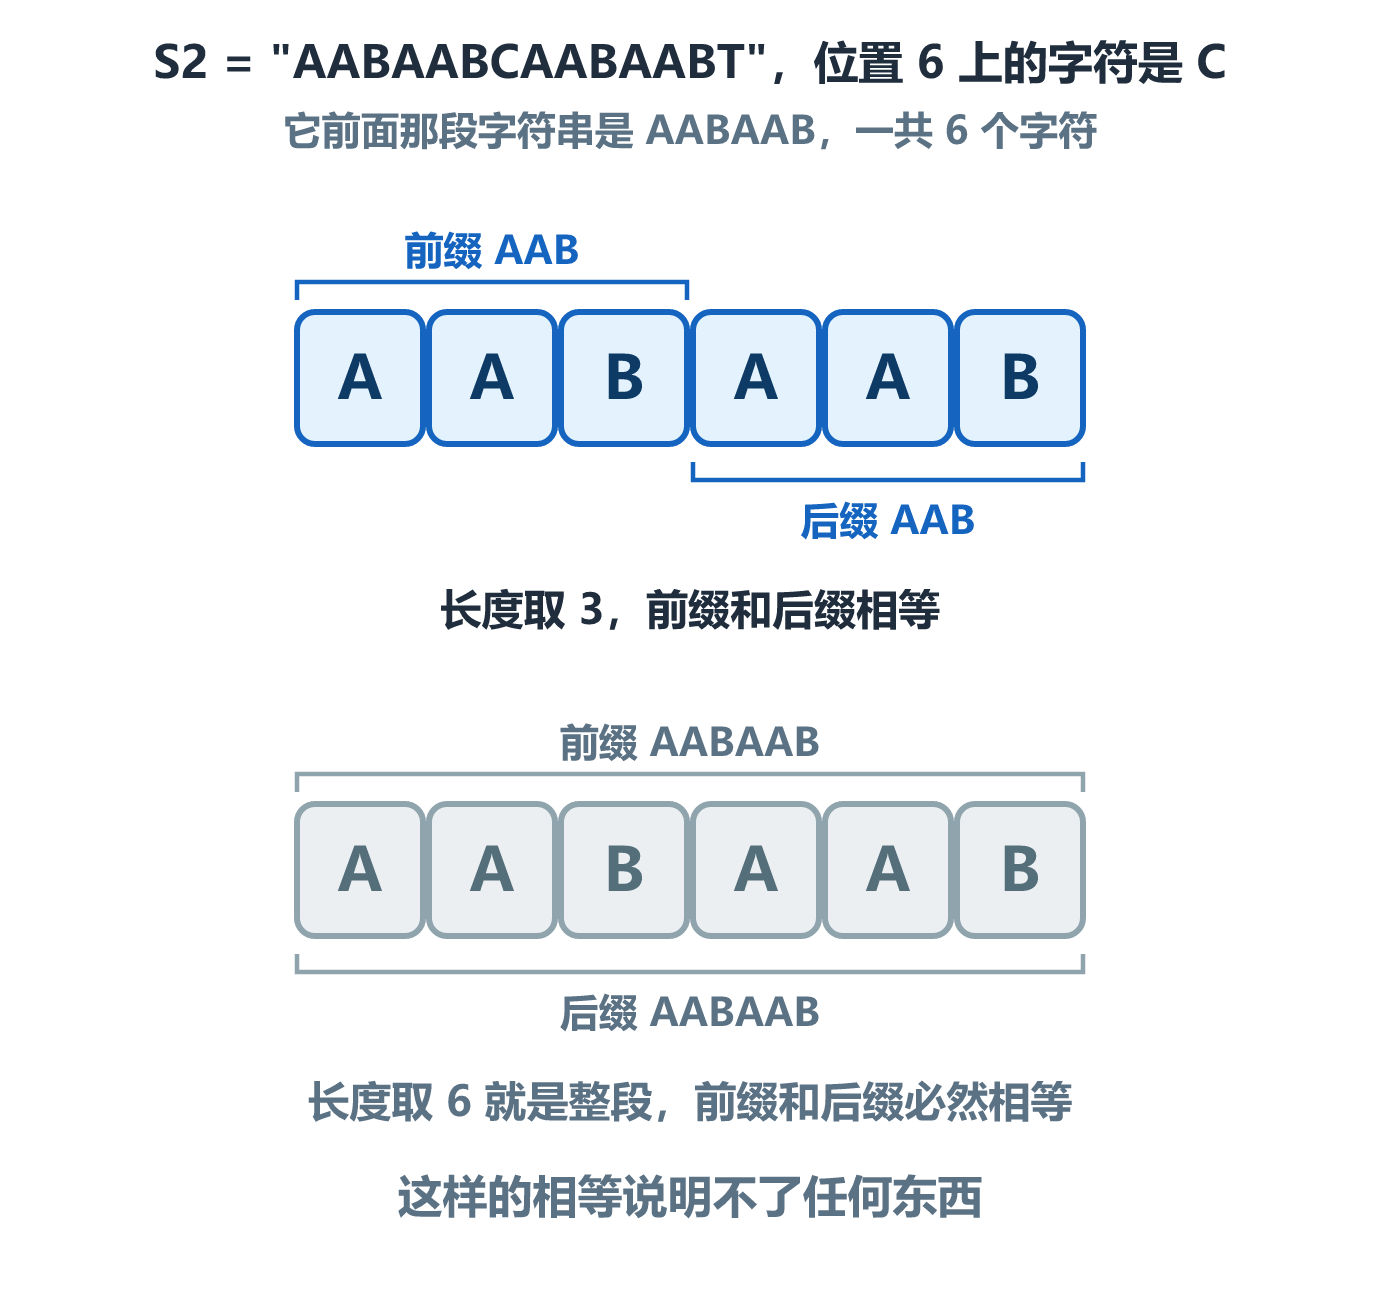
1.算的是这个位置前面那段字符串,不含这个位置上的字符。
2.前缀和后缀都不能取到整段。取到整段,就是拿整段去对整段,前缀和后缀必然相等,算出来的数就等于整段的长度,但这样的相等说明不了任何东西。
比如 S2 = “AABAABCAABAABT” 里的位置 6,这个位置上的字符是 C,它前面那段字符串就是 AABAAB。
这里假设 S2 至少有一个字符,先讲第 0 个和第 1 个位置。
第 0 个位置固定是 -1。
它前面一个字符都没有,这个长度不存在,按约定写成 -1。
第 1 个位置固定是 0,它前面只有一个字符,又不能取到整段,只能拿空的前缀去对空的后缀,长度是 0。
不管 S2 长什么样,这两个位置的值都是定死的。
把 S2 取成 “AABAABCAABAABT”,从头到尾算一遍:
| 位置 | 前面那段字符串 | 相等的最长前缀和后缀 | next 值 |
|---|---|---|---|
| 0 | 没有 | 没有 | -1 |
| 1 | A | 空 | 0 |
| 2 | AA | A | 1 |
| 3 | AAB | 空 | 0 |
| 4 | AABA | A | 1 |
| 5 | AABAA | AA | 2 |
| 6 | AABAAB | AAB | 3 |
| 7 | AABAABC | 空 | 0 |
| 8 | AABAABCA | A | 1 |
| 9 | AABAABCAA | AA | 2 |
| 10 | AABAABCAAB | AAB | 3 |
| 11 | AABAABCAABA | AABA | 4 |
| 12 | AABAABCAABAA | AABAA | 5 |
| 13 | AABAABCAABAAB | AABAAB | 6 |
挑几个位置核对一遍。
位置 2 前面是 “AA”,前一个 A 和后一个 A 相等,取 1。
位置 6 前面是 “AABAAB”,前三个字符和后三个字符都是 “AAB”,取 3。
位置 7 前面是 “AABAABC”,从头取一段、从尾取一段,怎么取都对不上,这个位置就是 0。
位置 13 前面是 “AABAABCAABAAB”,前缀和后缀里最长的一对是 “AABAAB”,取 6。
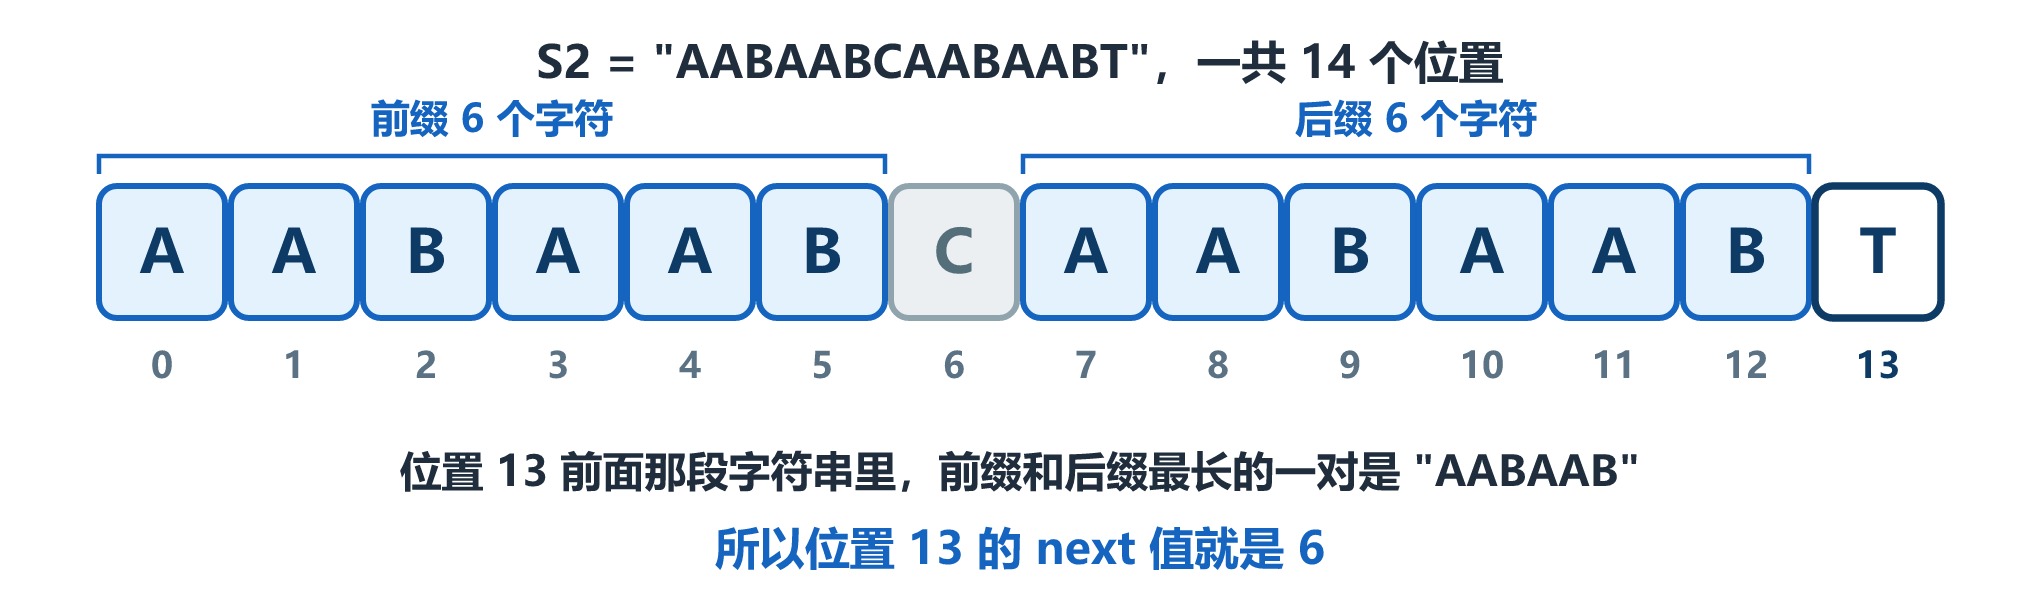
这张表就是 S2 的 next 数组,14 个位置,14 个数。
还有一种位置,它的前缀和后缀会重叠,这里提一下:
比如某个字符前面是 “AAAAA”,前缀取 4 个 A、后缀取 4 个 A,这两段有 3 个字符是共用的,两边照样相等,这个位置的 next 值就是 4。
刚才那个 S2 里没有这种位置,表里 14 个数,前缀和后缀没有一处叠在一起,看表和看图都更方便。
拿到 next 数组,两个比对位置怎么走
匹配还是从两个字符串的 0 位置开始,S1 的 0 位置对着 S2 的 0位置,字符相等就一起往后走。
走到对不上的时候,S1 的比对位置停住不动,S2 的比对位置退到它刚才那个位置的 next 值所在的位置上,接着往下比。
拿 S1 和这个 S2 走一遍。
两个串从各自的 0 位置开始,一路都对得上,一直对到 S1 的 13 位置和 S2 的 13 位置,这里对不上了。
13 位置的 next 值是 6,于是 S2 的比对位置退到 6,S1 的 13 位置不动,让这两个位置接着比。
S1中验证的起点,变成 S1 的比对位置减去 S2 的比对位置,即 13 减 6 得 7。
这一退的含义,就是 S2 不再从 S1 的 1 位置开始比对,改为从 S1 的 7 位置开始比对。
接下来要验的,是从S1的 7 位置起把 S2 配出来。
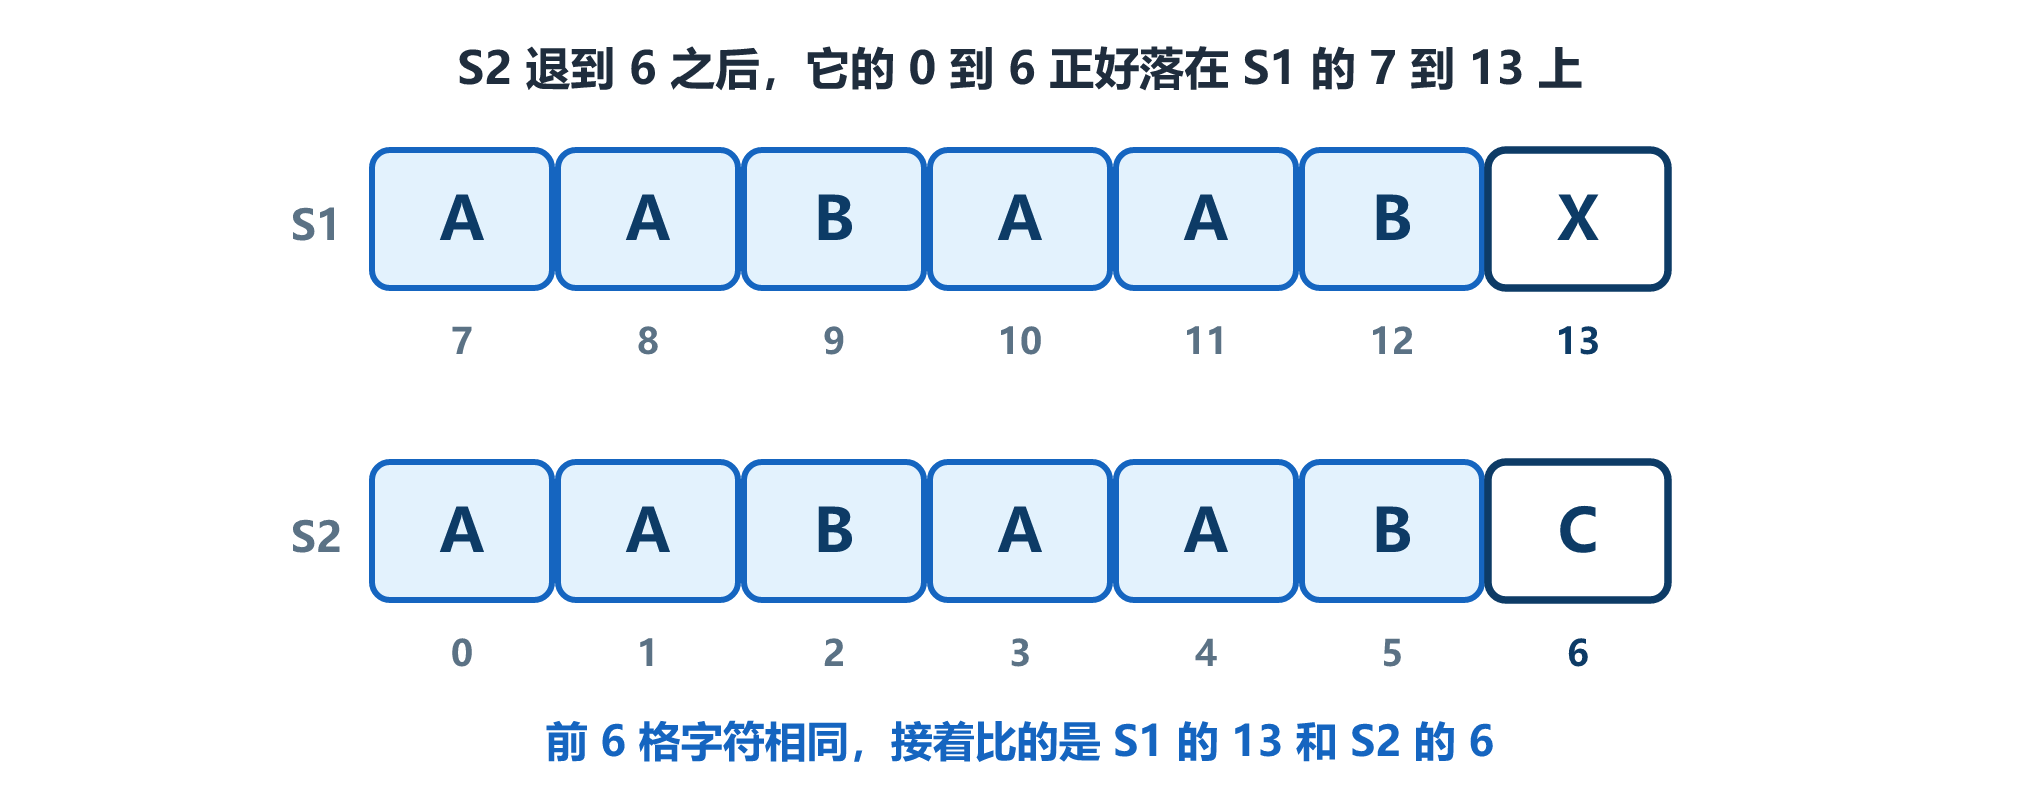
S1 的 13 位置对 S2 的 6 位置还是对不上,6 位置的 next 值是 3,S2 退到 3 位置,S1中验证的起点变成 10 位置。
S1 的 13 位置对 S2 的 3 位置依然对不上,3 位置的 next 值是 0,S2 退到 0 位置,S1中验证的起点变成 13 位置。
S1 的 13 位置对 S2 的 0 位置还是对不上,0 位置的 next 值是 -1。
这个 -1 说的是 S2 已经退无可退,没有位置可退了。
代码见到这个 -1,不把 S2 的比对位置真改成 -1,而是让 S1 换下一个位置,从 14 位置重新对上 S2 的 0 位置。
把整场匹配的几步列出来:
| 走到哪一步 | S1 的比对位置 | S2 的比对位置 | S1中验证的起点 |
|---|---|---|---|
| 还没开始 | 0 | 0 | 0 |
| 一路配到对不上 | 13 | 13 | 0 |
| 第一次退 | 13 | 6 | 7 |
| 第二次退 | 13 | 3 | 10 |
| 第三次退 | 13 | 0 | 13 |
| 退不动,换起点 | 14 | 0 | 14 |
整个过程可以收成一句:
相等就一起往前,不相等就把 S2 的比对位置回退到 next 数组元素的值对应的位置,S2 退无可退时,S1 的比对位置换下一个位置,S2 留在 0 位置。
S1 的 1 到 6 和 7 到 12 都不用再和 S2 比一遍
S1 从 7 位置开始验证的时候,S1 的 7 到 12 这 6 个字符没有重新对一遍,直接拿 S1 的 13 位置去对 S2 的 6 位置。
敢省掉这一步,凭的是 next 值自己的定义。
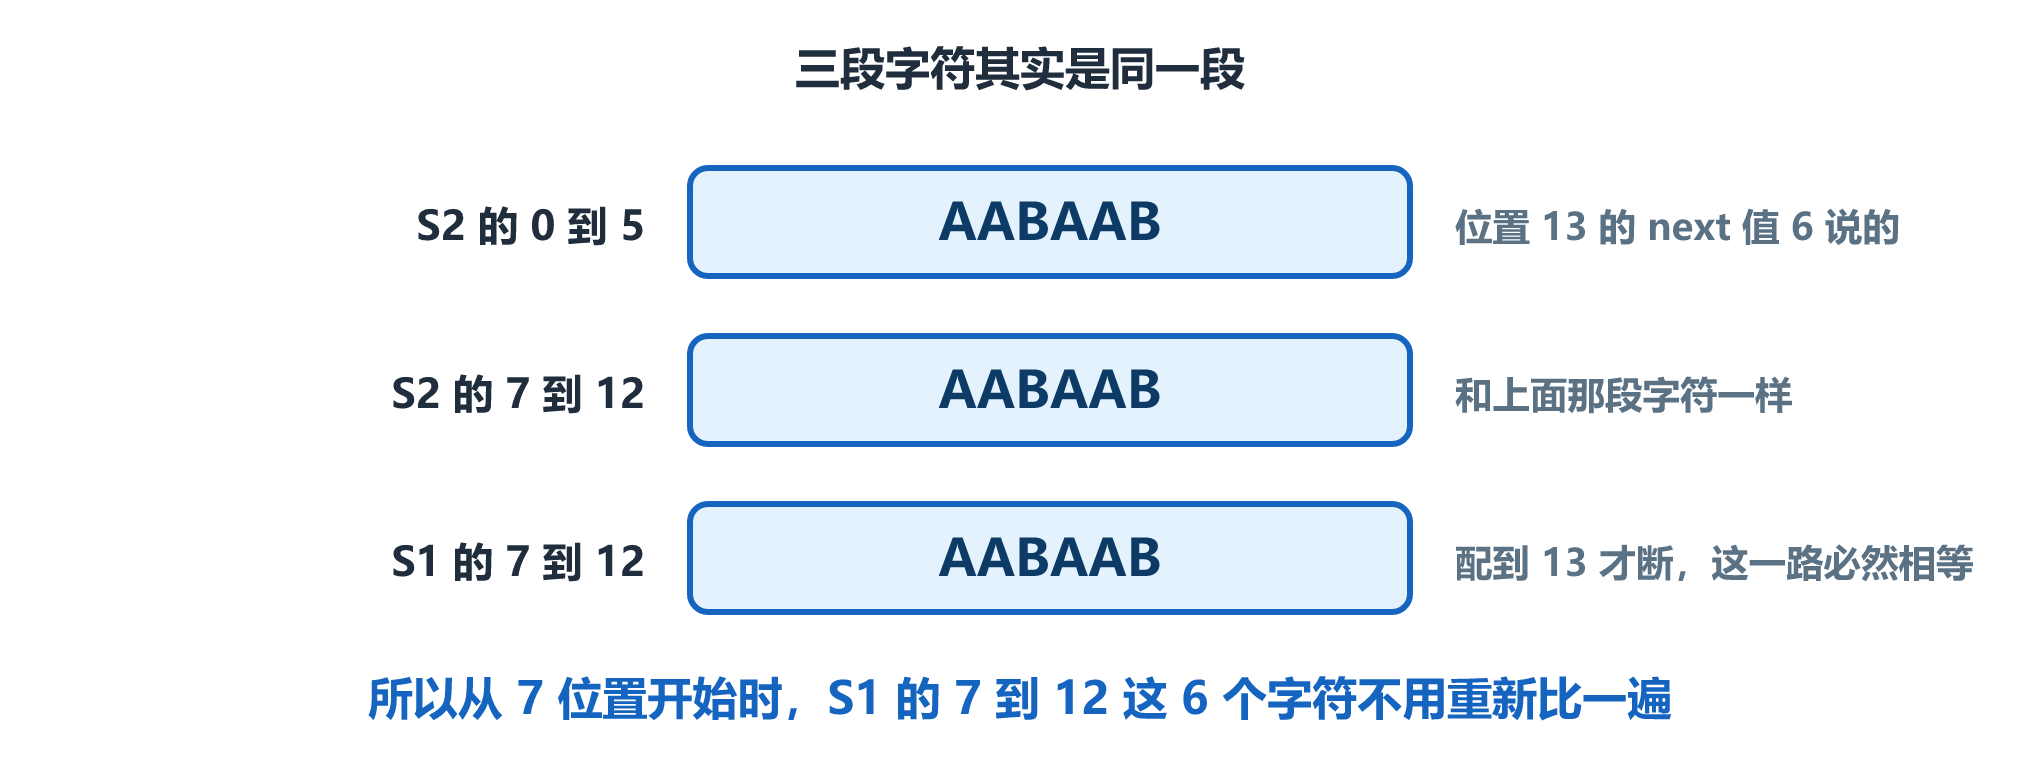
S2 的 13 位置的 next 值是 6,意思是 S2 里 0 到 5 这一段,和 7 到 12 这一段,字符完全一样,而且找不到比 6 更长的、相等的前缀和后缀。
再补一条已知事实:
刚才是一路从 0 配到 13 位置才对不上的,所以 S1 的 7 到 12 这一段,和 S2 的 7 到 12 这一段,字符也一样。
S2 里 0 到 5 这一段和 S1 的 7 到 12 这一段,都等于 S2 的 7 到 12,所以它们彼此也相等。
也就是说,S1 的位置 7 到 12 和 S2 的位置 0 到 5 的字符完全一致。
S2 对齐到 S1 的 7 位置之后,S1 的 1 到 6 这几个起点也可以直接跳过。
因为这几个起点配不出整个 S2。
只要反过来推一遍就清楚了。
假设里面真有一个起点,从它开始能把整个 S2 完整对上。
既然能对上,S1 从这个起点到 12 位置的一段,就得和 S2 的开头一段完全相等。
起点还必须在 1 到 6 之间,那这一段最少有 7 个字符。
S1 的 0 到 12 又是一路配到 13 位置才对不上的,所以从起点到 12 位置的同一段,也等于 S2 里同样位置的一段。
两个说法指的是 S1 里同一段字符,于是 S2 的开头一段,和 S2 靠后的同样长的一段,字符完全一样。
开头那段从 0 位置开始,是前缀;
靠后那段一直延伸到 12 位置,是后缀。
这一对相等的前缀和后缀,长度就是起点到 12 位置那段的长度,最少 7 个字符,比 6 长。
可 next 值 6 指的就是最长只到 6。
这个数是拿 S2 自己的字符算出来的,不会出错。
出错的就是刚才那个假设,1 到 6 这几个起点都配不出整个 S2,直接跳过去没有问题。
next 值的二义性
6 是 0 到 5 这六个字符的长度,而 0 到 5 后面紧跟着的那个字符,位置正好也是 6。
所以S2退到 6,退的是长度,也是那段前缀后面那个字符所在的位置。
两个说法指着同一格,写代码的时候直接用这个数当下标就行。
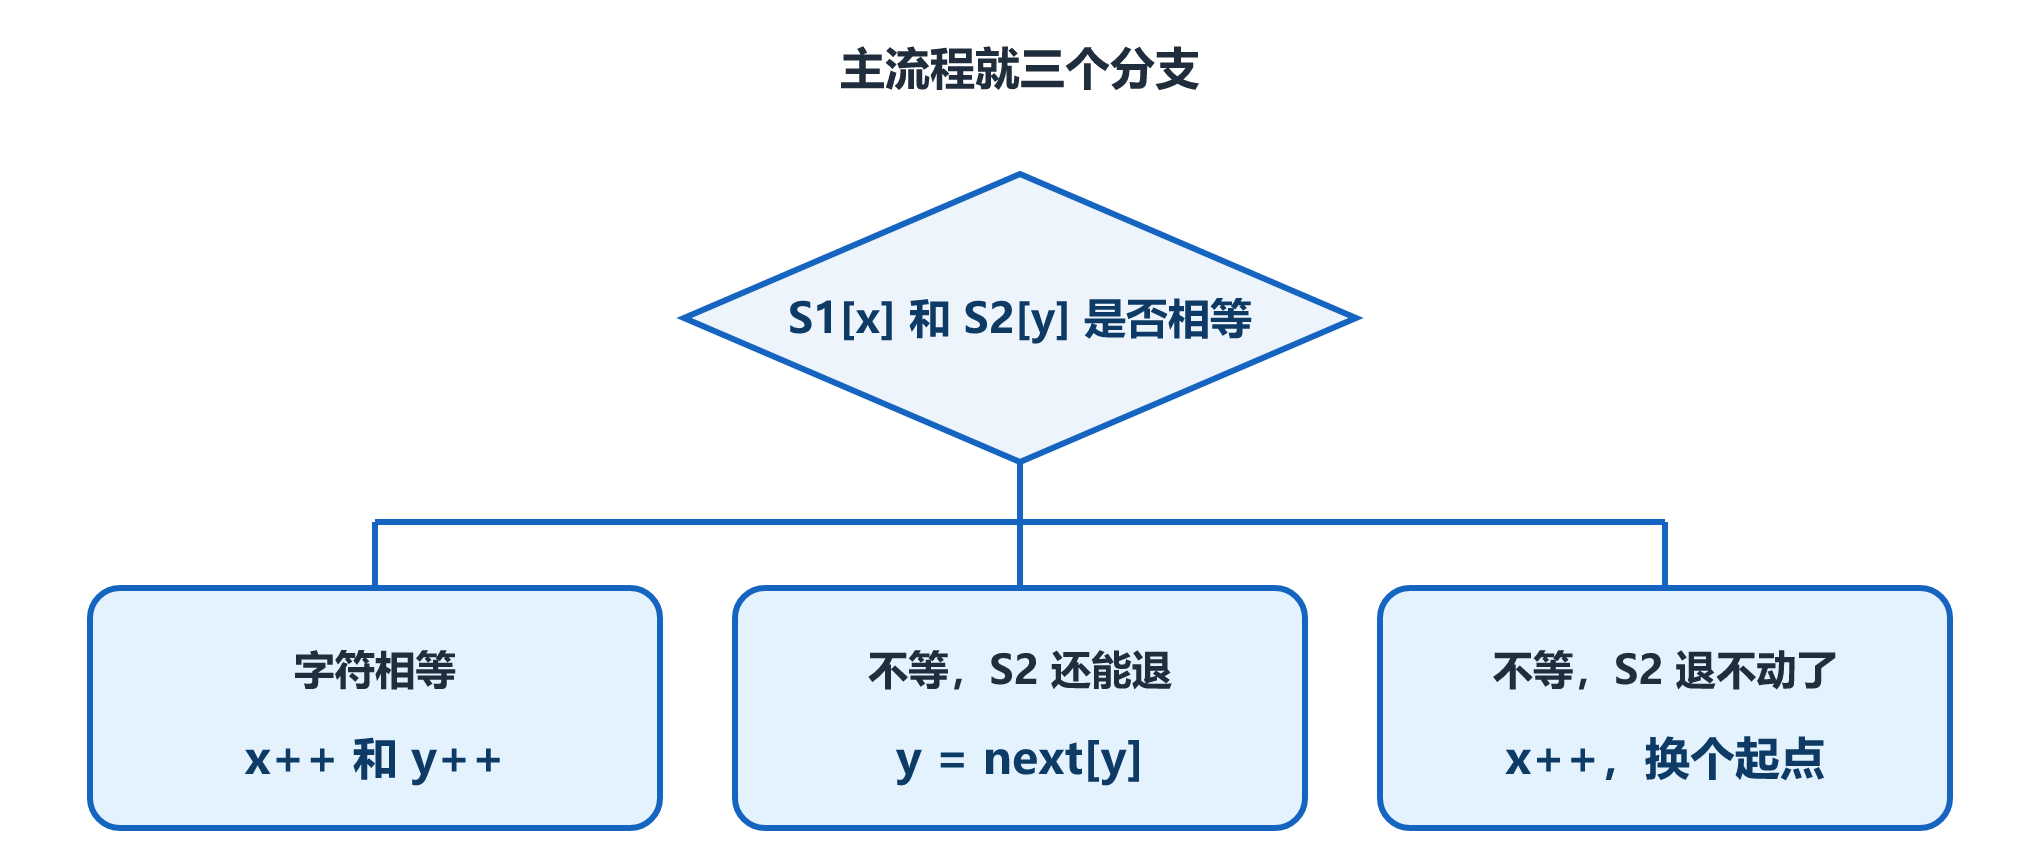
主流程就三个分支
不相等的时候,S2 的比对位置往回退,不会漏掉任何还能配上整个 S2 的机会;
S1 上跳过的那几个起点,本来就不可能配上。
这两件事合起来,整个匹配过程只剩三种情况。
1.两个位置的字符相等,两个比对位置一起往后走。
2.不相等,但 S2 还能退,S2 的比对位置退到 next 值上,S1 不动。
3.不相等,S2 退到 0 位置还是对不上,S1 换下一个位置重新开始,S2 还在 0 位置。
int x = 0;                       // S1 上正在比对的位置
int y = 0;                       // S2 上正在比对的位置

while (x < n && y < m) {
    if (s1.charAt(x) == s2.charAt(y)) {
        x++;                     // 相等,两个位置一起往后
        y++;
    } else if (next[y] == -1) {  // S2 退无可退,S1 换下一个起点
        x++;
    } else {
        y = next[y];             // S1 不动,S2 退到 next 值上
    }
}

return y == m ? x - m : -1;      // S2 走完说明配上了,起点是 x - m
| 代码 | 大白话 |
|---|---|
x++ 和 y++ 挨着 | 两边的字符对上了,一起往后挪一个位置 |
next[y] == -1 时单独 x++ | S2 已经退到 0 位置还是对不上,换 S1 的下一个起点 |
y = next[y] | S1 不动,S2 退到它自己记着的那个位置 |
y == m | S2 整个配完了,说明找到了 |
x - m | 比对位置往前推 m 个位置,就是这段匹配的起点 |
循环走完而 y 没到 m | S1 走到底还没配上,返回 -1 |
跳出循环的判据落在 y 上。
如果它走到 m,说明 S2 从头到尾都配上了,这时候 S1 的比对位置往后推 m 个位置就是答案。
如果它是被 x 走到底打断的,说明 S1 里没有 S2。
收尾
S1 的比对位置从头到尾只往前,没有往回退过,这就是 next 数组在匹配里做的事。
next 数组自己怎么算出来,以及这一路的来回为什么总共只花 O(n + m),这两件事放在下一篇。

一站式 AI 云服务平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)