
石化核心系统 MongoDB 国产化交付复盘:20 亿行数据 5 分钟无感切换
经手过几十个国产数据库替换项目,金融、政务、能源都做过。踩过的坑都是学费,希望帮你省下来。
工业场景核心生产系统的非关系型数据库国产化,是所有信创项目里最难啃的类型之一。
不是数据量大不大的问题。是数据模型特殊、操作语法封闭、替代方案缺失。传统替换路径基本等于"推倒重来"——应用代码重写、数据模型重构、业务逻辑重测。改造周期以年计,业务中断风险极高。很多企业对"非关系型数据库国产化"望而却步,不是不想做,是做不起。
2025 年,茂名石化联合电科金仓等单位,完成自控平稳率系统的 MongoDB 国产化改造。石化行业首个 MongoDB 国产替代落地案例。上线结果:应用零代码修改、数据零丢失、业务零中断,5 分钟完成新老系统切换。
这次把茂名石化项目的交付难点和实战经验复盘一下。如果你所在的能源企业、或者为工业企业提供服务的 ISV 正在推进信创改造,这篇应该有些参考价值。
工业场景数据库替换,难点在哪
先对齐认知。工业场景和 IT 系统的信创逻辑完全不同。
数据模型特殊。 文档数据库的数据模型和关系型数据库完全不同。MongoDB 的 BSON 格式、嵌套文档、数组字段、聚合管道——这些特性在关系型库里没有直接对应物。替换不是"导个 SQL 文件"就能搞定的。
操作语法封闭。 MongoDB 的查询语法、驱动 API、管理命令自成体系。国内长期缺乏能平滑替代的产品。传统替换方案要求大规模重写应用代码,改造量大、试错成本高。
高并发写入是刚需。 石化自控平稳率系统要实时采集全厂 DCS 数据,持续写入海量设备日志与运行数据。写入延迟从毫秒变成秒级,监控就失真了。写入吞吐量不能降。
7×24 不能断。 生产装置稳定运行是底线。系统停机哪怕几分钟,可能影响的是一套装置的平稳率监控。这和"凌晨维护窗口可以停机"的 IT 系统完全不同。
历史数据量大。 茂名石化这个项目,存量监测数据超 20 亿行。光全量迁移一次就要很久,增量同步必须跟上。
这些难点叠加在一起,工业场景文档数据库替换的核心矛盾是:技术封闭性 + 业务连续性 + 数据量级。三者缺一不可。
为什么工业场景现在集中推进信创
两个原因:
安全可控要求升级。 能源行业是关键信息基础设施,自主可控已从"倡导"变成"必须"。进口数据库的垄断局面需要打破,但前提是替代方案能扛住生产场景的考验。
技术成熟度够了。 经过金融、政务等行业的验证,国产数据库在关系型场景的替代路径已经成熟。文档数据库这块,随着金仓等厂商推出 MongoDB 兼容版本,平滑替代的技术可行性也得到了验证。
茂名石化案例:自控平稳率系统的交付经验
茂名石化自控平稳率系统是保障生产装置稳定运行的核心系统,负责实时采集全厂 DCS 数据,对数据库的并发写入能力与连续运行稳定性要求极高。
原有系统基于 MongoDB,运行多年后逐渐暴露出数据一致性保障弱、权限管控粗放、运维成本攀升等问题。改造目标明确:应用零代码修改、数据零丢失、业务零中断。
核心思路:不是让业务去适配数据库,而是让数据库兼容现有业务。
从交付角度看,这个项目的关键点有几个:
关键点一:全栈国产化技术栈搭建
茂名石化牵头搭建了从底层芯片、国产服务器与操作系统,到上层数据库与应用的全链条国产化技术栈。
这不是"只换数据库",是整条链路都换。底层芯片、服务器 OS、数据库、应用层——每一层都要验证兼容性。任何一层出问题,整条链路就会崩。
全栈替换的难点在于:不同层的成熟度不同。芯片和服务器的适配相对成熟,操作系统的适配也在推进,数据库是核心变量。如果数据库不能兼容现有应用,应用层就得改,全栈替换的成本就失控了。
关键点二:20 亿行数据的迁移策略
存量数据超 20 亿行,一次性迁移不现实。团队采用了"全量迁移 + 增量同步 + 双重校验"的策略:
第一步:全量迁移
    KDTS(金仓全量数据迁移工具)
    → 将 MongoDB 存量数据迁移到金仓数据库

第二步:增量同步
    KFS(金仓异构数据同步软件)
    → 全量迁移期间产生的增量数据实时追平
    → 保持源库和目标库数据一致

第三步:双重校验
    → 数据完整性校验(100%)
    → 数据一致性校验(误差 < 0.1%)

第四步:功能验证 + 性能压测
    → 测试环境全量功能验证
    → 峰值并发压测

第五步:灰度切换
    → 5 分钟内完成新老系统切换
这个流程的关键在增量同步。全量迁移只是第一步,CDC 增量同步保证切换那一刻数据一致。没有增量同步,零停机是不可能的。
关键点三:5 分钟无感切换
切换窗口只有 5 分钟。这 5 分钟要完成:
- 停止源库写入
- 确认增量数据追平
- 切换应用连接地址
- 验证核心功能
- 确认业务正常运行
5 分钟听起来很短,但前期准备充分——全量数据已迁移、增量数据已追平、测试环境已验证——切换本身只是改个连接字符串的事。项目团队的比喻很形象:“泡杯茶就上线”。
数据完整性 100%,一致性误差控制在 0.1% 以内。
关键点四:性能与成本的双重优化
上线后的实测数据:
| 指标 | 改造前 | 改造后 | 变化 |
|---|---|---|---|
| 首页加载时间 | 2.8 秒 | 1.45 秒 | 缩短约 48% |
| 后台审核响应速度 | 基准 | — | 提升 52% |
| 高峰写入能力 | — | 2800+ TPS | 满足峰值需求 |
| 系统可用性 | — | 99.999% | 五个九 |
| 自控平稳率监控效率 | 基准 | — | 提升 10%+ |
| 综合成本 | 基准 | — | 降低约 70% |
| 平均工期 | 基准 | — | 缩短约 75% |
| 运维工作量 | 基准 | — | 减少约 35% |
| 年度数据库维保支出 | 基准 | — | 下降约 28% |
如果沿用传统"推倒重来"的替换模式,20 亿行数据 + 复杂业务逻辑,仅应用层代码重构的工作量就难以估量,业务中断风险极高。而"应用零代码修改"的路径,让原有 DBA 团队无需重新学习就能上手运维,运维成本大幅下降。
对比:传统替换 vs 平滑替换
| 维度 | 传统"推倒重来" | 平滑兼容替换 |
|---|---|---|
| 应用代码 | 大规模重写 | 零修改 |
| 数据迁移 | 手动导出导入 | 全量 + 增量自动同步 |
| 停机时间 | 数小时至数天 | 分钟级 |
| 改造周期 | 以年计 | 数月 |
| 业务中断风险 | 极高 | 极低 |
| DBA 学习成本 | 需要重新学习 | 无需重新学习 |
| 适用场景 | 数据量小、业务简单 | 数据量大、业务复杂、不能停机 |
深度分析:为什么文档数据库替换这么难
关系型数据库的国产化替代,路径相对清晰——Oracle 到国产库的 SQL 兼容已经比较成熟。但文档数据库的替换完全是另一回事。
根本原因是数据模型的差异。
关系型数据库的数据模型是标准化的(表、列、主键、外键、SQL 语法),不同关系型库之间的迁移工具链成熟。但文档数据库的数据模型是非结构化的——嵌套文档、数组字段、动态 schema。每种文档数据库的存储格式和查询语法都有自己的特色。
MongoDB 的 BSON 格式、聚合管道、GridFS——这些特性在传统关系型库里没有直接对应。如果目标库不支持这些特性,替换就必须重写应用代码。
所以文档数据库国产化替代的关键能力是:协议兼容 + 数据模型对等 + 操作语法兼容。这三项能力缺一不可,否则就是"伪兼容"。
金仓数据库 MongoDB 兼容版走的正是这条路——在关系型数据库内核基础上,扩展文档数据模型能力,同时保持 MongoDB 通信协议和操作语法的兼容。这种架构的优势是:底层是成熟的关系型数据库内核(高可用、备份恢复、加密等企业级能力),上层兼容 MongoDB 协议(应用无需改代码)。
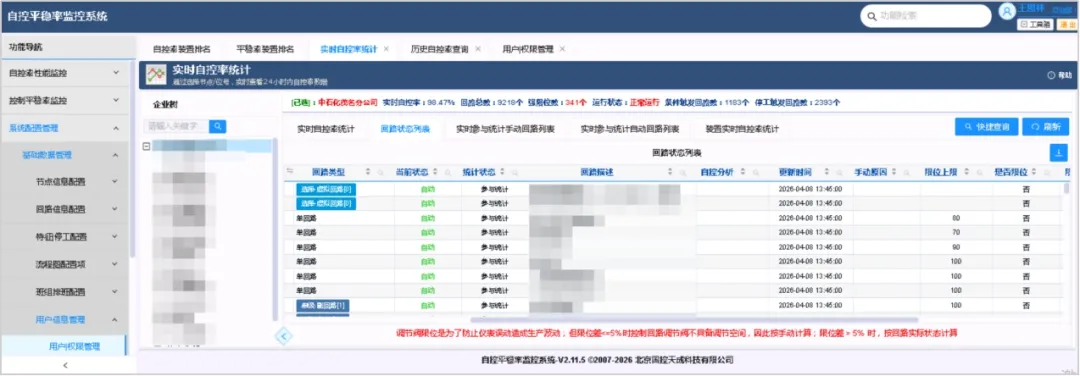
这也解释了为什么茂名石化项目能做到"应用零代码修改"——不是项目简单,是底层兼容能力做得足够深。
几点经验
从茂名石化项目里,提炼出几条硬经验:
-
兼容能力是第一评估项。 文档数据库替换,先看目标库能不能兼容现有应用的协议、语法、数据模型。兼容度决定了改造量。兼容度低,改造量成倍增长。
-
增量同步是零停机的核心。 全量迁移只是第一步,CDC 增量同步保证切换那一刻数据一致。20 亿行数据不可能一次性迁移完,增量追平是关键。
-
全栈替换要逐层验证。 芯片、服务器、OS、数据库、应用——每一层都要独立验证兼容性,再整条链路联调。不要假设"这层没问题,直接上"。
-
性能验证不能省。 文档数据库的写入性能对工业场景是生命线。上线前必须用真实业务数据做峰值压测,不能只看基准测试数据。
-
DBA 团队的能力延续很重要。 替换后如果 DBA 需要重新学习整套运维体系,隐性成本极高。选方案的时候要把运维学习成本算进去。
写在最后
工业场景核心系统的非关系型数据库国产化,是所有信创项目里难度最高的类型之一。数据模型特殊、操作语法封闭、业务不能中断、历史数据量超大——这些要求,任何一个行业的数据库替换都比不了。
但茂名石化的实践证明了这条路是走得通的。应用零代码修改、数据零丢失、业务零中断——这三个"零"不是口号,是完整的方法论:全量迁移打底、增量同步追平、双重校验兜底、灰度切换收尾。
打破了"替换国产非关系型数据库必须重构应用"的固有认知。有了第一个案例,后面就会有第二个、第三个。工业场景的信创替换,从"做不了"到"做得到",中间缺的不是技术,是第一个敢试的人。
后续我会继续分享更多行业信创迁移案例这些话题,跟着我一步步走,信创迁移这事就没那么难了。
交付过那么多迁移项目,有顺利上线的,也有半夜救火的。关注我,后续继续分享信创迁移一线实战。

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)