
不写一行接口代码,让 AI 读完 232 页年报:WorkBuddy × TextIn xParse 连接器实战全记录
摘要:一份 A 股年报 200 页起步,真正难的不是"读不完",而是"读不了"——关键信息全在表格里、数据散落在十几个章节、看完还不敢用。本文记录一次完整实战:把宁德时代 2025 年年度报告(232 页)变成结构化指标资产,全过程没有手写一句 HTTP 请求、没有拼过一个 header,所有解析与抽取由 WorkBuddy 的「TextIn xParse·智能文档解析」连接器完成。文章会给出连接器的三个工具怎么用、三组刻意做的失败实验,以及一次由勾稽校验抓出来的真实错误(资产负债率口径错了 3.48 个百分点)。
写在前面:这次想解决的不是"读不完"
一份 A 股年报,200 页起步。但真正让人难受的不是页数,是三件事:
第一,关键信息全在表格里,而表格是图片。 你要的营业收入、扣非净利润、毛利率、分产品收入结构,90% 躺在表格里。复制粘贴到 Excel,合并单元格全乱,跨页的表格直接断成两张。
第二,数据是散的。 三年的主要会计数据在一张表,分季度数据在另一张表(而且表头可能在上页、数据在下页),分产品收入在"管理层讨论"里,研发投入在第三节。想看一个完整的盈利质量判断,得在 200 多页里来回跳十几次。
第三,看完不敢用。 就算把数字抄下来了,怎么证明抄对了?页码、位置、上下文——一条证据链都留不下,复核的人只能重新翻一遍。
所以目标不是"用 AI 总结年报"(那只是把幻觉包了一层壳),而是:
把一份 232 页的 PDF,变成一份能逐一复核的结构化指标资产,并且产出能直接交给人的交付物。
一、为什么这次不手写接口
我最早的做法是脚本直调 TextIn 的 REST 接口(xparse/parse/sync 解析、v3/entity_extraction 抽取):自己拆片、拼 header、处理错误码、处理 50 页上限和分片页码偏移。
能跑,但有两个代价:
一是门槛。 想复现的人得先申请密钥、看懂两套接口的字段、自己踩一遍分页和偏移的坑——光把接口跑通就要小半天。这跟"让业务同学也能用"是矛盾的。
二是换了机器就失效。 脚本跑在我的电脑上,换台机器、换个同事,环境依赖又是一轮折腾。
这一次换了一条路:把 TextIn 作为连接器接进 WorkBuddy,让 AI 直接调用连接器暴露的能力。 全过程没有一行接口调用代码,解析、抽取、表格结构还原都是连接器在干活;WorkBuddy 只负责编排、校验和产出。
差别不是"省了几行代码",而是——这件事从"工程师的活"变成了"任何人在对话框里能做完的活"。
二、连接器给了三个工具,各自该用在哪
接进 WorkBuddy 之后,「TextIn xParse·智能文档解析」暴露了三个工具。分工非常清楚,用错地方会事倍功半:
| 工具 | 它返回什么 | 什么时候用 |
|---|---|---|
recognition_text | 纯文本层,按阅读顺序把整页文字拉平 | 需要拿全量数值/上下文、确认文档里某个字段到底怎么写的 |
doc_to_markdown | 保真结构:HTML 表格(含 colspan 合并单元格)、标题层级、页码注释 <!-- 30 --> | 需要表格结构本身,或需要拿到维度名(行标签) |
general_information_extration | 定向抽取:只给 key(要哪些字段)或 table_header(要哪张表),返回字段值 + llm_confidence | 已经知道要什么,只想拿结果 |
三个都支持本地文件路径,也支持 HTTP/HTTPS 文档地址。
理解这三条线之后,整个流程就变成一句话:用 recognition_text 看全貌,用 doc_to_markdown 拿结构,用 general_information_extration 拿数。
三、把 TextIn 接进 WorkBuddy
连接器是配置出来的,写进 ~/.workbuddy/mcp.json:
{
  "mcpServers": {
    "textin-xparse": {
      "command": "npx",
      "args": ["-y", "@intsig/server-textin"],
      "env": {
        "APP_ID": "你的 APP_ID",
        "APP_SECRET": "你的 APP_SECRET",
        "MCP_SERVER_REQUEST_TIMEOUT": "600000"
      },
      "timeout": 600
    }
  }
}
⚠️ 写完 json 不会自动生效。 必须到 WorkBuddy 左侧栏的「专家·技能·连接器」→ 顶部「连接器」标签,从右上角「自定义连接器」进去,在「MCP 服务管理」里找到它并点「信任」。少这一步,配置写得再对也不会被加载。
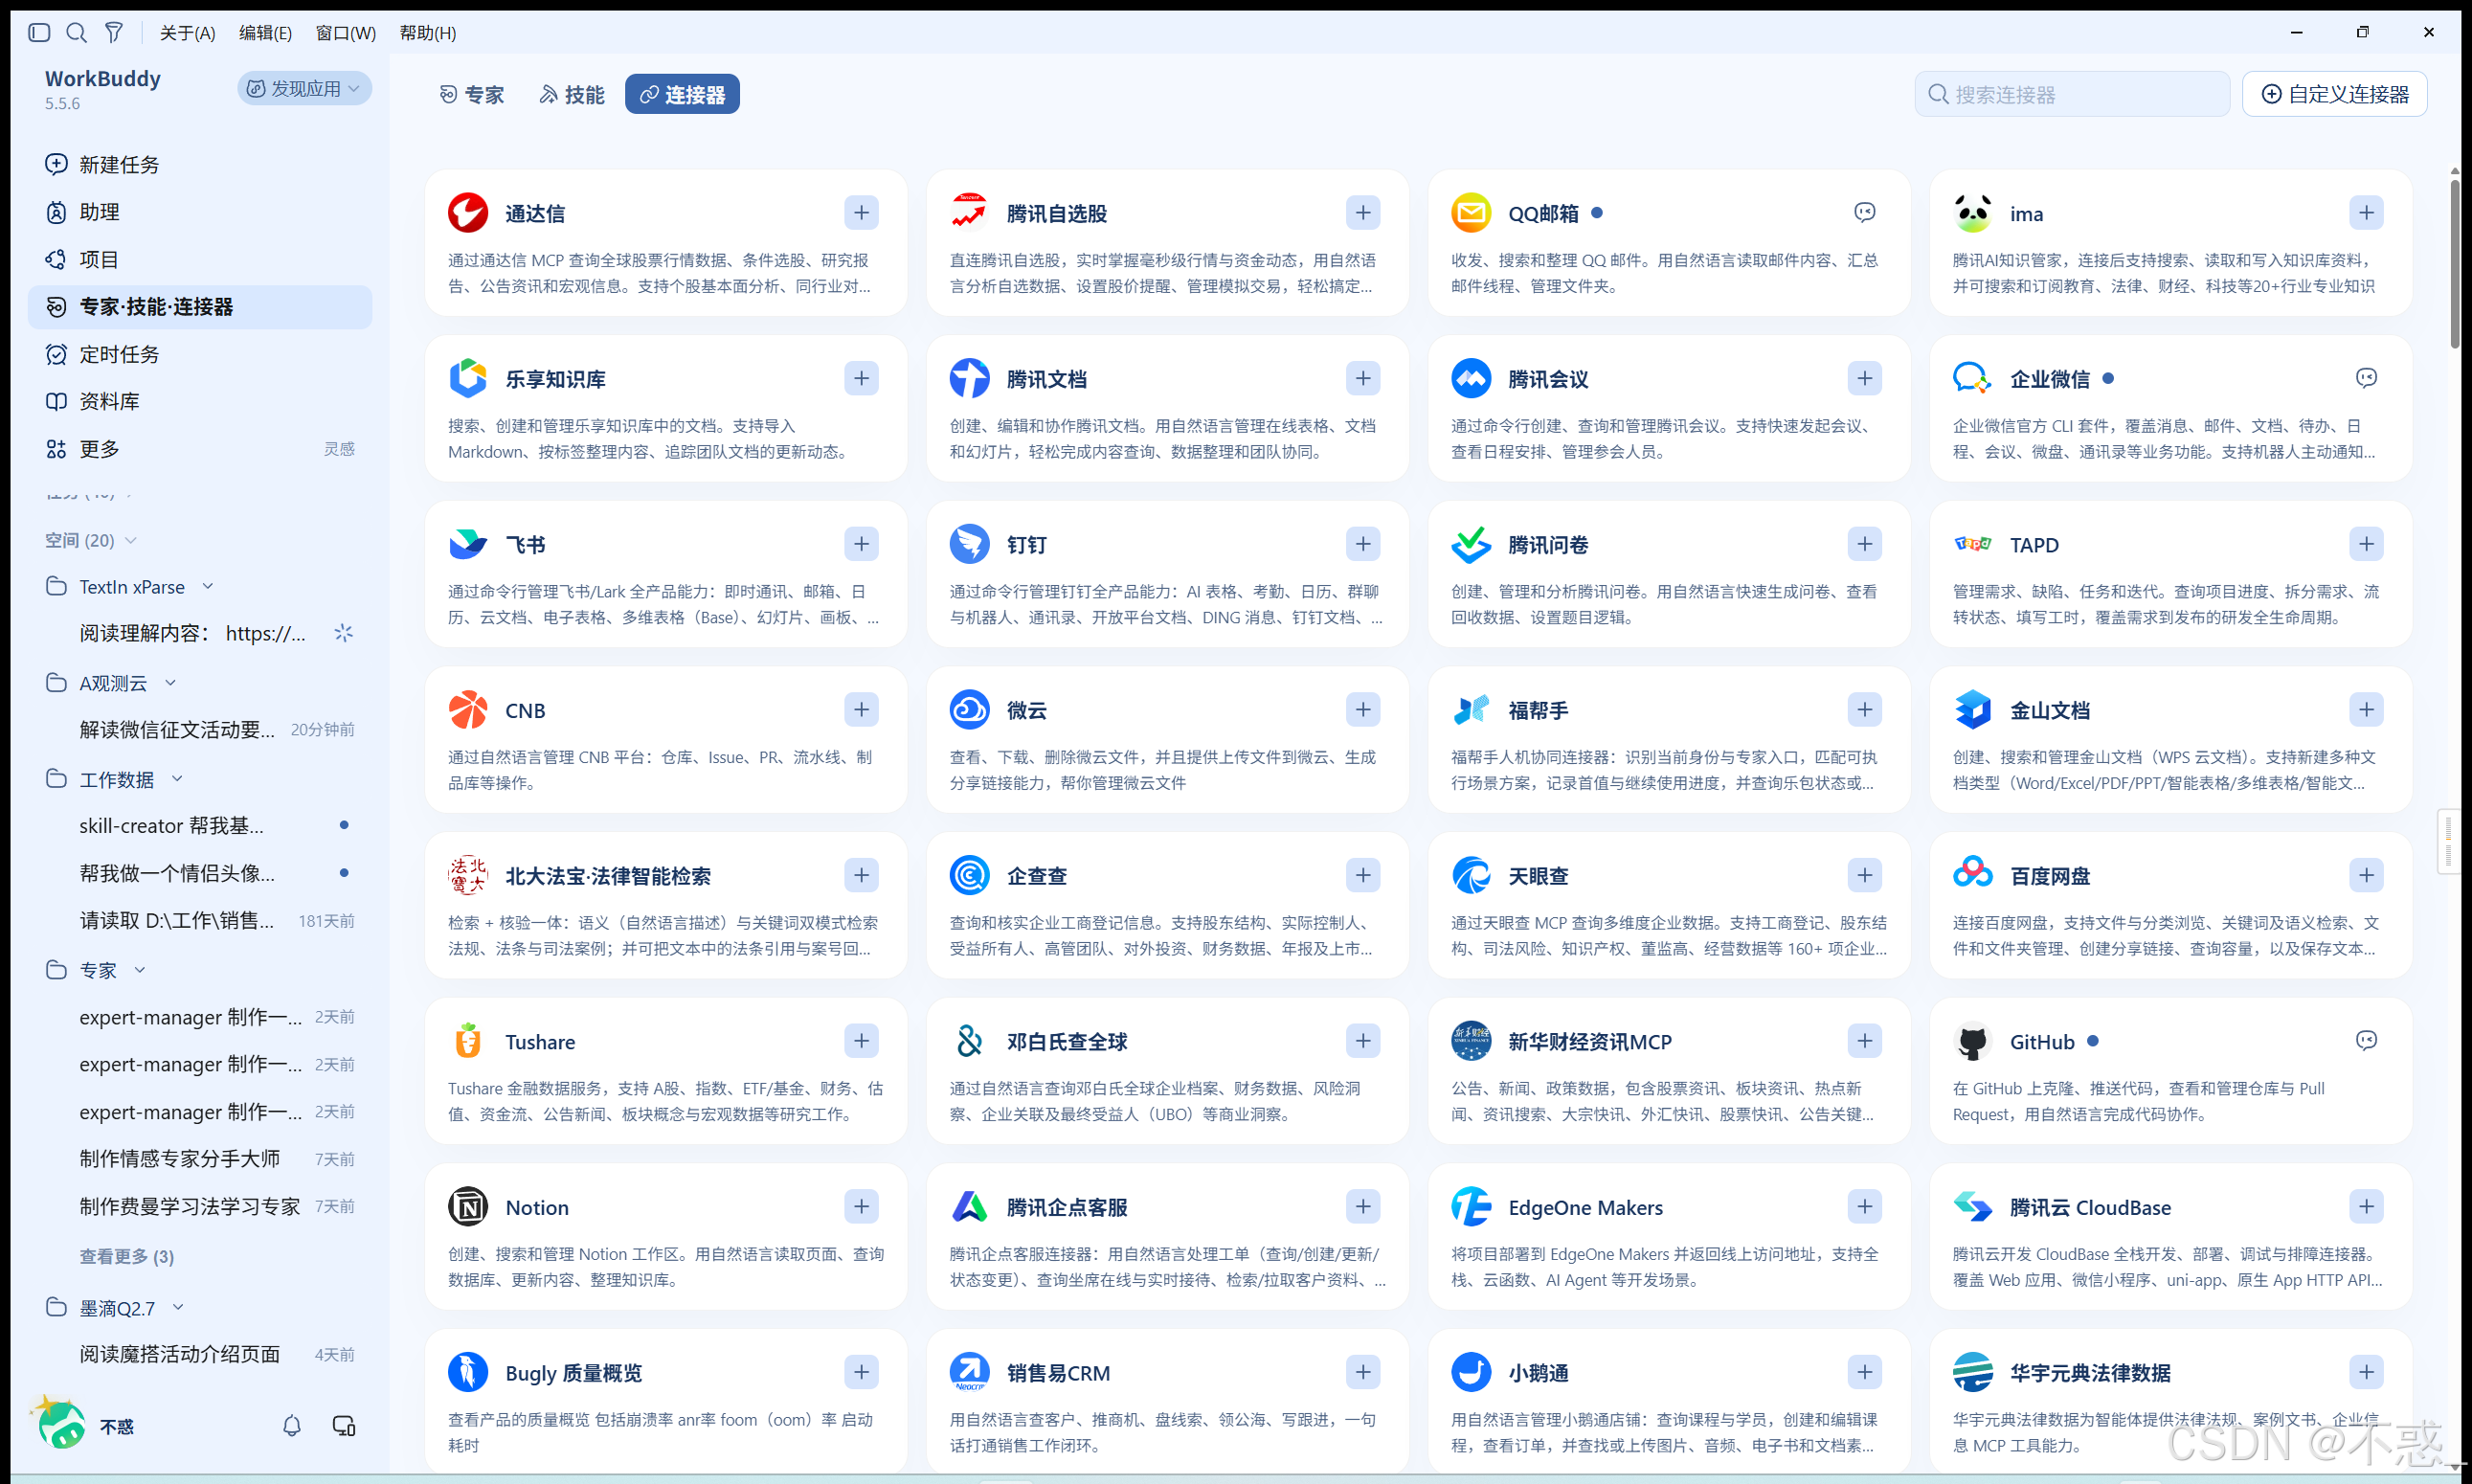
图 1:WorkBuddy 的「专家·技能·连接器」页面。 左侧栏是统一入口,顶部三个标签分别是专家 / 技能 / 连接器。连接器市场里排着飞书、钉钉、TAPD、GitHub 等官方连接器;右上角「自定义连接器」用于管理自己通过 mcp.json 加进来的服务——TextIn 就在那里。
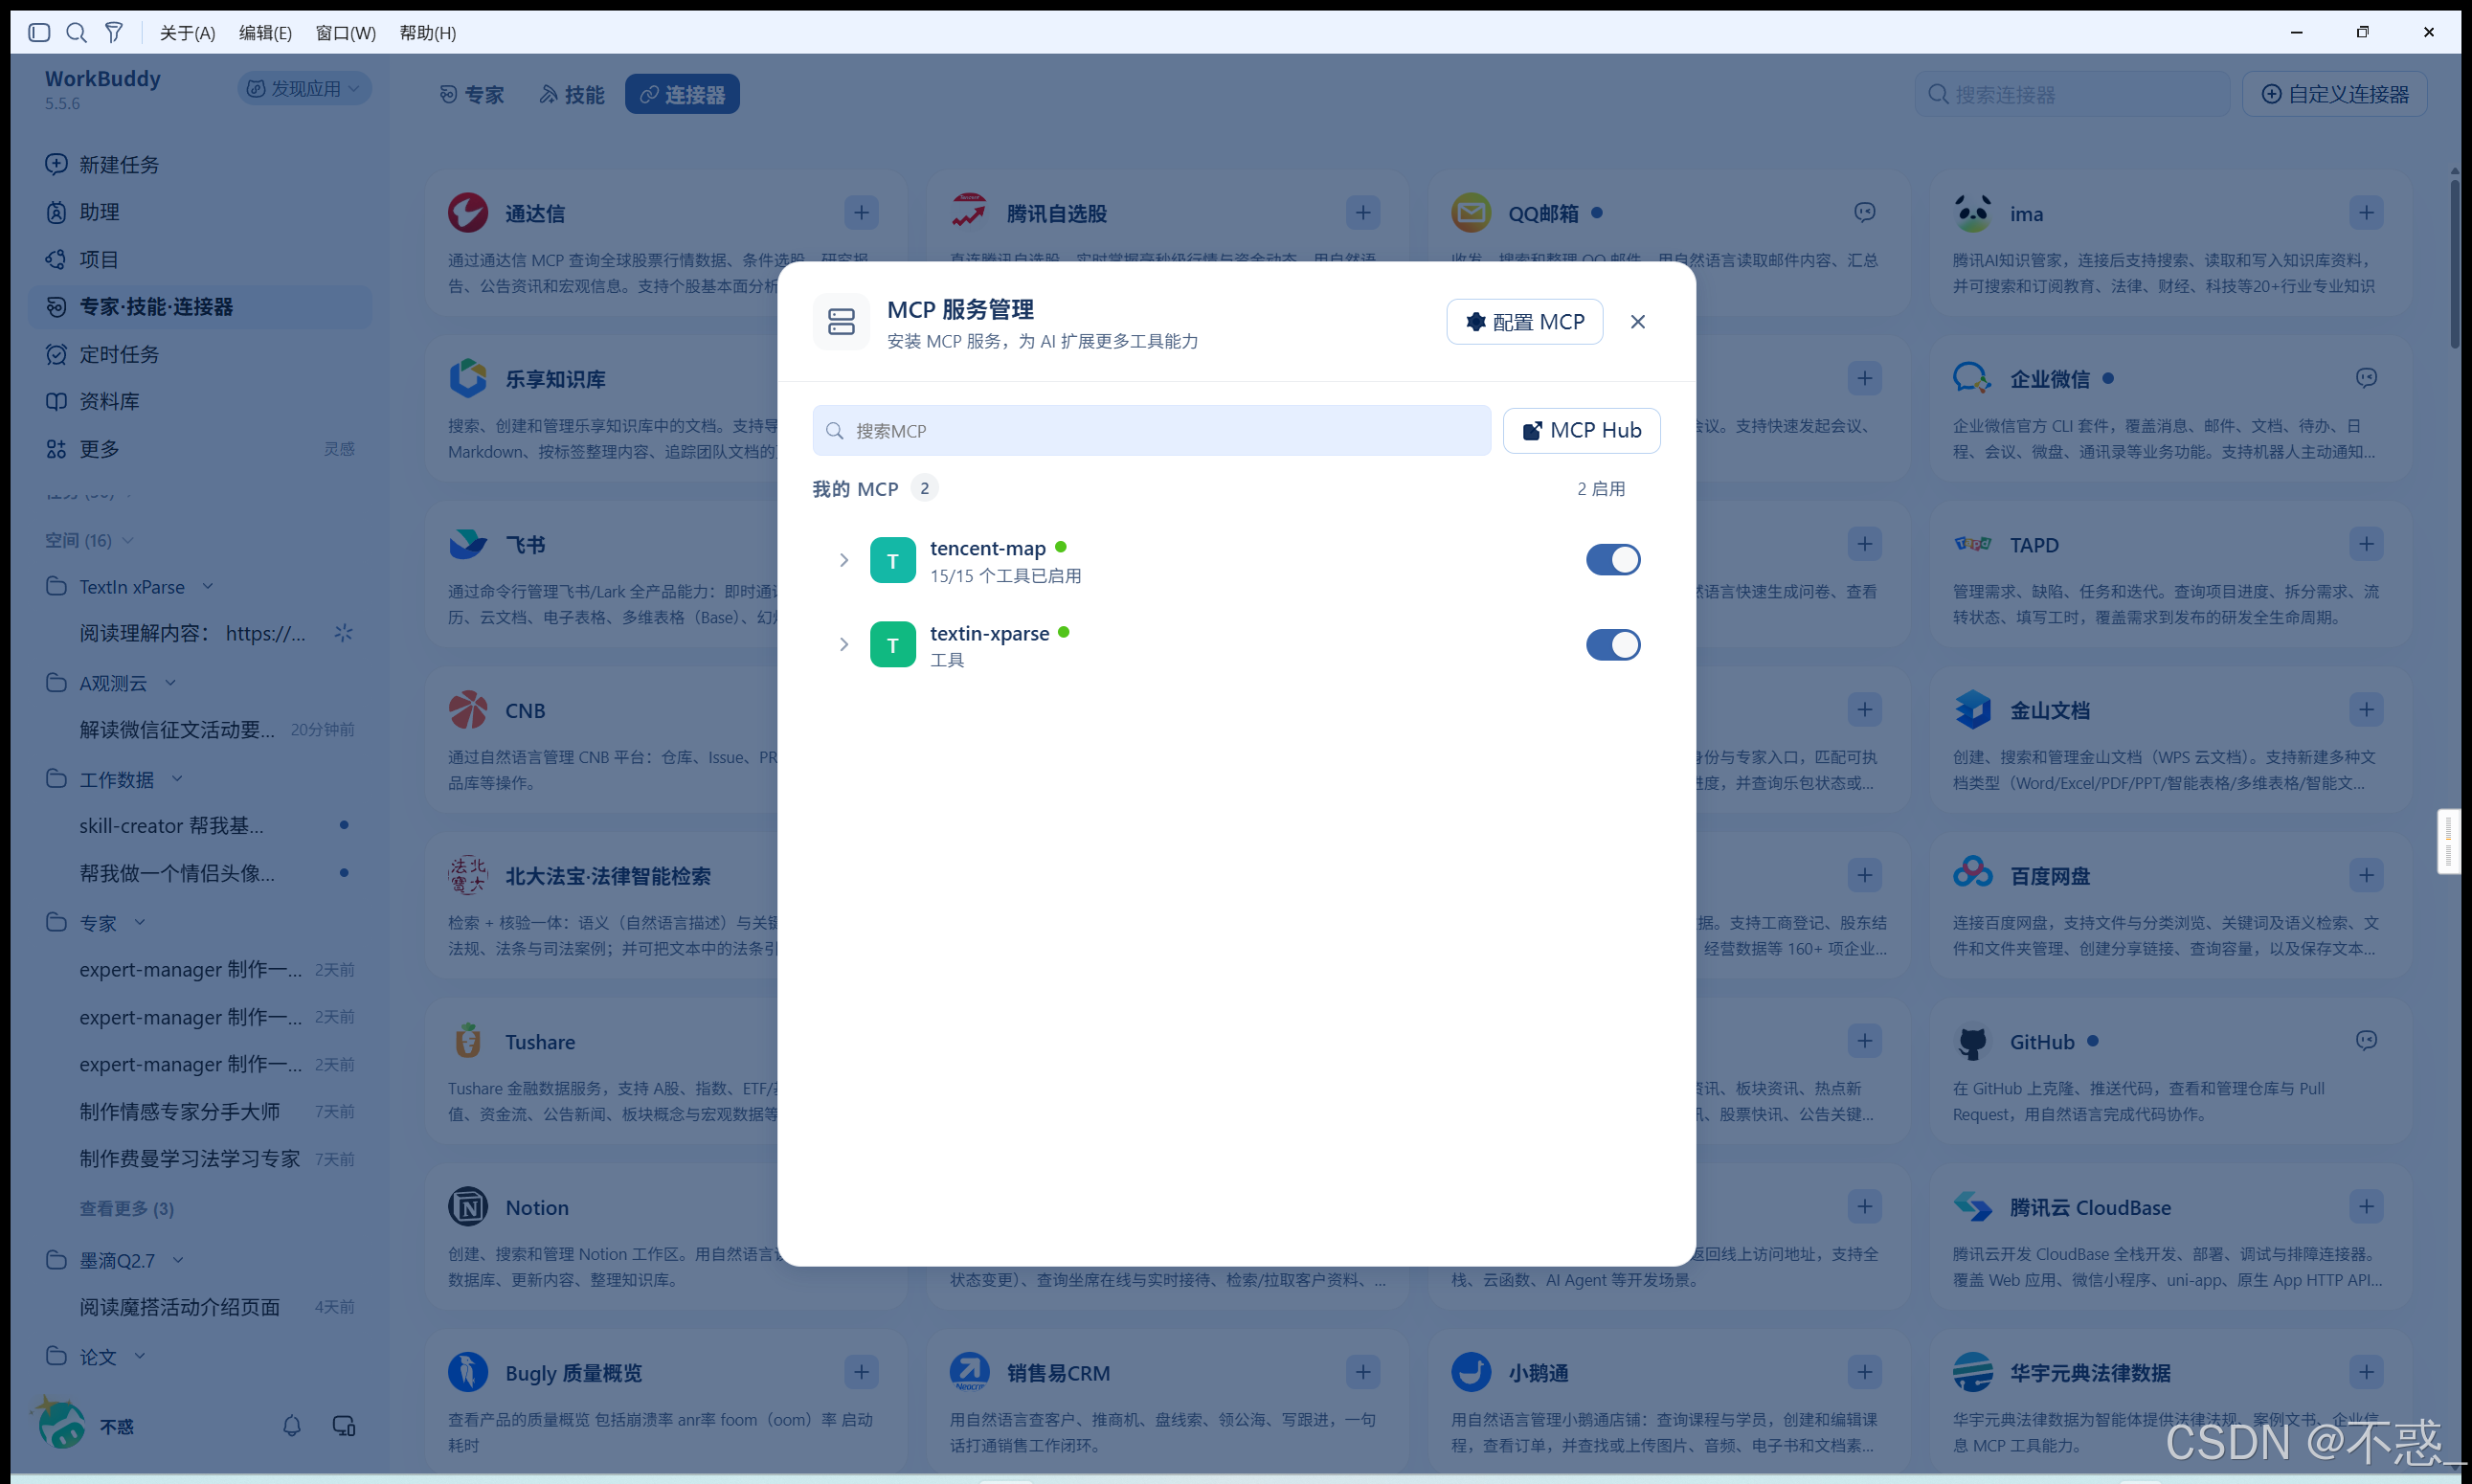
图 2:「MCP 服务管理」对话框。 标题下方显示「我的 MCP 2 / 2 启用」——tencent-map 是 15/15 个工具已启用,textin-xparse 已启用(状态点变绿)。到这一步,TextIn 才真正成为会话里可以直接调用的原生工具。
四、数据源与预处理
数据源用巨潮资讯网(cninfo),证监会指定的信息披露平台。
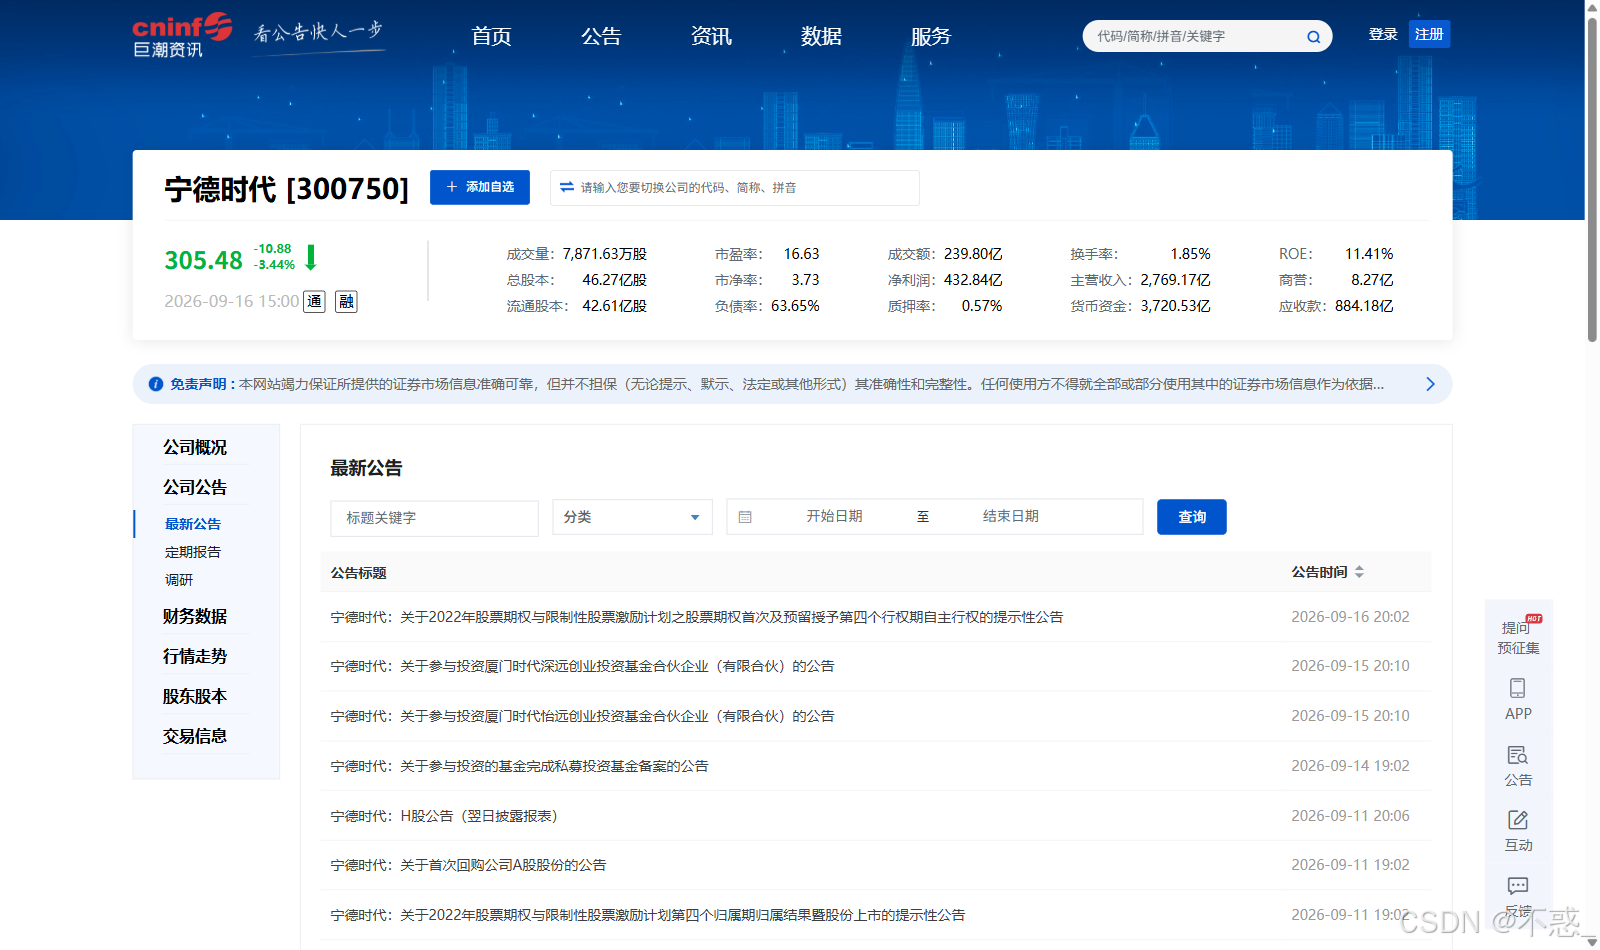
图 3:巨潮资讯网的 300750 个股页。 页面右上角可以看到当日实时行情:股价 305.48 元、市盈率 16.63、市净率 3.73、ROE 11.41%、主营收入 2,769.17 亿、净利润 432.84 亿、资产负债率 63.65%。
图 4:下载后的 2025 年年度报告首页,标题为"宁德时代新能源科技股份有限公司 2025 年年度报告",落款 2026 年 3 月,共 232 页。
拿到整本 PDF 之后,第一件事是切片。理由不是"接口限制"——整本 232 页它确实读进去了(第十节会把整本直抽的三种翻车方式摆出来)——而是页范围直接决定抽取结果的干净程度,也直接决定花掉多少额度。
按财报章节切成小片:
catl2025_p11_仅主要会计数据表.pdf              1 页   五、主要会计数据和财务指标
catl2025_p12_分季度与非经常性损益.pdf           1 页   六、分季度主要财务指标
catl2025_p11-13_主要会计数据与分季度.pdf        3 页  【对照实验用】故意多装两页
catl2025_p25_分行业分产品分地区.pdf             1 页   收入与成本整体情况
catl2025_p30_研发投入.pdf                     1 页   研发投入金额与占比 + 现金流
catl2025_p106_资产负债率.pdf                  1 页   债券章节的近两年财务指标
catl2025_p113_合并资产负债表.pdf               1 页   负债 / 权益 / 少数股东权益
catl2024_p116_合并资产负债表.pdf(2024 年报)   1 页   补齐 2023 年数据
切片用的是本地 pypdf——这只是把纸裁开,读懂纸上的字仍然是连接器在做。
五、第一步:用 recognition_text 看全貌
先让连接器把「主要会计数据和财务指标」那一页的文本层吐出来,确认这一页到底有哪些字段、指标叫什么名字。
返回的是一段拉平的文字,核心部分是这样的:
五、主要会计数据和财务指标
公司是否需追溯调整或重述以前年度会计数据
□是 ☑否
单位:千元
项目        2025年        2024年      本年比上年增减   2023年
营业收入    423,701,834   362,012,554  17.04%         400,917,045
归属于上市公司股东
的净利润     72,201,282    50,744,682   42.28%         44,121,248
...
加权平均净资产收益
率          24.91%        24.13%       0.78%          24.04%
...
资产总额    974,827,544   786,658,123  23.92%         717,168,041
这一页就够把九个核心指标的三年序列全部拿全。 而且它顺带解决了一个后面很关键的问题:我怎么知道该用哪个词去抽。 财报里同一个概念可能有多种写法(“资产总额"还是"资产总计”?),只有先读出来才能确定。
六、第二步:用 general_information_extration 定向拿数
6.1 核心财务指标(key 模式)
把要的字段名列成 key 数组丢进去:
{"path": "slices/catl2025_p11_仅主要会计数据表.pdf",
 "key": ["营业收入", "归属于上市公司股东的净利润", "资产总额", "加权平均净资产收益率"]}
返回(真实返回值,原文照录):
{"营业收入": ["423,701,834"],
 "归属于上市公司股东的净利润": ["72,201,282"],
 "资产总额": ["974,827,544", "786,658,123", "23.92%", "717,168,041"],
 "加权平均净资产收益率": ["24.91%", "24.13%", "0.78%", "24.04%"]}
注意「资产总额」和「加权平均 ROE」返回了四个值——因为年报那张表的列序就是 [2025年, 2024年, 本年比上年增减, 2023年],四个值一一对应。返回值的个数和顺序本身就是信息,这一点后面会变成一条重要经验。
6.2 分季度数据(table_header 模式)
分季度表的表头是季度,用 table_header 更自然:
{"path": "slices/catl2025_p12_分季度与非经常性损益.pdf",
 "table_header": ["第一季度", "第二季度", "第三季度", "第四季度"]}
返回 4 行 × 4 列,每一格都带 llm_confidence: 1 和 llm_confidence_level: "high":
| 行 | 第一季度 | 第二季度 | 第三季度 | 第四季度 |
|---|---|---|---|---|
| 营业收入 | 84,704,589 | 94,181,664 | 104,185,734 | 140,629,847 |
| 归母净利润 | 13,962,558 | 16,522,581 | 18,548,970 | 23,167,173 |
| 扣非净利润 | 11,829,172 | 15,368,296 | 16,421,757 | 20,888,640 |
| 经营活动现金流净额 | 32,868,257 | 25,818,809 | 21,973,364 | 52,559,552 |
但这里有个必须知道的事:table_header 模式不返回行标签。 四行数据给你了,但哪一行是营业收入、哪一行是现金流,工具没说。要么靠顺序推断,要么配合另外两个工具补齐。
6.3 收入结构与毛利率
同一页(第 25 页)用两个工具各抽一次,互相印证。
table_header 模式拿数(6 列表头):
| 维度 | 项目 | 营业收入(千元) | 营业成本(千元) | 毛利率 | 收入同比 | 毛利率变动 |
|---|---|---|---|---|---|---|
| 分产品 | 动力电池系统 | 316,506,369 | 241,064,397 | 23.84% | 25.08% | -0.10pct |
| 分产品 | 储能电池系统 | 62,439,820 | 45,763,689 | 26.71% | 8.99% | -0.13pct |
| 分产品 | 电池材料及回收 | 21,860,936 | 15,899,813 | 27.27% | -23.83% | +16.76pct |
| 分地区 | 境内 | 294,060,576 | 223,497,885 | 24.00% | 16.84% | +1.75pct |
| 分地区 | 境外 | 129,641,258 | 88,885,412 | 31.44% | 17.50% | +1.99pct |
| 分业务 | 电气机械及器材制造业 | 417,723,738 | 307,077,698 | 26.49% | 17.17% | +1.80pct |
doc_to_markdown 模式拿结构,它把 colspan 分组行和维度名一起保留了下来:
<table border="1" ><tr>
<td>项目</td><td>营业收入</td><td>营业成本</td><td>毛利率</td>...
</tr><tr>
<td colspan="7">分产品</td>
</tr><tr>
<td>动力电池系统</td><td>316,506,369</td><td>241,064,397</td><td>23.84%</td>...
两份结果对起来,维度名补齐了,数值也互相验证了。 这就是"三个工具配合"的实际用法。
6.4 财务报表:研发投入与资产负债表
第 30 页研发投入(doc_to_markdown 返回的原始 HTML 片段):
<table border="1" ><tr>
<td>项目</td><td>2025 年</td><td>2024 年</td><td>2023 年</td>
</tr><tr>
<td>研发投入金额(千元)</td><td>22,146,581</td><td>18,606,756</td><td>18,356,108</td>
</tr><tr>
<td>研发投入占营业收入比例</td><td>5.23%</td><td>5.14%</td><td>4.58%</td>
</tr></table>
注意返回里连"☐适用 ☑不适用"这种勾选项和页码注释 <!-- 30 --> 都在——页码注释意味着你知道这段内容来自第几页,这是可追溯性的下限保障。
合并资产负债表(第 113 页):
{"负债合计": ["603,801,220", "513,201,949"],
 "所有者权益合计": ["371,026,324", "273,456,174"],
 "少数股东权益": ["33,918,577", "26,526,141"],
 "资产总计": [""]}
最后一个 "资产总计": [""] 不是 bug,是信息。 年报里这一栏的用词是「资产总额」,不是「资产总计」,一字之差就抽不到。返回空字符串时要当成"没抽到",绝不能当成 0。
七、把抽出来的数,框回年报原页
抽取结果必须能回到纸面上核对。下面这五张图:左边是年报原页,红框是按文本检索定位到的那个数值;右边是连接器实际返回的字段与取值。
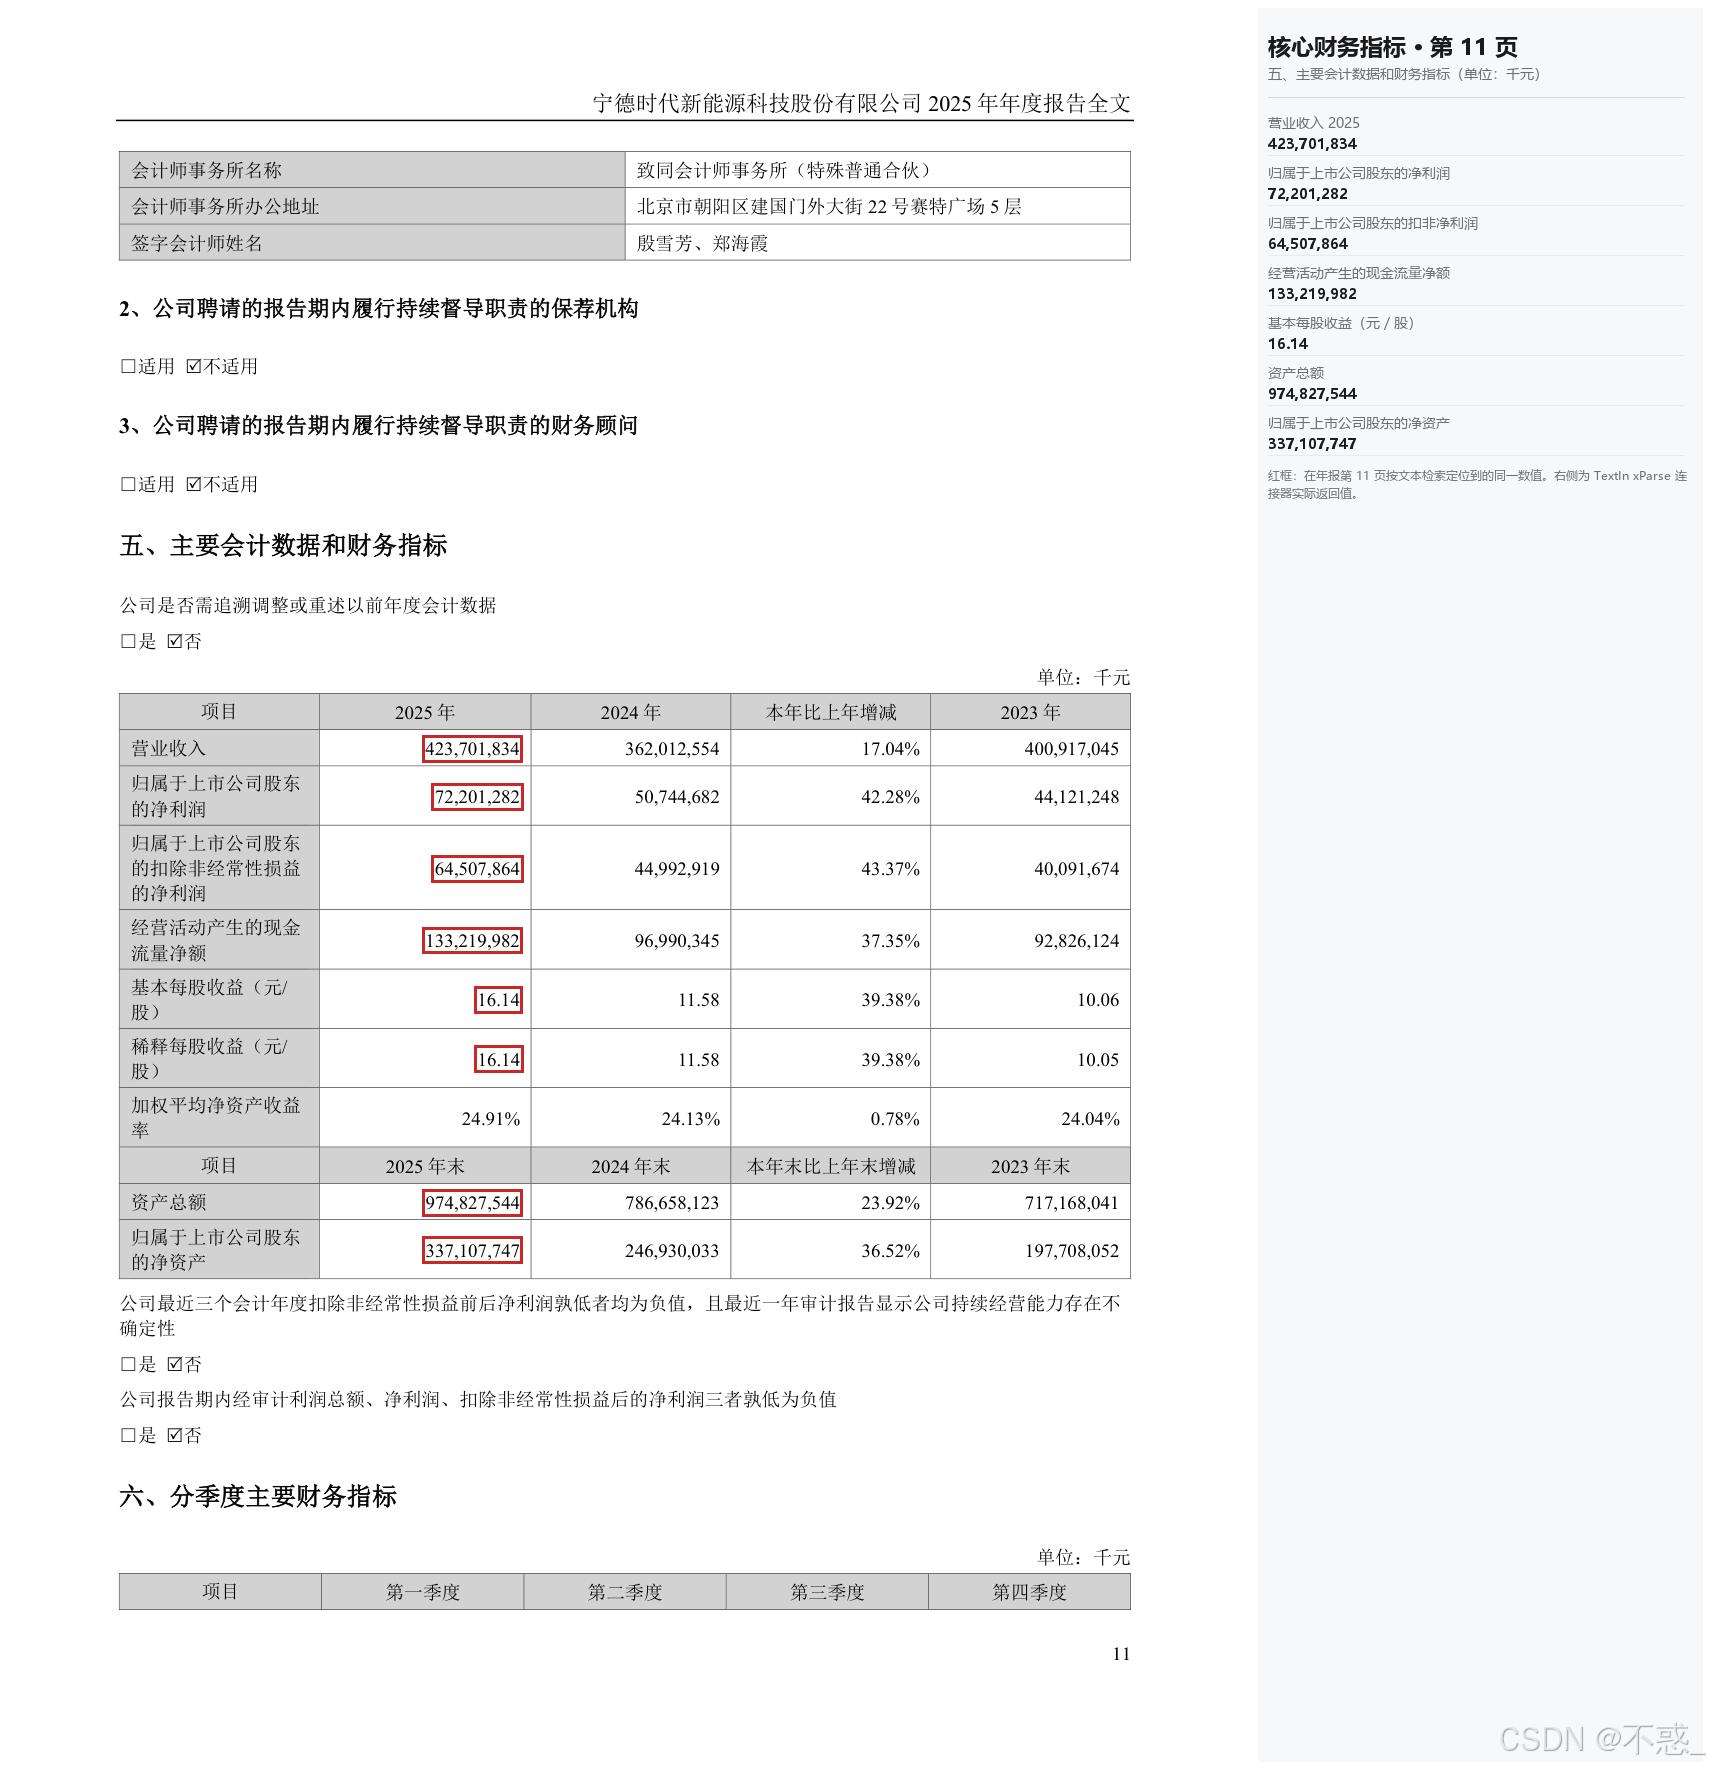
图 5:第 11 页「五、主要会计数据和财务指标」。 营业收入 423,701,834、归母净利润 72,201,282、扣非净利润 64,507,864、经营现金流 133,219,982、基本每股收益 16.14、资产总额 974,827,544、归母净资产 337,107,747——七个字段全部框在对应的单元格里,右侧面板就是连接器的返回值。
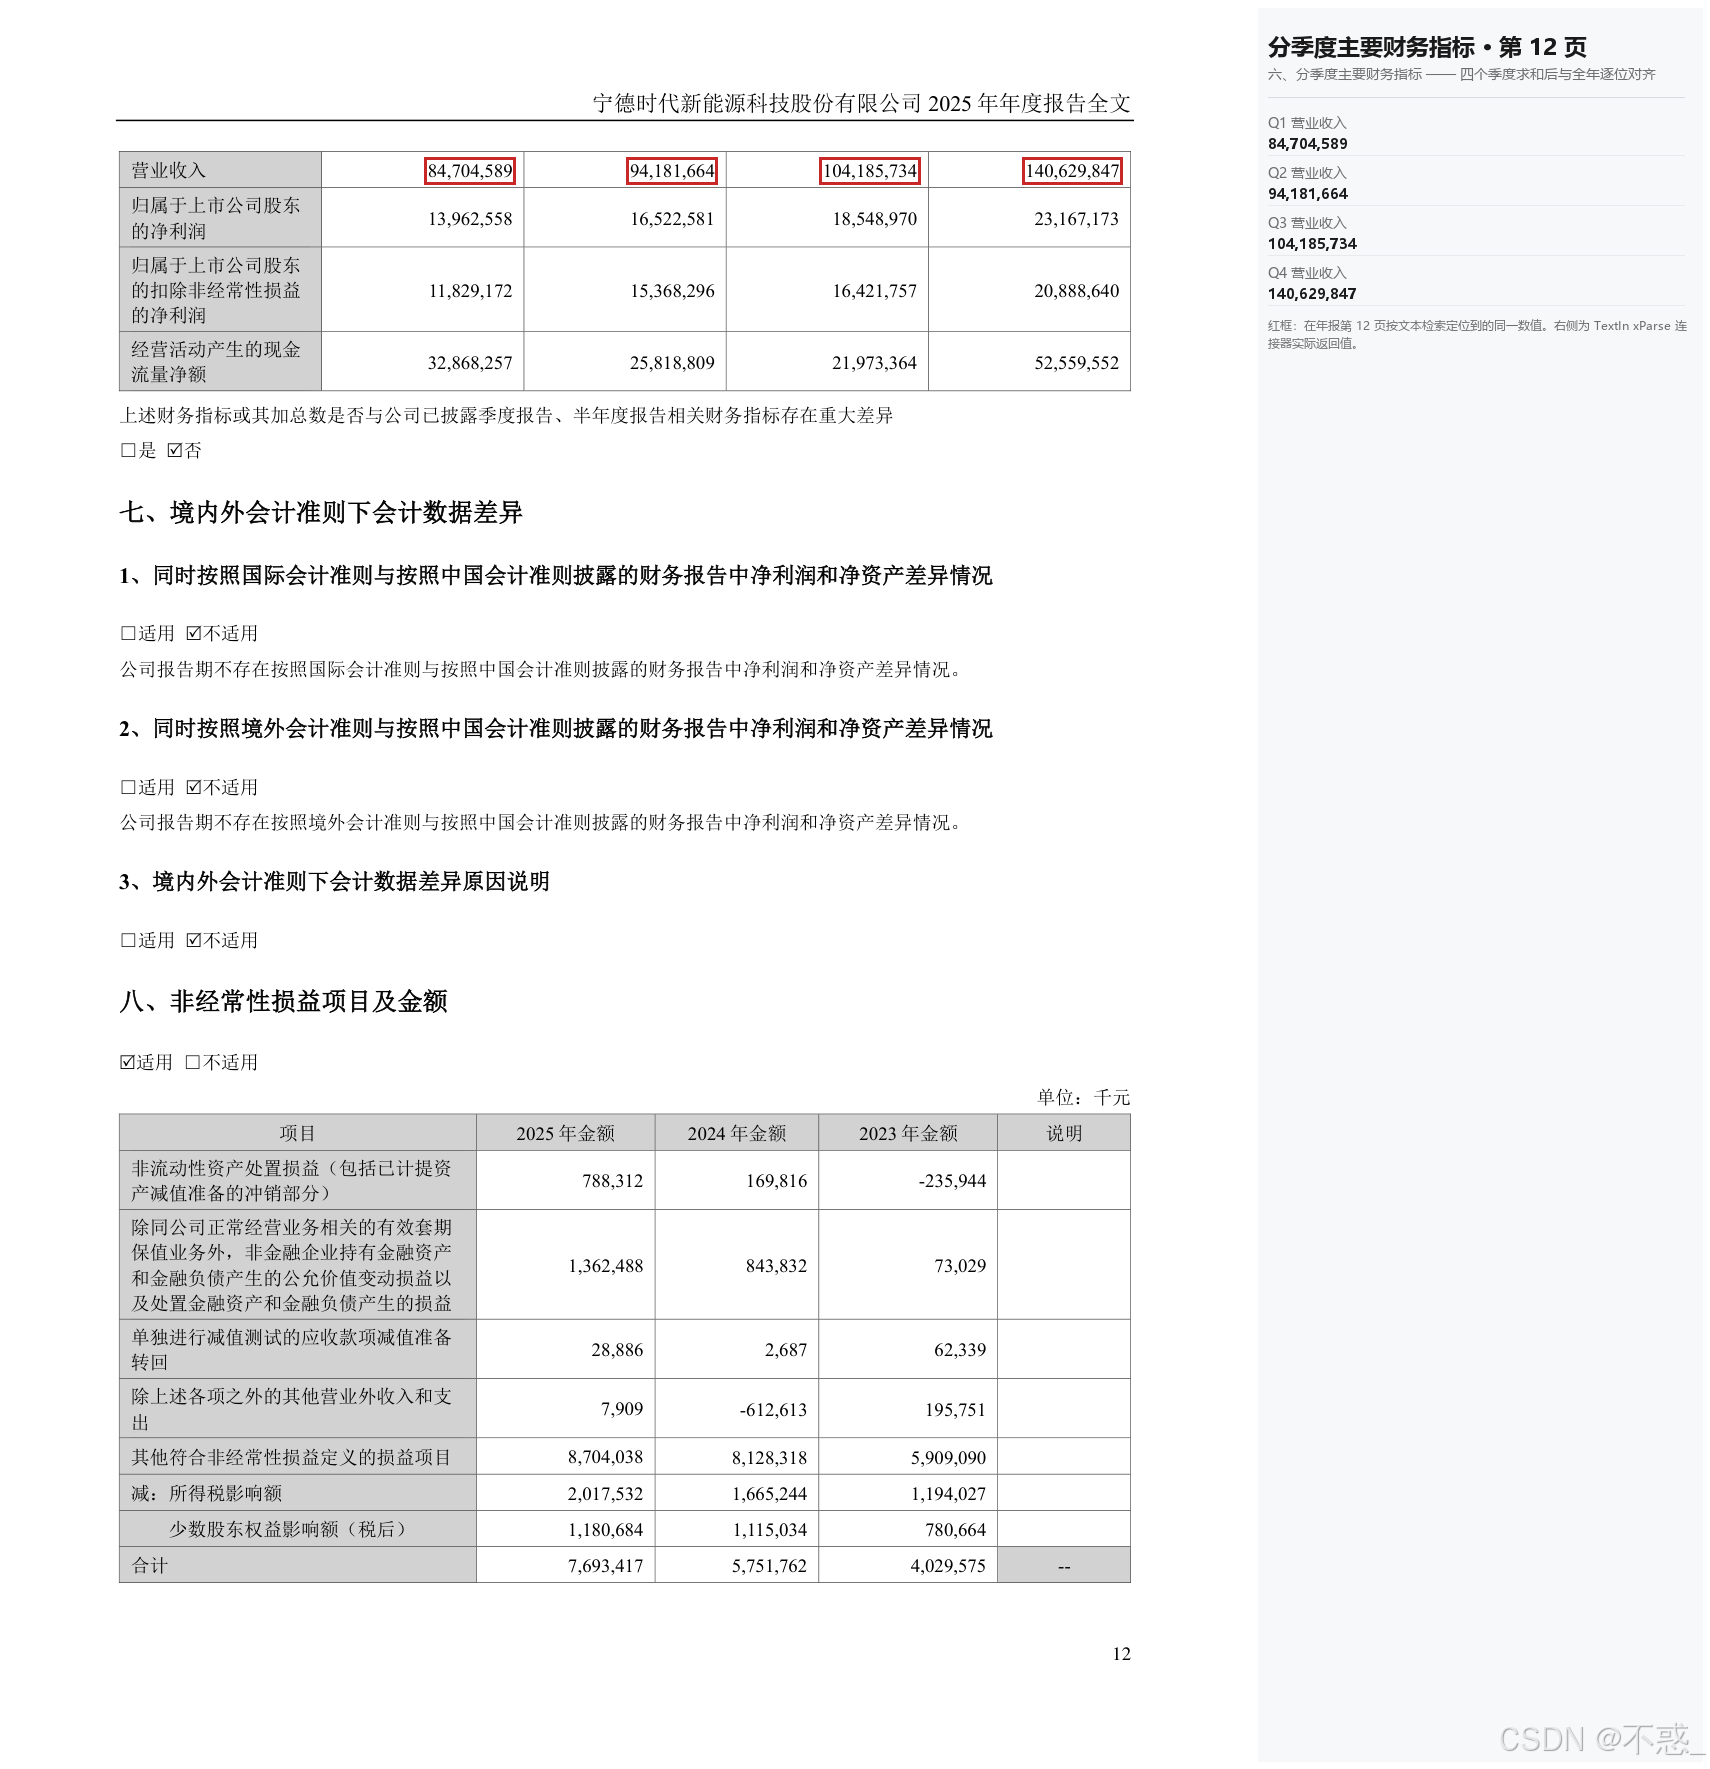
图 6:第 12 页「六、分季度主要财务指标」。 四个季度的营业收入被逐一框出。
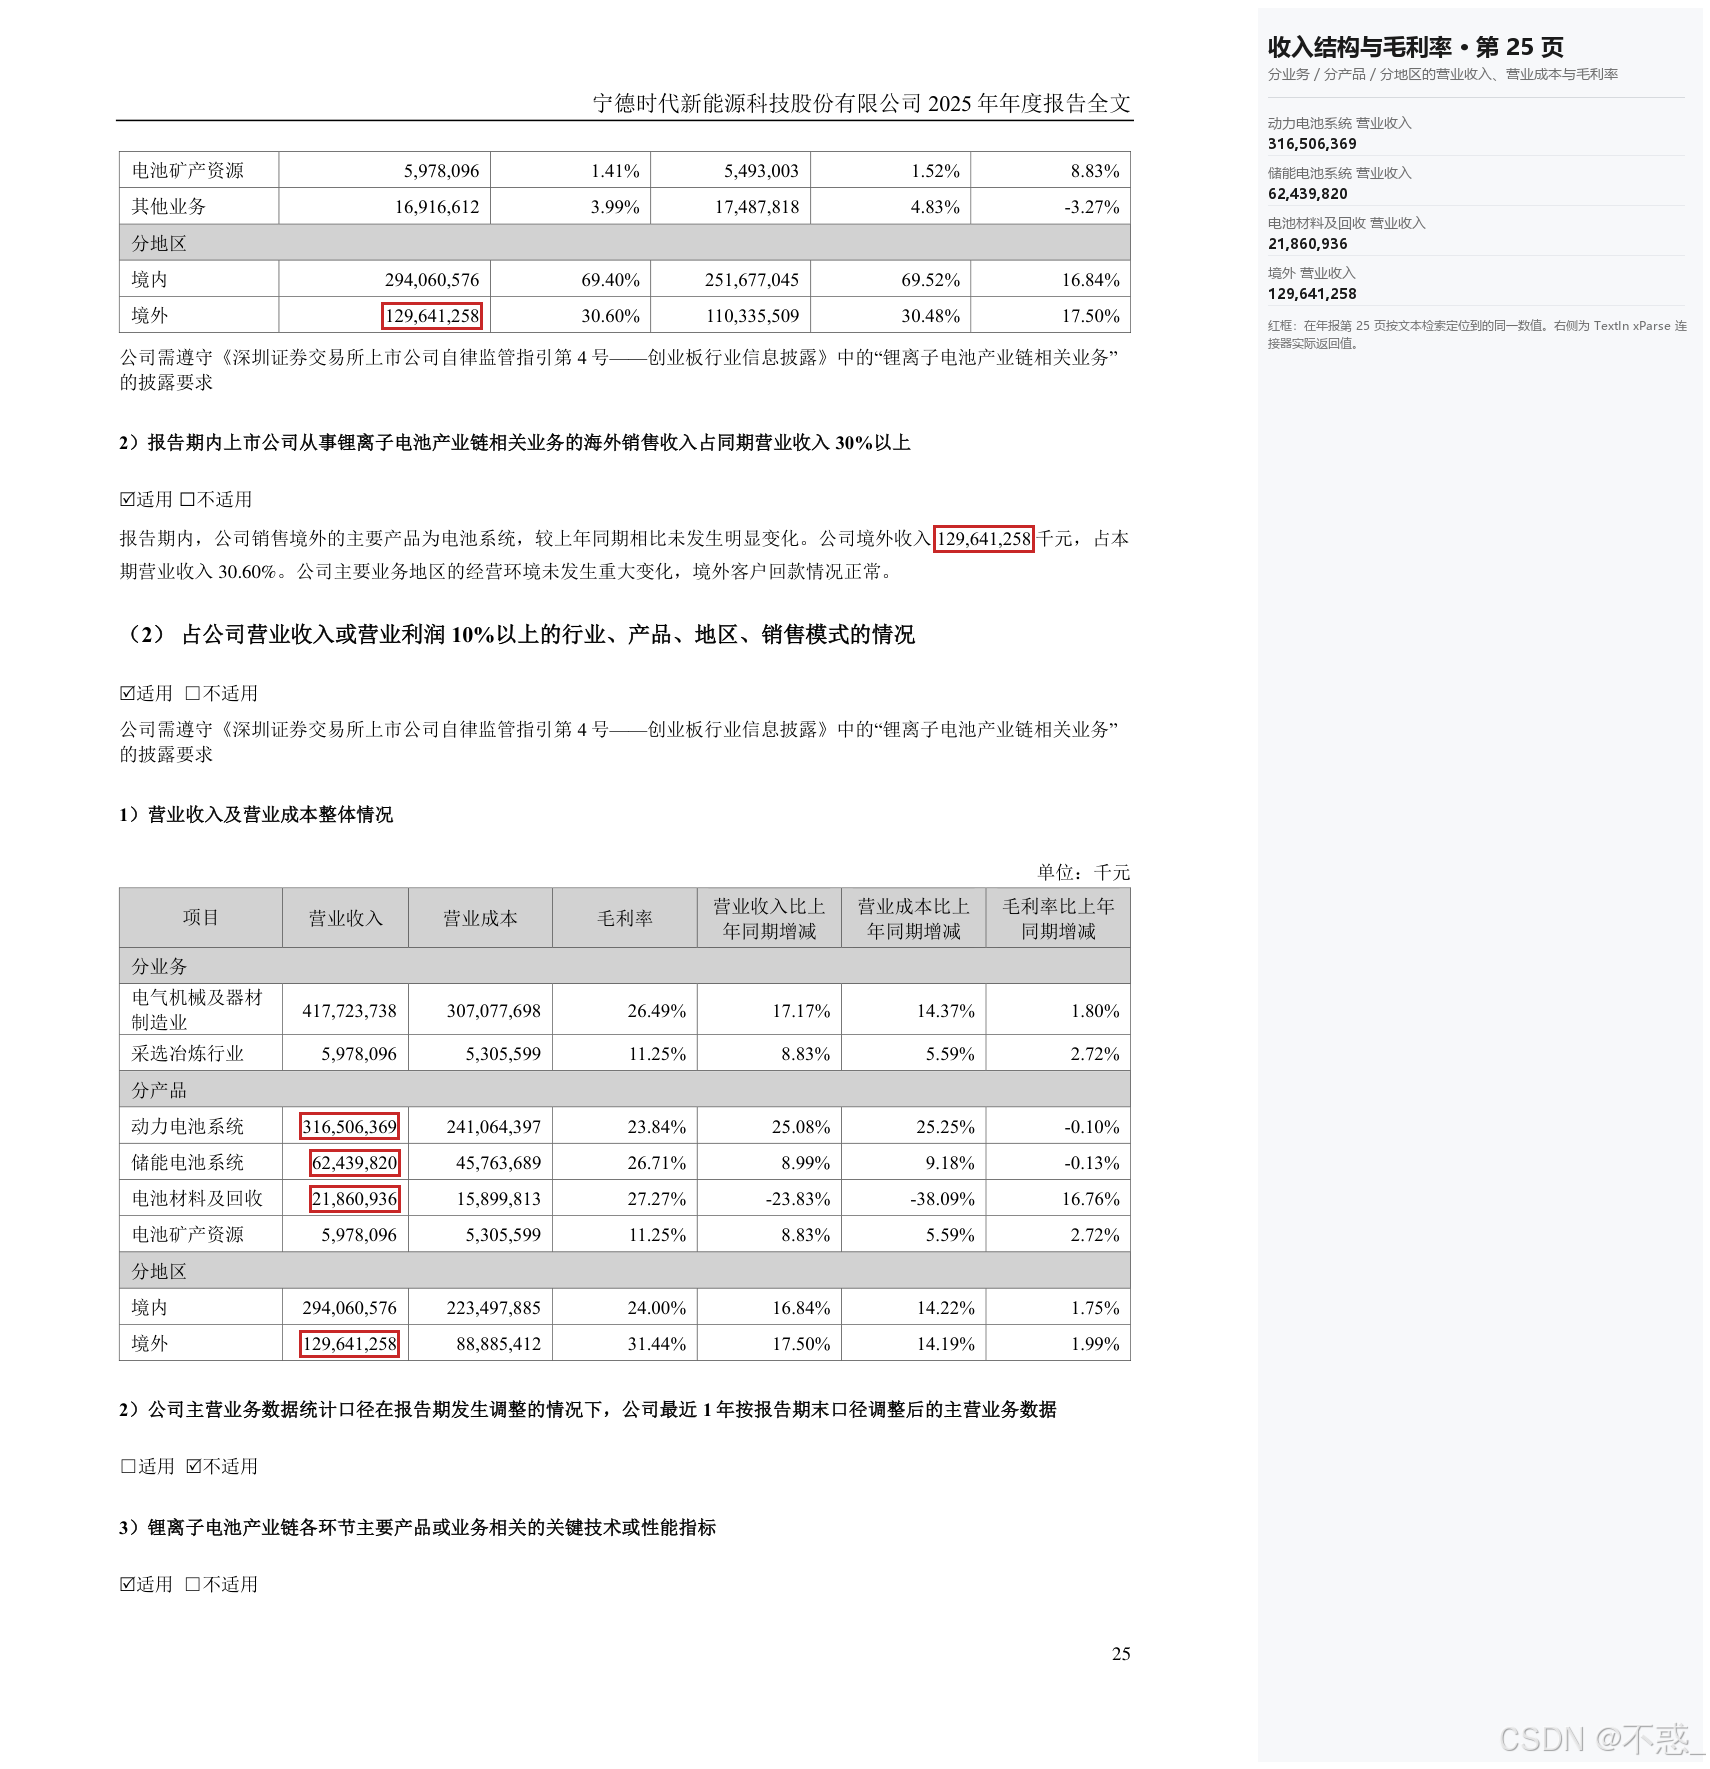
图 7:第 25 页收入结构表。 动力电池系统、储能电池系统、电池材料及回收、境外收入四个数值的位置。
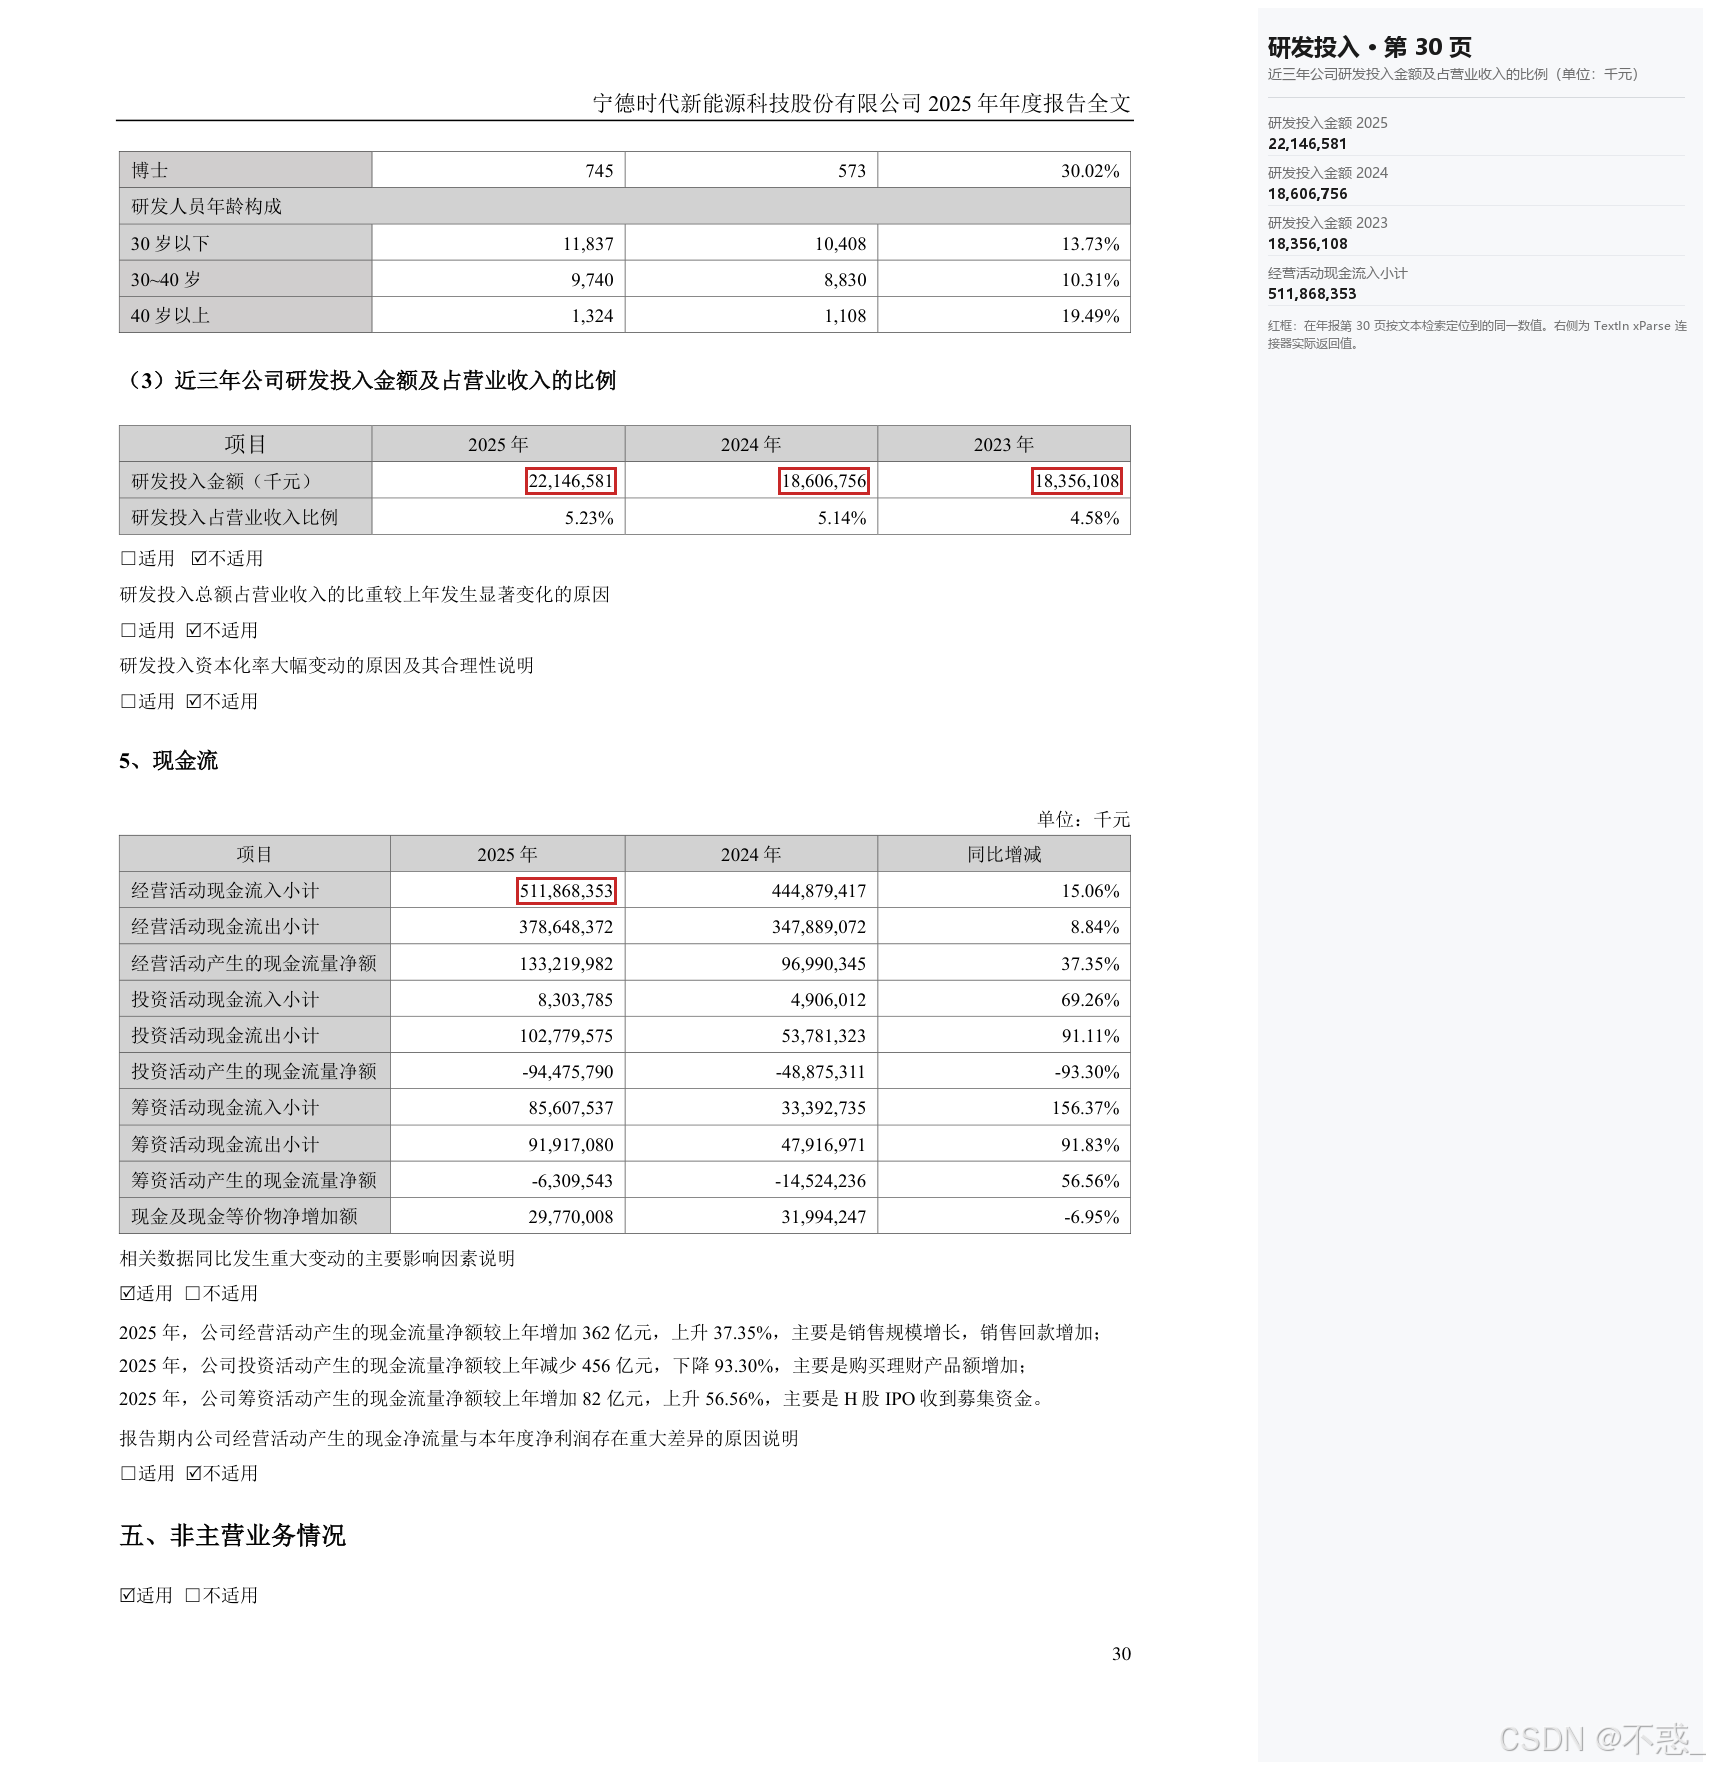
图 8:第 30 页研发投入表。 三年研发投入金额与经营活动现金流入小计。
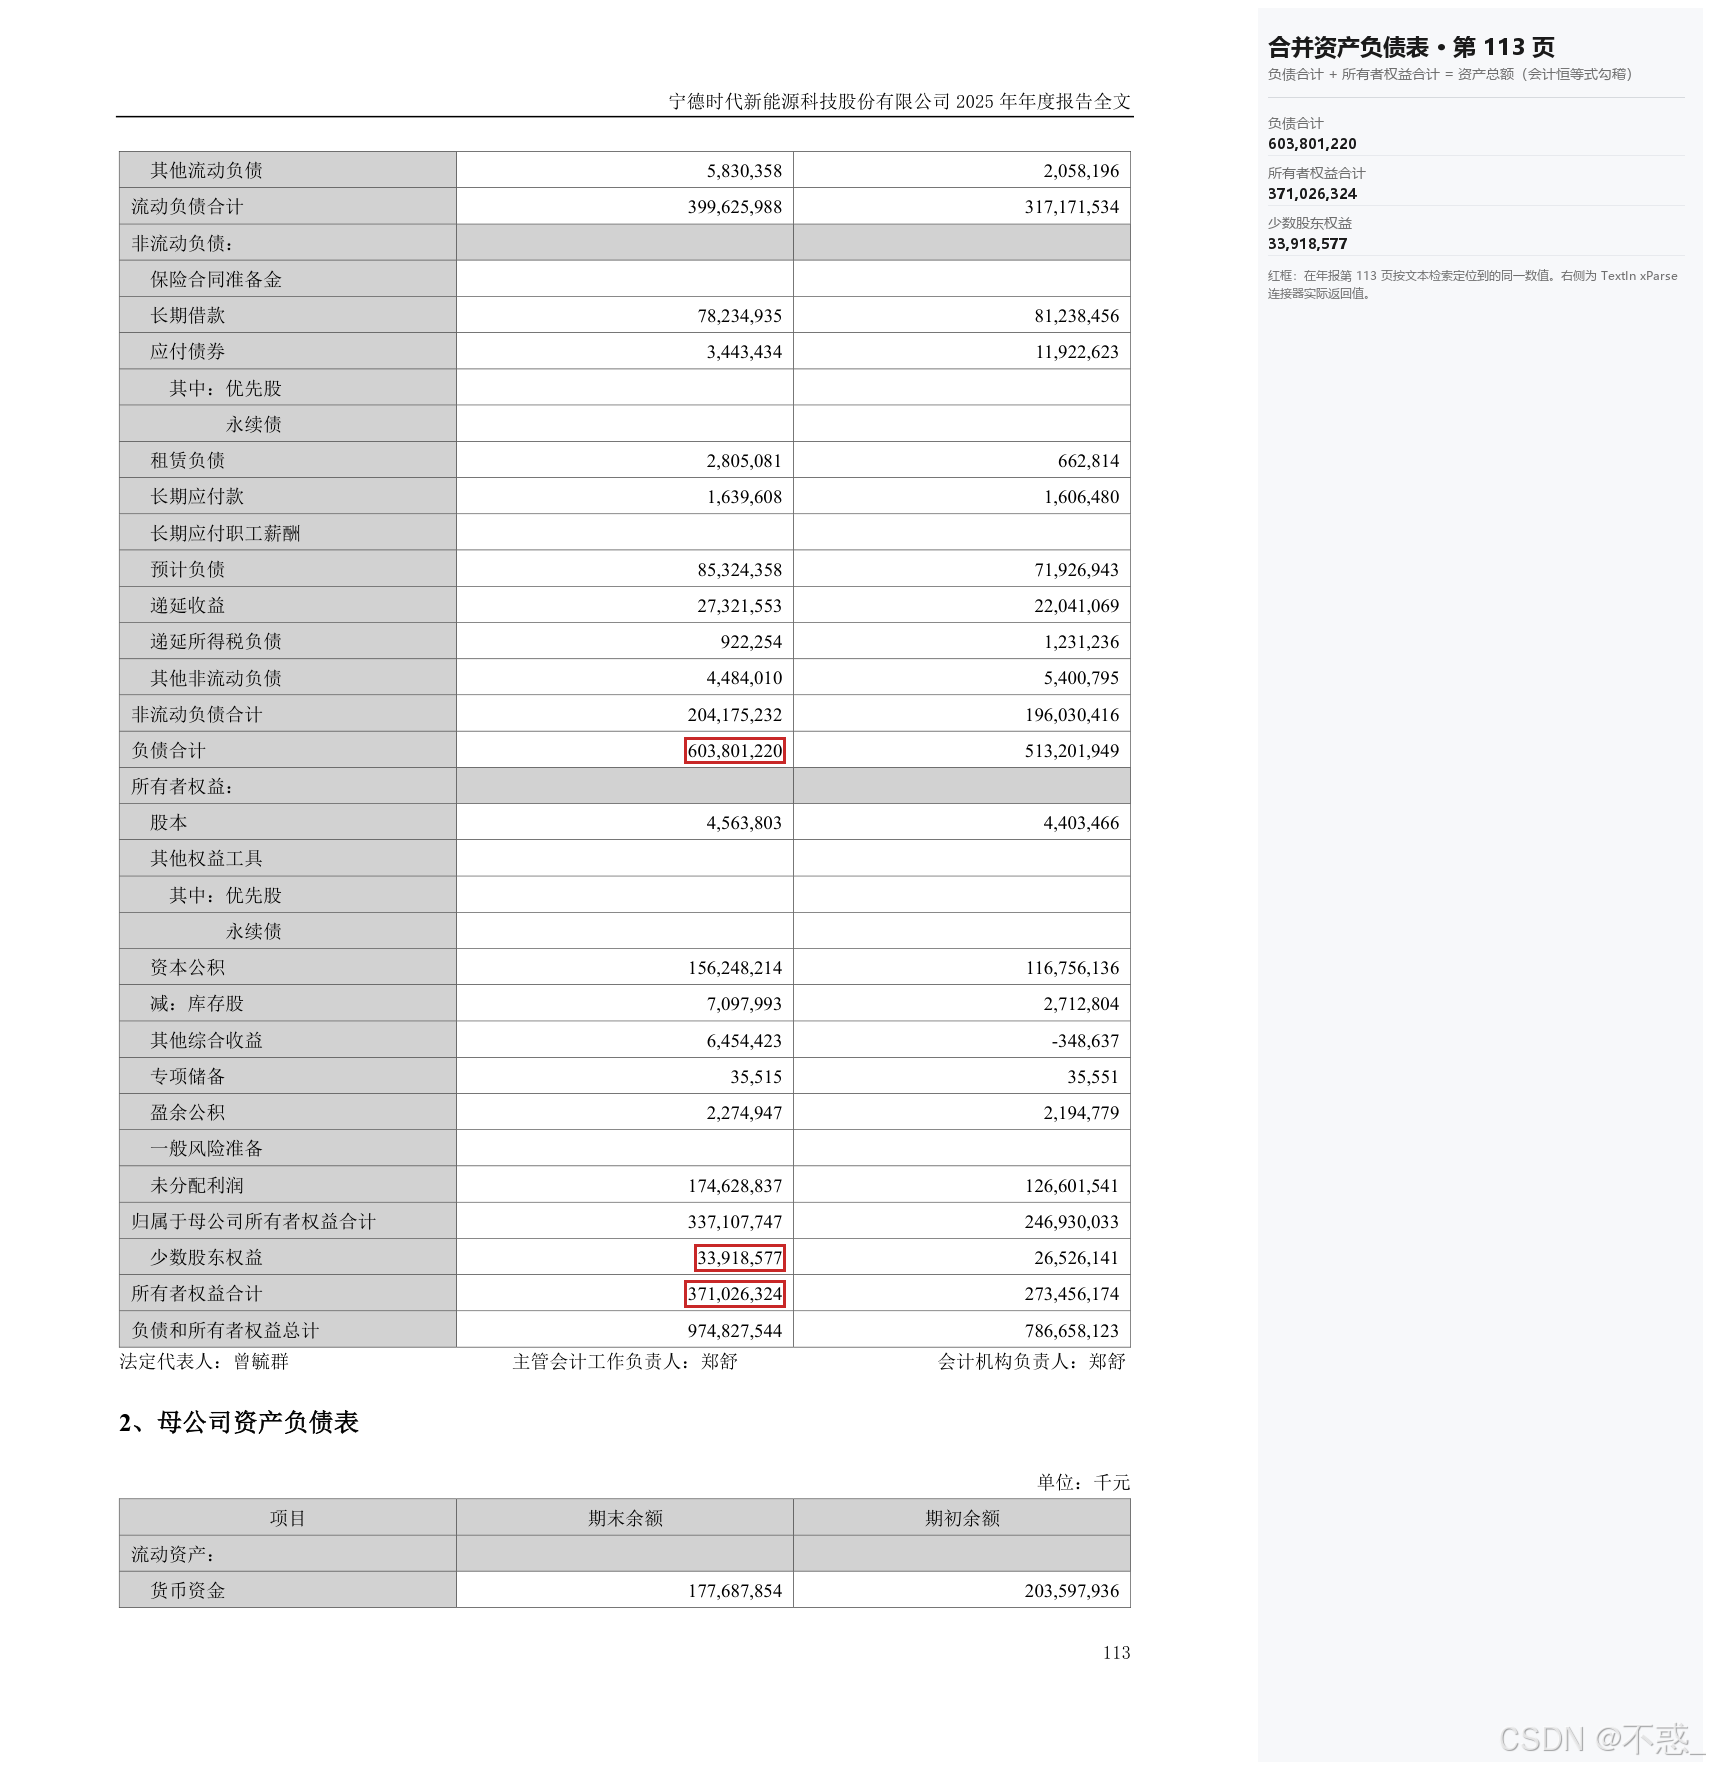
图 9:第 113 页合并资产负债表。 负债合计、所有者权益合计、少数股东权益——这三个数是第九节那条纠错的关键。
八、真正让数据可信的:22 条勾稽校验
工具把数抽出来,但抽取不等于可信。真正让这份数据立住的,是 22 条勾稽校验(全部通过)。
8.1 季度求和 = 全年
| 校验项 | 计算 | 全年披露值 | 结论 |
|---|---|---|---|
| 营业收入 | Q1+Q2+Q3+Q4 = 423,701,834 | 423,701,834 | 精确相等 |
| 归母净利润 | 13,962,558+16,522,581+18,548,970+23,167,173 = 72,201,282 | 72,201,282 | 精确相等 |
| 经营活动现金流净额 | 32,868,257+25,818,809+21,973,364+52,559,552 = 133,219,982 | 133,219,982 | 精确相等 |
| 扣非净利润 | 11,829,172+15,368,296+16,421,757+20,888,640 = 64,507,865 | 64,507,864 | 差 1 千元(披露本身就有舍入) |
三个精确相等、一个差 1 千元。 这个结果说明两件事:季度表和年度表来自同一套账;那 1 千元的差是年报自身披露口径的舍入,不是抽错了。
8.2 会计恒等式
| 校验项 | 计算 | 资产总额 | 结论 |
|---|---|---|---|
| 2025 年 | 负债 603,801,220 + 权益 371,026,324 = 974,827,544 | 974,827,544 | 精确相等 |
| 2024 年 | 513,201,949 + 273,456,174 = 786,658,123 | 786,658,123 | 精确相等 |
| 2023 年 | 497,284,890 + 219,883,151 = 717,168,041 | 717,168,041 | 精确相等 |
8.3 权益归属分解
| 校验项 | 计算 | 所有者权益合计 | 结论 |
|---|---|---|---|
| 2025 年 | 归母 337,107,747 + 少数股东 33,918,577 = 371,026,324 | 371,026,324 | 精确相等 |
| 2024 年 | 246,930,033 + 26,526,141 = 273,456,174 | 273,456,174 | 精确相等 |
| 2023 年 | 197,708,052 + 22,175,098 = 219,883,150 | 219,883,151 | 差 1 千元(舍入) |
8.4 跨年报一致性
2023 年的资产负债表数据在哪?2025 年报只披露本年与上年两年。于是从 2024 年报里抽 2023 年——两份不同年报对同一年(2024)的披露值必须一致:
| 指标 | 2024 年报(第 116 页) | 2025 年报(第 113 页) | 结论 |
|---|---|---|---|
| 负债合计 | 513,201,949 | 513,201,949 | 完全一致 |
| 所有者权益合计 | 273,456,174 | 273,456,174 | 完全一致 |
| 少数股东权益 | 26,526,141 | 26,526,141 | 完全一致 |
8.5 跨通道比对
我还用另一种完全不同的技术路径(手写脚本直调 REST 接口)跑了一遍。两条路径抽出来的九个核心指标,三年数值全部一致。
| 指标 | 连接器 | 脚本通道 | 结论 |
|---|---|---|---|
| 营业收入 | 4.23702e+08 | 4.23702e+08 | 三年全部一致 |
| 归母净利润 | 7.22013e+07 | 7.22013e+07 | 三年全部一致 |
| 扣非净利润 | 6.45079e+07 | 6.45079e+07 | 三年全部一致 |
| 经营活动现金流净额 | 1.3322e+08 | 1.3322e+08 | 三年全部一致 |
| 基本每股收益 | 16.14 | 16.14 | 三年全部一致 |
| 稀释每股收益 | 16.14 | 16.14 | 三年全部一致 |
| 加权平均净资产收益率 | 24.91 | 24.91 | 三年全部一致 |
| 资产总额 | 9.74828e+08 | 9.74828e+08 | 三年全部一致 |
| 归母净资产 | 3.37108e+08 | 3.37108e+08 | 三年全部一致 |
九、勾稽抓出了一个真错:资产负债率口径
这是这一轮最值得说的发现。
我第一版算出来的资产负债率是 2023 年 72.43%、2024 年 68.61%、2025 年 65.42%——用的是 1 − 归母净资产 ÷ 资产总额。
这一轮用连接器抽第 106 页(债券章节的"近两年主要会计数据和财务指标"),返回的是:
资产负债率 61.94% 65.24% -3.30%
61.94% 和 65.42% 差了 3.48 个百分点。 我没有直接采信任何一边,而是把合并资产负债表拉出来,用会计恒等式验:
- 2025 年:负债 603,801,220 ÷ 资产总额 974,827,544 = 61.94% ✅ 与年报原文一致
- 2024 年:负债 513,201,949 ÷ 资产总额 786,658,123 = 65.24% ✅ 与年报原文一致(上年末值)
第一版的算法漏了少数股东权益。 1 − 归母净资产 ÷ 资产总额 得到的是"归母净资产占资产的比重之补数",只有在没有少数股东权益时才等于资产负债率。宁德时代少数股东权益 2025 年是 339.19 亿元,占比不小,所以差了 3.5 个点。
修正后的三年趋势:
| 年份 | 修正后资产负债率 | 第一版(错误) | 偏差 |
|---|---|---|---|
| 2023 | 69.34% | 72.43% | -3.09pct |
| 2024 | 65.24% | 68.61% | -3.37pct |
| 2025 | 61.94% | 65.42% | -3.48pct |
趋势方向(持续下降)没错,但绝对水平错了 3 个多百分点。 一个"看起来合理"的比率,如果不做恒等式校验,就这么混进结论里了。
这就是勾稽校验的价值:它不是让结果更漂亮,而是让错误无处藏身。
十、三个必须知道的对照实验
为了把"连接器怎么用才对"说清楚,我刻意做了三组失败用例。它们不计入通过率,但比通过的部分更有信息量。
实验一:同一组 key,页范围不同,结果差很多
| 输入 11-13 页(含分季度表) | 输入 11 页(仅主要会计数据表) | |
|---|---|---|
| 资产总额 | [974,827,544, 84,704,589, 94,181,664, 104,185,734, 140,629,847] | [974,827,544, 786,658,123, 23.92%, 717,168,041] |
| 加权平均 ROE | [24.91%, 24.13%, 0.78%] | [24.91%, 24.13%, 0.78%, 24.04%] |
宽范围那次的后四位其实是分季度营业收入——被一并召回并串到了「资产总额」这个键上。ROE 那次则是第三个位置拿到了"同比增减"列(0.78%),而不是 2023 年的 24.04%。
收敛到单页之后,返回值个数和列序完全对上,与年报逐位一致。
结论:抽取务必按语义分页;拿到数组先看长度和类型,别直接下标取值。
实验二:key 必须与文档用词逐字一致
| 失败做法 | 正确做法 | |
|---|---|---|
| 输入 | 合并资产负债表 + key 资产总计 | 同一份文档 + key 资产总额 |
| 返回 | ""(空字符串) | 974,827,544 |
一字之差,一个都给不出来。 而返回空字符串这件事本身很危险——如果代码写成 float(x or 0),就会得到一个静默的 0。正确姿势:先用 recognition_text 把页读出来确认用词,再写 key;空字符串一律按"没抽到"处理并报警。
实验三:整本 232 页一次喂进去
同一份年报全本,三次真实调用全部不理想:
| 调用 | 结果 |
|---|---|
| key「加权平均净资产收益率」 | 返回空字符串 |
| key「致同会计师事务所」 | 只返回「(特殊普通合伙)」,前半截丢了 |
| key「基本每股收益」 | 55.5 秒后返回 40003 余额不足 |
而紧随整本报错之后的单页调用(p30 研发投入)仍然成功返回三年数据——说明账号还有余额,是整本那一次把额度吃掉了。
三个问题:抽不稳、返回值可能被截断、一次性吃掉大量额度。长文档必须切片——既省钱也更准。
十一、产出物
11.1 交互式研读看板
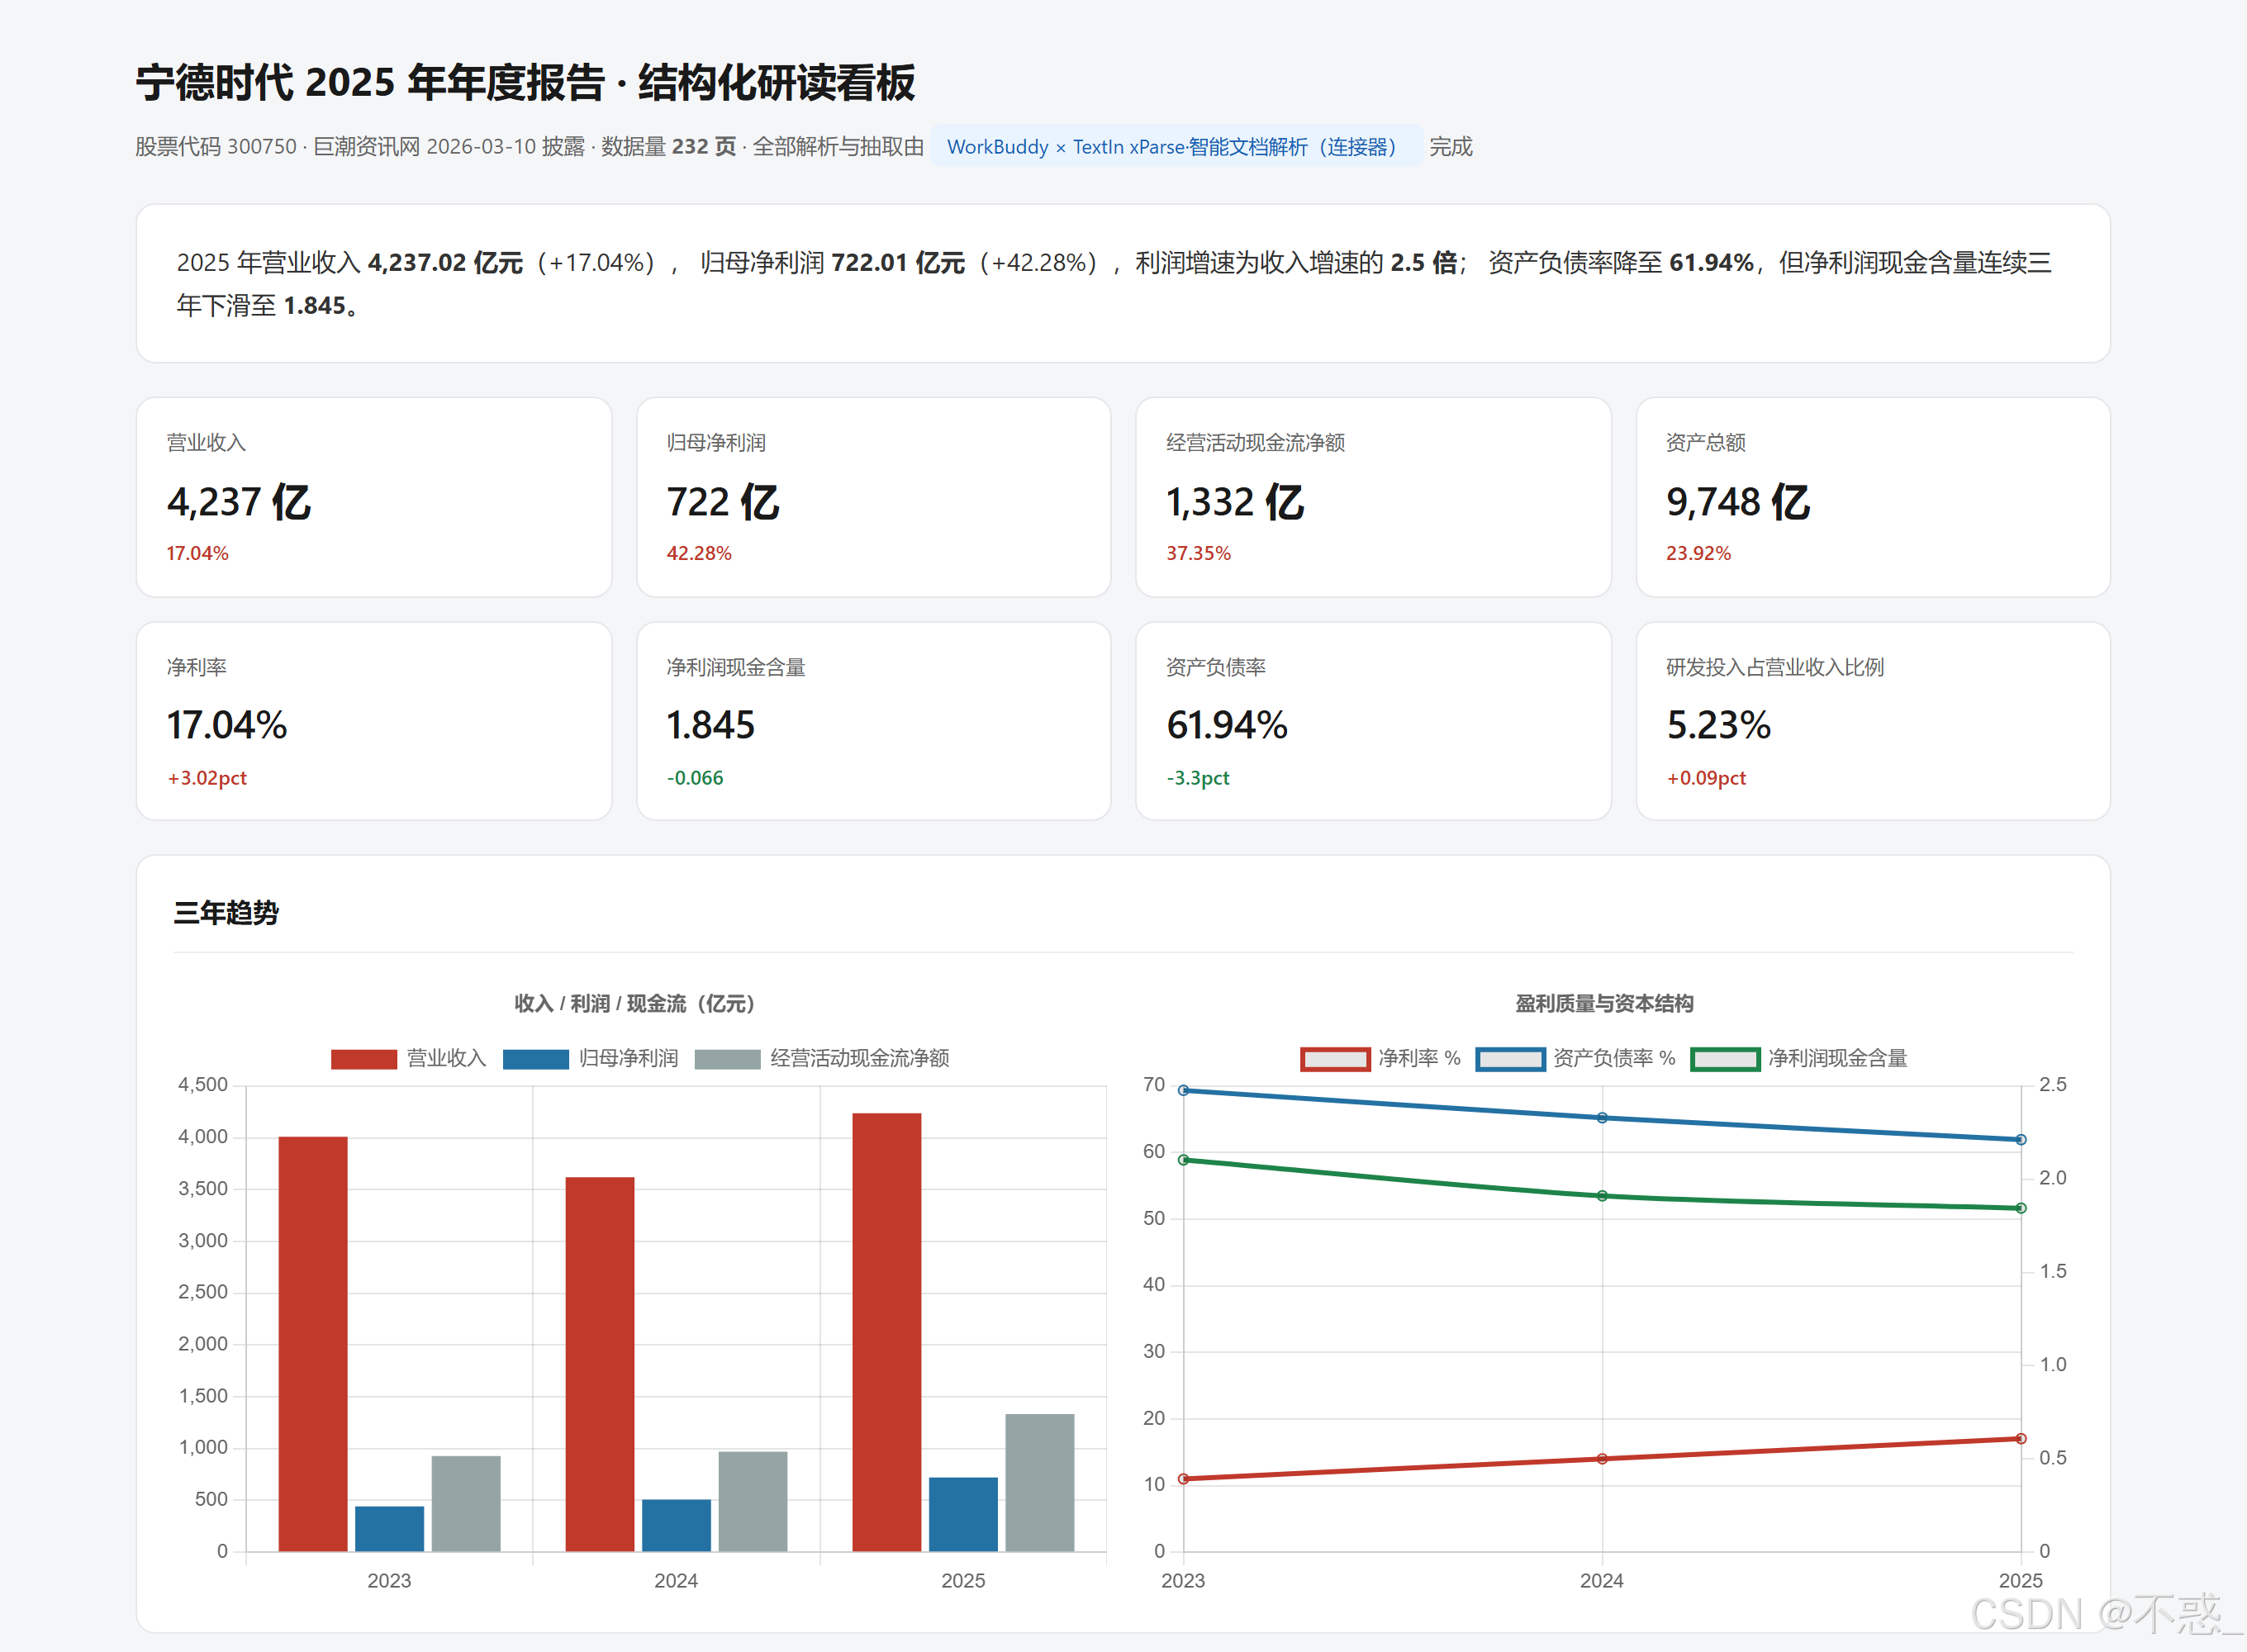
图 10:看板首屏。 顶部一句话结论,下面 8 张指标卡(含同比与上年对照),再下面是三年柱状对比与盈利质量/资本结构双轴趋势。配色遵循国内习惯——增长用红、下降用绿。
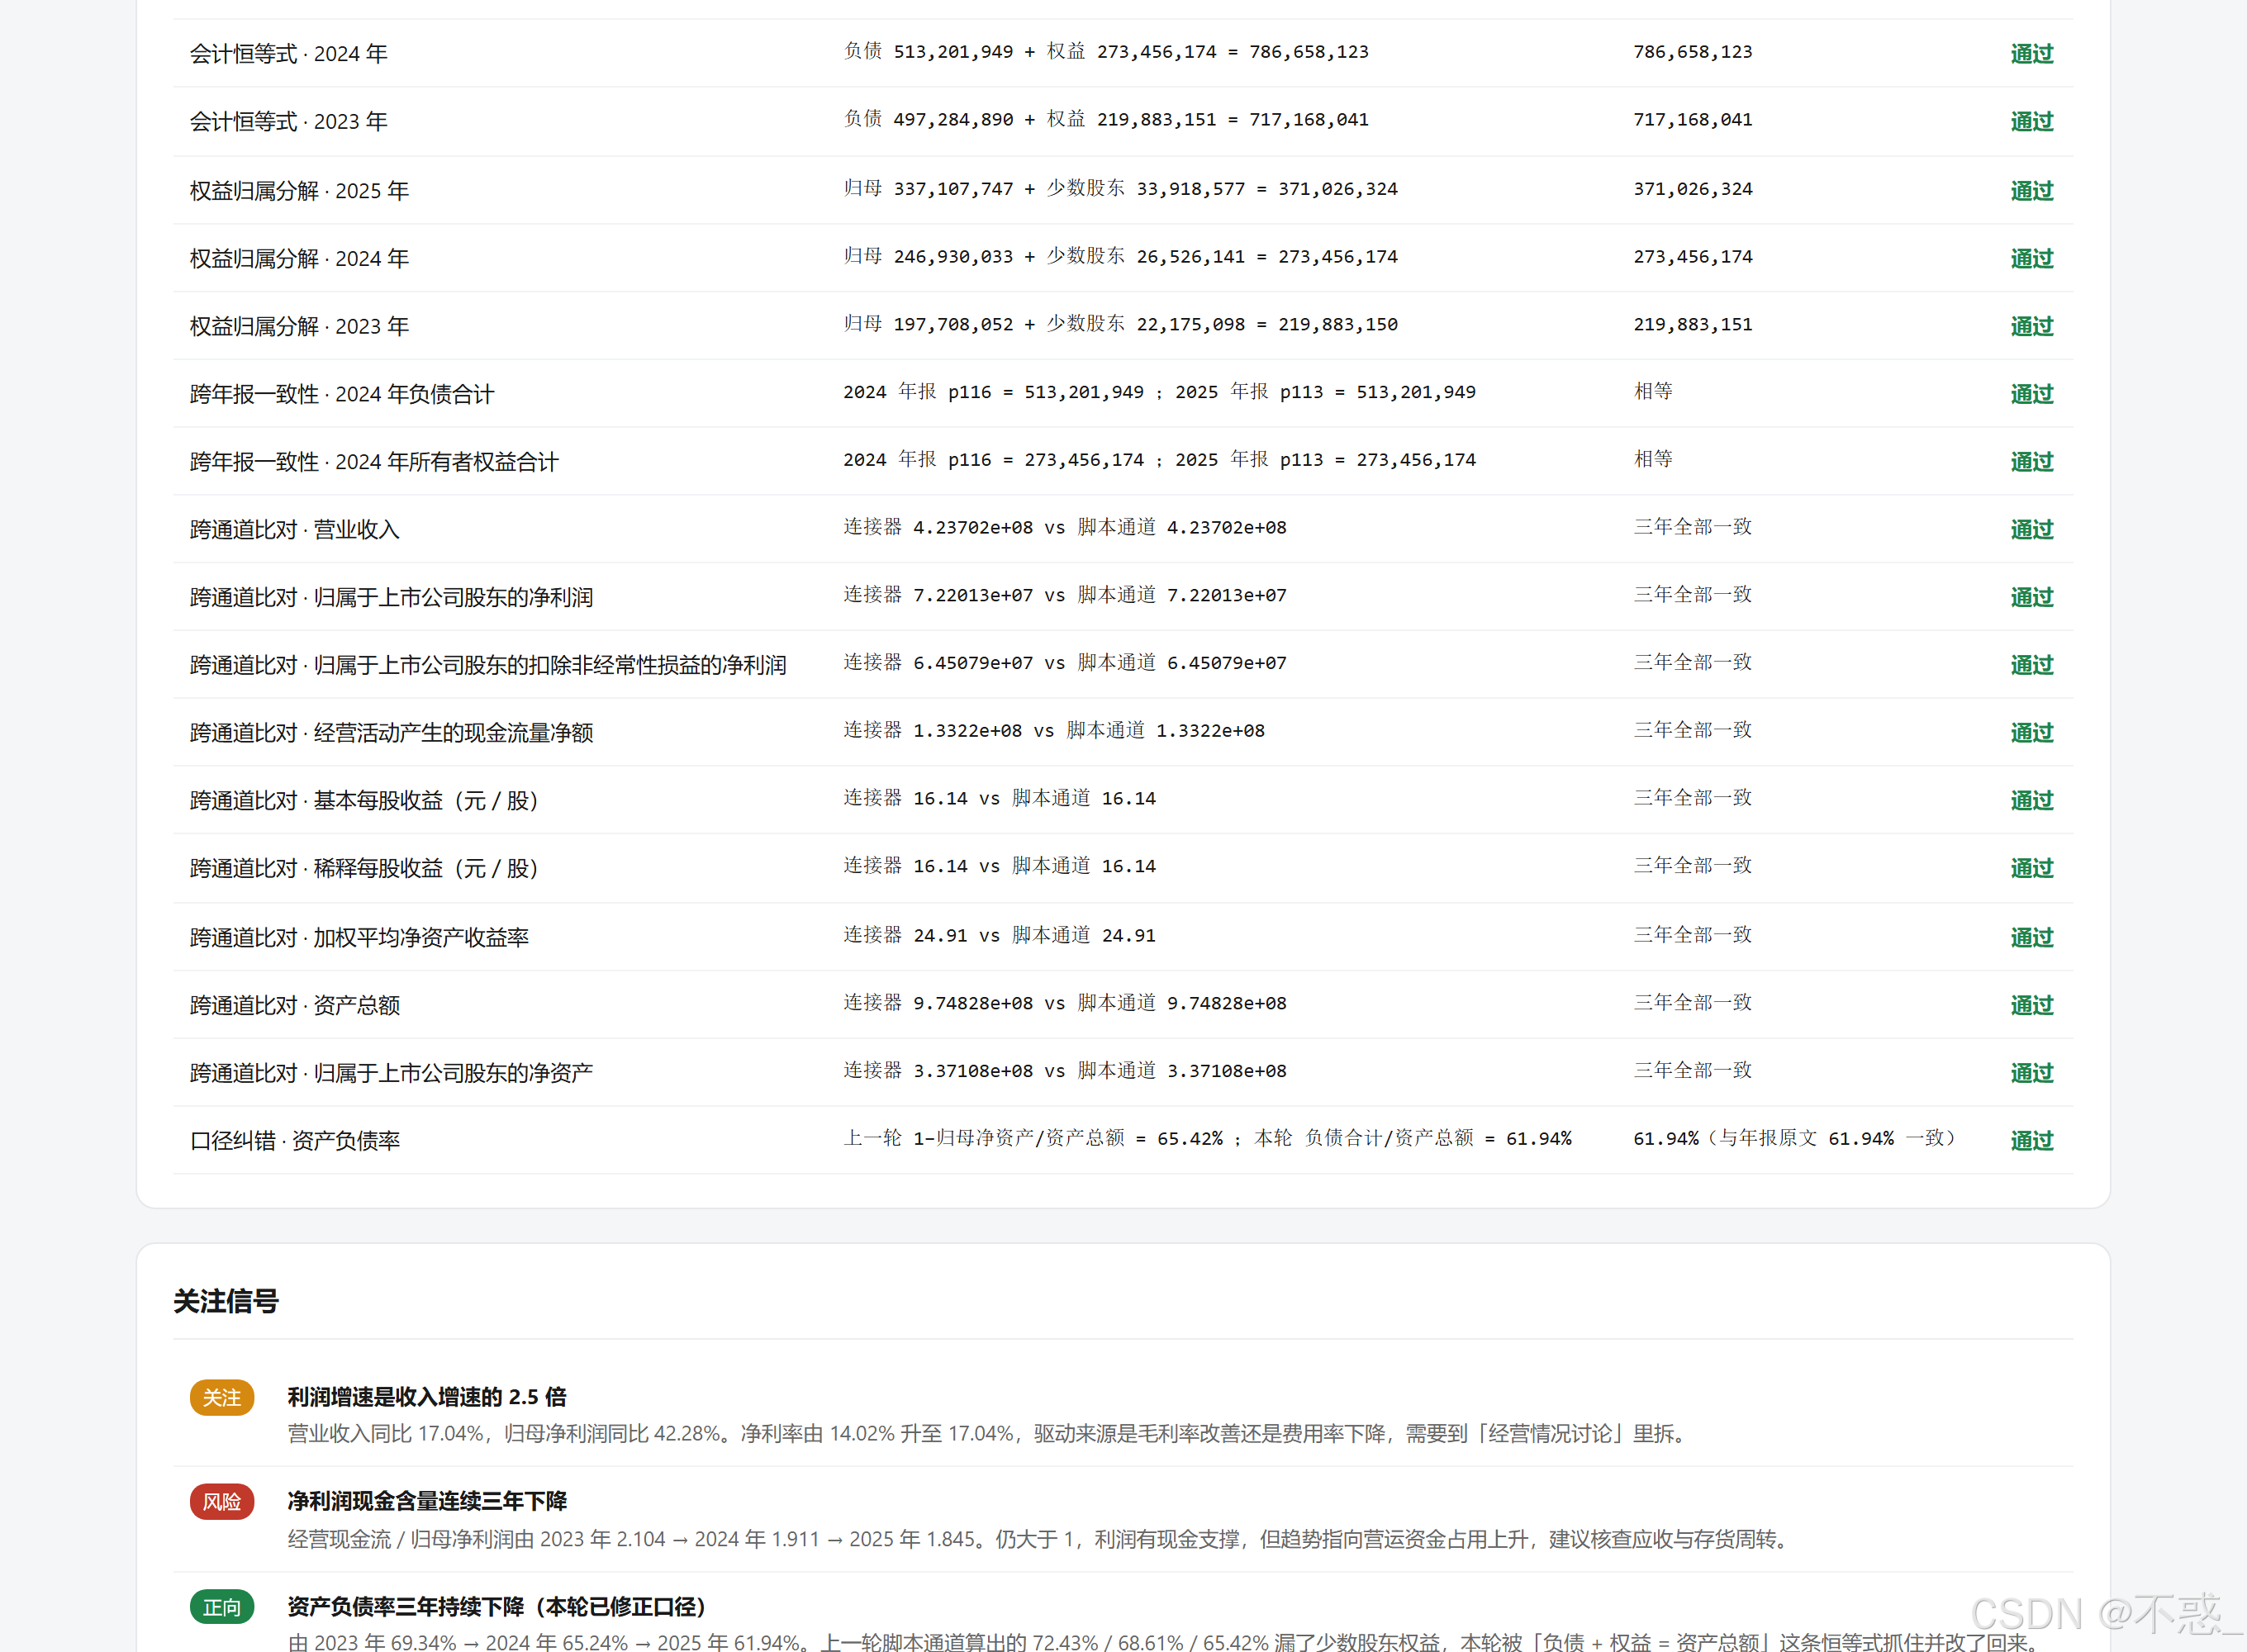
图 11:勾稽校验区,22 条逐条列出计算式、期望值与结论。最后一行「口径纠错 · 资产负债率」就是第九节那个发现的落点。
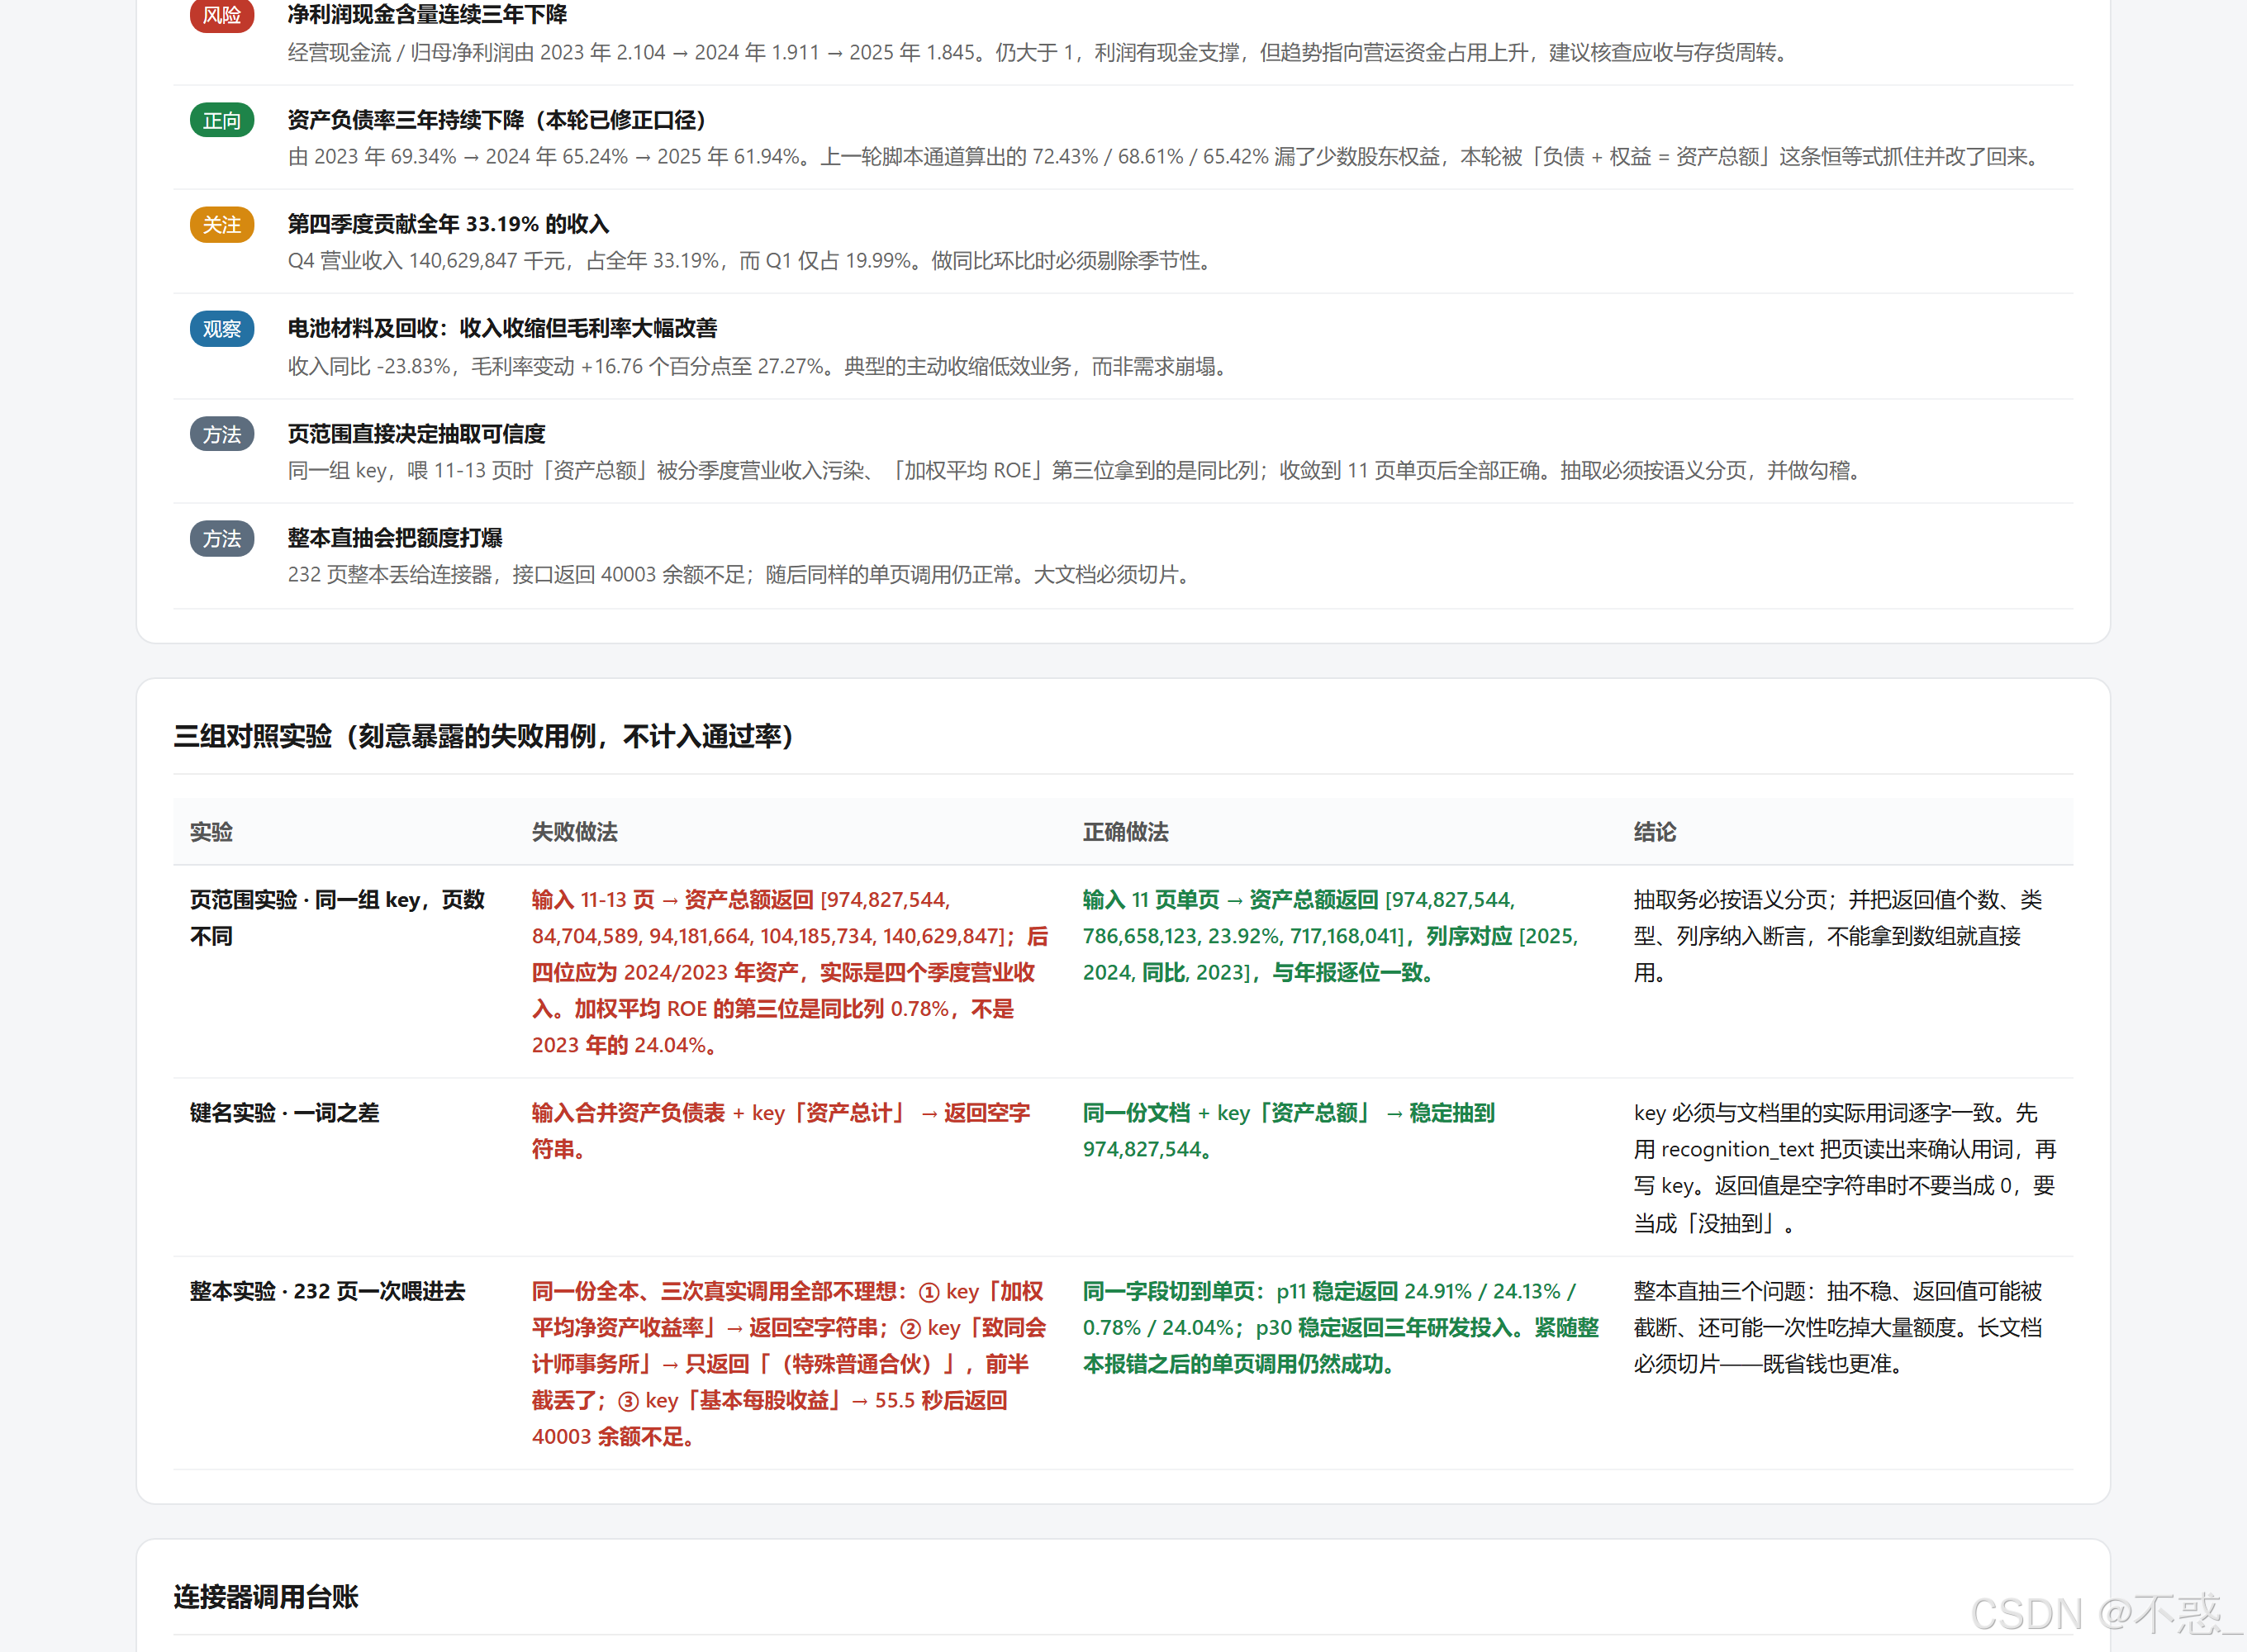
图 12: 上半部分是 7 条关注信号(含 2 条方法类信号);下半部分是三组对照实验的失败做法 / 正确做法 / 结论对照。
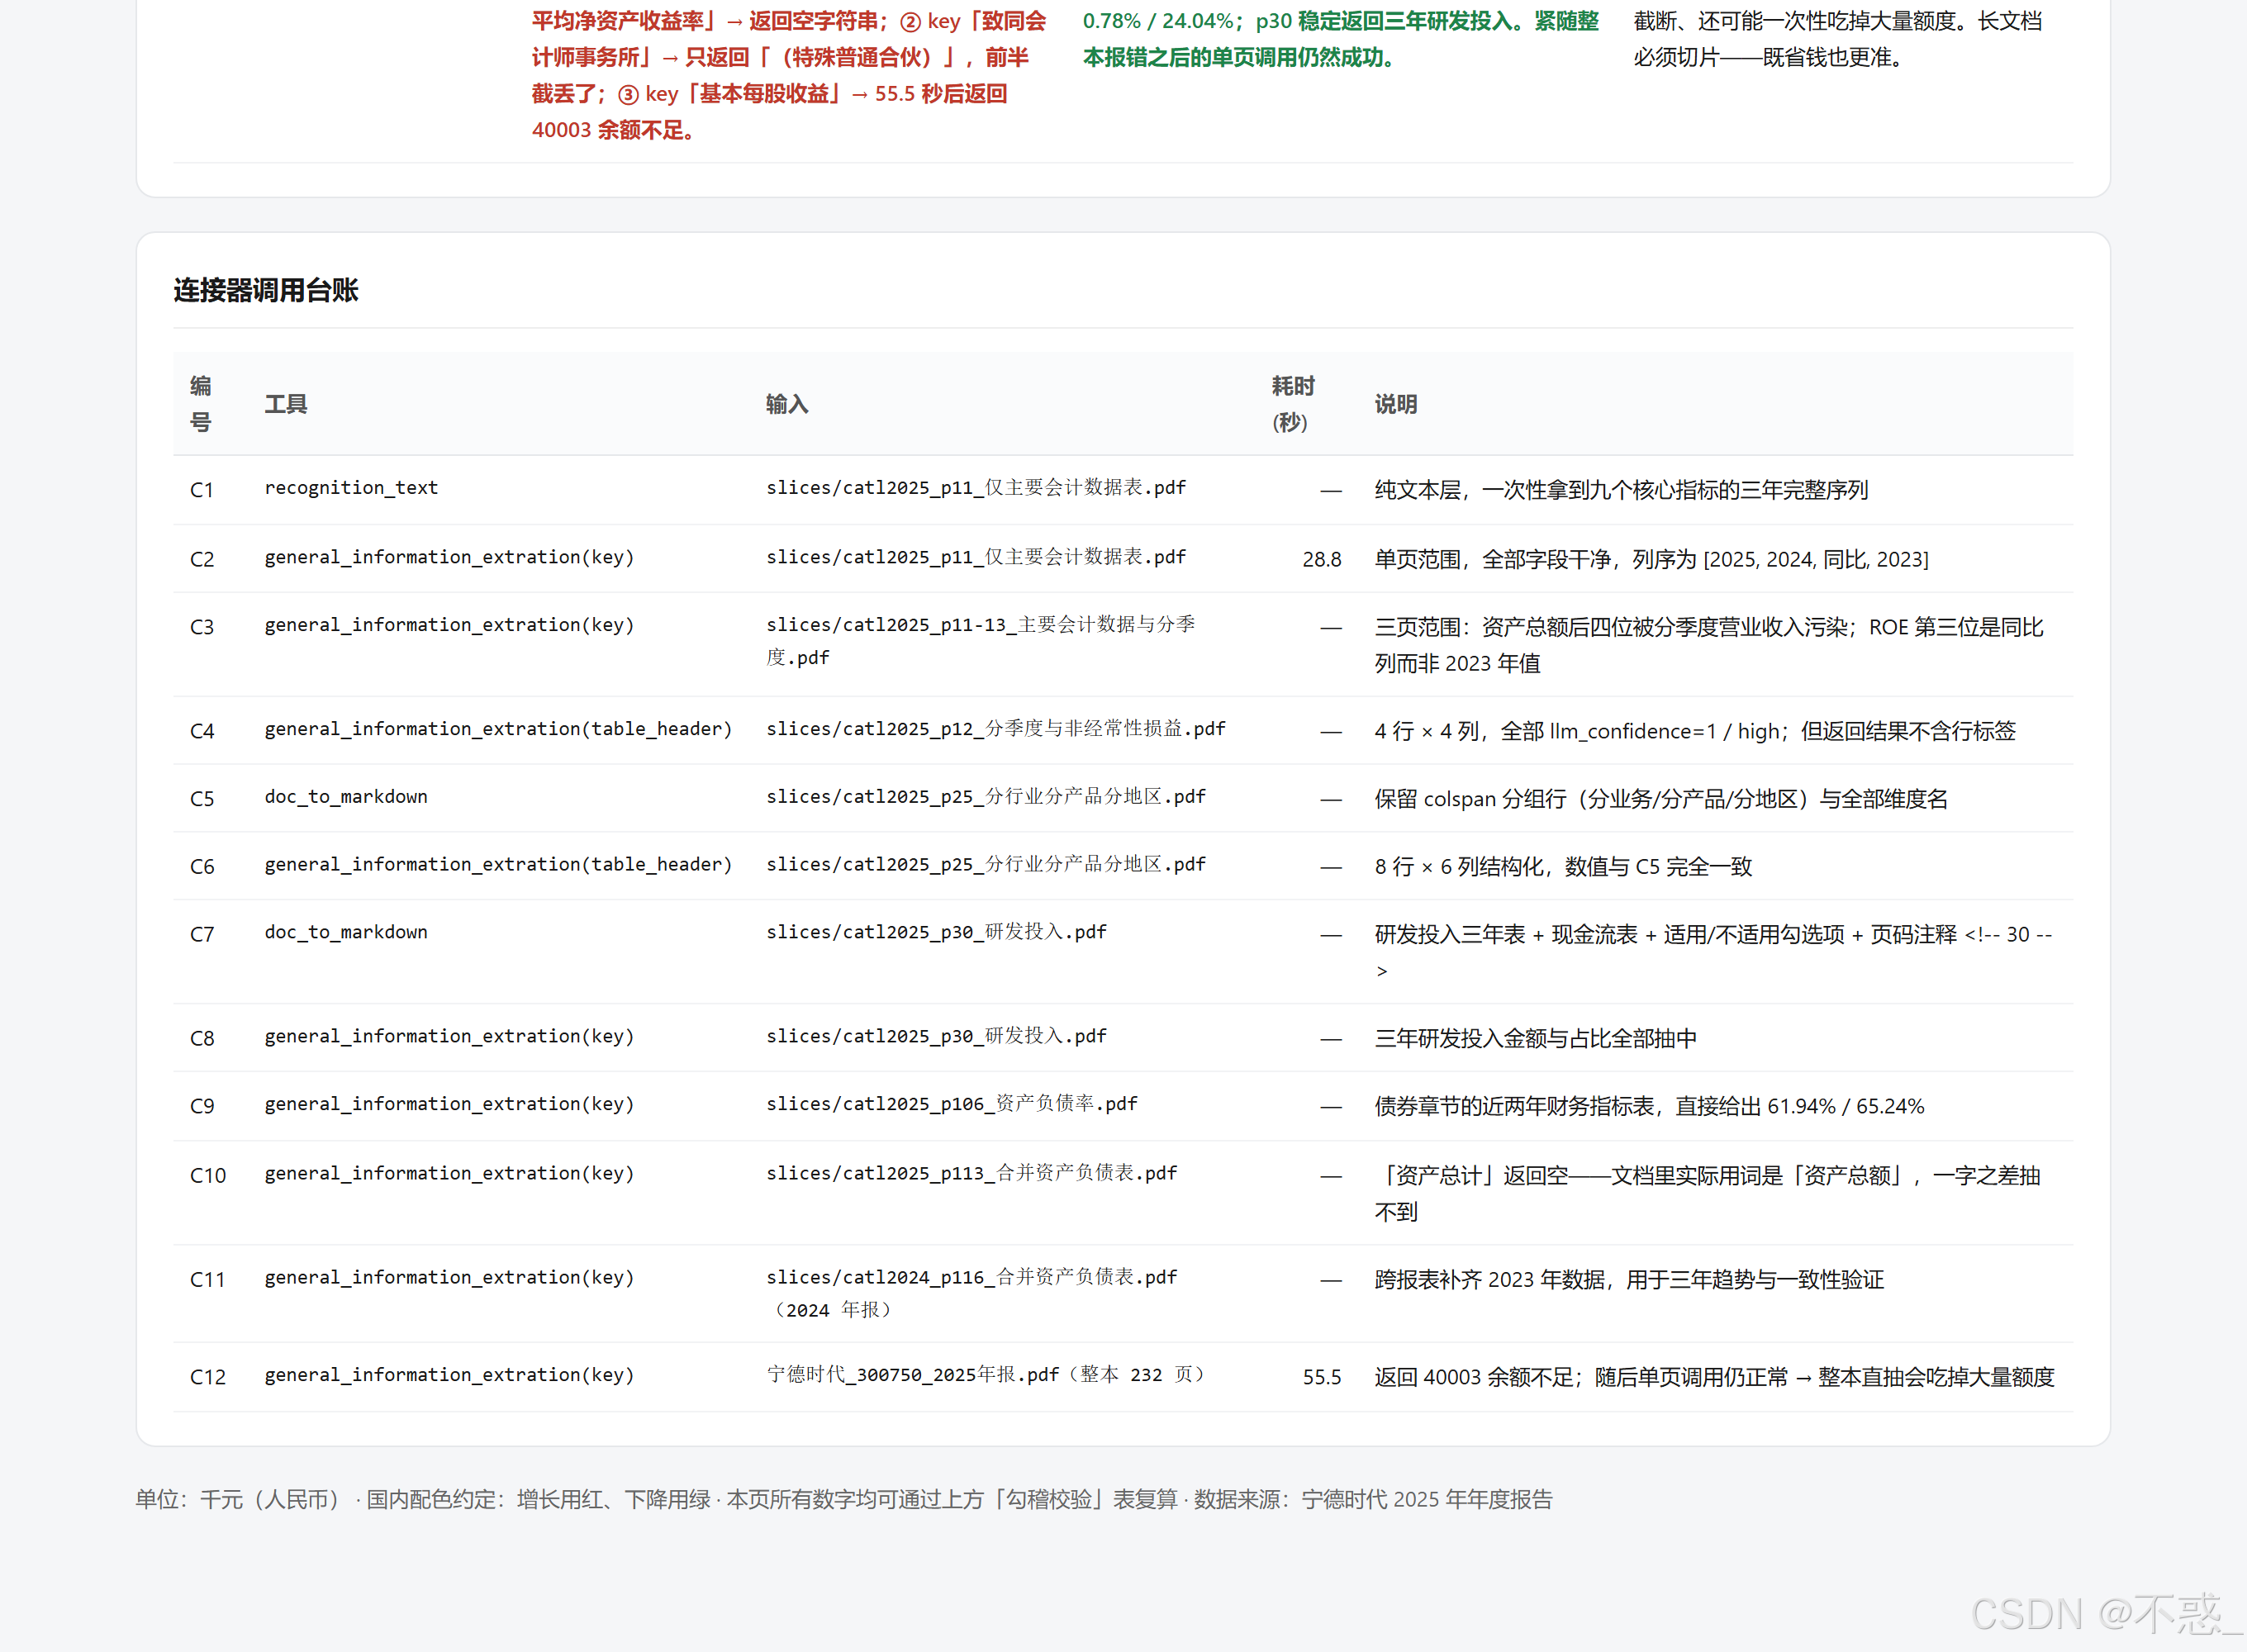
图 13:连接器调用台账。 C1–C12 每次调用的工具、输入文件、耗时、说明都记录了——这份表本身就是"有效调用与处理结果证明"。
11.2 Excel 结构化指标台账
八个工作表:
| 工作表 | 内容 |
|---|---|
| 核心财务指标 | 9 项 × 三年 + 同比 |
| 派生指标 | 净利率 / 现金含量 / 扣非占比 / 资产负债率 / 期末 ROE / 研发占比 |
| 分季度数据 | 4 个指标 × 4 季度 + 合计 + 与全年披露值的差异列 |
| 收入结构与毛利 | 分业务 / 分产品 / 分地区,含收入同比与毛利率变动(红涨绿跌) |
| 勾稽校验 | 22 条校验的计算式、期望值、结论 |
| 对照实验 | 三组失败用例 |
| 关注信号 | 7 条信号的级别、标题、说明 |
| 连接器调用台账 | C1–C12 |
11.3 WorkBuddy 里的操作痕迹
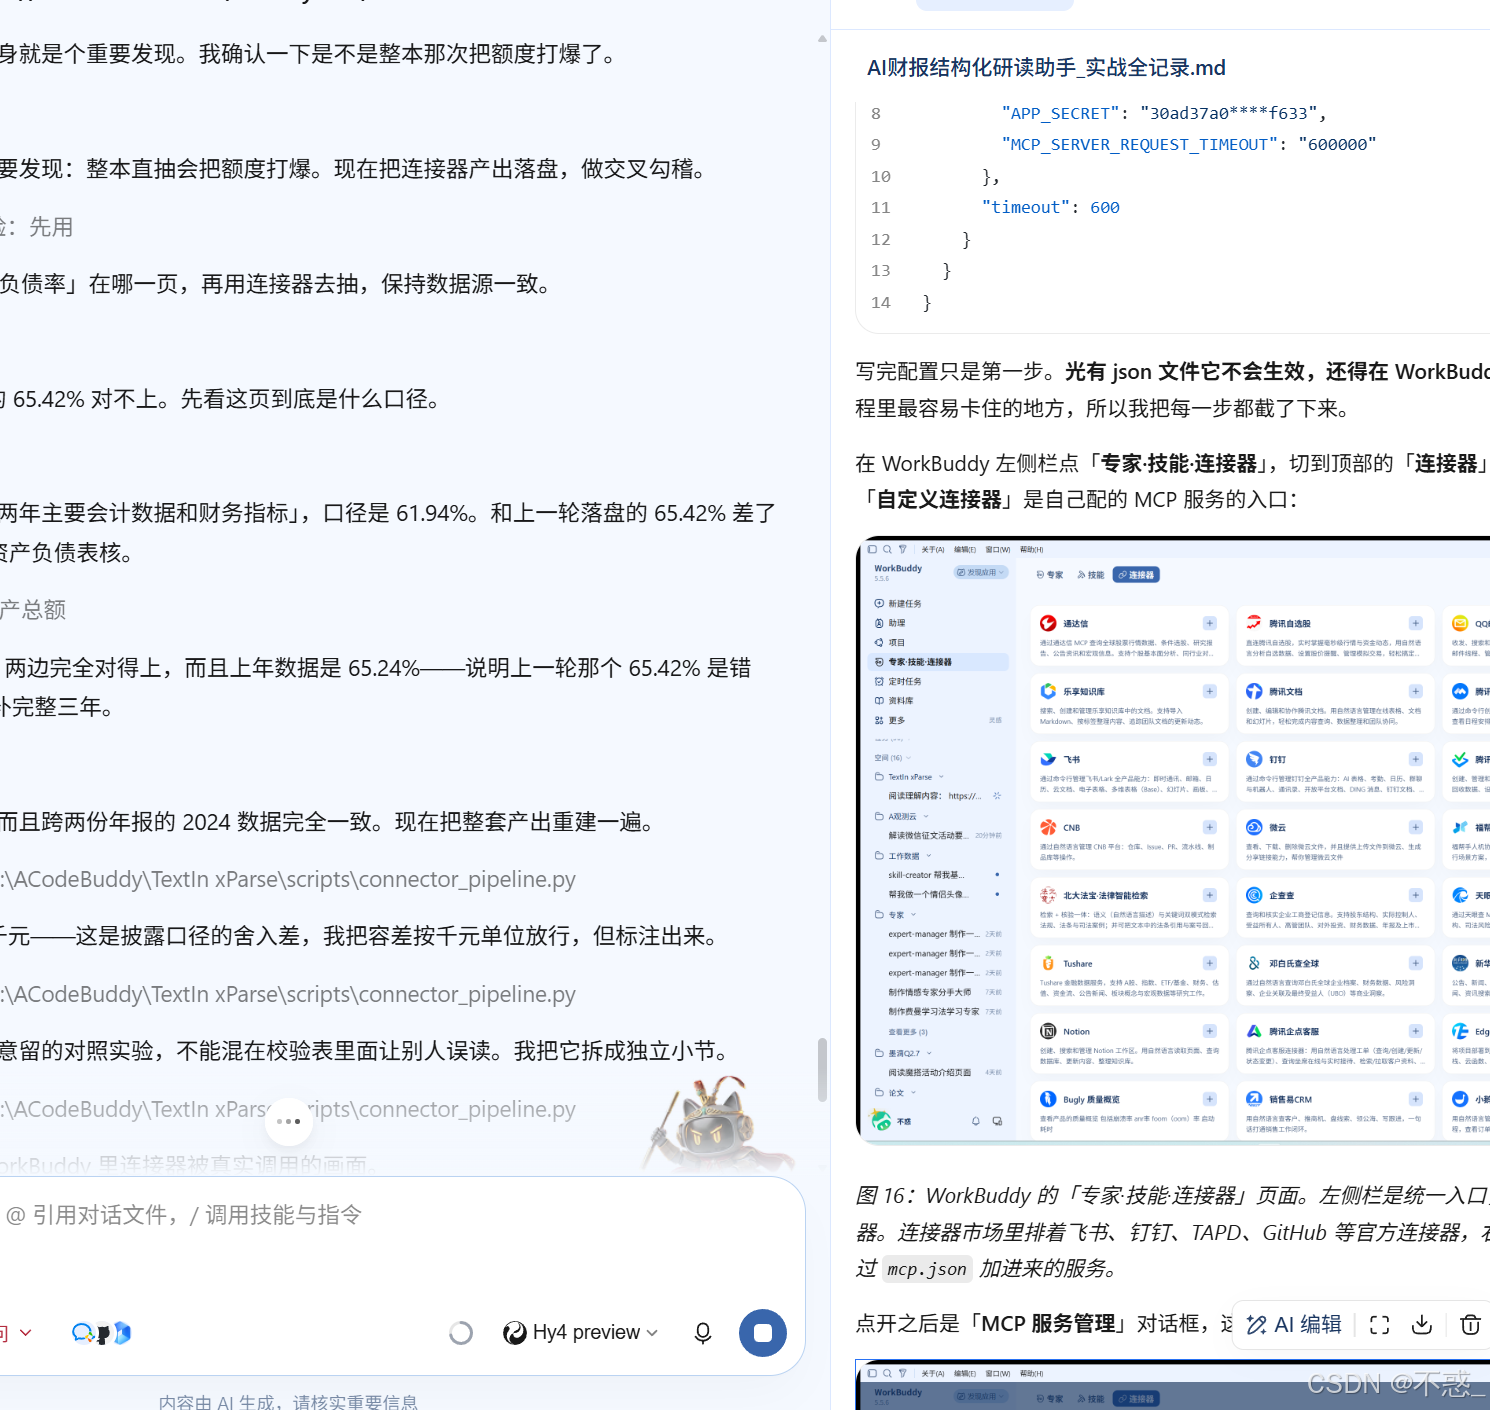
图 14:WorkBuddy 会话里逐步推进的过程。 每一条动作(写脚本、跑校验、调整口径)都留在会话里,配合底部的消耗计数,天然构成一份可追溯的操作日志。
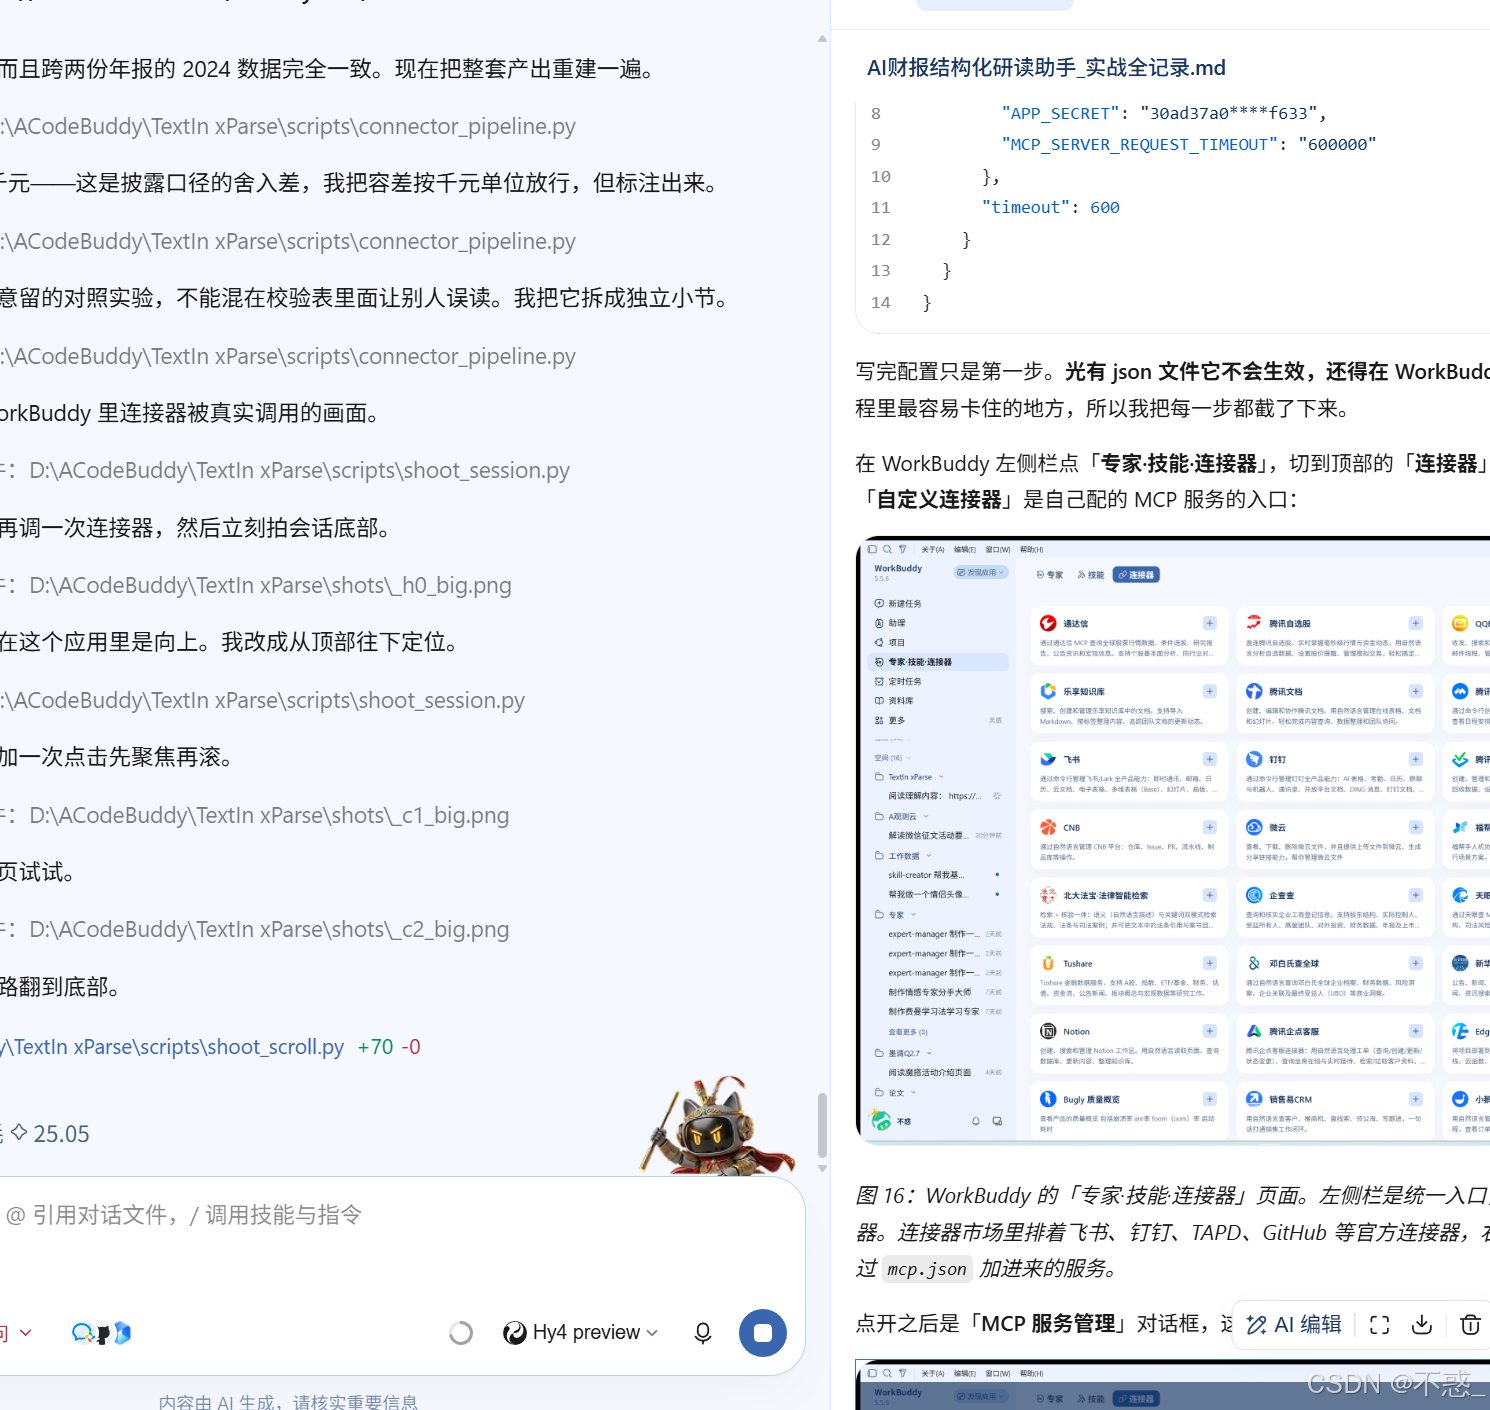
图 15: 执行完成后,产出物直接落在会话里,可点开预览或下载。
十二、连接器做不了什么(说清楚边界)
这一版全部走连接器,好处是把门槛降到零。但有一条能力是连接器这三个工具给不了的:引用坐标。
底层 Parse 接口返回的 elements[] 带归一化四点坐标,可以画出"这个数字在原页的哪个位置"的高亮框。连接器这三个工具返回的是值,不带坐标。
所以本文的对照证据图(图 5–图 9)是用本地渲染 + 文本检索定位做的,不是接口返回的坐标——这一点必须讲明白,不能含糊过去。
两种做法的取舍很清楚:
| 连接器(本文方案) | 底层接口 | |
|---|---|---|
| 上手成本 | 零代码,对话里就能用 | 要申请密钥、看接口文档、写脚本 |
| 输出形态 | 值 / Markdown / 表格结构 | 值 + 元素坐标 + 页图像直链 |
| 可做坐标级溯源 | ❌ | ✅ |
| 适合谁 | 业务同学、快速验证、批量取数 | 需要做审计级溯源、要画高亮证据的工具 |
如果场景需要"每个数字都带原页坐标"(审计、法务、投研尽调),那还是要走底层接口;如果目标是"把 200 页变成本周能用的结构化数据",连接器这三个工具完全够。
十三、结果盘点
| 指标 | 数值 |
|---|---|
| 处理文档 | 2 份年报 PDF(232 页 + 229 页),实际送入连接器 8 个切片 |
| 连接器调用次数 | 12 次(doc_to_markdown 2 次 / recognition_text 1 次 / 信息抽取 9 次) |
| 单次抽取耗时 | 约 28.8 秒(p11 单页、4 个字段,含固定开销) |
| 抽取字段数 | 核心 9 项 × 3 年 + 分季度 4 项 × 4 季 + 收入结构 8 行 × 6 列 + 研发 2 项 × 3 年 |
| 结构还原 | colspan 分组行、维度名、勾选项、页码注释全部保留 |
| 勾稽校验 | 22 条,全部通过 |
| 抓出的实质性错误 | 1 处(资产负债率口径错 3.48 个百分点) |
| 对照实验 | 3 组(页范围 / 键名 / 整本直抽) |
| 交付物 | 1 个交互看板 + 1 份 8 表 Excel 台账 + 1 份结构化 JSON + 5 张对照证据图 |
最直观的对比:一个人要把这份年报里本文用到的所有数据找齐、算对、核对完,保守估计 3–4 小时。
这一版是 12 次连接器调用 + 22 条自动勾稽。
十四、怎么复用到别的公司
整条链路已经固化成一个可复用的 Skill。换个公司只需要三步:
- 换数据源 — 巨潮资讯网按股票代码查公告(注意
static.cninfo.com.cn有反爬,用浏览器会话带 cookie 下载) - 换切片页码 — 先用
recognition_text探页,确认"主要会计数据"在第几页、分季度表在第几页,再按章节切片 - 跑连接器 + 勾稽 — 三个工具按分工调用,最后跑一遍校验脚本出看板与台账
注意事项(都是真实踩过的):
- 页范围宁窄勿宽 —— 宽了会串行污染
- key 必须与文档用词逐字一致 —— 先用
recognition_text确认 - 空字符串按"没抽到"处理 —— 别当 0
- 别整本直抽 —— 抽不稳、可能截断、吃额度
- 任何算出来的比率都要能溯源到两个原始科目 —— 第九节那个错误就是这么来的
写在最后
我第一版给这个项目的结论是"把一份 PDF 变成带坐标的结构化资产"。这一版的结论要改一下:
把一件原本需要工程师做的事,变成任何人在对话框里能做完的事。
代价是放弃了坐标级溯源。但换个角度想——真正决定这份数据能不能用的,从来不是有没有坐标,而是有没有人去核对。
22 条勾稽校验里,有一条抓出了我自己第一版 3.48 个百分点的错误。那条校验比任何高亮框图都值钱。
AI 抽取的门槛已经降到零了,接下来真正稀缺的,是"校验"这件事的自动化。
如果这篇对你有帮助,欢迎点赞收藏。有问题或者想聊聊别的文档类型(招股书、研报、合同、论文)怎么套这套流程,评论区见。
一站式 AI 云服务平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)