
KMP算法详解,快速理解
·
KMP(Knuth-Morris-Pratt)算法:
作用:在一段较长的文本(主串)中,以极高的效率查找某个较短的词或片段(模式串)出现的位置,并解决暴力匹配中的性能退化问题。
核心:在主串匹配失败时,主串指针不回退,模式串利用已经匹配成功的信息跳过不必要的比较。
1. 暴力匹配痛在哪里?
假设在主串 A B A B A B C 中找模式串 A B A B C:
主串:  A B A B A B C
模式串:A B A B C
              ^ (此处 'A' 与 'C' 失配)
第二轮:
主串:  A B A B A B C
模式串:  A B A B C
第三轮:
主串:  A B A B A B C
模式串:    A B A B C
暴力做法:
主串指针退回第 2 个字符 B,模式串退回第 1 个字符重新比。这丢弃了前 4 个字符已经匹配成功的有效信息。
KMP 的洞察:
既然前面匹配成功的片段是 s=A B A B,而这个片段的前缀 A B 与后缀 A B 完全一致,失配时主串指针停在原地不动,让模式串的前缀和公共匹配成功的子串“ABAB”的后缀对齐,这样主串的指针就不用移动了,主串指针前面已经匹配好的s的前缀就和模式串的后缀对齐了,接着从主串的原位置和模式串前缀的下一个字符比较。
主串:  A B A B A B C
模式串:    A B A B C
              ^ (直接从这里接着比)
2. 最长公共前后缀与 next 数组
为了知道每次失配时模式串该滑到哪,我们需要提前计算模式串中每个子串的最长相等前后缀长度(不能包含自身)。
以模式串 A B A B C 为例:
| 子串 | 前缀集合 | 后缀集合 | 最长公共前后缀 | 长度 |
|---|---|---|---|---|
A | 无 | 无 | 无 | 0 |
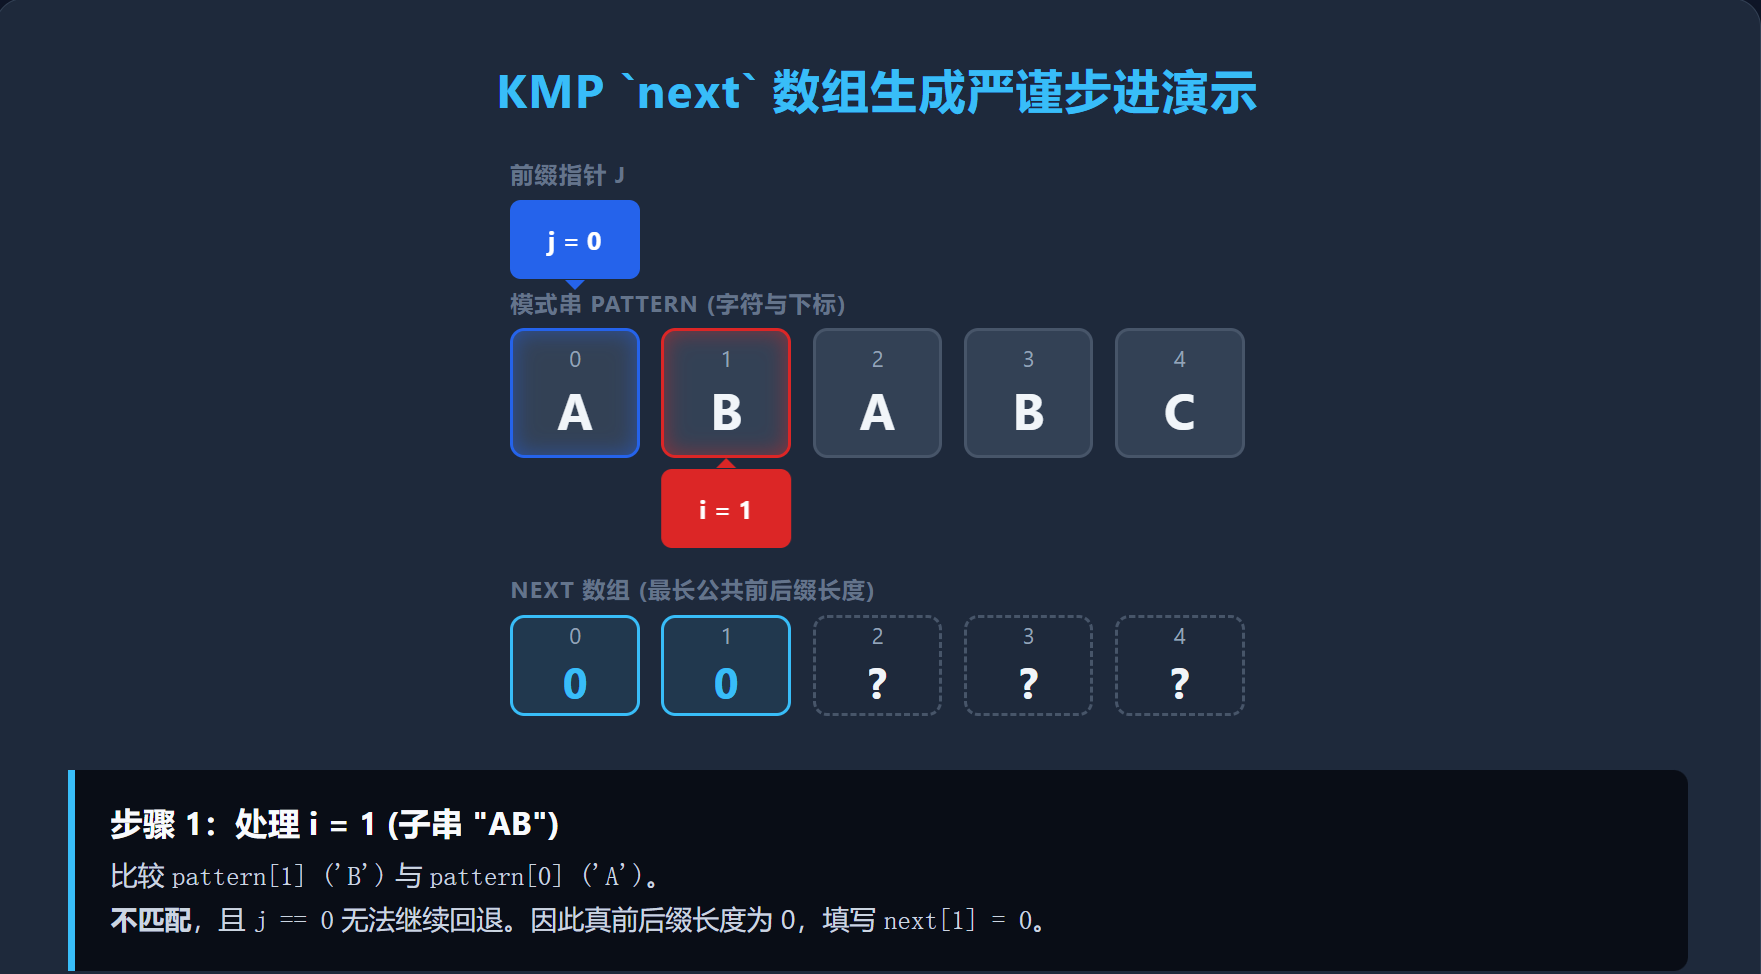
A B | {"A"} | {"B"} | 无 | 0 |
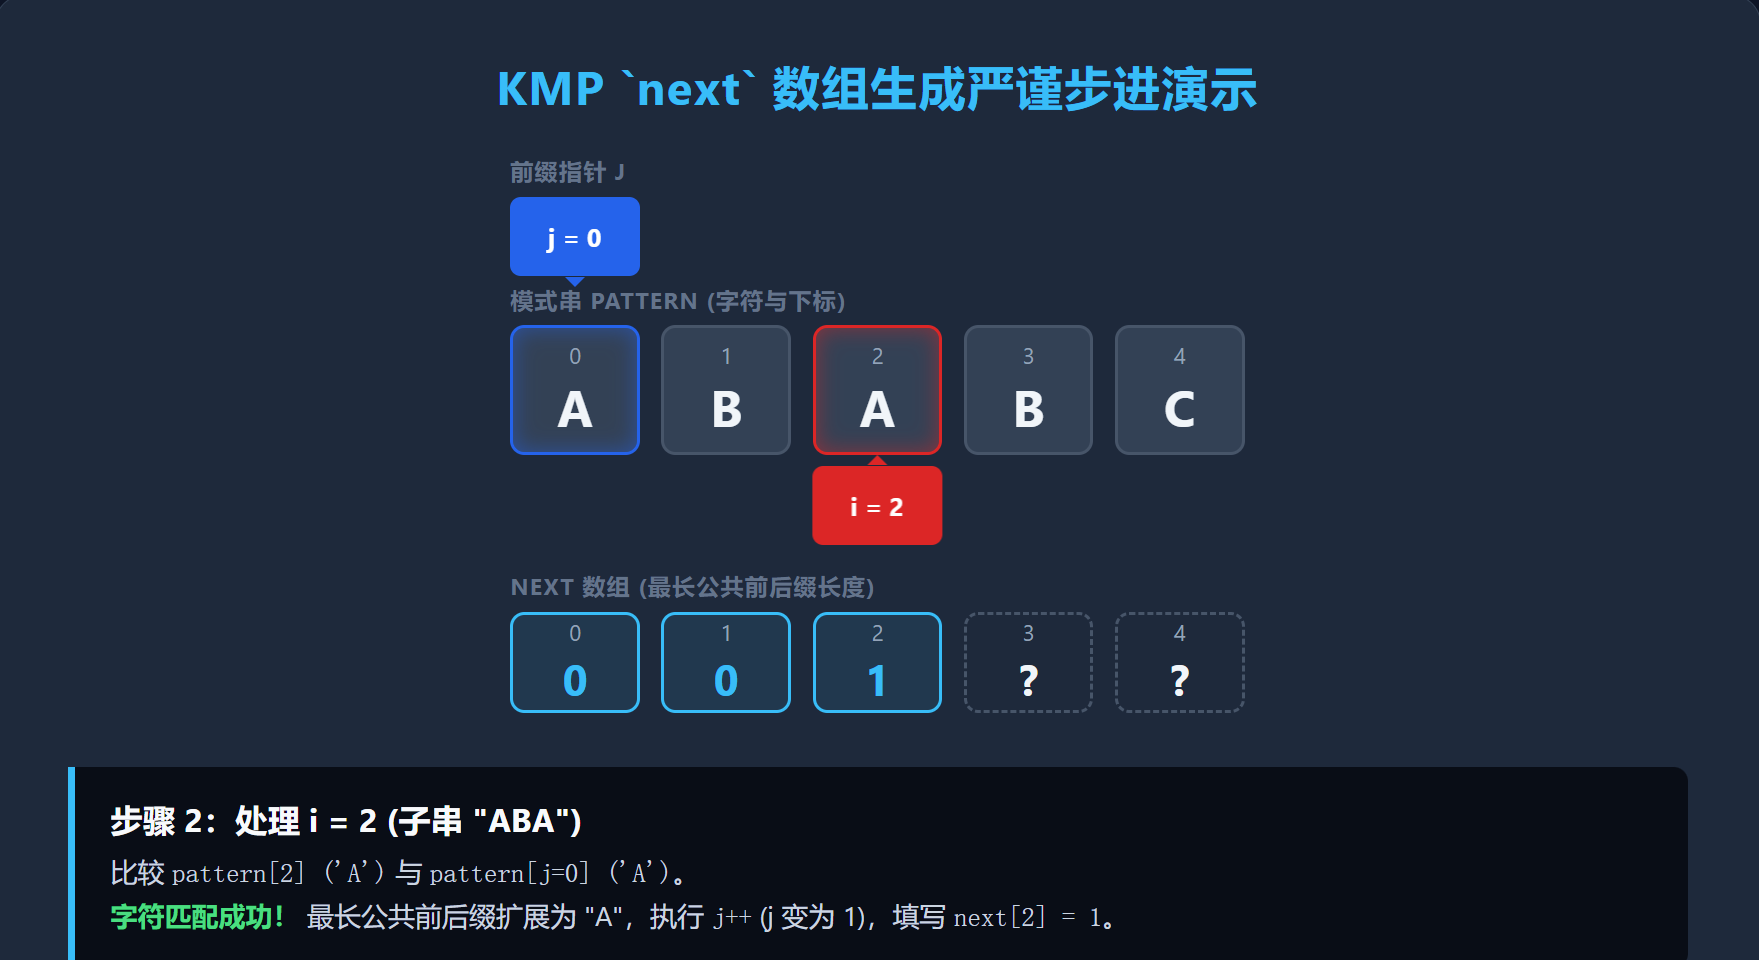
A B A | {"A", "AB"} | {"A", "BA"} | "A" | 1 |
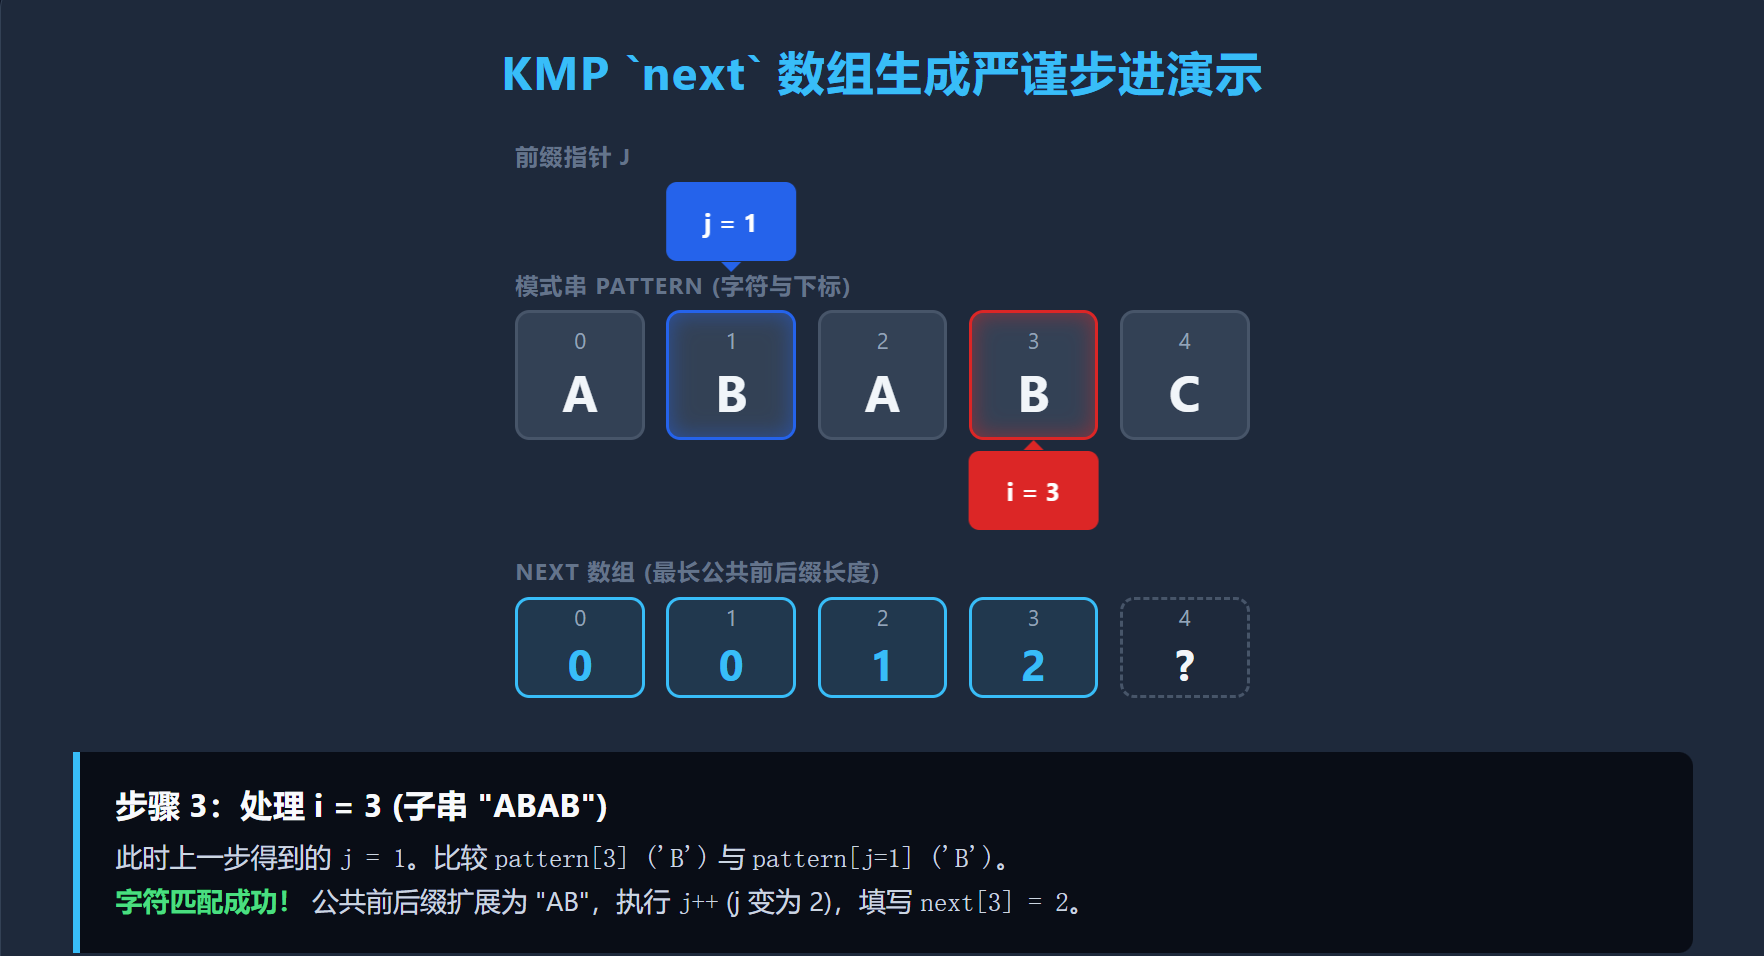
A B A B | {"A", "AB", "ABA"} | {"B", "AB", "BAB"} | "AB" | 2 |
A B A B C | … | … | 无 | 0 |
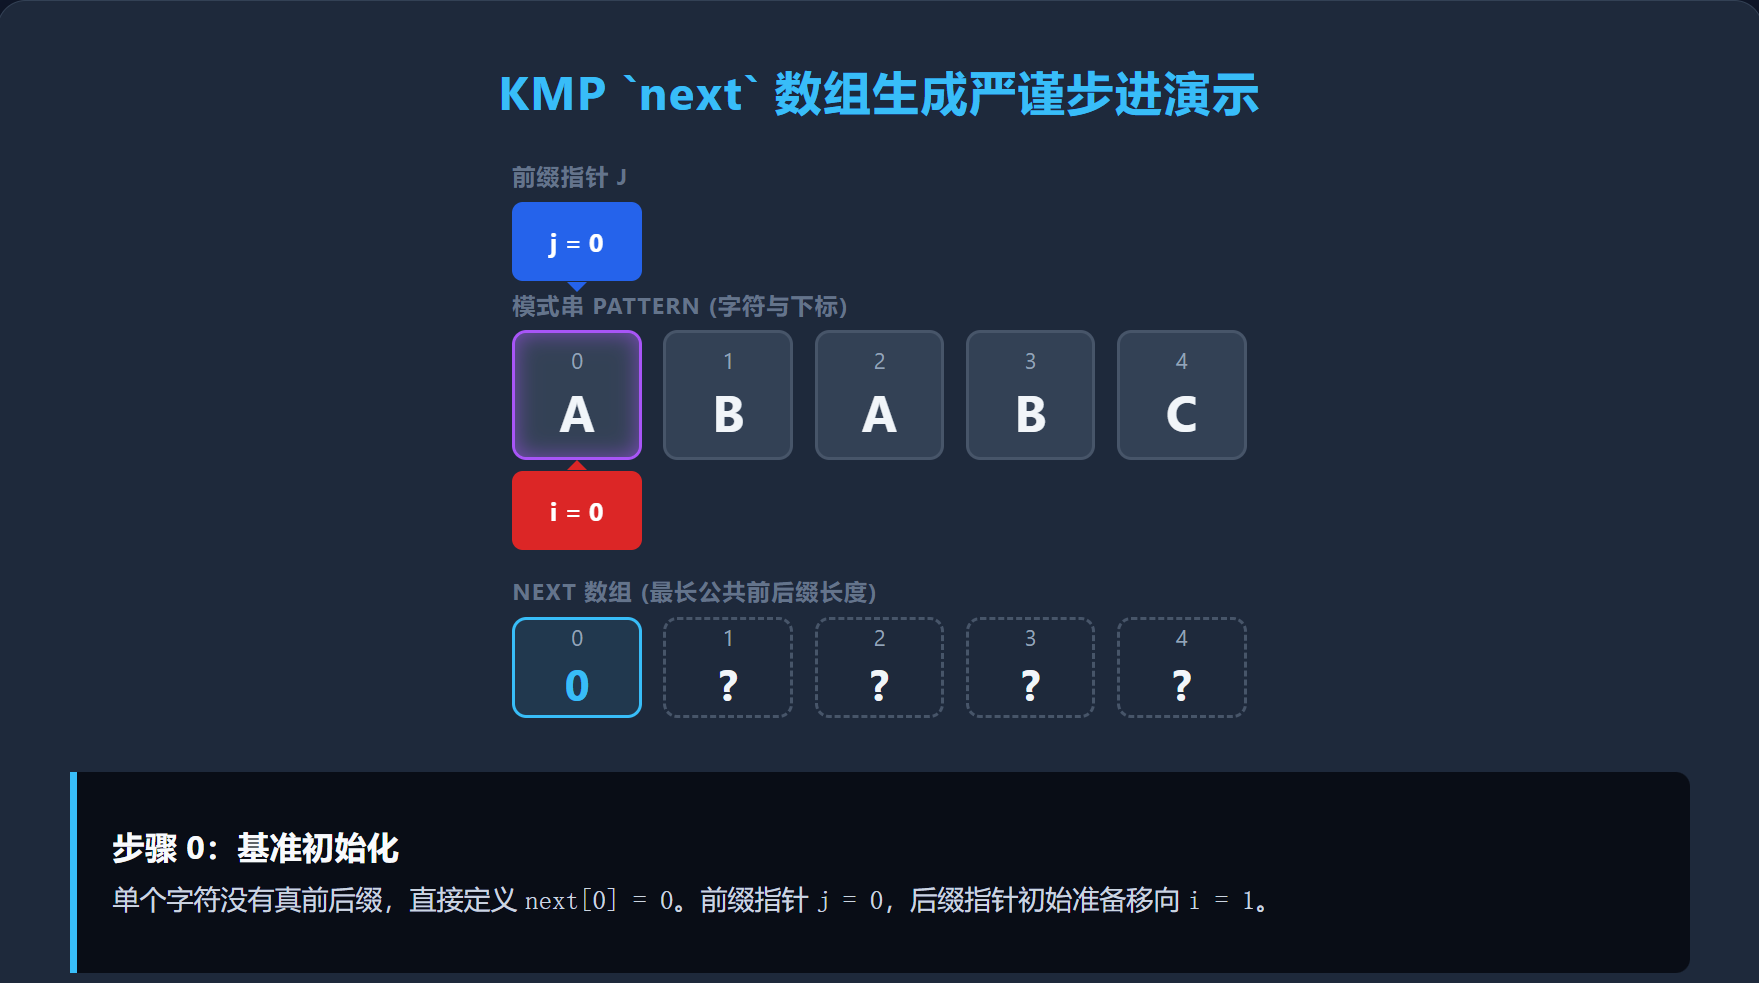
对应的公共前后缀长度表(前缀表)为:[0, 0, 1, 2, 0]。
在代码中,next[i] 存储模式串 0 ~ i 这一段子串的最长公共前后缀长度。当在下标 j 处失配时,说明 0 ~ j-1 已经匹配成功,模式串指针直接回跳到 next[j-1] 继续比较。
3.next数组构建过程
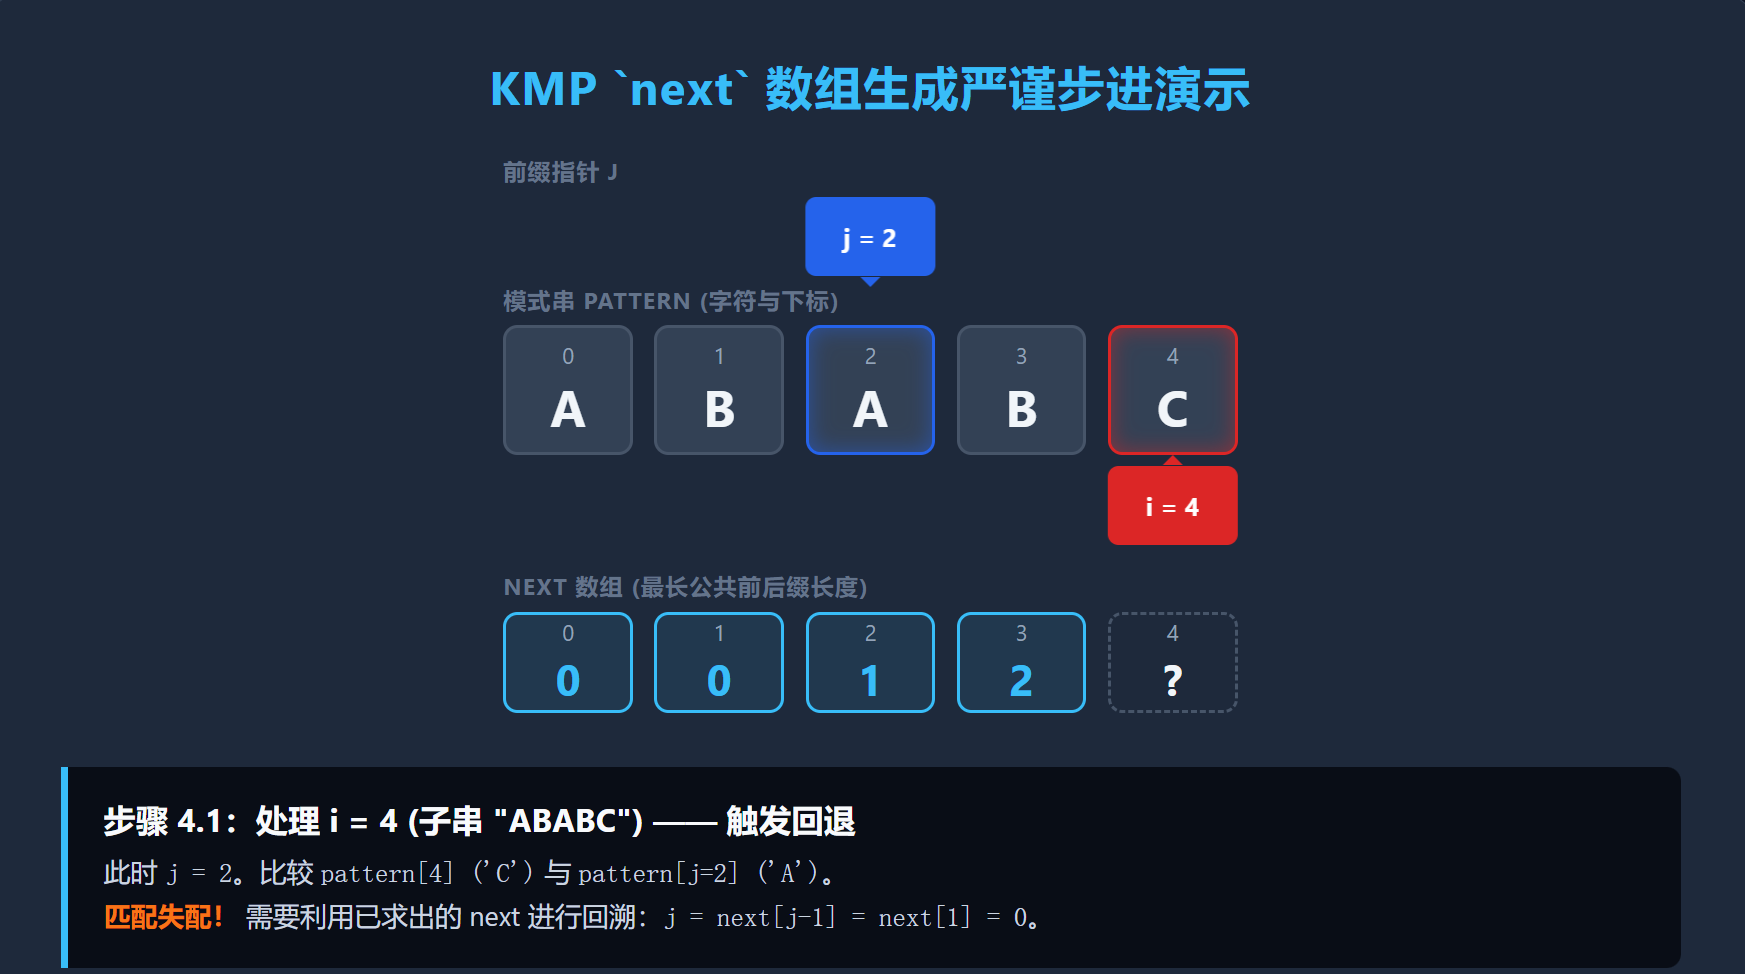
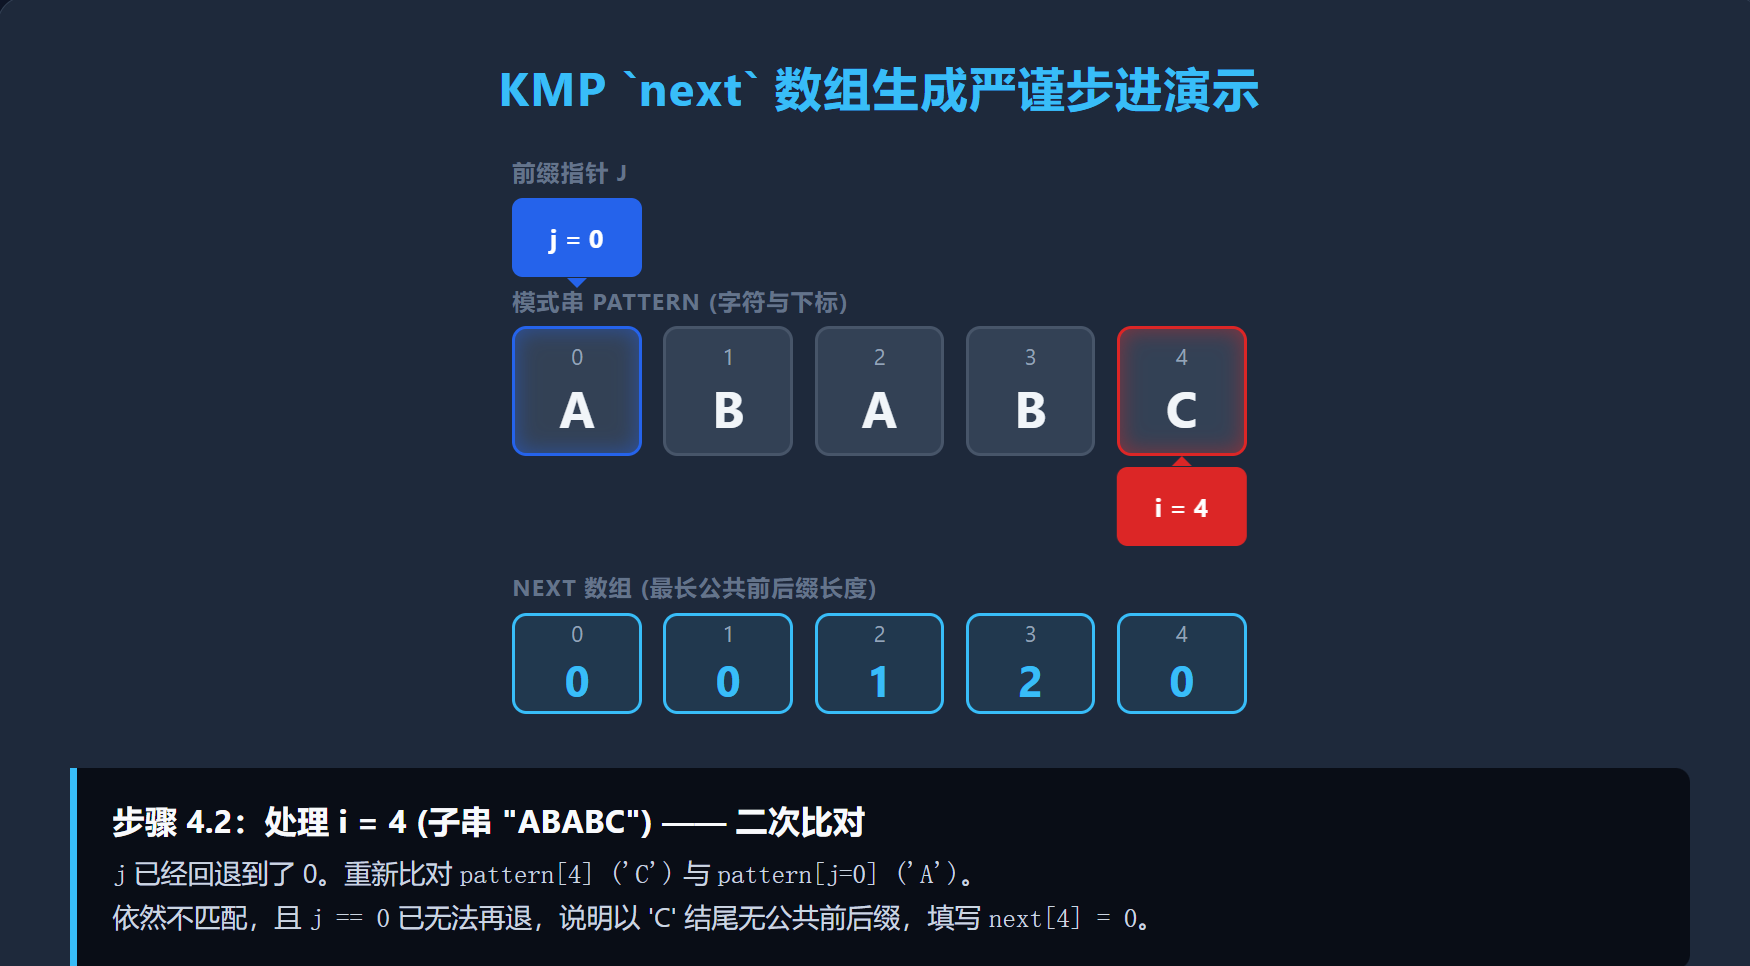
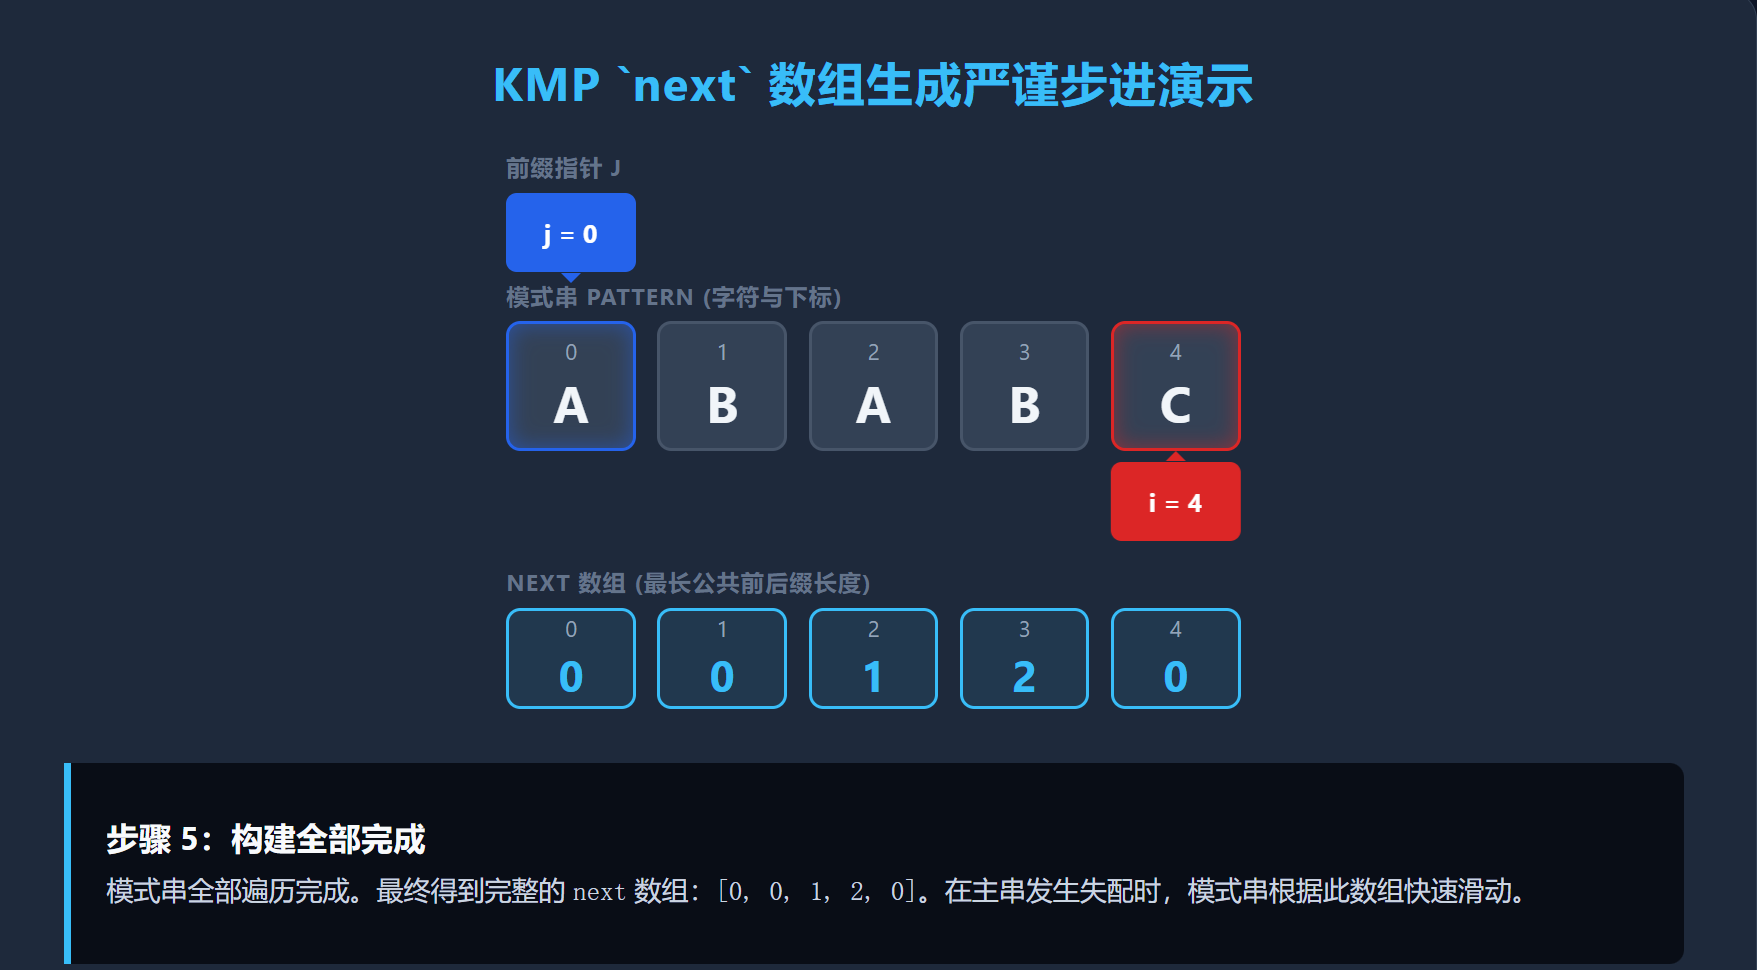
4. Java 完整实现
public class KmpSearch {
    /**
     * 计算 next 数组(前缀表)
     * next[i] 表示 pattern[0...i] 这一子串的最长相等前后缀长度
     */
    private static int[] buildNext(String pattern) {
        int m = pattern.length();
        int[] next = new int[m];

        // j 指向前缀末尾位置,同时代表当前最长公共前后缀长度
        int j = 0;
        next[0] = 0; // 单个字符没有非空真前后缀

        // i 指向后缀末尾位置
        for (int i = 1; i < m; i++) {
            // 前后缀不匹配时,持续回退 j 到上一个候选前缀
            while (j > 0 && pattern.charAt(i) != pattern.charAt(j)) {
                j = next[j - 1];
            }
            // 匹配成功,前缀长度加 1
            if (pattern.charAt(i) == pattern.charAt(j)) {
                j++;
            }
            next[i] = j;
        }
        return next;
    }

    /**
     * KMP 查找算法
     * @return 模式串首次在文本串中出现的下标;未找到返回 -1
     */
    public static int search(String text, String pattern) {
        if (pattern == null || pattern.isEmpty()) return 0;
        if (text == null || text.length() < pattern.length()) return -1;

        int[] next = buildNext(pattern);
        int j = 0; // 模式串指针

        for (int i = 0; i < text.length(); i++) {
            // 当前字符不匹配,模式串指针 j 回退
            while (j > 0 && text.charAt(i) != pattern.charAt(j)) {
                j = next[j - 1];
            }
            // 字符匹配成功,模式串指针向后移
            if (text.charAt(i) == pattern.charAt(j)) {
                j++;
            }
            // 找到完整匹配
            if (j == pattern.length()) {
                return i - pattern.length() + 1;
            }
        }
        return -1;
    }

    public static void main(String[] args) {
        String text = "ABABABABC";
        String pattern = "ABABC";

        int index = search(text, pattern);
        System.out.println("匹配成功的位置: " + index); // 输出: 4
    }
}
注意:next[]数组回退和主串与模式串匹配回退是同一种形式。都是尽量匹配最长的串,遇到不匹配的字符,就退一步,用更小的子串匹配。
5.主串和模式串匹配时为什么j=next[j-1]回退后,可以直接比较字符
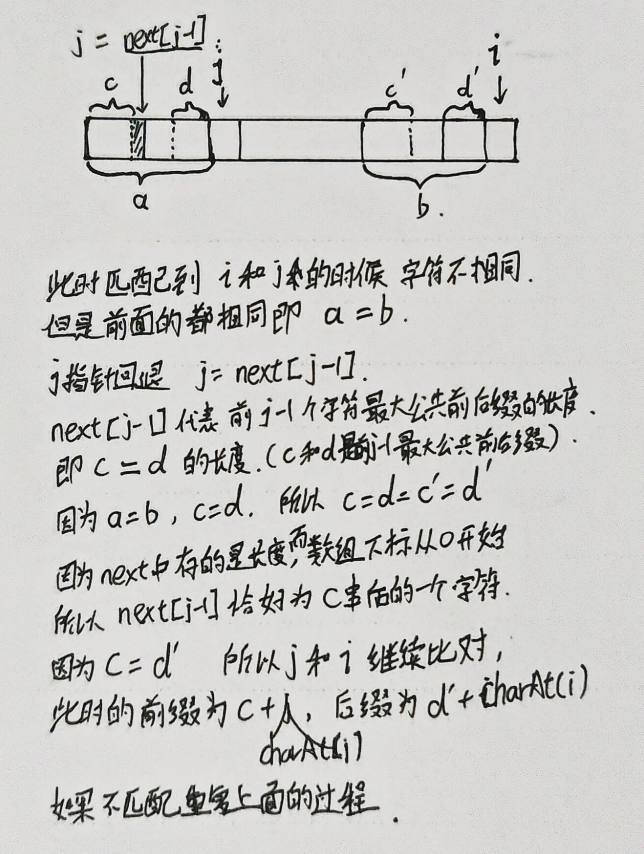
此时匹配到 i 和 j 的时候,字符不相同。
前面字符串的相同即 a = b。

j 指针回退  j = next [j-1].

next [j-1] 代表前 j-1 个字符最大公共前后缀的长度。
即 c = d 的长度。(c 和 d 是前 j-1 最大公共前后缀)。

因为 a=b,c=d。所以 c = d = c' = d'

因为 next数组 中存的是长度,数组下标从 0 开始
所以 next [j-1] 恰好为 c 串后的一个字符。

因为 c = d' 所以 j 和 i 继续比对,
此时的前缀为 c + charAt (i),后缀为 d' + charAt (i)

如果不匹配重复上面的过程。
6. 复杂度对比
- 暴力匹配: 时间复杂度为 O(N×M)O(N \times M)O(N×M),容易在重复字符较多的场景(如主串
AAAAAAAAB,模式串AAAB)发生频繁回退导致超时。 - KMP 算法:
- 预处理
next数组耗时 O(M)O(M)O(M)。 - 主串搜索阶段耗时 O(N)O(N)O(N)。
- 总时间复杂度稳定在 O(N+M)O(N + M)O(N+M),空间复杂度为 O(M)O(M)O(M)。
- 预处理

一站式 AI 云服务平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)