
【KMP算法-下篇】同一道题:Java 库函数 2600 微秒,手写 KMP 16 微秒
给你两个字符串,要你回答第二个在第一个里第一次出现的位置,从 0 开始数。
查不到就返回 -1。
题目保证第二个串至少有一个字符。
这种题一行代码就能完成:
Java 有 haystack.indexOf(needle),C++ 和 Python 也各有现成的 find。
可这些现成的函数,跑起来不一定比手写的快。
手写的版本,就是上篇【KMP算法-上篇】匹配失败之后,KMP 凭什么敢一次跳过一大段和中篇【KMP算法-中篇】next 数组的递推:往前填一位,靠的是往回退几步讲的那套 KMP。
这篇讲两件事:
它快在哪里,以及同一套 KMP 还能解另一道看起来毫不相干的题。
库函数能过,一个用例就能把差距拉开
JDK 自带的 indexOf 内部用的什么匹配办法,要看源码才知道。
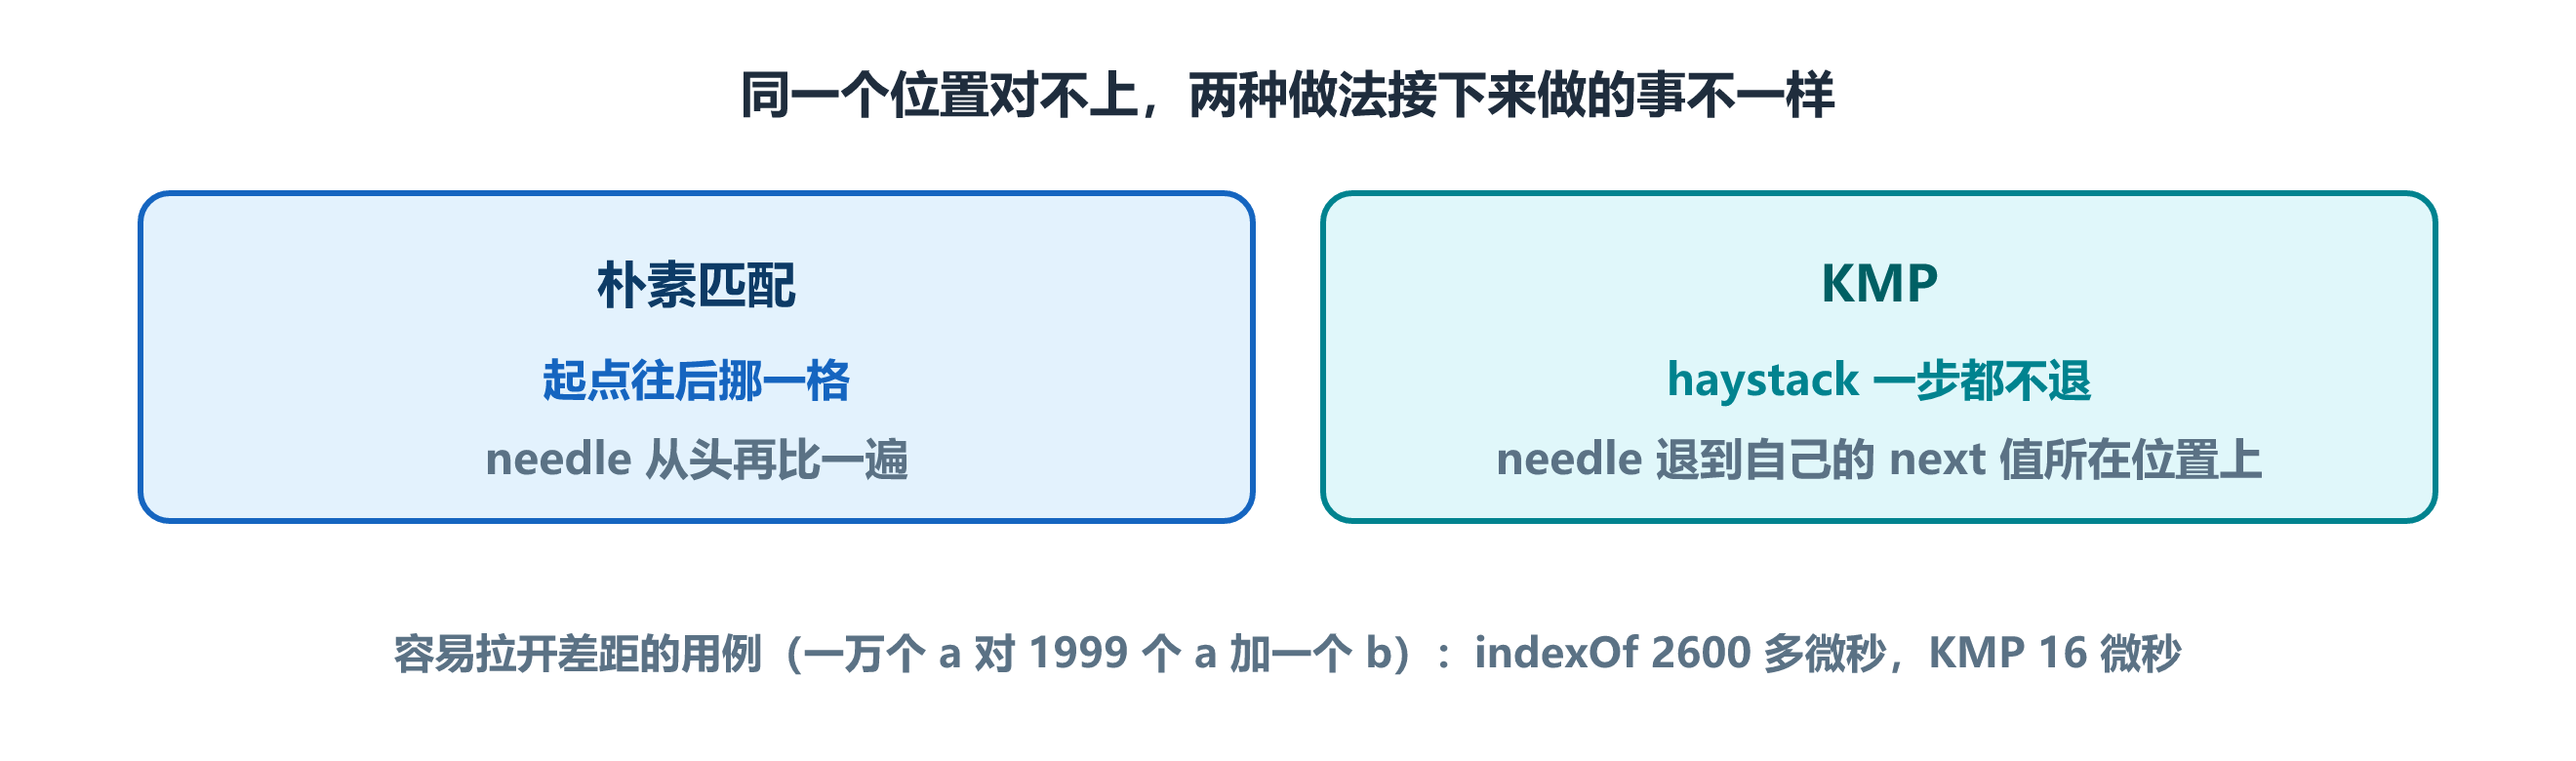
朴素匹配是最直接的:
一次对不上,就把起点往后挪一格,重新从头比一遍。
拿一个容易把差距拉开的用例试一下:
haystack 是1万个 a,needle 是1999个 a 再加一个 b。
这种用例下,前面绝大多数起点,都要从头比到 needle 的最后一位,才发现差一个字符。
同一台机器上,indexOf 花了 2600 多微秒,手写 KMP 只要 16 微秒。
这组用例里,差距就出在匹配的做法上。
把讲过的匹配那一趟拼起来
这道题要做的,就是把前面讲的两趟接到一起:
算 next 数组是一趟,拿 next 做匹配是另一趟。
把 haystack 当成 S1,needle 当成 S2。
从两个串的开头同时往前走,字符一样就一起往后挪一位。
对不上,就看 S2 当前位置的 next 值:
能退就让 S2 往后退,退不动就让 S1 换一个起点重来。
S2 走到底,说明配上了,起点是 S1 走到的位置减掉 S2 的长度。
S1 走到底,S2 还没走完,就是没配上,返回 -1。
这两趟合起来,就是一个完整的匹配函数。
翻译成 Java 代码
class Solution {
    public int strStr(String haystack, String needle) {
        char[] s1 = haystack.toCharArray();
        char[] s2 = needle.toCharArray();
        int n = s1.length, m = s2.length;
        int[] next = nextArray(s2, m);

        int x = 0;   // S1 上正在比对的位置
        int y = 0;   // S2 上正在比对的位置

        while (x < n && y < m) {
            if (s1[x] == s2[y]) {
                x++;         // 相等,两个位置一起往后
                y++;
            } else if (next[y] == -1) {
                x++;         // S2 退无可退,S1 换下一个起点
            } else {
                y = next[y]; // S1 不动,S2 退到 next 值所在位置上
            }
        }

        // S2 走到底就是配上了,起点是 x 减掉 S2 的长度
        return y == m ? x - m : -1;
    }

    // 算每一位的 next 值,只看 S2 自己
    private int[] nextArray(char[] s, int m) {
        if (m == 1) {                    // 只有一位,直接给定
            return new int[] { -1 };
        }
        int[] next = new int[m];
        next[0] = -1;                    // 这两位是规定好的
        next[1] = 0;
        int i = 2;                       // 正在算 next 值的位置
        int cn = 0;                      // 当前正在试的那个长度
        while (i < m) {
            if (s[i - 1] == s[cn]) {
                next[i++] = ++cn;        // 对上了,这一位就是当前长度加一
            } else if (cn > 0) {
                cn = next[cn];           // 没对上,换成更短的长度再试
            } else {
                next[i++] = 0;           // 退到 0 还是没对上,这一位就是 0
            }
        }
        return next;
    }
}
| 代码 | 大白话 |
|---|---|
s1 和 s2 | haystack 和 needle 各自转成的字符数组 |
x 和 y | S1 和 S2 上各自的比对位置 |
next[y] == -1 | S2 退不动了,S1 换一个起点重来 |
y = next[y] | S1 不动,S2 退到 next 值所在位置上 |
y == m | S2 走到底,说明配上了 |
x - m | 配上的这一段在 S1 里的起点 |
nextArray | 单独算 S2 每一位的 next 值,跟 S1 无关 |
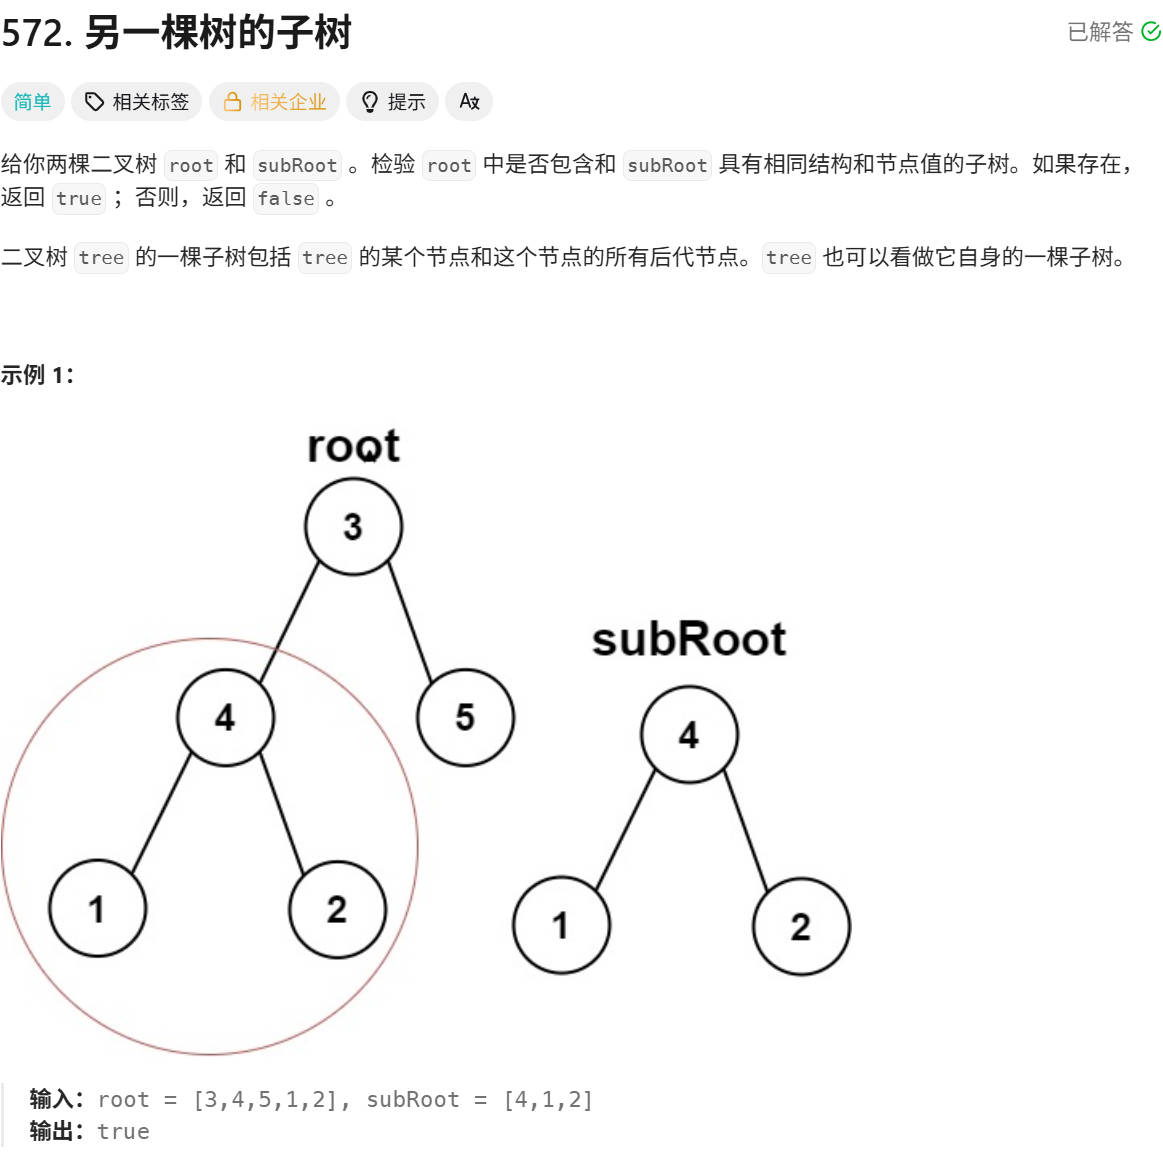
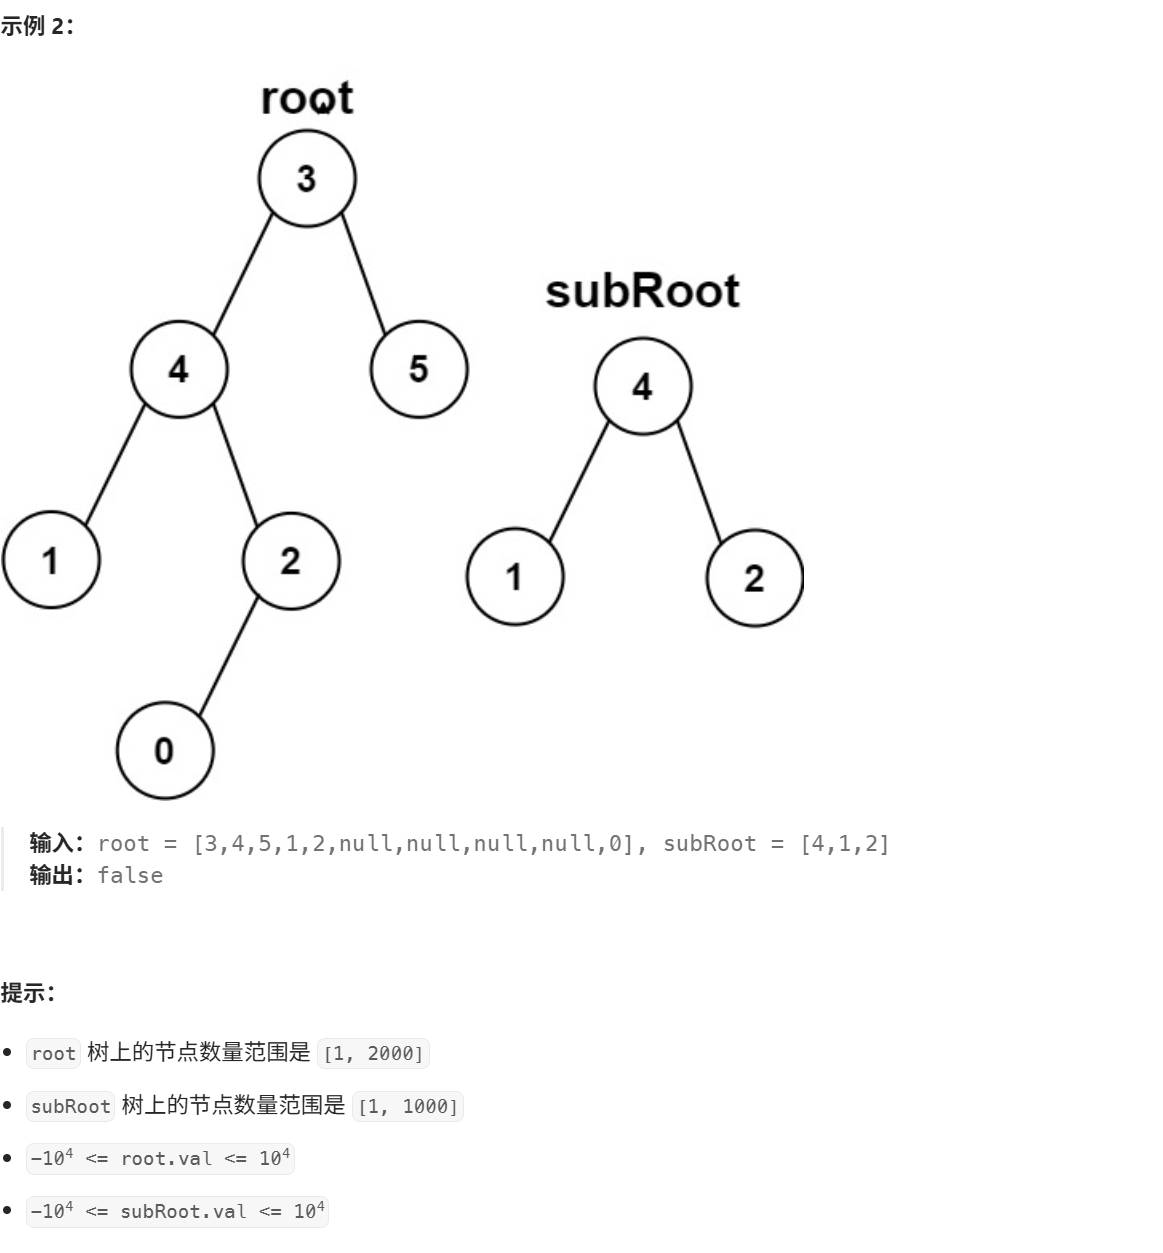
换一道题:一棵树里有没有另一棵树
第二道题换到树上。
给你两棵树,问你第一棵里有没有一棵子树,跟第二棵的结构和节点值完全一样。
这里说的子树,是选中一个节点当起点,从这个节点往下能走到的每一个节点都要算上,一个都不能少。
举个例子,第一棵长这样:
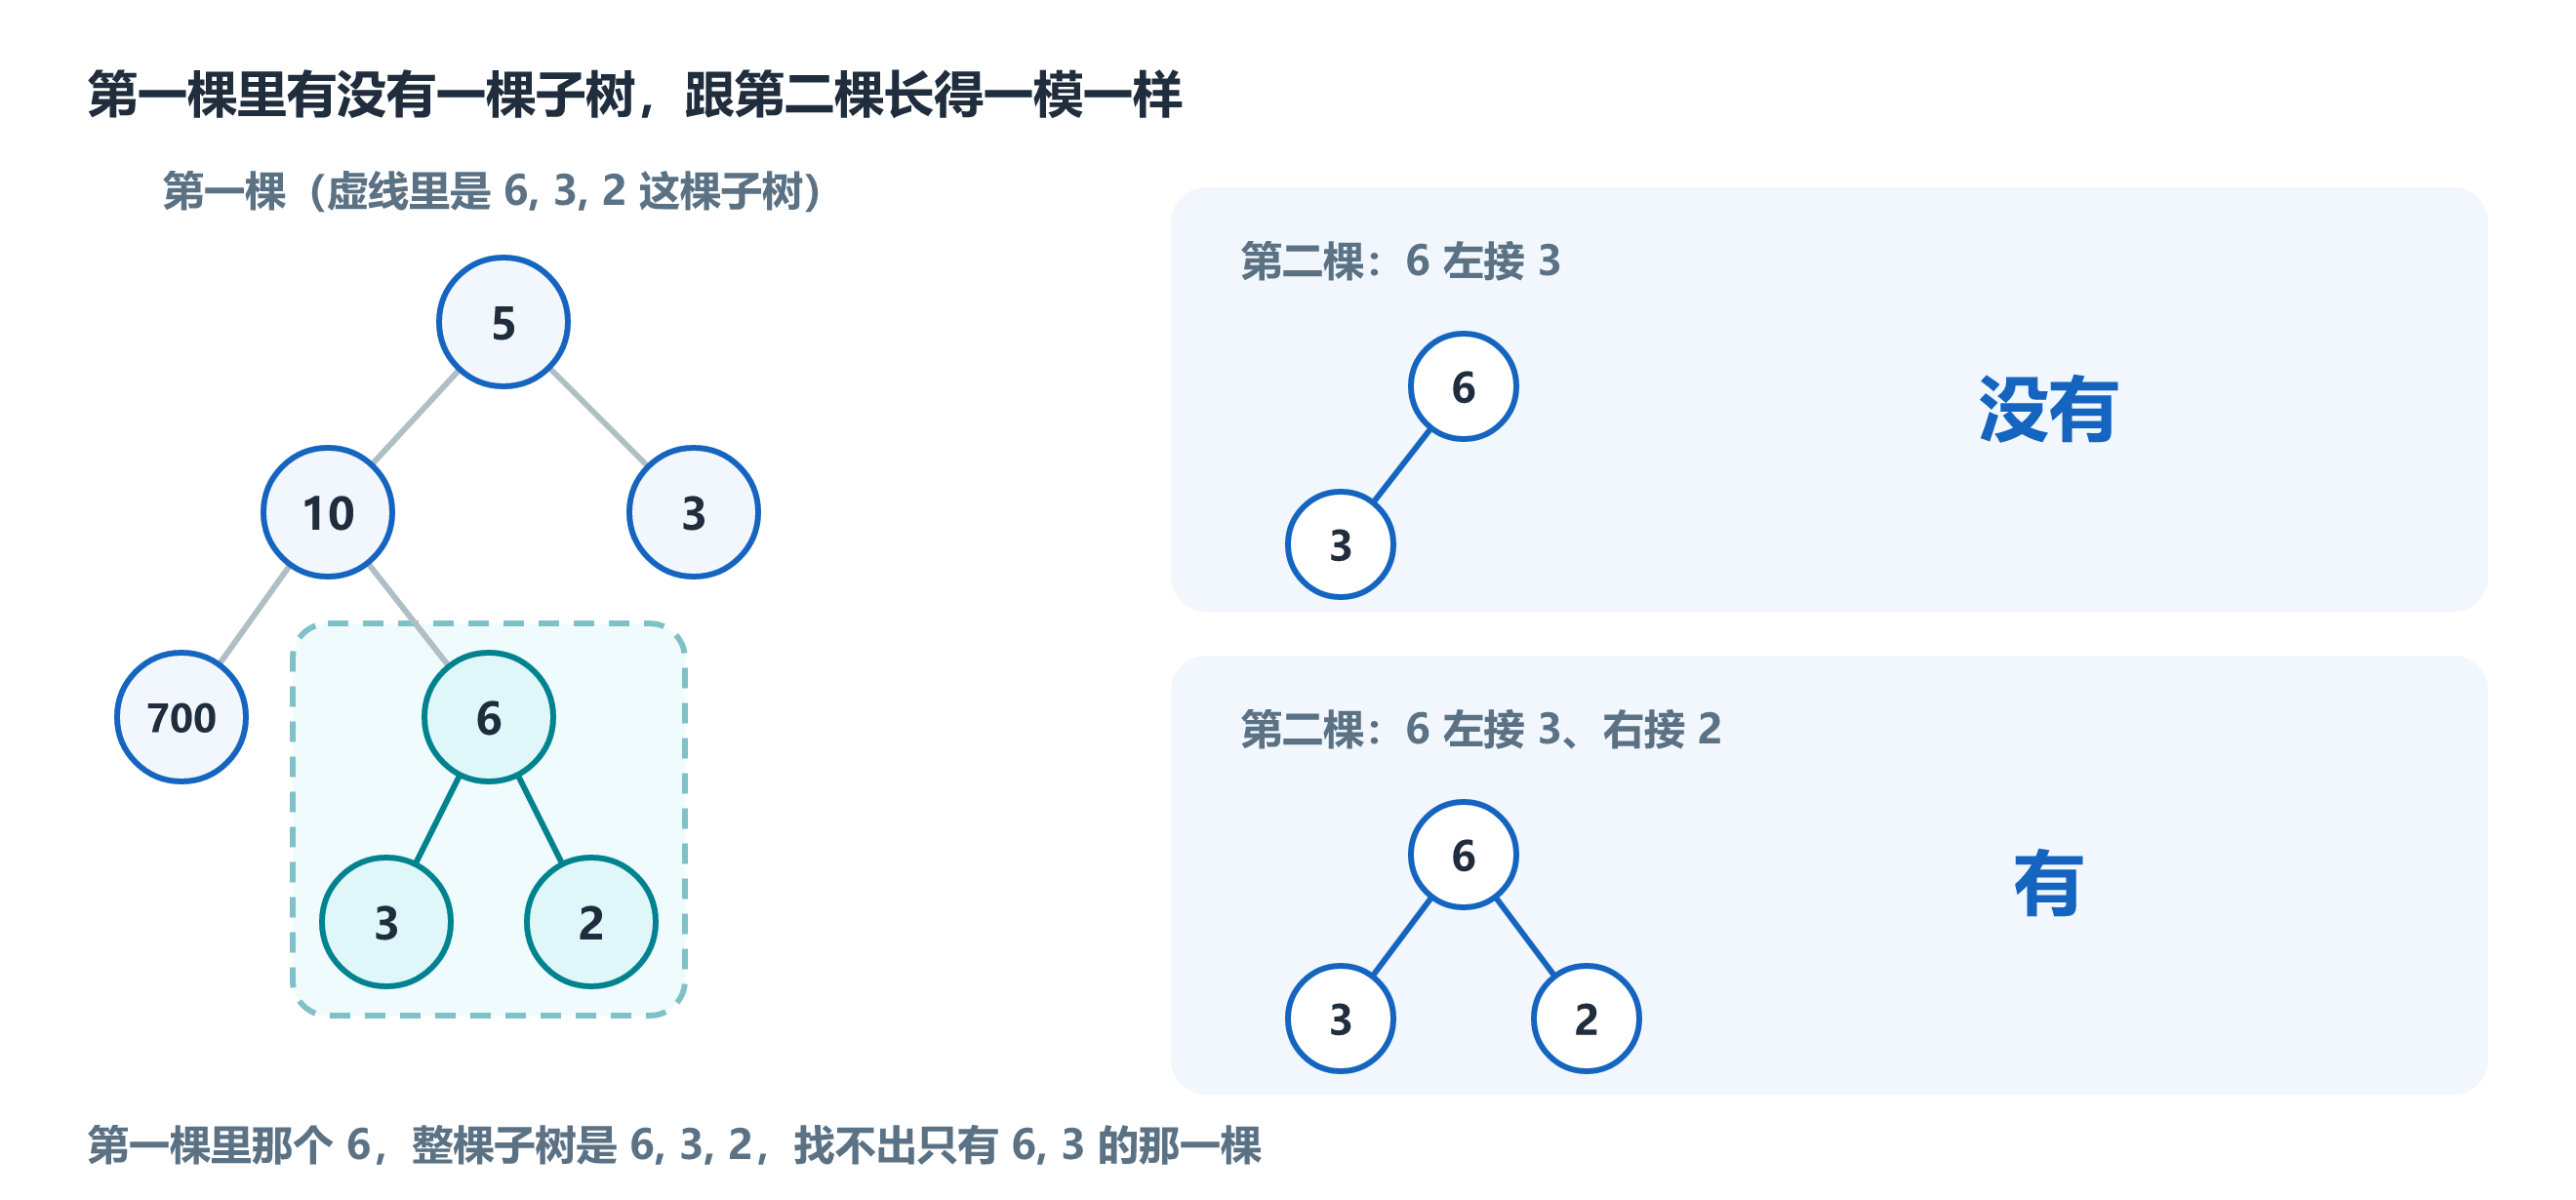
第二棵如果是 6 左接一个 3,答案是没有。
第一棵里的 6 右边还接着 2,它这棵子树是 6, 3, 2,找不出只有 6, 3 的那一棵。
要是第二棵是 6 左接 3、右接 2,答案就是有。
一个个节点去试一遍
最直接的做法:
把第一棵的每个节点都当一次起点,跟第二棵从头比一遍。
比的时候两边要同时走完才算配上,一边走完一边还有剩就是没配上。
public boolean isSubtree(TreeNode root, TreeNode subRoot) {
    if (root == null) return false;         // 第一棵都空了,下面不可能有
    if (same(root, subRoot)) return true;   // 当前这个节点对上了
    return isSubtree(root.left, subRoot)    // 没对上,就往左右子树里接着找
        || isSubtree(root.right, subRoot);
}

// 判断两棵树是不是长得一模一样
private boolean same(TreeNode a, TreeNode b) {
    if (a == null && b == null) return true;
    if (a == null || b == null) return false;   // 一个有,一个没有
    return a.val == b.val && same(a.left, b.left) && same(a.right, b.right);
}
第一棵有 n 个节点,第二棵有 m 个。
最坏情况下,每个起点都要把第二棵树整棵比一遍,复杂度是 O(n × m)。
题目给的节点数不大,这么写也能过。
可树一大就慢了,下面换个做法。
把树变成字符串,再跑一遍 KMP
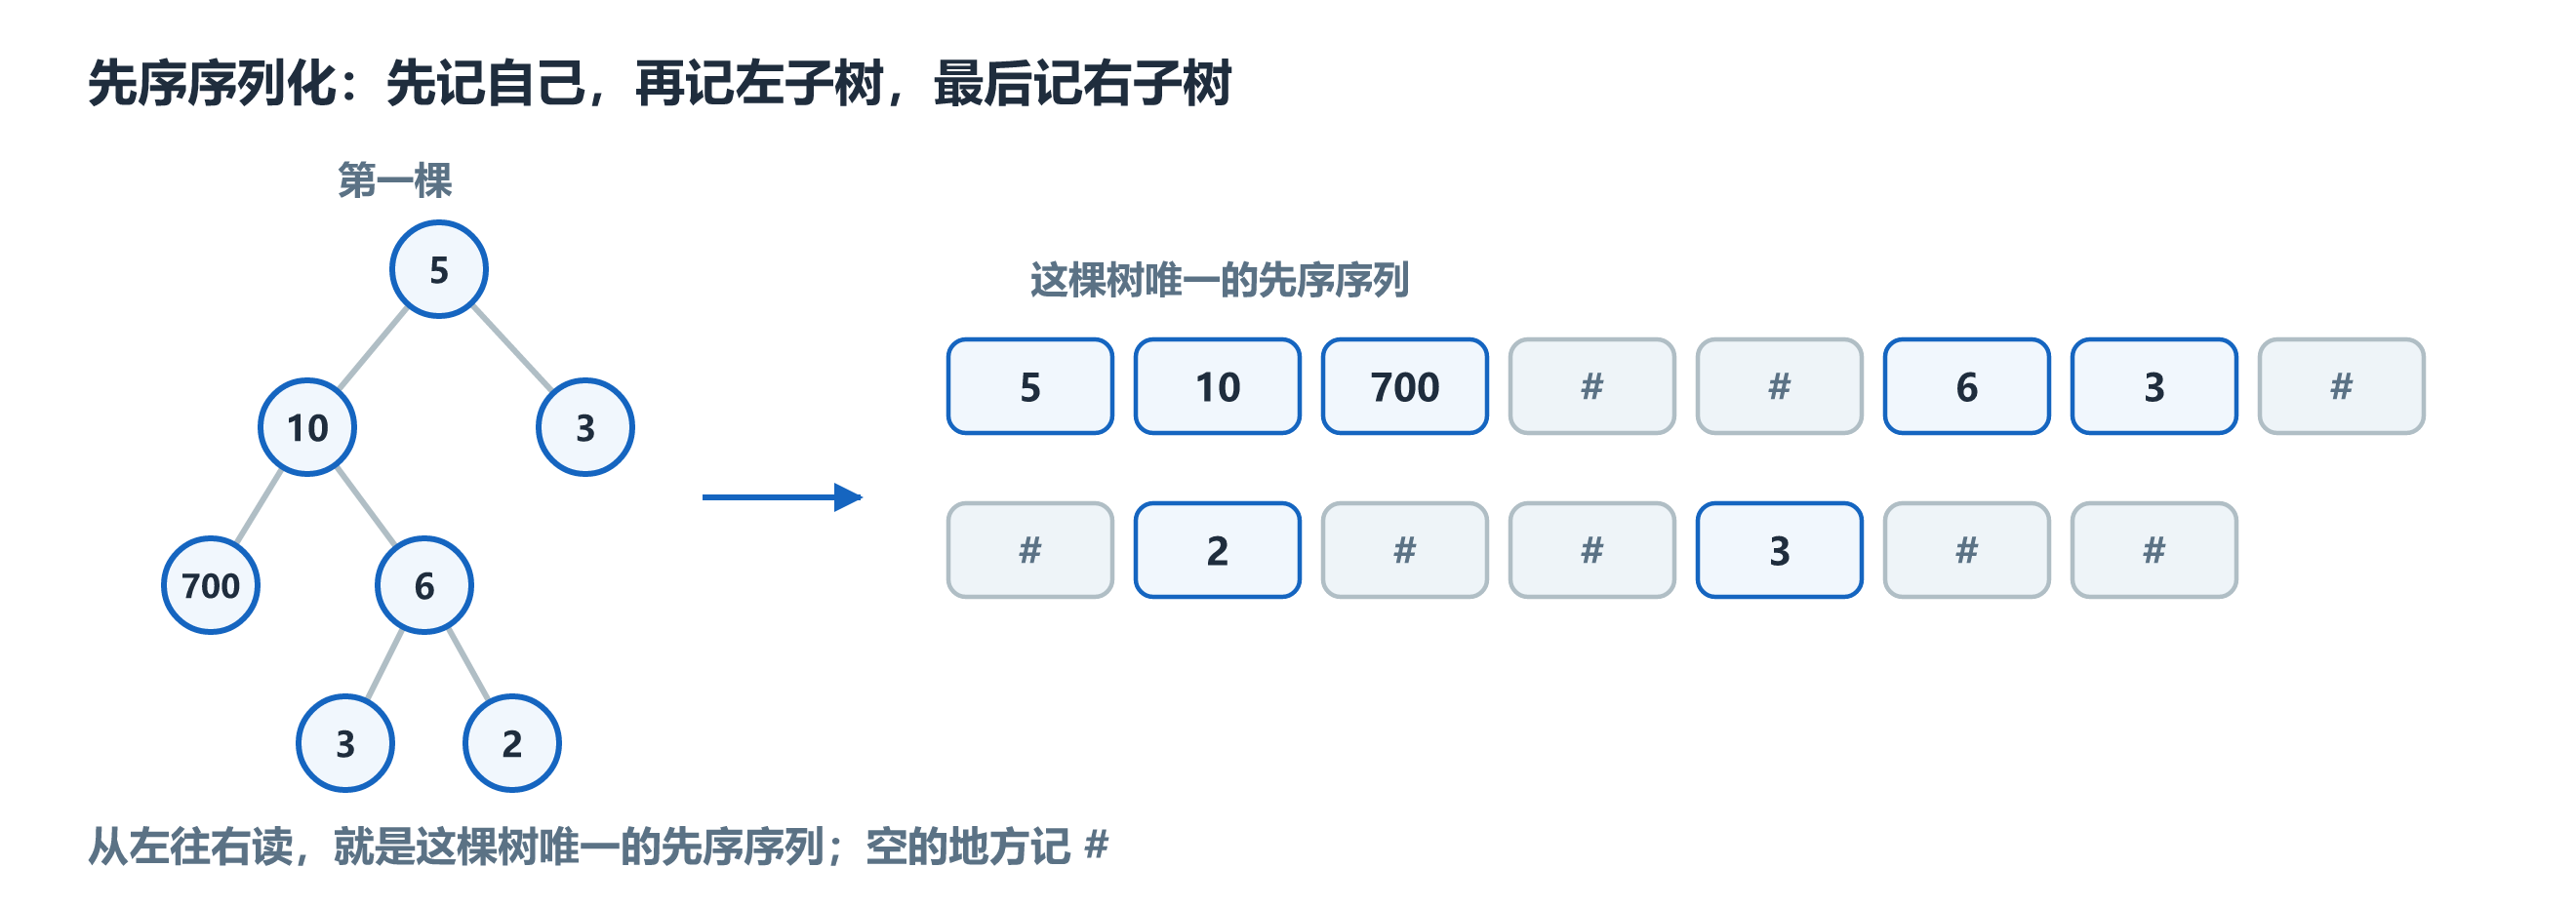
一棵树可以先写成一个序列:
先记自己,再记左子树,最后记右子树。
空的地方也要记一笔,不然结构就丢了。
这个写法就叫先序序列化。
这么记出来的序列是唯一的,把它还原回树,也只会得到原来那一棵。
第一棵写出来是这样:
5, 10, 700, #, #, 6, 3, #, #, 2, #, #, 3, #, #
# 就是空。
把两棵树都这么写一遍,然后拿第二棵的序列去第一棵的序列里找。
找得到,说明第二棵的序列是第一棵序列里连着的一截,第二棵就是第一棵的子树。
找不到就没有。
树上的问题变成了序列上的问题,而序列匹配我们已经有 O(n + m) 的做法了。
第二道题的 Java 代码
这道题 KMP 这一趟和第一道题是同一套走法,变的是比对:
第一道题比的是字符,用 == 就行;
这里比的是序列里的一个个位置,每个位置要么是一个节点的值,要么是一个 #,在代码里都以 String 存着,得用 equals 来比。
class Solution {
    public boolean isSubtree(TreeNode root, TreeNode subRoot) {
        List<String> s1 = new ArrayList<>();
        List<String> s2 = new ArrayList<>();
        serialize(root, s1);
        serialize(subRoot, s2);
        return kmp(s1, s2) != -1;
    }

    // 先序序列化:空节点也要占一位,整棵树才能被还原
    private void serialize(TreeNode node, List<String> out) {
        if (node == null) {
            out.add("#");
            return;
        }
        out.add(String.valueOf(node.val));
        serialize(node.left, out);
        serialize(node.right, out);
    }

    private int kmp(List<String> s1, List<String> s2) {
        int n = s1.size(), m = s2.size();
        int[] next = nextArray(s2, m);
        int x = 0, y = 0;
        while (x < n && y < m) {
            if (s1.get(x).equals(s2.get(y))) {
                x++;
                y++;
            } else if (next[y] == -1) {
                x++;
            } else {
                y = next[y];
            }
        }
        return y == m ? x - m : -1;
    }

    private int[] nextArray(List<String> s, int m) {
        if (m == 1) {
            return new int[] { -1 };
        }
        int[] next = new int[m];
        next[0] = -1;
        next[1] = 0;
        int i = 2, cn = 0;
        while (i < m) {
            if (s.get(i - 1).equals(s.get(cn))) {
                next[i++] = ++cn;
            } else if (cn > 0) {
                cn = next[cn];
            } else {
                next[i++] = 0;
            }
        }
        return next;
    }
}
| 代码 | 大白话 |
|---|---|
serialize | 把一棵树按先序序列化,空的地方记 # |
s1 和 s2 | 两棵树各自的序列 |
kmp(s1, s2) | 在 s1 里找 s2,跟第一道题是同一套做法 |
!= -1 | 找到了,第二棵就是第一棵的子树 |
nextArray | 算 s2 每一位的 next 值,比对用 equals,别的和第一道题一样 |
这几处一不留神就容易写错
needle 长度为 1 时,next[1] = 0 会越界
nextArray 一上来就写了 next[0] = -1 和 next[1] = 0。
needle 长度为 1 的时候没有第 2 位,next[1] = 0 这一行会越界。
所以在最前面加一个判断,长度为 1 直接返回 { -1 }。
next[y] == -1 这个分支不能省
写代码时容易省掉一步,把"能退"和"退不动"合成一个 else。
真合成的话,y 会被赋成 -1,下一轮拿 -1 去访问 S2,越界报错。
退不动的时候,得让 S1 自己往前走一步。
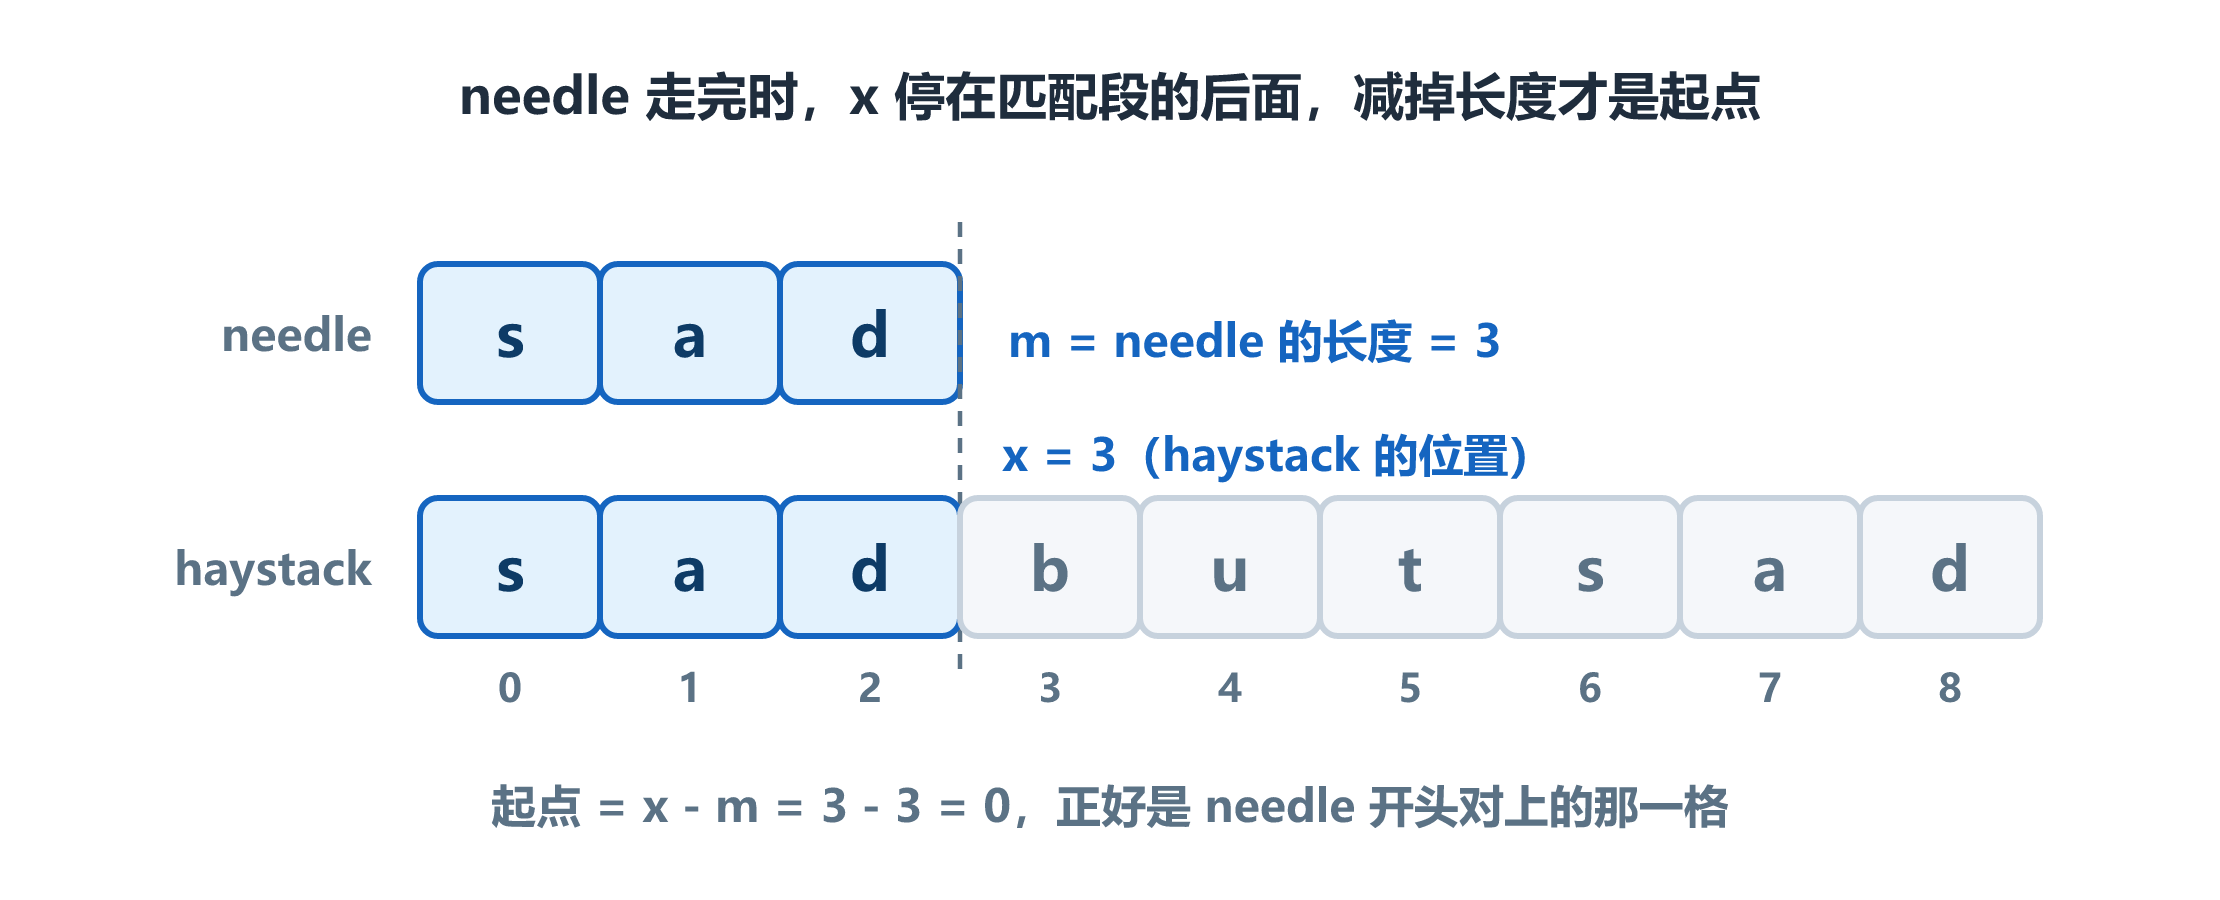
返回的是 x - m
循环停下来的时候,x 停在 S2 整个匹配完之后的位置,也就是起点的后面。
要减掉 S2 的长度,才是题目要的那个起点。
序列化时,空节点一定要占位
第二道题的树如果只记有值的节点,有的树明明不是子树,它的序列却照样能在第一棵的序列里找到。
比如第一棵是 1 左接 2、右接 3,序列是 1, 2, 3。
第二棵是 2 右接 3,序列是 2, 3,正好是第一棵序列里的一截。
按这个找法,答案是"有",可实际上第一棵里的 2 是个叶子节点,下面什么都没有。
把空节点也记进去就不会再误判了:
第一棵变成 1, 2, #, #, 3, #, #,第二棵变成 2, #, 3, #, #,第二棵的序列在第一棵的序列里就找不到了。
序列化时,别把节点值拼成一个大字符串
把每个节点的值直接拼成一整个字符串,相邻两个节点的值会连在一起。
比如 1 和 12 两个节点挨着,拼出来是 112,读回去既可以当成 1 和 12,也可以当成 11 和 2。
所以序列里每个位置都单独存一项,值该转成字符串就转成字符串。
两趟各花多少时间
第一道题两趟加起来 O(n + m):算 next 数组 O(m),匹配 O(n),额外空间就是那个 next 数组,O(m)。
前面试过的朴素匹配,最坏情况是每个起点都要把 needle 从头比一遍,也就是 O(n × m)。
第二道题也是 O(n + m):两棵树各序列化一遍是 O(n) 和 O(m),再跑一趟 KMP 是 O(n + m)。
代价是空间,两个序列都要存下来,O(n + m)。
一个个节点去试的话就是 O(n × m),树的节点一多就慢了。
两道题,一套骨架
两道题一道在字符串上,一道在树上,用的却是同一副骨架:
把要比的换成一个序列,失配了只让 S2 的位置往回退,S1 的位置一路往前走。
第一道题里,这个序列就是两个字符串本身。
第二道题里,这个序列是树先序序列化的结果。
换一种序列,这一套照样管用。

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)