
HarmonyOS 7 + protobuf.js-long.js:跨端遥测 int64 的精度保真与字符串边界【鸿蒙心迹】
一个跨端遥测帧可以正常解码,字段也都能显示,却不代表数据没有变化。只要后端把递增序列、雪花 ID 或纳秒时间戳定义成 int64,ArkTS 业务层又过早把它转换成 JavaScript number,超过安全整数边界后,日志里的“最后几位”就可能悄悄改变。
本文构造 MeterWire 演示项目。固定任务为 WIRE-I64-0068,协议类型 meter.v3,二进制帧 142 B,序列号 9007199254740997。错误路径把它转成 Number 后得到 9007199254740996;正确路径保留 Long 语义,在页面、缓存和 JSON 边界统一输出十进制字符串。演示状态为 BYTES_READY → LONG_DECODED → STRING_NORMALIZED → ROUNDTRIP_OK。文中数据用于说明精度边界,不是线上遥测记录。
一、异常不是解码失败,而是解码得“太顺利”
最难排查的类型问题往往没有异常。protobuf.js 能从字节流中还原消息,页面也能渲染,HiLog 里甚至看不到红色错误。问题只出现在把 64 位整数交给 Number 的那一刻:JavaScript Number 采用双精度浮点表示,能够精确表达的整数范围有上限。超过 Number.MAX_SAFE_INTEGER 后,相邻整数不一定还能区分。
9007199254740997 比安全上限大 6。把它传给 Number,不会抛错,而是舍入成 9007199254740996。两者只差 1,肉眼扫日志很难发现。若它只是排序游标,页面可能重复拉取一条数据;若它是幂等键,服务端会认为请求属于另一个实体;若它是毫秒之外的高精度时间戳,排序也可能发生交换。
MeterWire 不把这类问题描述成“protobuf 精度丢失”。protobuf 的 wire format 可以承载 64 位整数,变化发生在 JavaScript 表示和业务转换边界。定位责任非常重要:否则团队会去替换序列化协议,却保留同样的 Number 转换,问题仍然存在。
二、先把协议中的整数语义写清楚
同样是 64 位字段,int64、uint64、sint64 的线格式和语义不同。业务还要回答它是不是可计算数值。订单 ID、日志序列、游标通常只需要比较相等和传输,不应该参与加减;累计计数可能需要算术;时间戳还涉及单位和时区。只写一个 number id,这些差异会在每个客户端里被重新猜一遍。
MeterWire 的 sequence 使用 uint64,表示单调递增且不为负的帧序列;deviceId 使用 string,因为它是标识而非数值;sampleTimeMs 使用 int64,允许测试数据表达特殊边界;温度使用缩放后的 int32,避免浮点比较噪声。协议字段号一旦发布就不复用,删除字段时保留编号。
这段代码解决什么问题:在 schema 层区分 64 位序列、时间和普通数值,避免所有字段进入 ArkTS 后都被粗暴视为 Number。
syntax = "proto3";
package meter.v3;

message TelemetryFrame {
  string device_id = 1;
  uint64 sequence = 2;
  int64 sample_time_ms = 3;
  int32 temperature_milli_c = 4;
  uint32 sample_count = 5;
  string task_id = 6;
}
这段定义没有承诺 ArkTS 端最终使用哪一种对象类型,只固定 wire 语义。sequence 不能因为当前数据小就临时改成 uint32,也不能为了 UI 方便改成 string 后仍沿用旧字段号。协议升级需要新增字段或版本,让新旧消费者有明确迁移路径。
实际项目还应在 schema 仓库里记录单位、范围、零值语义和是否允许参与算术。例如 sample_time_ms 的单位必须写入注释与文档,不能让一端发送微秒、另一端按毫秒显示。protobuf 能保证字段编码,却不能替团队决定业务含义。
三、long.js 的作用是保留 64 位整数能力
protobuf.js 可以配合 long.js 表示 64 位整数。关键不是“安装了 long.js 就安全”,而是初始化顺序和转换策略。应用必须在加载类型和解码前,把 Long 实现配置给 protobuf.js,再调用 configure();否则不同构建产物可能使用不同的降级表示。
MeterWire 把运行时配置放进单独模块,只初始化一次。业务页面不直接修改 protobuf.util.Long,测试也不在用例之间反复切换配置。这样 TelemetryFrame.decode 返回的 64 位字段始终具有一致形态。
这段代码解决什么问题:在协议类型加载前统一配置 protobuf.js 的 64 位整数实现,并把配置时机从页面生命周期中移出。
import * as protobuf from 'protobufjs'
import Long from 'long'

let configured = false

export function configureWireRuntime(): void {
  if (configured) return
  protobuf.util.Long = Long as unknown as protobuf.Long
  protobuf.configure()
  configured = true
}

export async function loadMeterType(): Promise<protobuf.Type> {
  configureWireRuntime()
  const root = await protobuf.load($rawfile('proto/meter.proto'))
  return root.lookupType('meter.v3.TelemetryFrame')
}
状态在 proto 资源加载完成并收到 142 B 帧后进入 BYTES_READY。容易出错的是把 configureWireRuntime() 写进 aboutToAppear:页面重复进入可能在已有消息对象存在时重配运行时,测试环境也会出现初始化顺序差异。配置应属于应用或模块启动阶段,页面只获取已经准备好的解码服务。
示例中的 $rawfile 表示项目资源定位意图,具体资源读取方式应按当前工程和 SDK 类型声明实现。重点是先得到字节与 schema,再解码;不要把网络 URL、文件读取和类型初始化混在一个页面函数里。
四、对象转换才是最危险的拐点
protobuf.js 解码出的字段可能是 Long 对象。很多代码为了“方便打印”,会写 Number(message.sequence),或者在 toObject 时选择 longs: Number。这一步不会检查安全范围。一旦转换,后面再用 BigInt 包装只能得到已经舍入的值,无法恢复原始 9007199254740997。
MeterWire 的规则是:协议层允许 Long,应用领域层统一使用十进制字符串。字符串适合日志、JSON、RDB 文本列、路由参数和等值比较;需要算术时,在局部函数内显式转成 BigInt,并在返回 UI 前再变回字符串。这样精度决策集中在少数边界,而不是散落在每个组件里。
这段代码解决什么问题:把解码出的 Long 在第一道业务边界规范化为字符串,并阻止不安全整数进入 Number。
interface FrameView {
  deviceId: string
  sequence: string
  sampleTimeMs: string
  temperatureMilliC: number
  sampleCount: number
  taskId: string
}

function decodeFrame(type: protobuf.Type, bytes: Uint8Array): FrameView {
  const message = type.decode(bytes)
  const object = type.toObject(message, {
    longs: String,
    defaults: false
  }) as Record<string, unknown>

  return {
    deviceId: requireText(object.deviceId, 'deviceId'),
    sequence: requireInt64Text(object.sequence, 'sequence'),
    sampleTimeMs: requireInt64Text(object.sampleTimeMs, 'sampleTimeMs'),
    temperatureMilliC: requireSafeInt(object.temperatureMilliC),
    sampleCount: requireSafeInt(object.sampleCount),
    taskId: requireText(object.taskId, 'taskId')
  }
}
longs: String 明确告诉转换层输出十进制文本。状态由 BYTES_READY 进入 LONG_DECODED,字段检查完成后进入 STRING_NORMALIZED。requireInt64Text 还要校验字符串是否为合法十进制整数,不能因为来源是 protobuf 就跳过领域约束;负号、前导零和最大范围是否允许,都由协议规则决定。
页面上显示字符串不影响排序。若序列都非负且长度可能不同,可以用 BigInt 比较;若为了性能实现字符串比较,应先去除规范允许的前导零,再比较长度和字典序。直接按普通字符串排序会把 "100" 排在 "20" 前面。
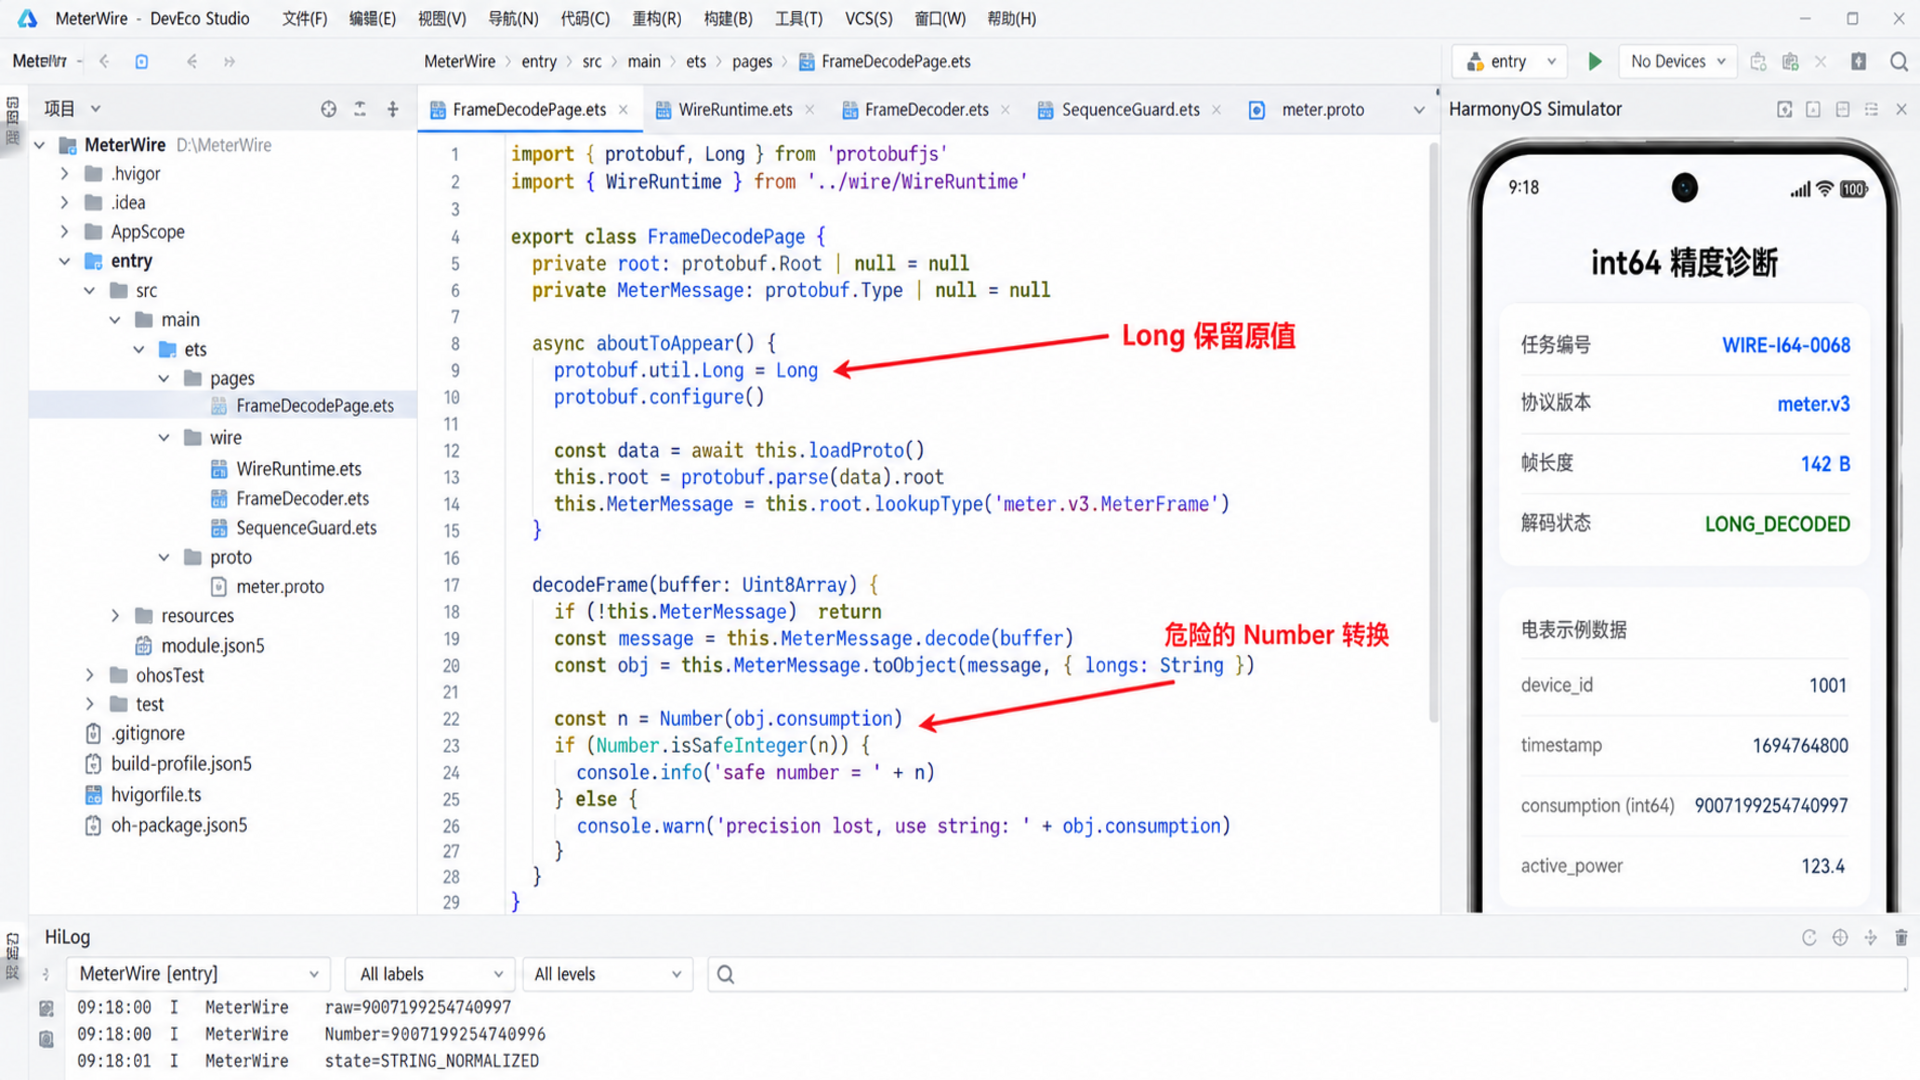
上图是与本文口径一致的 DevEco Studio 风格演示配图,不是真实 IDE 截图或性能证据。右侧模拟器展示 WIRE-I64-0068、142 B 和 LONG_DECODED,底部 HiLog 同时输出原始字符串和错误 Number 结果,红色标注只用于说明转换边界。
五、BigInt 适合计算,不适合直接穿过所有边界
看到 Number 不安全后,另一种极端是把所有 64 位字段都改成 BigInt。计算层这样做没有问题,但 BigInt 不能直接被标准 JSON.stringify 序列化。若 ViewModel、持久化层、日志上报或路由参数默认走 JSON,就会出现运行时异常,或者有人临时加 replacer,把行为藏在全局工具中。
MeterWire 只在校验窗口内使用 BigInt。序列连续性检查把当前与上一帧字符串转换为 BigInt,完成差值计算后输出普通 number 的有限结果或字符串。对象对外仍保持稳定的 FrameView 契约。
这段代码解决什么问题:在需要算术时局部使用 BigInt,同时保证 JSON、状态管理和日志边界继续使用可移植字符串。
function verifySequence(previous: string, current: string): string {
  const prev = BigInt(previous)
  const next = BigInt(current)
  if (next <= prev) throw new Error('SEQUENCE_NOT_INCREASING')

  const gap = next - prev
  if (gap > 10_000n) throw new Error('SEQUENCE_GAP_TOO_LARGE')
  return gap.toString()
}

function toAuditJson(frame: FrameView): string {
  return JSON.stringify({
    taskId: frame.taskId,
    sequence: frame.sequence,
    sampleTimeMs: frame.sampleTimeMs,
    sampleCount: frame.sampleCount
  })
}
这里不会把 BigInt 放进 FrameView,因此 toAuditJson 不需要自定义 replacer。状态变化也更清楚:解码后是字符串事实,连续性检查只是一个验证动作,不改变原值。实际项目若决定领域层统一 BigInt,也可以,但必须在所有序列化、数据库、IPC 和 UI 边界上建立同一套显式转换,不能只改一个接口。
六、运行页应把“正确值”和“危险转换”并排展示
MeterWire 的运行页不是一般遥测大屏,而是一张精度诊断卡。顶部显示任务 WIRE-I64-0068、协议 meter.v3、帧长 142 B,核心区域显示 Long 规范值 9007199254740997,旁边用红色说明标出 Number 结果 9007199254740996。当前状态为 STRING_NORMALIZED,进度 78%。
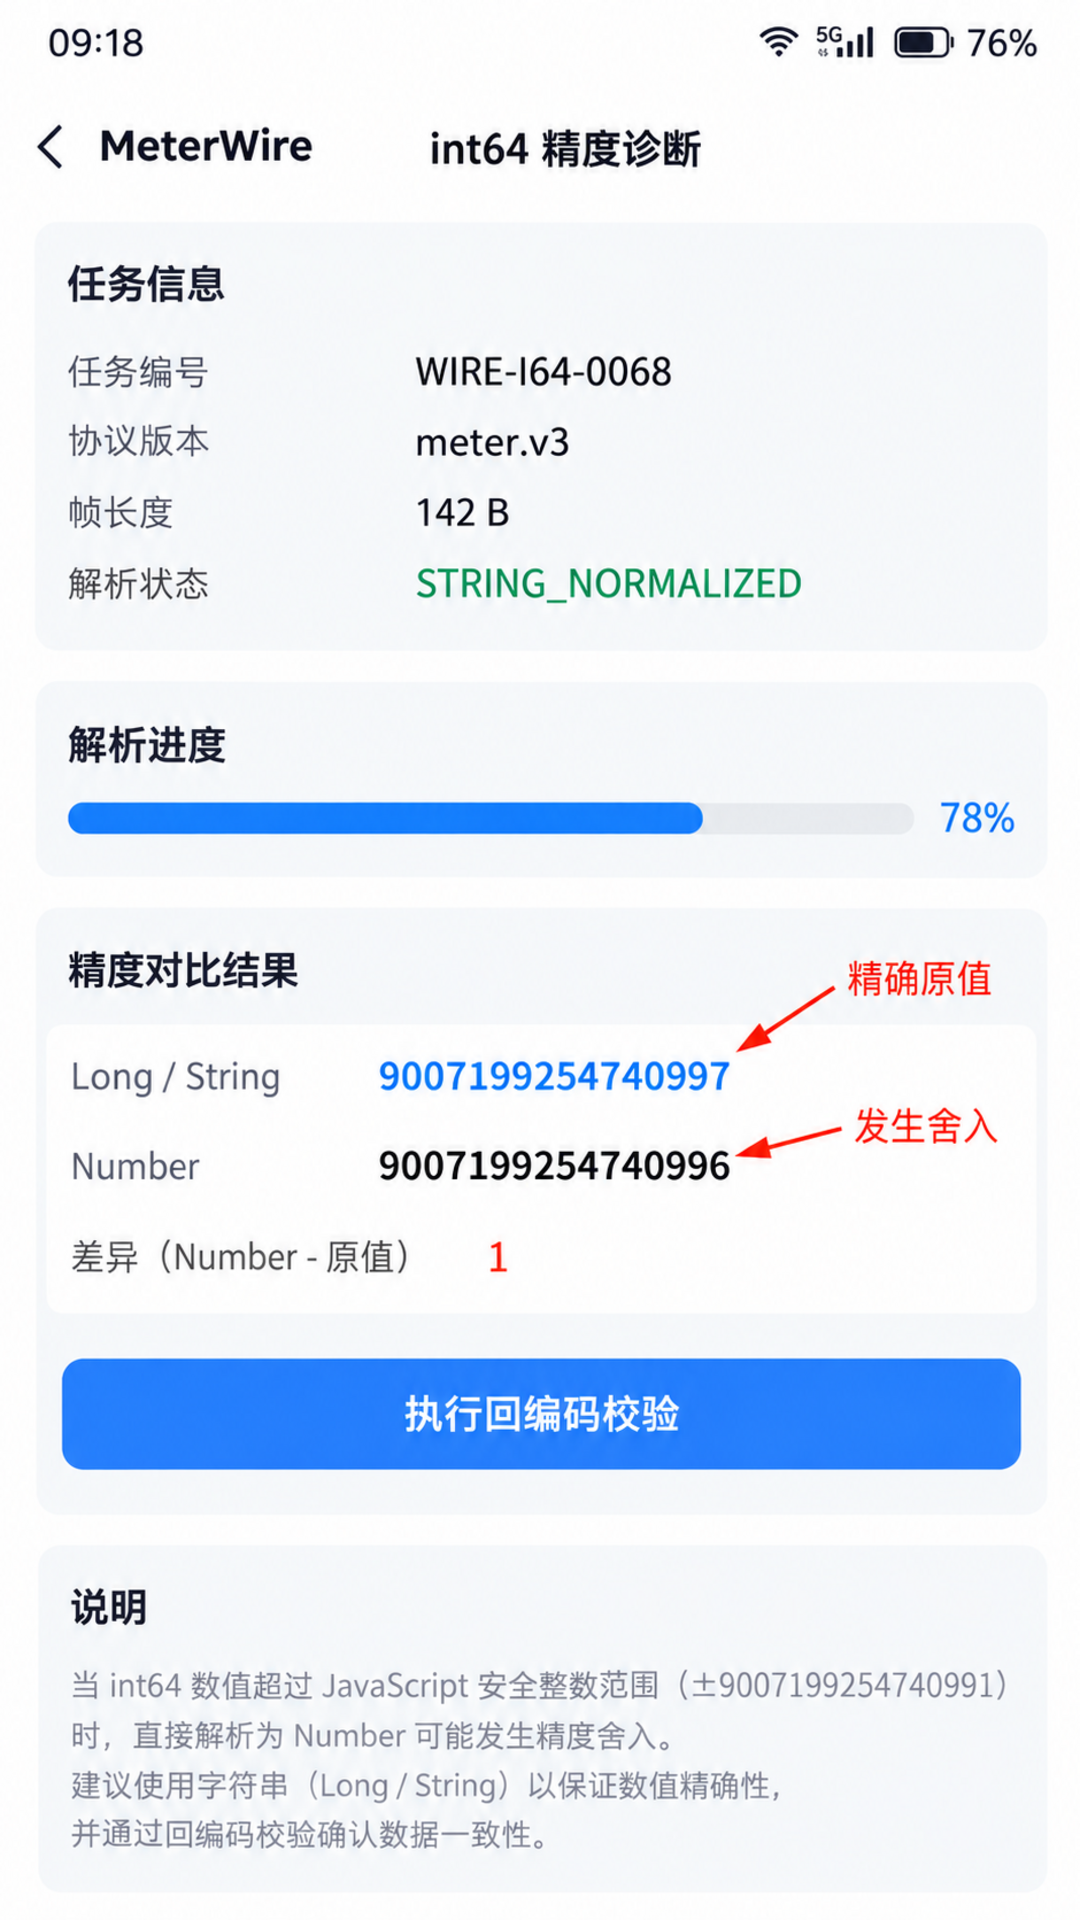
这组对照能避免“只是格式不同”的误解。两个十进制值真实不同,差值为 1。按钮“执行回编码校验”不会把页面字符串直接拼成字节,而是用同一 schema 调用 fromObject 和 encode,随后再次解码,验证值在往返过程中保持一致。
状态栏固定为 09:18、Wi-Fi、5G、76% 电量,只是本批演示界面的统一视觉数据,不表示真实设备或真实网络。正文、日志和图片都使用同一时刻,便于交付检查。
七、往返校验需要比较业务事实,不只比较字节
同一个 protobuf 消息可能因为字段顺序或默认值处理得到不同但语义等价的字节,因此回归测试不应只依赖整个缓冲区完全相等。MeterWire 的门禁先对黄金字节解码,检查 sequence 字符串,再从规范对象编码并重新解码,最后比较关键业务字段。
诊断样本固定为:安全边界内 9007199254740991、边界外 9007199254740997、接近 uint64 上限的文本值,以及零值。每个向量记录 schema 摘要和期望字符串。若某次依赖升级改变了 Long 配置或 toObject 选项,测试会在发布前暴露。
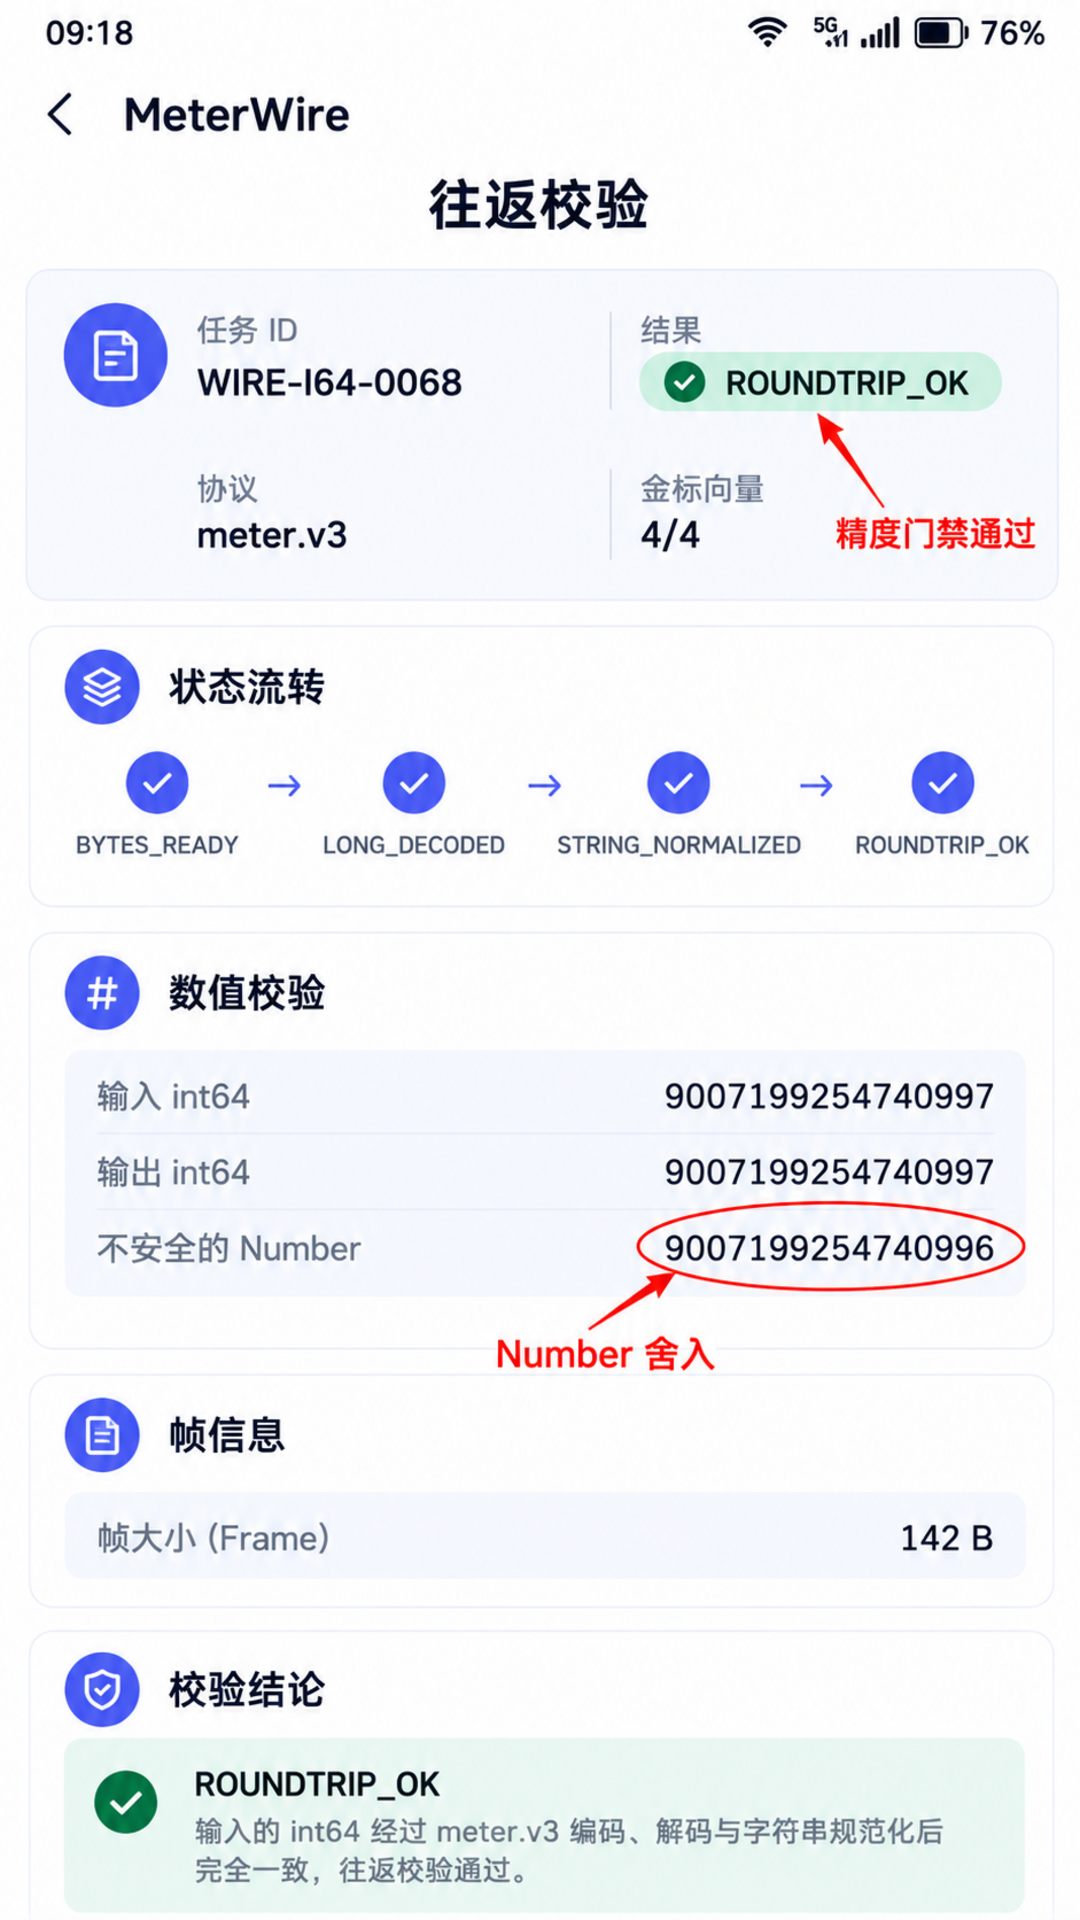
诊断页显示完整状态链,黄金向量 4/4 通过,回编码后仍为 9007199254740997,最终状态 ROUNDTRIP_OK。红圈标记 Number 舍入结果和最终门禁,说明页面不是在庆祝“能 decode”,而是在证明精度没有跨边界丢失。
八、缓存、数据库与日志都要接受字符串契约
解决解码层还不够。若 RDB 列定义为数值并由 ArkTS Number 绑定,写入时仍会舍入。序列号不参与数据库算术时,文本列更直接;需要范围查询时,可以拆出固定宽度文本、二进制表示或数据库支持的整数类型,并在适配层验证。选择哪种方案取决于当前数据库 API 与查询需求。
日志系统也要避免自动类型推断。sequence=%{public}s 表达的是已脱敏可公开的字符串;若序列具有业务敏感性,应使用 private 或哈希。不要同时打印完整设备 ID 和高精度时间戳,让多条非敏感字段组合成可识别轨迹。
路由参数、Preferences 和网络 JSON 都遵循同一原则:写入字符串,读取后验证。任何模块若要求 Number,都必须在接口文档里声明只接受安全整数,并在调用前使用 Number.isSafeInteger。把异常尽早变成 UNSAFE_NUMBER_BOUNDARY,比让错误值进入业务更容易定位。
九、依赖升级要检查行为,不只检查版本号
protobuf.js 和 long.js 是三方运行时,升级时要检查 API、生成代码、Tree Shaking 和包体积,更要检查 Long 实现是否仍被打入产物。某些构建优化会移除看似没有直接引用的初始化模块;如果配置只靠副作用导入,release 包与 debug 包可能行为不同。
建议让解码服务显式调用 configureWireRuntime(),并在启动自检中解码一个超安全整数向量。自检失败时关闭遥测提交而不是回退 Number。依赖锁文件、schema 摘要和黄金向量一起进入发布记录,出现问题时才能判断是协议变更、三方库升级还是业务转换改动。
许可证与供应链检查仍然必要,但不应替代行为测试。一个依赖许可证合规,不代表它的默认转换选项符合当前业务。本文只使用上游公开 API,不假设某个 HarmonyOS SDK 内置 protobuf.js;项目应通过实际可用的包管理与编译环境验证兼容性。
十、精度策略要从协议一直延伸到界面
MeterWire 的结论不是“int64 一律转字符串”,而是标识型 64 位整数不应无条件进入 Number。wire 层保留 int64/uint64 语义,protobuf.js 与 long.js 保留精确值,领域层选择字符串,局部计算使用 BigInt,外部边界再次回到字符串。每一步都有明确理由和可测试结果。
最终样本从 142 B 字节进入 LONG_DECODED,规范值保持 9007199254740997;危险转换稳定暴露为 9007199254740996;四组黄金向量通过,状态进入 ROUNDTRIP_OK。这是一条可解释的演示链,不是对所有后端语言、所有 protobuf 生成器的泛化结论。
上线前至少确认:schema 是否写清整数语义与单位;运行时配置是否早于首次解码;业务对象是否避免不安全 Number;BigInt 是否被限制在可控计算边界;缓存、数据库、日志和 JSON 是否遵守同一表示;release 构建是否执行超安全整数自检。只要其中一层偷偷“为了方便”转回 Number,前面的精度工作就会失效。
1. 不是所有整数都要用同一种表示
字段表示应按用途决定。温度毫摄氏度的合理范围远小于安全整数,继续使用 number 最简单;帧序列只做等值、排序和透传,字符串更稳定;两个序列之间需要计算差值时,BigInt 只在函数内部出现;若原生算法要消费 64 位整数,则在 C++ 边界使用明确的 uint64_t,并用十进制字符串或高低位结构跨 JS 侧传递。把所有字段统一成字符串会增加普通计算成本,把所有字段统一成 Number 则会隐藏边界风险。
接口命名也要提示语义。sequenceText 比 sequence 更能提醒调用者不要随手做减法;temperatureMilliC 比 temperature 更能说明单位。类型系统无法阻止所有错误,但可以让代码审查更容易发现可疑转换。
2. 有符号与无符号范围必须分别校验
Long 对象不仅保存数值,还携带 unsigned 语义。若将 uint64 当成有符号十进制处理,超过 2^63-1 后可能出现负数解释。MeterWire 的领域校验不只检查“是不是数字字符串”,还根据 schema 元数据检查是否允许负号和最大长度。sampleTimeMs 可以为有符号值,sequence 则必须非负。
跨语言时还要核对后端生成器的 JSON 映射。有的系统把 64 位整数输出为字符串,有的中间网关会重新解析 JSON 并改成 Number。测试必须覆盖完整链路,而不是只在 HarmonyOS 客户端本地 encode/decode。网关若无法保真,就应修复网关契约,不要让客户端猜测丢失前的原值。
3. 错误分层能避免把数据问题当网络问题
建议把异常分为四类:字节不可解码 WIRE_DECODE_FAILED,字段缺失或范围不符 WIRE_SCHEMA_INVALID,出现不安全 Number UNSAFE_NUMBER_BOUNDARY,往返值改变 ROUNDTRIP_MISMATCH。网络层只负责接收 142 B 帧,不要把后面三类统一映射成“请求失败”。
页面诊断时记录 taskId、schema、字段名和错误码,避免输出完整设备标识与原始帧。发生 UNSAFE_NUMBER_BOUNDARY 时可以记录 Number.isSafeInteger=false 和位数,不必打印实际业务 ID。错误分层越稳定,依赖升级后越容易判断变化来自 wire、转换还是领域规则。
4. 黄金向量要覆盖编码之外的业务边界
四组向量只是最小集合。实际项目还应加入负数、零、2^53-1、2^53、2^63-1、uint64 上限附近值、缺字段和错误 wire type。每个向量保存十六进制字节、期望字符串、是否 unsigned 和预期错误码。若样例只由当前 protobuf.js 自己生成再自己解码,可能同时继承同一个错误;至少准备一组由后端正式生成器产生的交叉语言向量。
回归测试还要分别运行 debug 与 release 产物。Tree Shaking、压缩和模块初始化顺序通常只在 release 暴露。测试页面可以在内部构建中显示 4/4 或更多向量结果,但正式用户界面无需保留这套入口。
5. 流式处理要限制对象和缓冲区生命周期
遥测流量持续到达时,不能为每帧永久保存 Long 对象和原始 bytes。解码服务收到字节后立即构造规范 FrameView,完成必要验证,再释放对输入缓冲区与 message 的引用。列表页面只保留当前窗口需要的字符串字段和聚合统计,历史帧按批写入存储。
页面离开时取消订阅,解码服务自身可以继续为后台业务工作,但旧页面不能接收新结果。若重新进入页面创建第二个订阅而没有释放第一个,日志会重复、序列连续性也会被计算两次。类型精度正确之后,生命周期仍然要单独验收。
6. 评审时寻找“看起来无害”的转换
代码审查可以重点搜索 Number(、一元加号、parseInt、模板外的隐式算术、longs: Number 和数据库数值绑定。并非这些写法都错误,但它们出现在 int64 字段附近时必须解释安全范围。相反,看到 toString() 也要确认基数为十进制、unsigned 语义正确,而且没有在更早的位置已经发生 Number 舍入。
最终发布记录应包含 protobuf.js 与 long.js 锁定版本、schema 摘要、黄金向量结果和 release 自检结果。这样半年后出现序列跳跃,不必从“是不是网络丢包”重新猜起,可以直接沿表示边界逐层排查。
团队还应约定接口评审模板:每个新增 64 位字段都回答“它是标识还是数值、是否允许负数、是否需要算术、如何进入 JSON、如何落库、如何显示”。这几个问题在 proto 合并时解决,成本远低于数据进入多个客户端后再补救。若回答尚不确定,就先保持精确字符串并限制功能范围,不要用 Number 抢跑。
此外,监控指标应分别统计解码失败、边界拦截和往返不一致,不能合并成一个失败率。三者的责任层不同:解码失败通常指向协议或字节,边界拦截说明调用方尝试了危险转换,往返不一致才表示值在链路中改变。告警维度清楚,排查才不会在网络、依赖和业务代码之间来回摇摆。
参考资料:

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)