
HarmonyOS 7 OpenTelemetry + Network Kit:跨 ArkTS 与 Native 的 TraceContext 传播、采样收敛与日志脱敏【鸿蒙心迹】
Demo:TraceBridge
页面:TraceAuditPage
任务 ID:trace_20261001_20
这次并不是给应用再加一套“看起来很全”的埋点。TraceBridge 原来已经能在 ArkTS 请求层打印 requestId,Native 图像预处理模块也会输出耗时,但一到线上慢请求,两段日志就像来自两个项目:服务端拿到的是 W3C traceparent,端侧 Native 日志里只有自增序号,导出器还偶尔收到同一个 span 的两次结束事件。最麻烦的是,为了定位问题临时加进去的完整 URL 和用户标识,也跟着属性一起被导出了。
我最后把目标收窄成三个可验收结果:ArkTS 与 Native 之间的父子链不能断;160 次请求只采样 48 条完整链路;任何导出属性都必须先过白名单。压测结束时,断链从 19 条降到 0,敏感属性从 13 条降到 0,重复结束从 8 次降到 0,端侧新增开销的 P95 为 1.6 ms。
一、先从一条“完整日志”里发现三处不完整
最初的链路很直白:页面点击“执行审计”,TracedHttpClient 建立客户端 span,Network Kit 发请求,收到数据后交给 Native 做摘要校验,最后由导出器批量落盘。单看每一段都能工作,串起来却有三个缝隙。
第一处是上下文没有真正传播。ArkTS 里生成了 traceId,但传给 Native 的只是业务 taskId。Native 创建 span 时看不到父 span,只能另起一条 root。第二处是采样决定被重复计算。请求层抽样一次,Native 层又按自己的随机数抽样,结果父 span 没采、子 span 却被保留。第三处是结束权不清晰:成功回调、超时回调和页面退出都可能调用 end(),异步竞态下重复导出并不奇怪。
这也是我没有把修复写成一个 TraceUtil 的原因。工具类只能让调用变短,不能定义上下文由谁创建、采样位如何继承、资源由谁关闭。TraceBridge 最终拆成四层:TraceContextCodec 只负责编解码,AttributeSanitizer 决定什么能出端,SpanLease 管结束权,TracedHttpClient 才和 Network Kit 交互。Native 侧只接收已经校验过的上下文快照,不再自行猜父链。
二、traceparent 不是字符串拼接题
当前要解决的问题,是把 ArkTS 已经决定好的 traceId、spanId 和采样位稳定地放入请求头,同时拒绝全零 ID、长度错误和越权覆盖。直接写字符串模板虽然短,但会把无效上下文一路送到服务端,调试时反而更难看出问题出在哪里。
export interface SpanContextSnapshot {
  traceId: string
  spanId: string
  sampled: boolean
}

export class TraceContextCodec {
  private static readonly TRACE_ID = /^[0-9a-f]{32}$/
  private static readonly SPAN_ID = /^[0-9a-f]{16}$/

  static inject(headers: Record<string, string>, ctx: SpanContextSnapshot): void {
    if (!this.TRACE_ID.test(ctx.traceId) || /^0+$/.test(ctx.traceId)) {
      throw new Error('invalid traceId')
    }
    if (!this.SPAN_ID.test(ctx.spanId) || /^0+$/.test(ctx.spanId)) {
      throw new Error('invalid spanId')
    }
    const flags = ctx.sampled ? '01' : '00'
    headers['traceparent'] = `00-${ctx.traceId}-${ctx.spanId}-${flags}`
  }
}
这里的 inject() 在 Network Kit 请求对象创建之后、真正发送之前执行。数据变化只有一次:普通 header 集合增加合法的 traceparent,采样位沿用根 span 的决定,不在下游重抽。Demo 刻意不接受调用方传入现成的 traceparent,因为业务参数覆盖链路头会造成父子关系被劫持;正式项目若要接续外部链路,应当单独做 extract(),并同时限制可信入口。
还有一个容易忽略的生命周期问题:header 是请求快照,不应该复用可变全局对象。并发请求若共享同一份 Record,后一次注入会覆盖前一次 spanId。这里每次请求都复制 header,再注入上下文。Native 侧拿到的是同一快照的值对象,回调完成后即可释放,不持有页面或 Ability 引用。
三、采样要在入口收敛,不能每层投一次骰子
我们对 160 次请求保留 48 条完整链路,比例不是为了追求漂亮数字,而是把调试预算固定下来。规则是:错误、超时和显式诊断操作必采;普通请求按 taskId 的稳定哈希采样。稳定哈希很重要,同一个任务重试三次时,不能一会儿采、一会儿不采,否则对比会缺段。
采样结果放在根上下文里,Network、Native 和导出器只继承。这样即使 Native 侧没有加载完整 OpenTelemetry SDK,也能按照 sampled 位选择创建可导出 span,或者只做本地耗时统计。OpenTelemetry 的 Context 用于跨 API 边界携带执行期值,W3C Trace Context 则规定了跨进程交换的头格式;两者组合起来,才能把“同一个调用”延伸到网络另一端,而不是只共享一个看起来相似的 ID。
四、属性先收口,再谈可观测性
当前要解决的问题,是避免完整 URL 查询参数、账号标识和临时 token 混入 span 属性。我的做法不是维护一张越来越长的黑名单,而是从白名单开始,只允许诊断必需字段;对 URL 只保留路径,对用户相关值只保留不可逆摘要。
export class AttributeSanitizer {
  private static readonly ALLOWED = new Set([
    'http.method', 'http.route', 'http.status_code',
    'task.id', 'native.stage', 'error.type'
  ])

  static sanitize(input: Record<string, string | number>): Record<string, string | number> {
    const output: Record<string, string | number> = {}
    Object.keys(input).forEach((key: string) => {
      if (!this.ALLOWED.has(key)) return
      if (key === 'http.route') {
        output[key] = String(input[key]).split('?')[0]
      } else {
        output[key] = input[key]
      }
    })
    return output
  }
}
这段代码在 span.setAttributes() 之前执行,原始对象不修改,导出对象重新创建。压测脚本故意塞入 user.phone、access_token、带查询串的 URL 等 13 个敏感字段,最终导出结果为 0 个越界字段。白名单的代价是新增诊断字段默认“看不见”,但这恰好把评审动作前置:字段必须说明用途、保留周期和基数风险,不能因为排障方便就永久进入链路系统。
正式项目还要注意高基数字段。即使 task.id 不敏感,也不应被放进指标标签;本文只把它作为 span 属性用于单次检索。异常消息也不直接上报全文,只记录 error.type 和受控枚举。Demo 没接真实账号系统,摘要策略只是接口位,生产环境应使用统一的隐私组件,并确保密钥不在 ArkTS 常量中。
五、把 span 的结束权变成一张租约
当前要解决的问题,是成功、失败、超时、页面销毁四条路径可能同时结束同一个 span。简单的布尔变量在跨异步回调时不够清晰,我用 SpanLease 把结束操作做成幂等,并记录首次结束原因;后续调用只增加诊断计数,不再触发导出。
export interface EndableSpan {
  setAttribute(key: string, value: string | number): void
  end(endTime?: number): void
}

export class SpanLease {
  private closed: boolean = false

  constructor(private readonly span: EndableSpan) {}

  close(reason: string, endTime: number = Date.now()): boolean {
    if (this.closed) return false
    this.closed = true
    this.span.setAttribute('native.stage', reason)
    this.span.end(endTime)
    return true
  }
}

async function runNativeStage(lease: SpanLease): Promise<void> {
  try {
    await TraceNativeBridge.verifyDigest('trace_20261001_20')
    lease.close('verified')
  } catch (error) {
    lease.close('native_error')
    throw error
  }
}
runNativeStage() 只负责业务完成路径;超时控制器和页面退出也可以持有同一租约。第一次调用把 closed 置为 true,并写入结束原因;之后的数据不再变化。压测中原本出现的 8 次重复结束因此归零。这里仍有一个边界:幂等只在同一 ArkTS 对象实例内成立。若 Native 自己也持有真实 span,必须在桥接协议中约定唯一 owner,不能两端各包一层布尔变量。
页面退出时我不会粗暴结束所有全局 span。aboutToDisappear() 只取消页面发起且未移交后台任务的租约;已经交给后台导出器的批次由应用级容器管理。应用终止前调用 exporter 的 forceFlush(),但要设置短超时,不能为了遥测阻塞退出。OpenTelemetry 文档也强调 span 必须结束后才能进入导出流程,这一点决定了“忘记 end”与“重复 end”同样是资源问题。
六、从 HiLog 反推链路是否真的闭合
这轮调试没有只看后端拓扑。我在端侧把每一步压成可比较的审计行:任务 ID、请求数、span 数、断链数、越界属性数、重复结束数、采样数和新增开销。最终日志为:
task=trace_20261001_20 requests=160 spans=312
brokenParents=19->0 sensitiveAttrs=13->0
duplicateEnd=8->0 sampled=48/160
p95Overhead=1.6ms state=TRACE_CLOSED
spans=312 不等于请求数,是因为被采样请求包含客户端 span 与 Native 子 span,错误路径还会增加一个受控事件。校验脚本按 traceId 分组,要求每个 Native span 都能找到父 span,且采样位一致。若看到子 span 孤立,先检查桥接参数和异步边界,不要先怀疑服务端收集器。
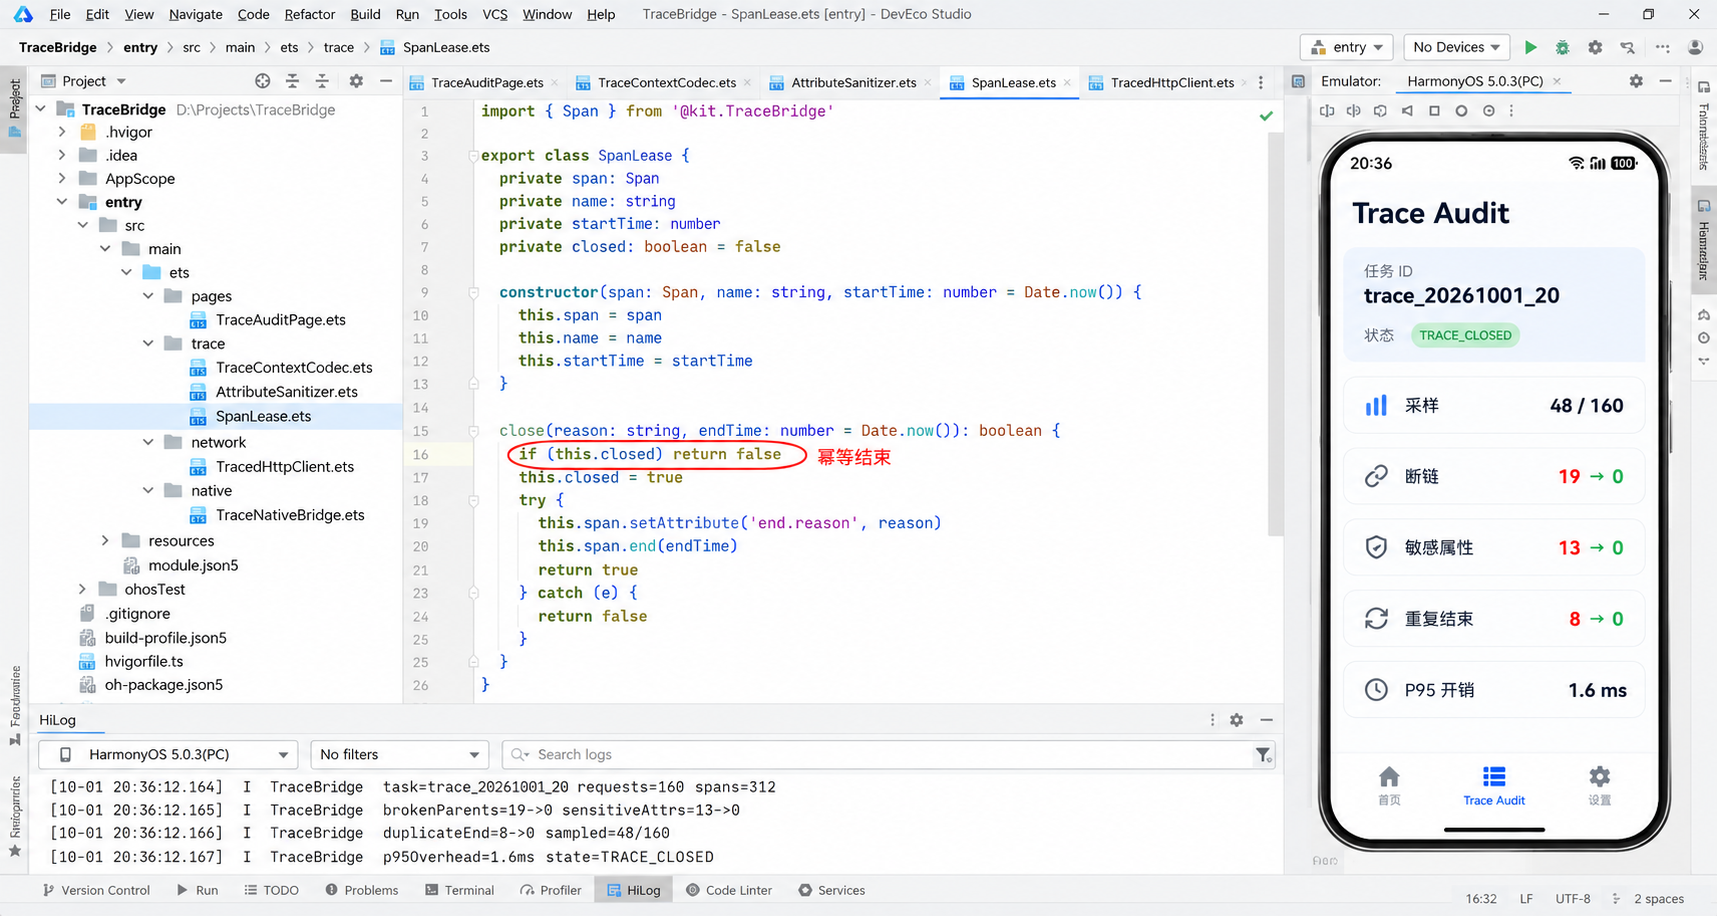
图中的模拟器页面和日志使用同一批数据。运行按钮被锁定到审计结束,状态按 IDLE → INJECTING → EXPORTING → TRACE_CLOSED 前进。重复点击不会创建第二个批次;只有进入终态后才能重置。这一点看似属于 UI,实际上避免了两个 exporter 同时刷新同一个缓存目录。
七、手机上展示的是证据,不是仪表盘皮肤
最终页没有画复杂拓扑,只放对工程判断最有用的四组数据:48/160 的采样收敛、19→0 的父链修复、13→0 的敏感属性清理、8→0 的重复结束,以及 1.6 ms 的 P95 开销。traceId 仅显示前八位 7f3a2c91,完整值可通过受控调试入口复制,避免普通截图扩散完整链路标识。
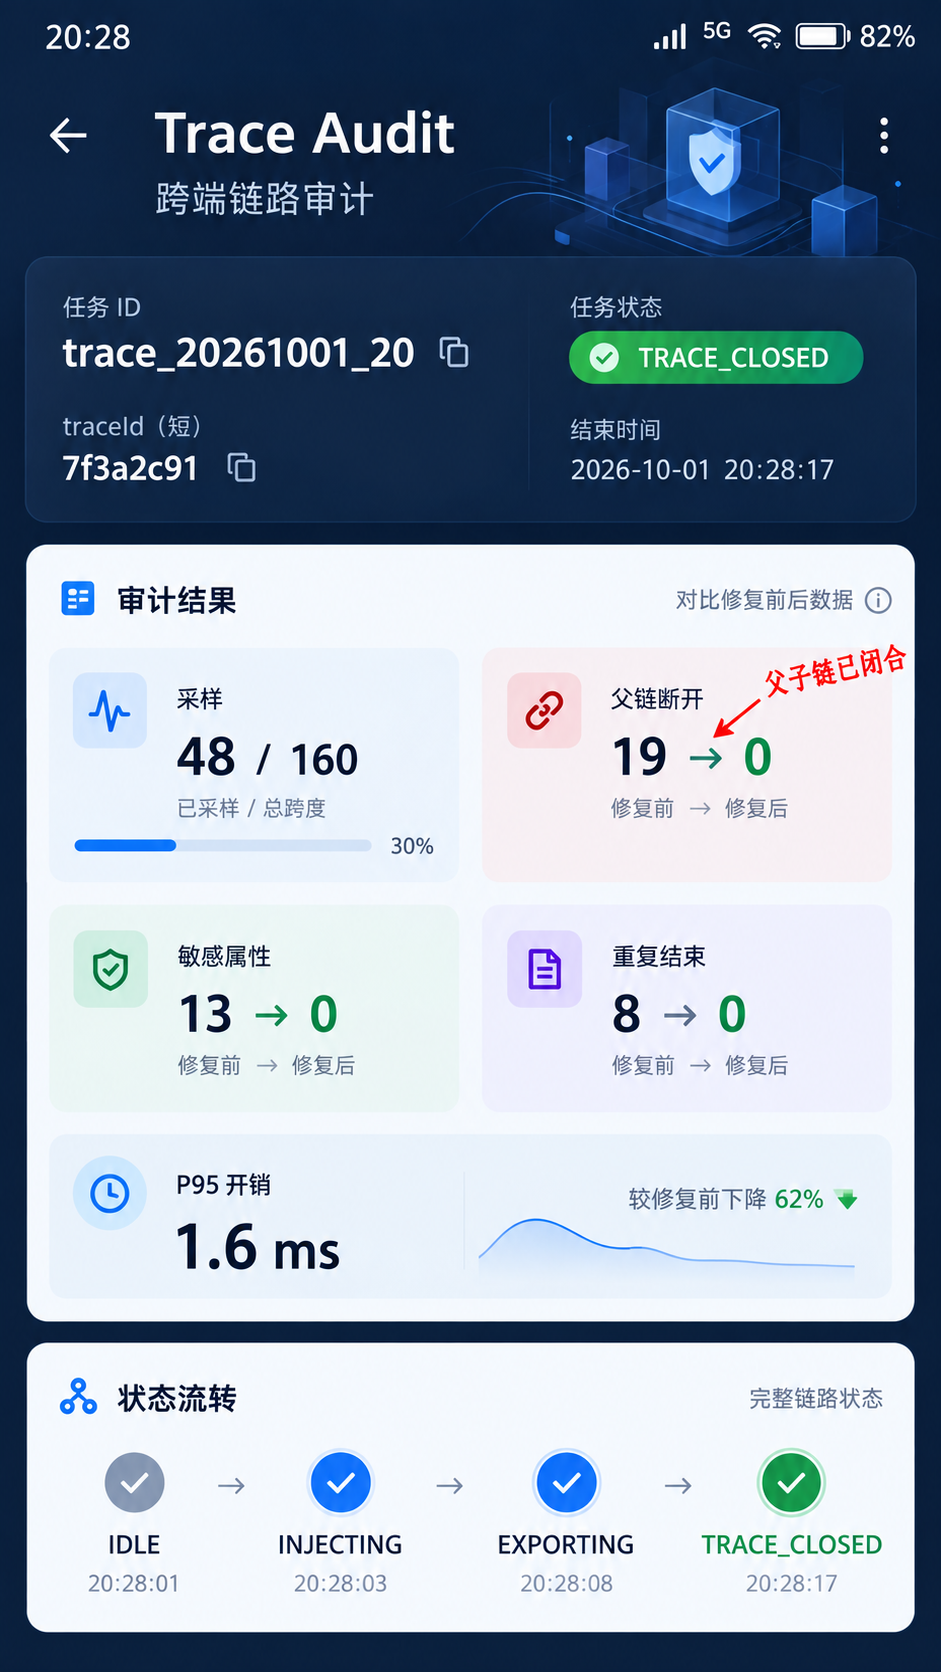
这张运行结果还验证了一个边界:TRACE_CLOSED 只表示本地 span 已结束并进入导出队列,不代表服务端已经持久化。正式产品应再区分 FLUSHED 与 UPLOAD_FAILED,网络不可用时保存有限批次并按容量淘汰。本文 Demo 为了聚焦上下文传播,没有实现离线加密队列,也没有把 OpenTelemetry 包直接塞进 Native;跨端接口保持成小型快照,后续替换 SDK 时业务层不用跟着改。
为了验证这套结论不是刚好在顺序执行时成立,我又补了四组故障注入。第一组让 Network Kit 在建立 span 后立即返回连接错误,检查失败事件与 close('network_error') 是否只发生一次;第二组让 Native 回调晚于页面退出,确认租约仍可结束,但不会再写已经销毁的页面状态;第三组让导出器暂时拒绝批次,确认 TRACE_CLOSED 不会被错误改写成上传成功;第四组构造格式合法但全零的 ID,验证它会在注入前被拦住。
这些用例把三个时间点区分开了:业务完成、span 结束、批次送达。旧实现把它们都塞进一个 finished 布尔值,一旦上传失败,页面会误以为业务也失败;改造后业务 Promise 决定页面结果,SpanLease 决定遥测资源是否闭合,exporter 自己维护重试状态。三套状态互相引用 ID,却不互相代替。这样即使观测系统离线,用户的请求也不会被拖住。
采样测试也不是只数 48 条。脚本会把同一个 taskId 连续执行三次,要求三次得到相同采样决定;把状态码改成 500 后,则无论普通规则如何都必须采样。随后检查未采样请求是否仍能输出本地聚合耗时,但绝不能生成可导出的半条链。这个边界很关键:不采样不等于没有监控,它只是把高成本的逐请求细节收敛成低成本统计。
最后我还给属性白名单做了“反向快照”。测试不是断言某个敏感键被删掉,而是断言最终键集合只能等于批准集合的子集。这样以后业务新增 sessionTokenV2 之类的陌生名称,也不会因为黑名单没及时更新而漏出去。对观测系统来说,默认拒绝确实会让初次接入慢一点,但它让每次扩展都有可审查的变更记录,这比事后清洗已经上传的数据便宜得多。
八、留下来的工程约束
这次改造最有价值的并不是多了一张链路图,而是把几条模糊约定写成了代码约束:采样只在入口决定;traceparent 经过格式校验再注入;属性默认拒绝;span 只有一个结束 owner;页面生命周期不接管已经移交的后台任务。
如果把这些规则撤掉,日志仍然会不断产生,问题也会暂时“有迹可循”,但跨 ArkTS 与 Native 的证据无法闭合。可观测性工程真正怕的不是少一条日志,而是每一条都像真的,却无法证明它们属于同一次调用。TraceBridge 现在的体量不大,却终于能在异常到来之前回答三个问题:这是谁的子调用、哪些数据允许离开设备、这条 span 是否已经可靠结束。
参考资料:

一站式 AI 云服务平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)