
重温 KMP:尝试拆解这套字符串匹配算法
引言 我前后一共三次接触KMP算法。第一次学习的时候,我完全看不懂这套算法究竟在干什么,最后只能机械记忆操作流程,照着步骤计算next数组。当时心里一直有个疑惑:为什么这套递推刚好可以算出正确结果?总感觉一切像是巧合。 等到第二次回头复习,我又陷入一模一样的困境:看不懂代码,看不懂网上各类讲解,之前记下来的流程几乎全部遗忘。直到这一次重温,很多逻辑才慢慢变得合情合理,不再是凭空出现的技巧。于是打算写下这篇完整复盘,记录我理解KMP的全过程。
一、字符串模式匹配:我们要解决什么问题
字符串模式匹配:给定主串(目标文本)SSS,模式串(查找模板)PPP,我们需要在主串中寻找与模式串完全相同的子串,并返回该子串在主串中的起始下标。
KMP 算法处理的是精确单模式匹配问题。精确:要求字符一一对应、完全相等,不允许字符差异;单模式:指每次仅使用一个固定模板,在文本中完成搜索。
这并不是一道仅存在于课本上的习题,现实工程中有非常多落地场景:文档、网页中的关键词查找;拼写检查;生物信息学:基因序列片段比对;数据压缩等领域。
字符串匹配是计算机科学的经典研究方向,已经诞生了多种成熟算法,包括朴素暴力匹配、Rabin‑Karp、KMP、Boyer‑Moore 等,不同算法在预处理开销、匹配效率上各有取舍。
本文就从最朴素的暴力解法出发,一步步展开讲解 KMP 的完整原理。
二、朴素暴力匹配:思路直观,但效率堪忧
最容易想到的就是暴力匹配。不断把模式串对齐到主串的不同位置,逐个字符比对。一旦出现字符不匹配,模式串整体向右移动一位,主串游标回退,模式串游标归零,从头开始新一轮比对。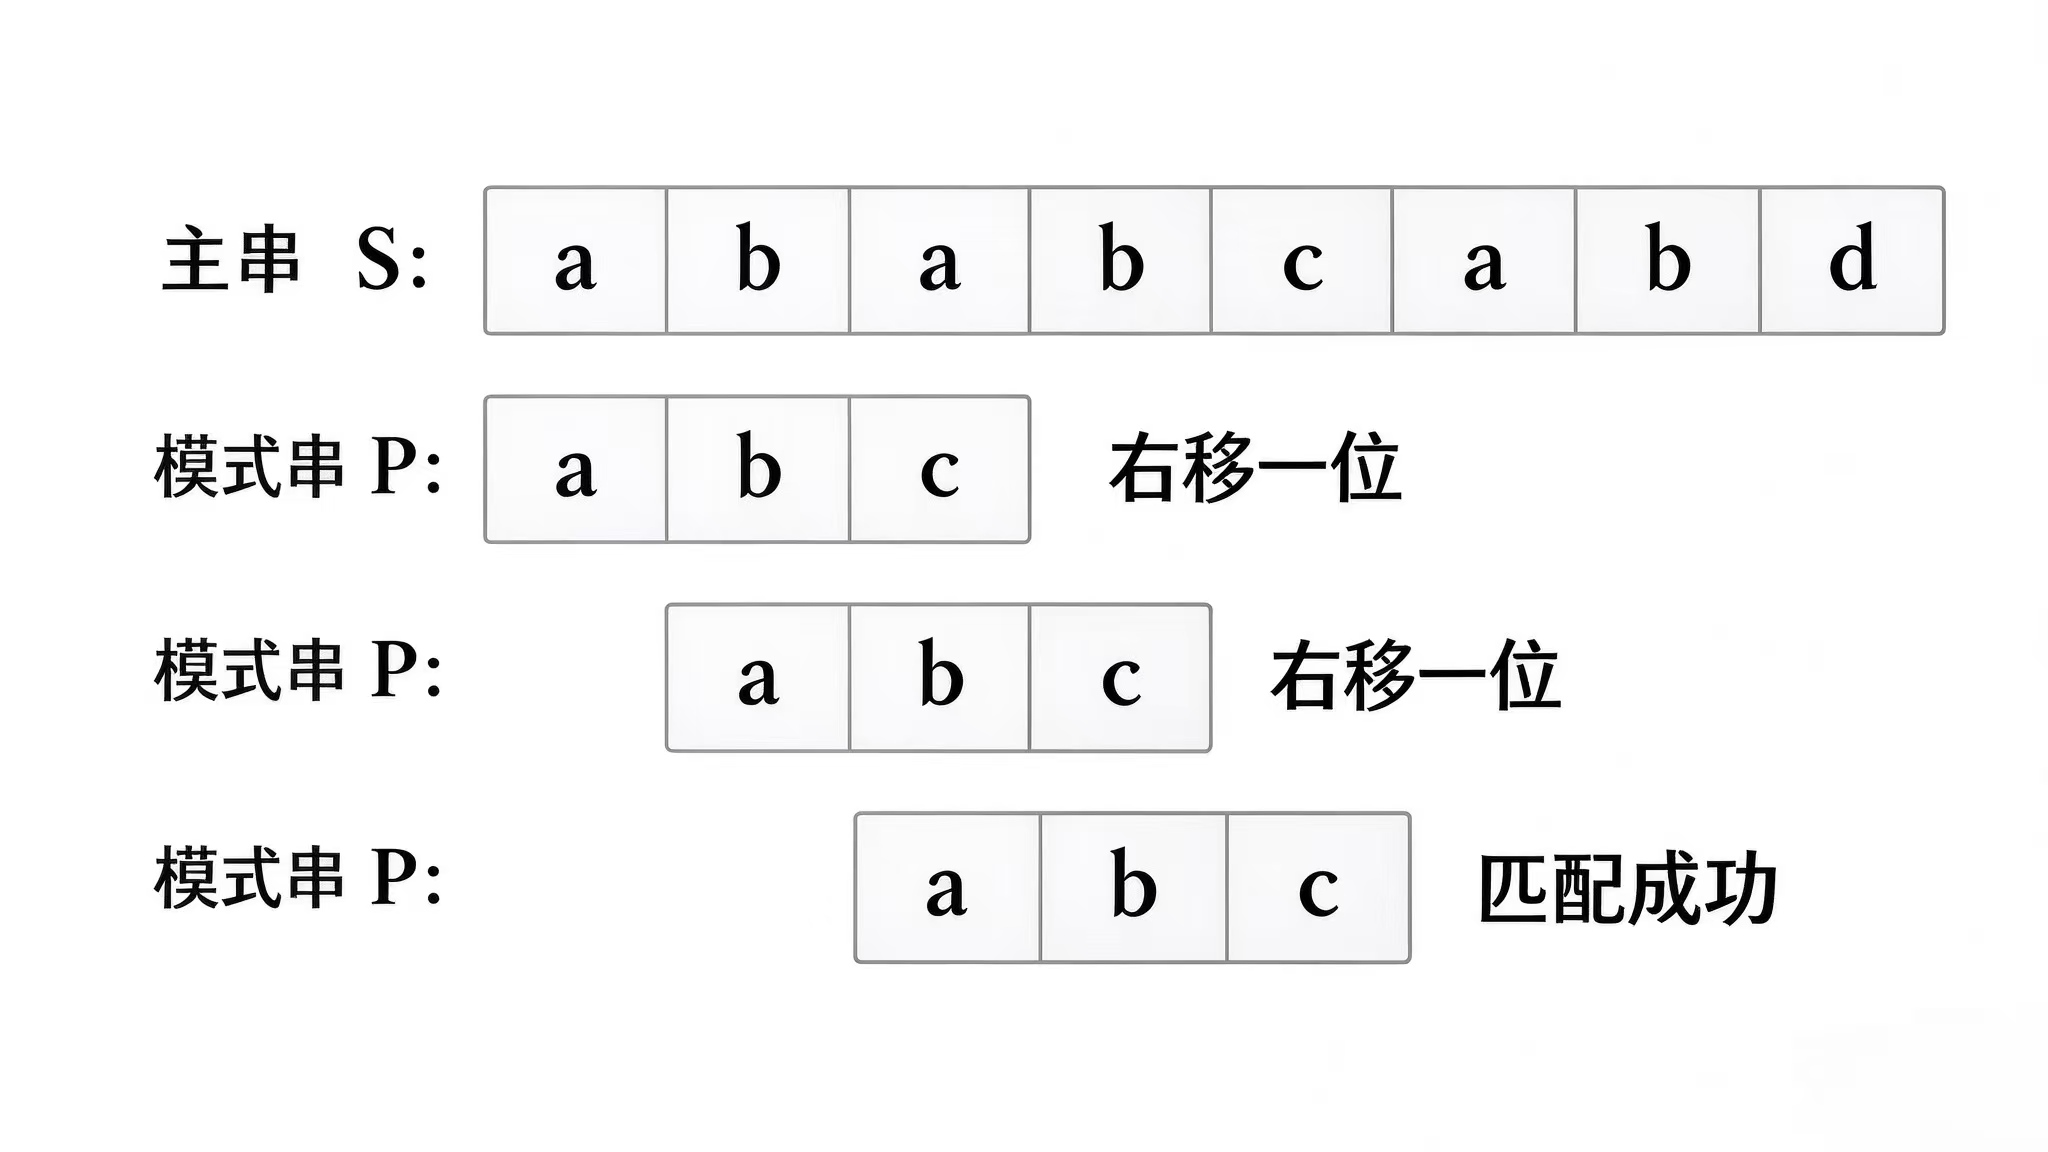
// C++ 朴素字符串匹配(暴力匹配)实现
// T:主串(待搜索的长文本),P:模式串(要查找的子串),startindex:主串中开始搜索的起点
int FindPat(string T, string P, int startindex)
{
    // 主串最后一个可以开始匹配的位置:超过这个起点,剩余长度不足以放下模式串,直接失败
    int LastIndex = T.length() - P.length();
    if (startindex > LastIndex)
        return -1;

    // i:主串T的指针;j:模式串P的指针
    int i = startindex, j = 0;
    while (i < T.length() && j < P.length())
    {
        if (T[i] == P[j]) {
            // 当前字符匹配成功,两个指针同时向后移动,继续比对下一位
            i++; j++;
        }
        else {
            // 匹配失败!朴素算法核心:主串指针回退到【本次起始位置+1】,模式串指针重置到0
            i = i - j + 1; j = 0;
        }
    }

    // j走到模式串末尾,代表全部字符匹配完成,返回匹配起点
    if (j >= P.length())
        return i - j;
    else
        return -1; // 遍历结束仍未找到匹配
}
效率分析 设主串长度 nnn,模式串长度 mmm。最好情况下,第一轮就完成匹配,只需要比对全部模式串字符,时间复杂度 O(m)O(m)O(m);
最坏情况下:模式串每一次滑动,都要比对完模式串全部 mmm 个字符之后才发生失配。模式串最多一共可以进行 n−m+1n-m+1n−m+1 轮匹配(从主串下标 0 的位置开始,一直到最后一个能放下模式串的起始位置,一共 n−m+1n-m+1n−m+1 个起始位置)。每一轮最坏都要做 mmm 次字符比较,因此总的最大比较次数 =m×(n−m+1)m\times(n-m+1)m×(n−m+1)。
当主串、模式串都很长时,这个复杂度是平方级 O(nm)O(nm)O(nm),时间开销会急剧变大。
暴力算法存在大量冗余比较:前面已经匹配成功的信息全部被丢弃,很多对比是完全可以通过已有结果直接推断结果,不需要重复执行。因此,我们需要一套更高效的算法,KMP就此登场。
三、KMP核心思想:主串游标绝不后退
暴力算法的痛点来自主串游标回退
,造成大量重复比对。 KMP的核心目标:把整体时间复杂度降低到线性级别。主串的游标只向前走,绝不回退;只让模式串游标回退,并且不要每次都直接回到起点0,而是跳转到一个预先算好的特殊位置继续比较,以此减少无效回溯。
先明确:前缀与后缀的定义
针对字符串 P[0,…,j−1]P[0,\dots ,j-1]P[0,…,j−1]:
- 前缀(prefix):以字符串起点 P[0]P[0]P[0] 开头,不包含最后一个字符的所有子串。
例:
ababc的前缀:a、ab、aba、abab
- 后缀(suffix):以字符串末尾 P[j−1]P[j-1]P[j−1] 结尾,不包含第一个字符的所有子串。
例:
ababc的后缀:c、bc、abc、babc
注:前后缀都不能等于字符串本身!
最长相等前后缀:在前缀集合、后缀集合里面,找出两个完全相同的子串,取其中长度最大的那一个。
举个例子:
字符串
abab
前缀集合:a、ab、aba;后缀集合:b、ab、bab。相等的子串只有ab,长度为2。也就是abab的最长相等前后缀长度等于2。
还原失配发生时的场景:
设主串当前字符为 S[i]S[i]S[i],模式串当前字符为 P[j]P[j]P[j]。
此时 jjj 之前的所有字符全部匹配成功:
S[i−j:i]=P[0:j]S[i-j:i] = P[0:j]S[i−j:i]=P[0:j]
但在当前位置满足:
S[i]≠P[j]S[i] \neq P[j]S[i]=P[j]
匹配发生失配。
按照朴素暴力算法,一旦失配,模式串只会机械整体右移一位,让 P[0]P[0]P[0] 与 S[i−j+1]S[i-j+1]S[i−j+1] 重新开始比对。
但这里存在大量无效比对,完全可以优化:
我们已知:本轮已经匹配成功的前缀 P[0,…,j−1]P[0,\dots ,j-1]P[0,…,j−1],和主串对应区间 S[i−j,…,i−1]S[i-j,\dots ,i-1]S[i−j,…,i−1] 完全相等。
模式串整体右移一位后,新一轮匹配的本质,是用模式串的前缀,去对上一轮已经匹配成功的后缀。
如果移位后,模式串前缀和上一轮匹配的后缀无法重合,那这一趟匹配必然失败,可以直接跳过,无需逐字符比对。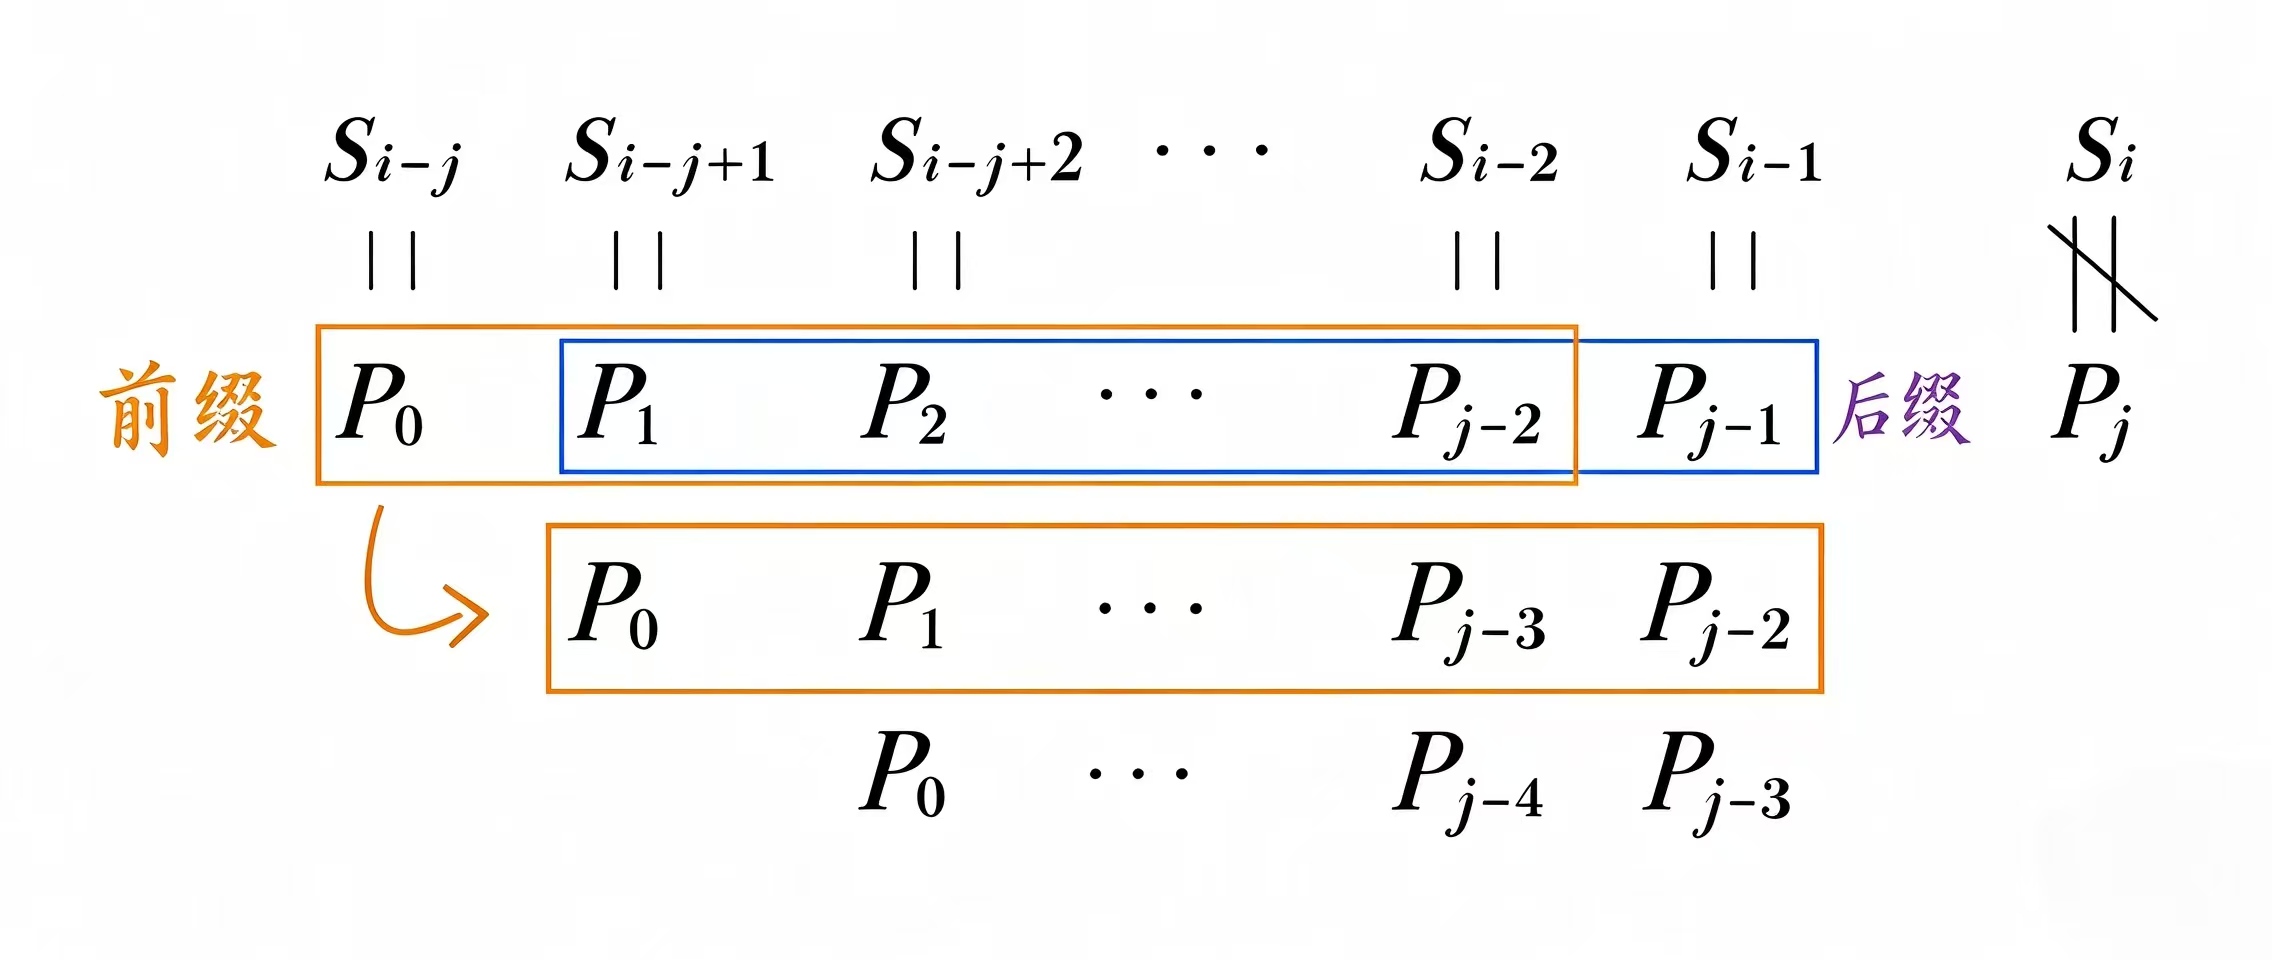
于是我们不需要无脑右移,而是从长到短检查模式串的相等前后缀:
- 检查长度为 j−1j-1j−1 的前后缀是否相等,不相等则继续右移;
- 检查长度为 j−2j-2j−2 的前后缀是否相等,不相等继续右移;
- 以此类推,不断缩小长度。
最终我们会找到一个最大长度 kkk,满足:
P[0,…,k−1]=P[j−k,…,j−1]P[0,\dots ,k-1] = P[j-k,\dots ,j-1]P[0,…,k−1]=P[j−k,…,j−1]
这个 kkk,就是当前失配位置对应的 最长相等前后缀长度,也是 KMP 算法中 next 数组的核心依据。
此时直接将模式串跳转到 kkk 的位置(最长相等前后缀的前缀的后一个位置),拿 P[k]P[k]P[k] 和原来失配的主串字符 S[i]S[i]S[i] 继续比对,不需要再从头比对。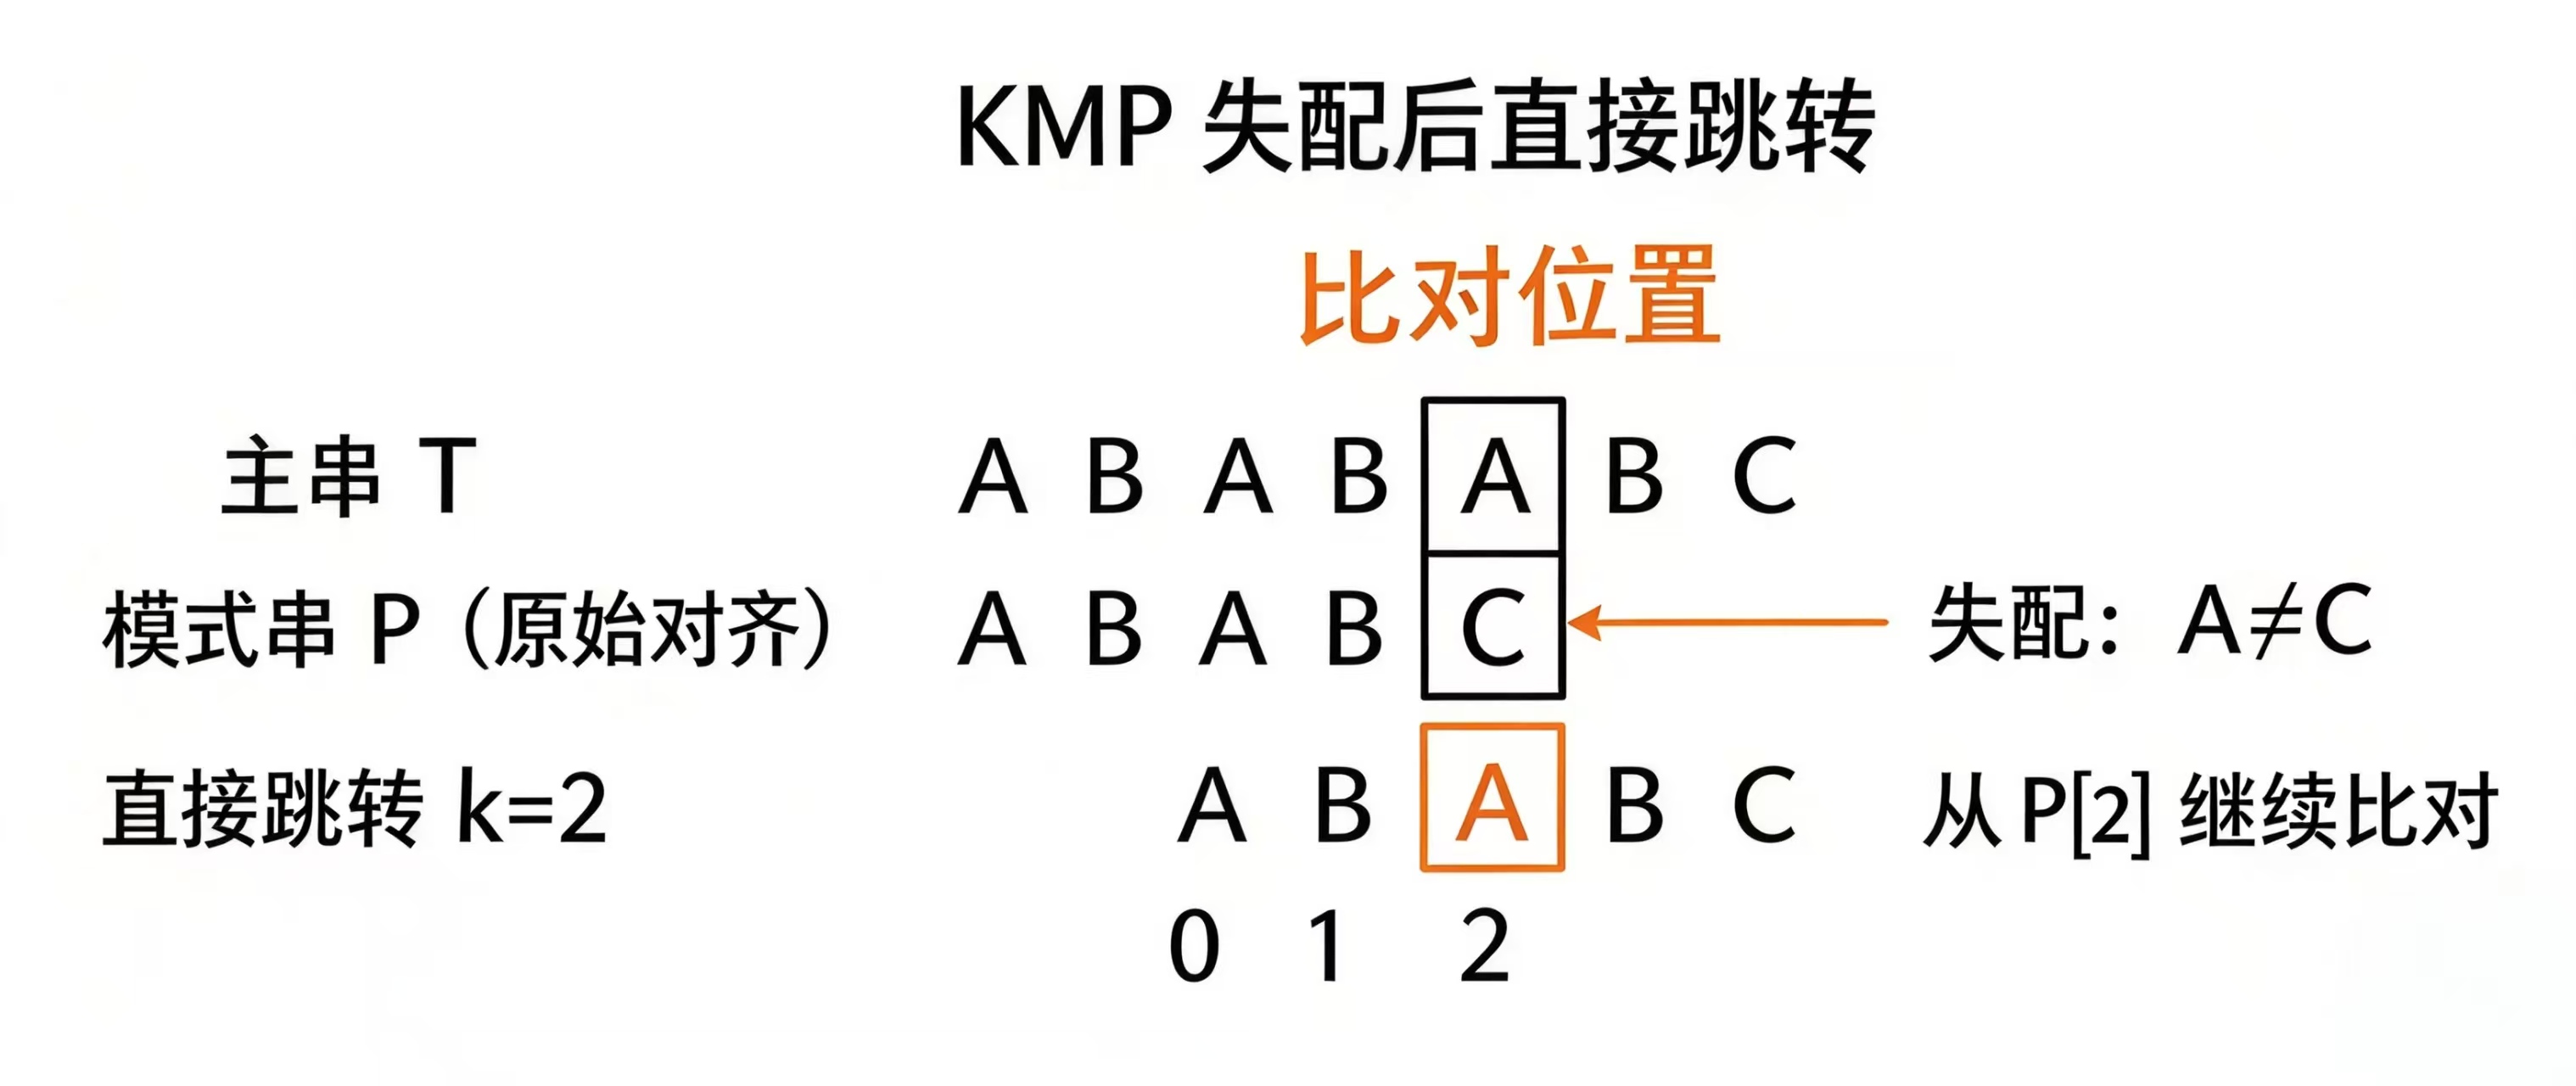
如果在 kkk 的位置再次发生失配,我们就对这个长度为 kkk 的前缀,再次求它自身的最长相等前后缀,得到次一级的跳转位置,继续尝试比对,循环往复。
这里出现边界问题:当不存在相等前后缀(k=0)(k=0)(k=0)。此时模式串游标指向第0号字符,仍然要拿 P[0]P[0]P[0] 和 S[i]S[i]S[i] 对比。
为了统一处理“连第一个字符都匹配失败”的边界,我们引入标记 k=−1k=-1k=−1。
当回退到 k=−1k=-1k=−1,代表模式串第一个字符也无法和 S[i]S[i]S[i] 匹配。这时主串游标 iii 自增到 i+1i+1i+1,模式串游标从 −1-1−1 自增到 0,双方同时向前走一步。
四、next数组:存储跳转信息
上面的跳转逻辑,每次失配时都需要知道:
失配下标jjj左侧子串的最长相等前后缀长度。
如果匹配的时候现场暴力去查找最长相等前后缀,效率会变差。因此我们提前预处理模式串,把全部跳转信息存入next数组(也叫特征向量 NNN)。
next[j]next[j]next[j] 的含义:模式串中,下标jjj左侧子串 P[0,…,j−1]P[0,\dots ,j-1]P[0,…,j−1] 的最长相等前后缀的长度。
人脑手动计算next数组,可以暴力枚举:从最大可能长度往下试探,找到满足前后缀相等的最大kkk。 但是机器如果照搬这种暴力枚举,预处理会比较慢。因此我们使用递推的方式,依靠已经计算完成的 N[0,…,j]N[0,\dots ,j]N[0,…,j] 推导 N[j+1]N[j+1]N[j+1],实现线性预处理。
next数组的递推逻辑
设模式串总长度 ∣P∣=m|P|=m∣P∣=m,已知 N[0,…,j]N[0,\dots ,j]N[0,…,j] 且 N[j]=kN[j]=kN[j]=k,求解 N[j+1]N[j+1]N[j+1]:
如果 P[j]==P[k]P[j] == P[k]P[j]==P[k]: 那么在原来长度kkk的相等前后缀基础上,两端同时扩展一位。得到 N[j+1]=k+1N[j+1] = k+1N[j+1]=k+1。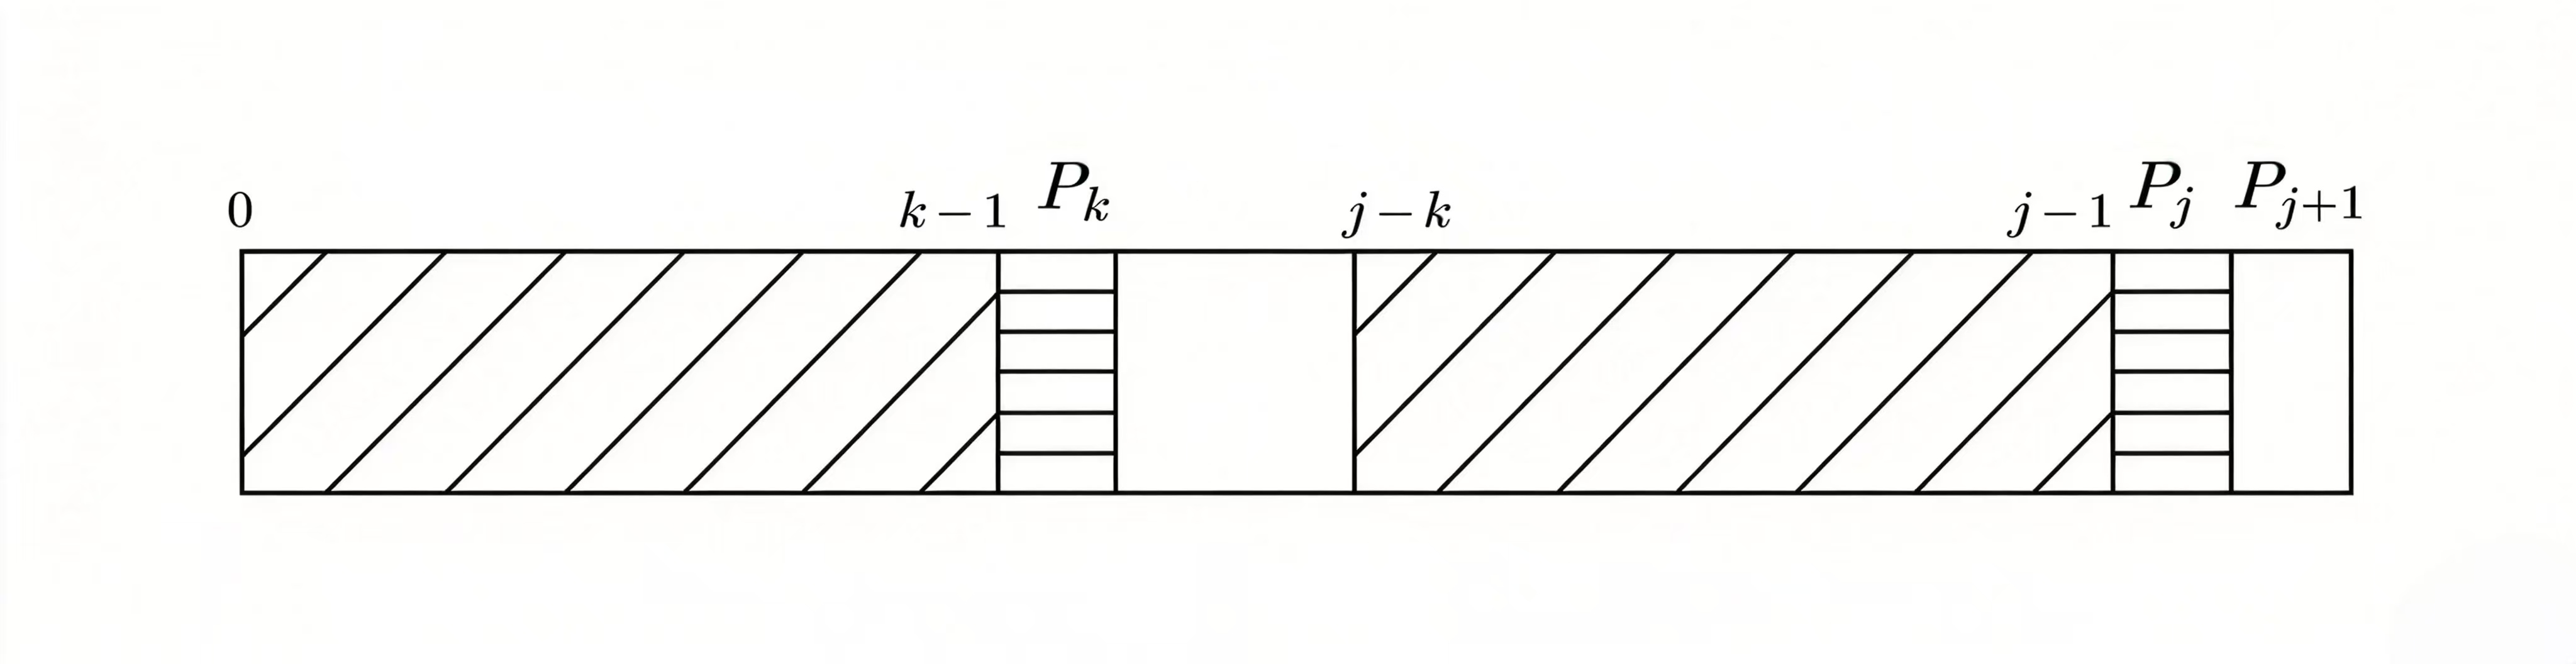
如果 P[j]≠P[k]P[j] \neq P[k]P[j]=P[k]: 由 N[j]=kN[j]=kN[j]=k,可知 P[0,…,k−1]=P[j−k,…,j−1]P[0,\dots ,k-1] = P[j-k,\dots ,j-1]P[0,…,k−1]=P[j−k,…,j−1]。 此时令 k′=N[k]k'=N[k]k′=N[k],P[0,…,k′−1]P[0,\dots ,k'-1]P[0,…,k′−1] 是子串 P[0,…,k−1]P[0,\dots ,k-1]P[0,…,k−1] 的最长相等前后缀的前缀。因为 P[0,…,k−1]=P[j−k,…,j−1]P[0,\dots ,k-1] = P[j-k,\dots ,j-1]P[0,…,k−1]=P[j−k,…,j−1],所以 P[0,…,k′−1]P[0,\dots ,k'-1]P[0,…,k′−1] 也等于 P[j−k,…,j−k+k′−1]P[j-k,\dots ,j-k + k'-1]P[j−k,…,j−k+k′−1],也就是 P[j−k′,…,j−1]P[j-k',\dots ,j-1]P[j−k′,…,j−1]。
根据相等子串的传递性,P[0,…,k′−1]P[0,\dots ,k'-1]P[0,…,k′−1] 和 P[j−k′,…,j−1]P[j-k',\dots ,j-1]P[j−k′,…,j−1] 同时也是 P[0,…,j−1]P[0,\dots ,j-1]P[0,…,j−1] 的次一级最长相等前后缀。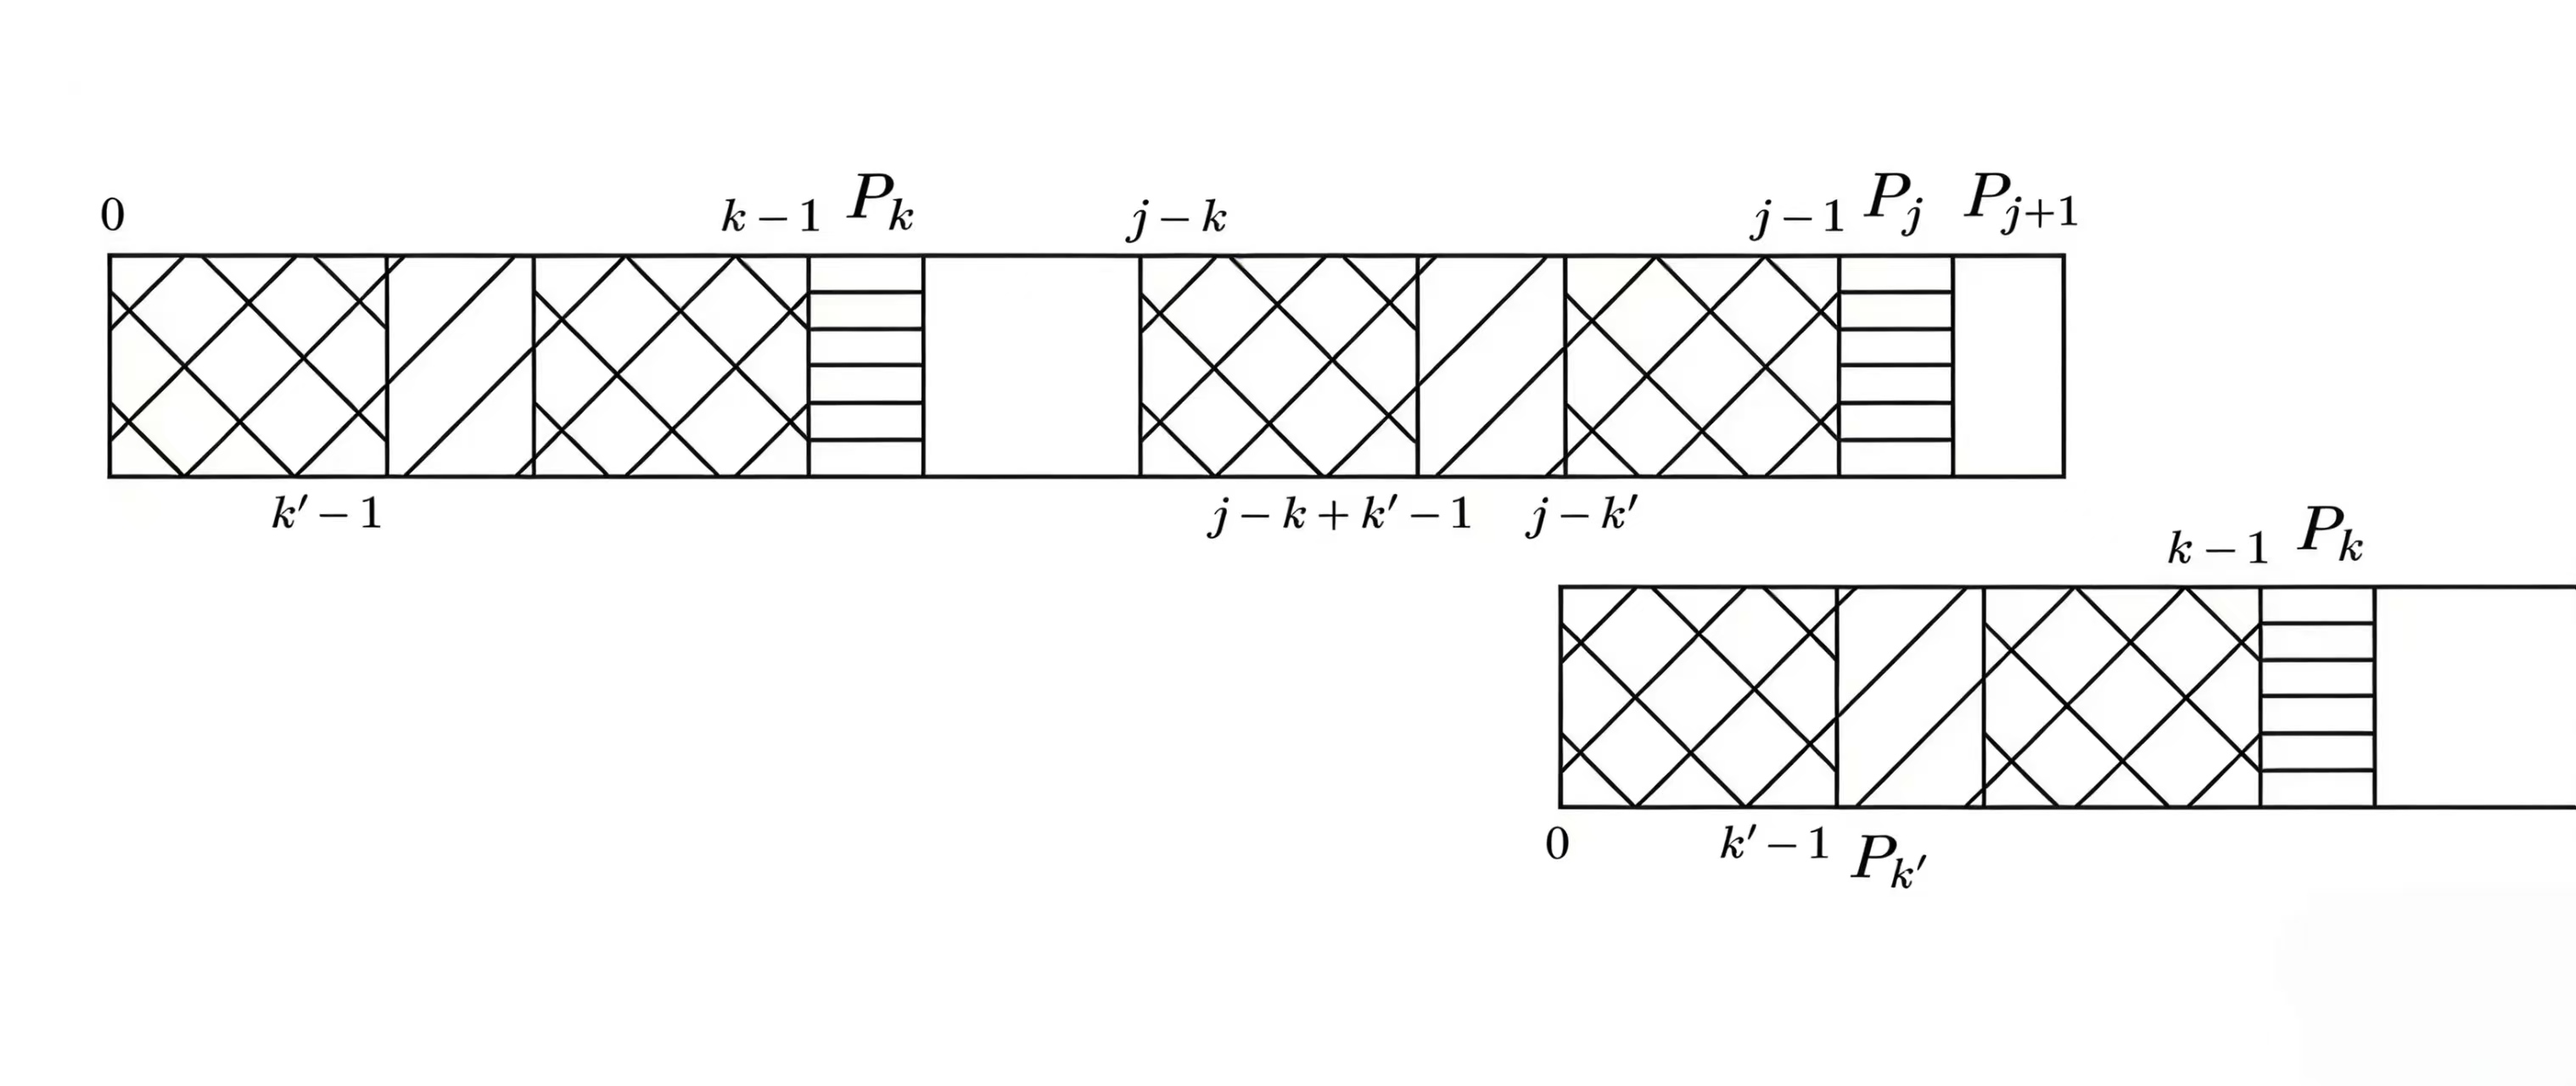
拿 P[j]P[j]P[j] 和 P[k′]P[k']P[k′]继续比较:
- 如果相等,则 N[j+1]=k′+1N[j+1]=k'+1N[j+1]=k′+1;
- 如果依旧不等,则继续令 k’=N[k′]k’=N[k']k’=N[k′],循环回退。
终止条件:k=−1k=-1k=−1。此时依旧满足公式 N[j+1]=k+1N[j+1]=k+1N[j+1]=k+1,即 N[j+1]=0N[j+1]=0N[j+1]=0。
五、next数组代码:原始版本与优化版本
next数组的原始版本
// 非优化next求解代码,原始KMP next数组
// P:模式串,返回next数组,next[j]代表P[0,...,j-1]最长相等前后缀的长度
int* findNext(string P)
{
    int j, k;
    int m = P.length();    // m:模式串P的总长度
    int* next = new int[m];
    next[0] = -1;          // 初始化:next[0]固定为-1,作为匹配失败的终止标记
    j = 0;                 // j:模式串前缀末尾指针
    k = -1;                // k:模式串后缀末尾指针,初始-1,代表没有匹配的前后缀

    // j最多走到 m-2,因为循环内会j++计算next[j+1]
    while (j < m - 1)
    {
        // 如果不匹配,利用next数组回退k,寻找更短的相等前后缀
        while (k >= 0 && P[k] != P[j])
            k = next[k];

        j++;    // 前缀指针后移
        k++;    // 后缀指针同步后移
        next[j] = k; // 记录P[0,...,j-1]的最长相等前后缀长度k
    }
    return next;
}
next数组的优化版本
思考这样一种场景:当我们失配在位置 jjj,需要回退到 k=next[j]k=next[j]k=next[j]。
如果 P[j]==P[k]P[j] == P[k]P[j]==P[k],原本失配的字符是 P[j]P[j]P[j],那么 P[k]P[k]P[k] 和主串字符也一定不匹配,还需要再一次回退。
优化的思路:既然回退过去依然会失败,我们直接把 next[j]next[j]next[j] 设置成 next[k]next[k]next[k],一步到位跳转到最终位置,省去匹配过程中重复的回退。
// next数组优化版本(nextval思想)
int* findNext(string P)
{
    int j, k;
    int m = P.length();
    int* next = new int[m];
    next[0] = -1;  // 初始化,next[0]固定为-1,作为失配终止标记
    j = 0;         // j:模式串前缀末尾指针
    k = -1;        // k:模式串后缀末尾指针

    while (j < m - 1)
    {
        // 字符不匹配,利用next回退k,寻找更短相等前后缀
        while (k >= 0 && P[k] != P[j])
            k = next[k];

        j++;
        k++;
        // 优化核心:若P[k]==P[j],回退到k仍然会失配,直接跳next[k]
        if (P[k] == P[j])
            next[j] = next[k];
        else
            next[j] = k;
    }
    return next;
}
六、KMP完整匹配代码
预处理得到next数组之后,执行匹配。
iii:主串游标,只增不减;
jjj:模式串游标,匹配成功同步前进;失配则依靠next数组回退;
j=−1j=-1j=−1代表模式串全部回退完毕,此时两个游标同时向前移动。
// KMP字符串匹配主体函数
// T为主串,P为模式串,N是预处理得到的next数组,start是主串起始搜索位置
int KMPStrMatching(string T, string P, int* N, int start)
{
    int i = start; int j = 0;
    int tLen = T.length(); int pLen = P.length();
    if (start > tLen - pLen)
        return -1;  // 起始位置过靠后,剩余字符不足以容纳模式串,直接返回失败
    while (i < tLen && j < pLen)
        if (j == -1 || T[i] == P[j])
            i++, j++;  // 匹配成功 / j=-1模式串完全回退,双游标同步前进
        else
            j = N[j];  // 失配,依靠next数组回退模式串游标,主串i不回退
    if (j >= pLen)
        return i - pLen; // 匹配完成,返回匹配起点
    else
        return -1;
}

// next数组求解函数原型(上文已实现,此处仅声明)
int* findNext(string P);
七、算法复杂度严谨分析
分析思路 观察游标的变化,区分哪些语句让游标增大,哪些语句让游标减小,统计总共执行的次数。
1)KMP匹配过程复杂度(主串T,长度∣T∣|T|∣T∣)
-
主串指针 iii:只会自增,最多增加 ∣T∣|T|∣T∣ 次。i++i++i++ 最多执行 ∣T∣|T|∣T∣ 次,j++j++j++ 最多执行 ∣P∣|P|∣P∣ 次。
-
每次循环要么走
if,要么走else。设if执行 xxx 次,else执行 yyy 次。
if(j++)(j++)(j++) 使 jjj 自增1;else(j=N[j])(j=N[j])(j=N[j]) 使 jjj 减小(最少减1)。
因为 jjj 的取值 j∈[−1,∣P∣]j\in[-1,|P|]j∈[−1,∣P∣],
所以 −1≤x−y≤∣P∣-1 \le x-y \le |P|−1≤x−y≤∣P∣。
y≤x+1y \le x+1y≤x+1,也就是 j=N[j]j=N[j]j=N[j] 的执行次数最多不超过 x+1x+1x+1。 -
∣T∣≥∣P∣|T|\ge|P|∣T∣≥∣P∣,
if的次数满足 x≤∣T∣x \le |T|x≤∣T∣。
j=N[j]j=N[j]j=N[j] 的次数满足 y≤x+1y \le x+1y≤x+1。
总循环次数:
x+y≤2∣T∣+1x+y \le 2|T|+1x+y≤2∣T∣+1
即循环体最多执行 2∣T∣+12|T|+12∣T∣+1 次。
时间代价与目标串长度成线性关系,O(∣T∣)O(|T|)O(∣T∣)。
2)next数组预处理复杂度(模式串P,长度∣P∣|P|∣P∣)
-
外层循环执行 (i++,k++)(i++,k++)(i++,k++),最多执行 ∣P∣−1|P|-1∣P∣−1 次,
其中 k++k++k++ 使 kkk 每次 +1+1+1。 -
内层循环执行 k=next[k]k=next[k]k=next[k],使 kkk 每次减小(最少减1)。
而 k∈[−1,∣P∣]k\in[-1,|P|]k∈[−1,∣P∣],设内层循环执行 yyy 次,外层循环执行 xxx 次。
−1≤x−y≤∣P∣-1\le x-y \le |P|−1≤x−y≤∣P∣
y≤x+1y \le x+1y≤x+1,即 k=next[k]k=next[k]k=next[k] 的次数最多为 k++k++k++ 次数+1+1+1。
x≤∣P∣−1x \le |P|-1x≤∣P∣−1,
y≤x+1≤∣P∣y \le x+1 \le |P|y≤x+1≤∣P∣。
总循环次数:
x+y≤2∣P∣−1x+y \le 2|P|-1x+y≤2∣P∣−1
即两层循环体总共最多执行 2∣P∣−12|P|-12∣P∣−1 次。
时间代价与模式串长度成线性关系,O(∣P∣)O(|P|)O(∣P∣)。
综上,匹配O(∣T∣),O(|T|),O(∣T∣),预处理O(∣P∣)O(|P|)O(∣P∣)。KMP总的时间复杂度:
O(∣T∣+∣P∣)=O(n+m)\boldsymbol{O(|T|+|P|)=O(n+m)}O(∣T∣+∣P∣)=O(n+m)。
八、个人复盘
前后三次学习 KMP 算法,我最大的感受是:KMP 的难点从来不在代码实现,而在算法思想。
朴素暴力匹配完全贴合人的直觉:匹配失败就整体后移、从头重来。而 KMP 是典型的反直觉优化思想——不推翻已匹配的有效前缀,而是复用已匹配成功的前后缀信息,通过预处理规避大量重复比对。
初学阶段,我曾把 next 数组的递推过程当成一套“固定模板”,只会机械默写。直到结合课堂教学逐次拆解跳转逻辑、推导,才真正读懂每一步递推、每一次游标回退的底层原理,不再是死记代码。
小结
KMP 算法的核心精髓可总结为两点:预处理存信息,失配不回溯。
通过提前遍历模式串,用 next 数组记录每个位置的最长相等前后缀;匹配发生失配时,仅通过数组跳转修正模式串游标,主串游标全程不回退,彻底消除暴力匹配的冗余重复比对,将字符串匹配的时间复杂度从朴素 O(nm)O(nm)O(nm) 优化为线性 O(n+m)O(n+m)O(n+m)。
本文为个人数据结构与算法课程学习复盘,完整融入了递推逻辑、指针势能法复杂度证明。个人理解难免存在疏漏,欢迎大家指正交流。

一站式 AI 云服务平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)