
Dify 实战:零代码搭建知识库问答 Agent,从上传文档到真的能答对
本文是《AI Agent 实战》系列第 3 篇。前两篇我们用手写代码的方式理解了 Agent 的构成和 LangGraph 的图编排。本篇换个路线:一行代码都不写,用 Dify 把一个私有知识库问答 Agent 搭出来。适合不想啃框架、但手上有一堆文档想让 AI 能问答的人。
上篇发出去后,评论区最高频的一句话是:"我是产品/运营,我不想学 LangGraph,但我想让我们公司的产品手册、制度文档、历史工单能被 AI 问答,怎么办?"
这个需求有个专业名词,叫 RAG(检索增强生成):把你的文档切成片段、向量化存起来,用户提问时先检索相关内容,再把内容喂给大模型作答。
自己写这套流程,你要处理文档解析、分块、Embedding、向量库选型、检索召回、重排、提示词拼装——至少几百行代码。而 Dify 把它做成了拖拽和填表。
先说清楚本篇能给你什么:
- 30 分钟内跑通一个能回答你私有文档的问答应用;
- 一套检索效果优化清单(这是大多数教程跳过、但决定你能不能真正落地的部分);
- 一份踩坑记录,包含"准确率上不去"的具体原因。
需要先明确的边界:Dify 适合知识库问答、流程编排、内部工具类 Agent。如果你的场景需要复杂的多步任务规划、精细的状态控制、自定义循环逻辑,还是得上 LangGraph(见第 2 篇)。两者不冲突,很多人是 Dify 做上层应用、LangGraph 做底层能力,再通过 API 打通。
一、Dify 是什么,以及它的应用类型怎么选
Dify 是一个开源的 LLM 应用开发平台,把模型接入、提示词编排、知识库(RAG 管道)、工具调用、发布与监控这些环节做进了一个可视化工作区。它既能用官方云服务,也能 Docker 本地私有化部署——对文档敏感的企业,这一条往往是决定性优势。
版本号提示:Dify 已进入 1.x 阶段,2026 年迭代到 1.17 系列,知识库、工作流、Agent 能力都在持续增强。本文界面描述基于 1.x 较新版本,具体菜单名称以你部署的版本为准。
四种应用类型,别一上来就选最复杂的:
| 类型 | 是什么 | 适合什么 |
|---|---|---|
| Chatbot(聊天助手) | 单轮/多轮对话,最简单 | 先理解 RAG,本篇入门用它 |
| Agent | 会自主判断并调用工具 | 需要工具编排的问答,如查库存、查订单 |
| Chatflow | 带画布编排的对话流 | 有分支、有多轮交互的客服场景 |
| Workflow | 批处理式工作流 | 内容生成、数据处理这类一次性跑完的任务 |
我见过太多人一开始就上 Workflow,把简单问答做成复杂 DAG,最后自己维护不动。合理路径是:先用 Chatbot 理解 RAG → 再用 Agent 理解工具调用 → 最后才上 Chatflow/Workflow。
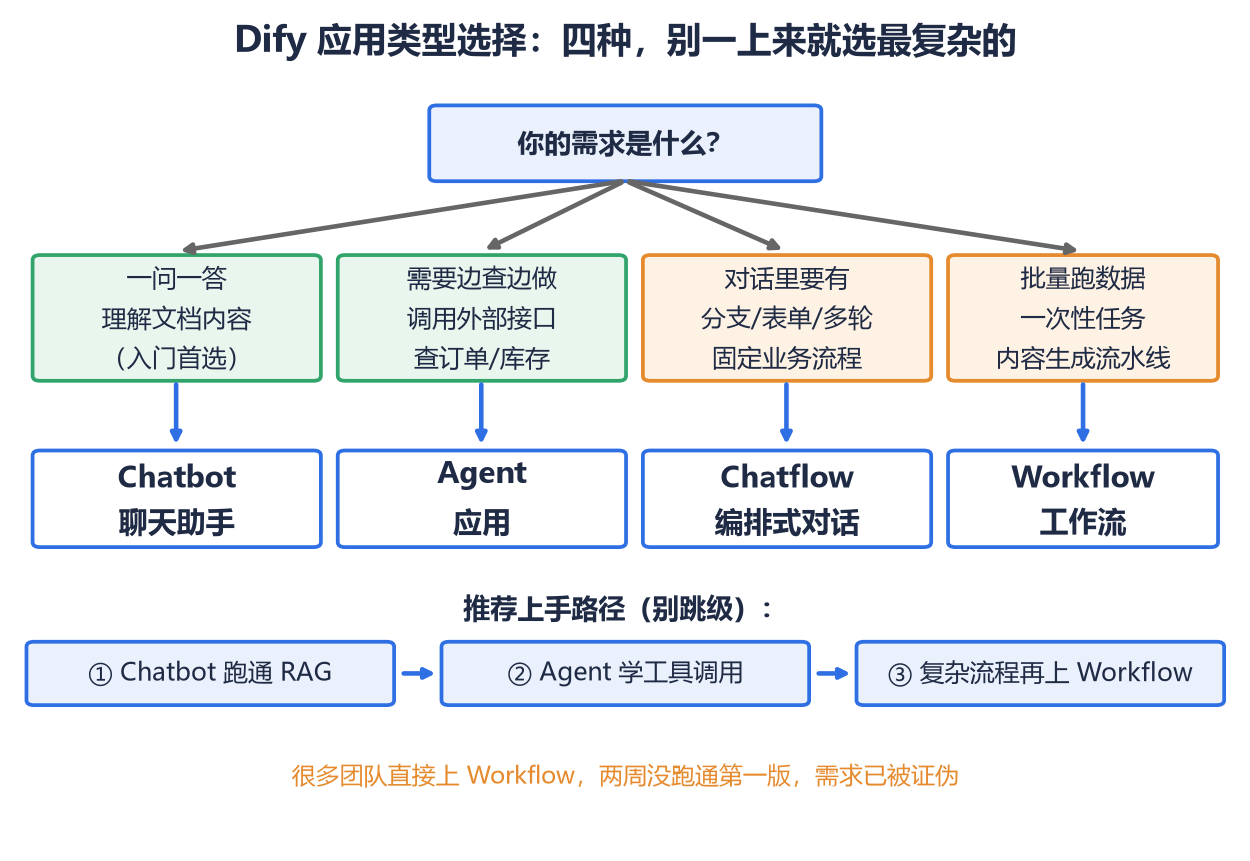
【图 1:四种应用类型选择决策树】
二、先搭好环境:云服务还是本地部署
路线 A:用官方云服务(本篇演示走这条)
注册即用,有免费额度可以先把流程跑通(额度和计费规则会变,动手前请以官网当前定价页为准)。优点是不用管服务器,缺点是文档会存在第三方,公司真实文档请先过合规。
路线 B:Docker Compose 本地部署
git clone "https://github.com/langgenius/dify.git"
cd dify/docker
cp .env.example .env
docker compose up -d
启动后访问 http://localhost/install 完成初始化。几个务实提醒:
- 配置门槛:默认栈会拉起 PostgreSQL、Redis、向量库(Weaviate/Qdrant 可选)等多个容器,2 核 4G 会跑得很勉强,建议至少 4 核 8G 起。
- 版本升级前看 Release Notes:Dify 近几个版本有过依赖相关的升级注意事项,别在业务高峰直接
up -d覆盖。 - 内网/离线环境:模型和插件都需要能访问到,注意提前配置模型服务地址或插件镜像源。
选哪条?验证想法用 A,涉及私有数据或要做交付用 B。
三、核心概念:Dify 的 RAG 是怎么工作的
理解这条链路,后面的参数你才知道自己在调什么:
原始文档
  ↓ 解析(提取文字、表格、图片)
  ↓ 分段清洗(切 Chunk,决定"一段知识有多大")
  ↓ 向量化(Embedding 模型把每段变成向量,存入向量库)
  ↓
用户提问
  ↓ 问题向量化
  ↓ 检索(向量检索 / 全文检索 / 混合检索,召回 Top-K 片段)
  ↓ Rerank 重排(可选,把真正相关的排到前面)
  ↓ 拼进提示词交给大模型
  ↓ 生成答案(可开启引用来源标注)
对应 Dify 里的四个可配置旋钮:
| 旋钮 | 在哪配 | 影响什么 |
|---|---|---|
| 分段策略 | 知识库 → 处理规则 | 知识颗粒度,直接决定召回完整性 |
| Embedding 模型 | 知识库 → 索引方式 | 检索质量的天花板 |
| 检索方式 | 知识库 → 检索设置 | 能不能召回关键词类问题 |
| Top-K / 阈值 | 应用 → 上下文设置 | 喂给模型的信息量与成本 |
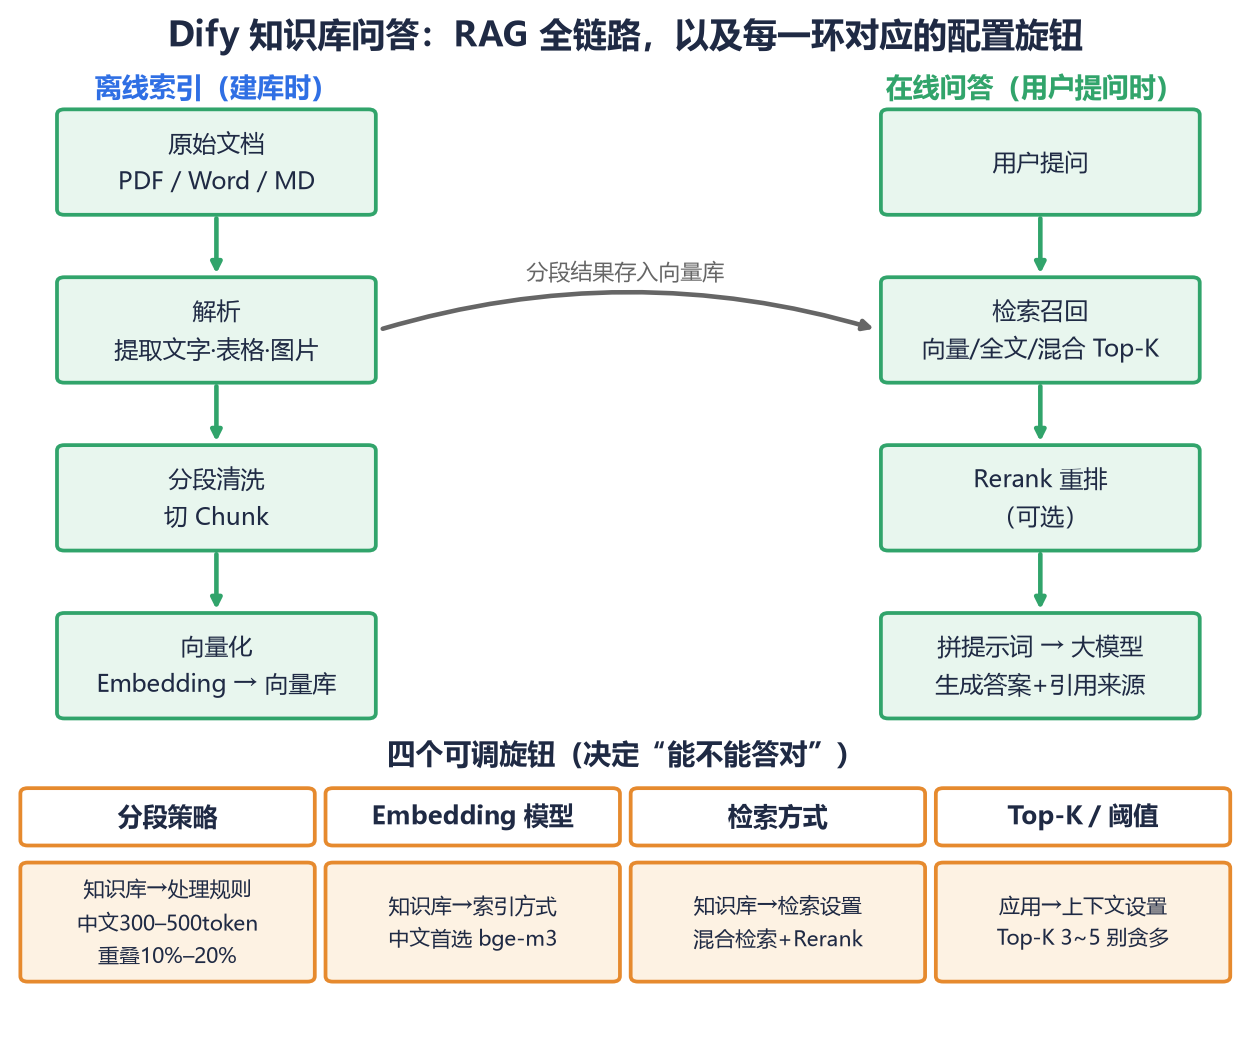
【图 2:RAG 全链路 + Dify 对应配置位置示意图】
四、实战:从零搭一个产品手册问答 Agent
我用一份虚构的《智能硬件产品手册》做演示(20 页 PDF + 30 条 FAQ + 一份保修政策文档)。
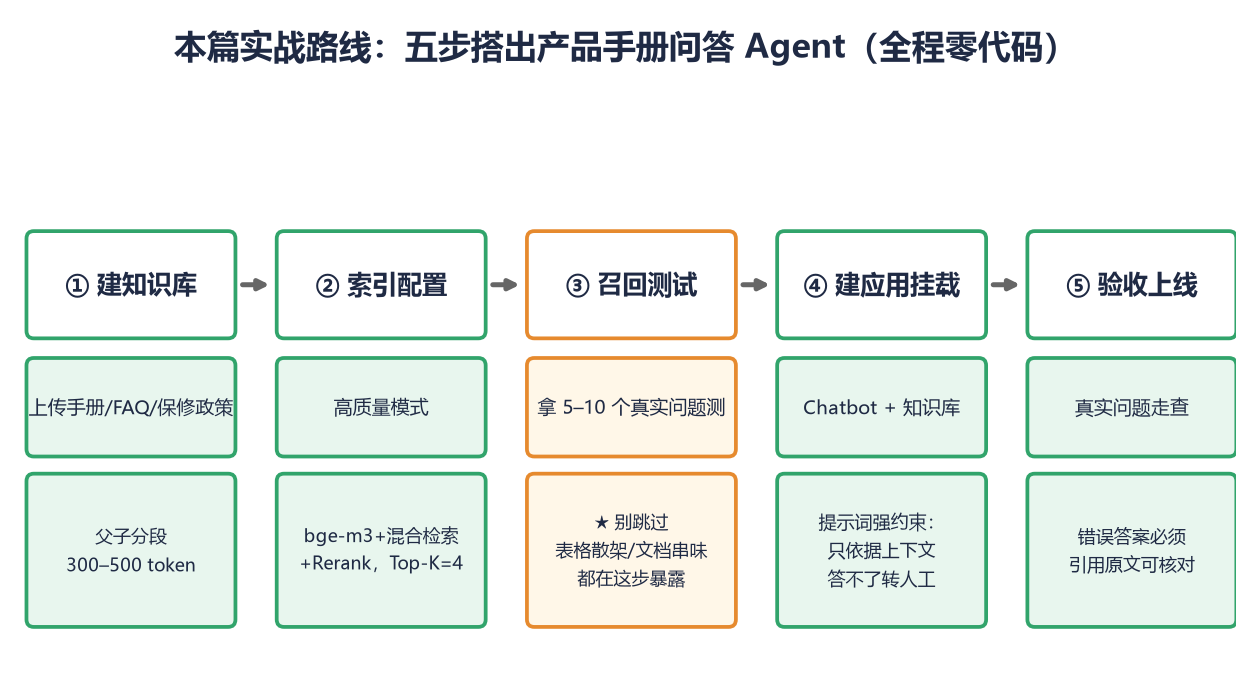
步骤 1:创建知识库
知识库 → 创建 → 选择"导入已有文本",上传文档。
这里就遇到第一个决策:分段模式选哪个?
| 模式 | 怎么切 | 适用 |
|---|---|---|
| 通用模式 | 按段落/句子自动切 | 结构松散的纯文本 |
| 父子模式 | 先切大块(父),再切小块(子),检索命中子块、生成时回退父块 | 技术文档、手册,推荐 |
| 问答对模式 | 按 Q-A 成对存储 | FAQ、工单库,召回精准度最高 |
我选了父子模式。原因:手册里"如何配对蓝牙设备"这段,被切成 4 个子块,用户提问只会命中其中一句,答案缺步骤;用父子模式则子块保检索精度、父块保上下文完整。
分段参数:中文技术文档建议 Chunk Size 300–500 token,Overlap 10%–20%。用 Dify 默认策略直接跑,技术文档的检索精度通常会打折——这是最常见的"效果差"原因之一。
【图 3:分段设置界面截图位置】
步骤 2:索引与检索设置
- 索引方式选"高质量"(经济模式是关键词倒排,中文语义匹配基本不够用)。
- Embedding 模型:中文场景优先 BGE-M3(
bge-m3)这类中文表现好的模型;云服务路线可以直接用它提供的内置 embedding。 - 检索方式选"混合检索",并开启 Rerank:纯向量检索会漏掉精确关键词(型号编号、SKU、专有名词),全文检索会漏掉同义表达,混合检索 + 重排是当前的稳定解。
- Top-K 设 3–5,相似度阈值 0.5 左右起步。
别贪心把 Top-K 调到 10:喂给模型的片段越多,噪声越大、Token 越贵、模型越容易被互相矛盾的片段带偏。
步骤 3:召回测试(这一步千万别跳过)
知识库自带的"召回测试"是整个流程里性价比最高的功能。在建应用之前,先拿 5–10 个真实问题去测:
测试问题                        期望召回              实际结果
"设备怎么连蓝牙"               配对章节              ✅ 命中,步骤完整
"保修期是几年"                 保修政策条款          ❌ 召回了退换货政策(跨文档混淆)
"X200 支持哪些频段"            规格表                ❌ 未命中(表格被切碎)
我这一步就抓出两个真问题:
- 表格被切碎:规格参数表按纯文本切分后,"型号"和"频段"分到了不同片段。解法:把规格表单独抽成问答对模式的知识库,或上传时保留表格结构。
- 多文档信息串味:保修政策和退换货政策相似度高,交叉后模型拼出不存在的条款。解法:给文档加元数据标签,检索时按标签过滤;同时在提示词里强制"只依据给定上下文回答,不得推测"。
准确率上不去,八成问题在这一步就能定位。 没有召回测试,你根本无法判断是模型笨还是检索没找到。
步骤 4:创建 Chatbot 应用并挂载知识库
工作室 → 创建应用 → Chatbot。核心配置:
- 模型:日常问答够用即可(DeepSeek、通义等 OpenAI 兼容模型都能接);
- 上下文:知识库选刚建的那个,引用来源打开(便于人工核对答案依据);
- 提示词见下。
你是本产品的官方客服助手。

【回答规则】
1. 只能依据下方检索到的「上下文」回答,不得凭借自身知识推测或补充。
2. 上下文中找不到答案时,固定回复:"这个问题我需要为你转接人工客服,
   请拨打 400-XXX-XXXX。",不要编造。
3. 涉及价格、保修期限、医疗或安全说明的内容,必须逐字引用上下文原文。
4. 回答不超过 200 字,操作步骤用编号列表。
第 2 条是这套应用里最重要的一句。知识库问答最大的业务风险不是"答不上来",而是答错还很自信——把不存在的服务承诺发给客户,是要担责的。宁肯它说不知道。
步骤 5:跑一遍真实问题
Q: X200 支持哪些频段?
A: 根据产品规格,X200 支持以下频段:
   - 4G:Band 1/3/5/8/34/38/39/40/41
   - 5G:n1/n3/n28/n41/n78/n79
   (来源:产品手册 V2.3 第 7 页 规格参数表)

Q: 我买了两年,屏幕摔坏了能免费修吗?
A: 这个问题我需要为你转接人工客服,请拨打 400-XXX-XXXX。
   (说明:保修政策中未包含意外损坏的免费维修条款,需人工判定)
第二问的"拒绝回答"是符合预期的——文档里确实没有免费维修条款,模型没有编造。这比硬答一个"可以免费维修"安全得多。
到这里一个可用的问答 Agent 就搭完了,全程没写一行代码。
五、再往上加一层:让 Agent 会查工单、会调接口
纯问答只能回答"文档里写了什么"。真实客服还需要"查这个用户的订单状态"。用 Dify 的 Agent 节点 + 自定义工具:
- 把你的内部接口按 OpenAPI/Swagger 描述(或写成 Dify 工作流当工具用),在"工具 → 自定义"里注册,填服务 URL 与鉴权;
- 应用类型选 Agent,挂上知识库 + 这个工具;
- 模型自己判断:查参数走知识库检索,查订单走工具调用。
进阶玩法(Dify 1.x 已支持):
- 知识编排(Knowledge Pipeline):可视化编排文档摄取、解析、切分、索引的全过程,把标准清洗逻辑做成可复用流水线,比默认"上传即索引"可控得多;
- 多模态检索:知识库支持图文联合理解,PDF 里的产品图、说明书示意图也能参与检索;
- 人机介入节点:在退款、改地址等敏感动作前插入人工审批——和第 2 篇 LangGraph 的
interrupt是同一个工程思想。
六、常见坑与排查清单
按"现象 → 原因 → 解法"整理:
- 答非所问 / 明明有答案却说不知道
先跑召回测试。召回不到 → 分段或 Embedding 问题(分段太碎、切断了完整段落);召回到了还答错 → 提示词约束不足或上下文太多互相矛盾。 - 答案把两份文档的内容混在一起
多文档交叉是高频事故。解法:文档打元数据标签按标签过滤检索、拆分成多个知识库、提示词强约束"仅依据上下文"。 - 表格、参数、价格答错
表格按文本切分会散架。解法:关键表格单独转成问答对模式,或用能保留表格结构的解析方式;涉及价格保修一律要求逐字引用。 - 默认分段策略直接上线,效果一般
按内容类型定制:技术文档按标题层级切、合同保留表格结构、论文注意段落完整性。 - 回答很慢
Rerank 会引入额外延迟。解法:控制 Top-K、给关键节点配结果缓存、无依赖节点用并行执行。 - 本地部署容器起不来 / 内存爆掉
检查宿主机资源,默认栈至少 4 核 8G;内存不足时优先精简向量库而非硬扛。 - 成本失控
Token 大头在检索片段过长。解法:Top-K 收敛、缓存、把长文档拆库按需检索、高频问题走小模型兜底。
七、和 LangGraph 到底怎么选
这是最常被问到的问题,一张表说清:
| 维度 | Dify | LangGraph |
|---|---|---|
| 上手门槛 | 低,可视化 | 高,需要写代码 |
| 知识库/RAG | 开箱即用,配置化 | 自己接,可控性强 |
| 复杂流程与循环 | 有工作流,但深度定制受限 | 状态图 + 条件边,表达力最强 |
| 精细状态控制/中间件 | 一般 | 强(Checkpointer、interrupt、reducer) |
| 私有化 | 支持,注意资源要求 | 支持,更灵活 |
| 团队维护 | 非工程角色也能改提示词和知识库 | 需要工程能力 |
| 适合场景 | 知识库问答、内部工具、客服流程 | 任务规划、多 Agent、复杂自主决策 |
务实建议:先用 Dify 验证需求是否成立,跑通了、要往复杂逻辑走的时候再换 LangGraph。 很多团队一上来就选"更强大"的框架,结果两周还没跑通第一版,需求本身已经被证伪了。
总结
本篇你完成了:
- 用 Dify 零代码搭出一个能回答私有文档的知识库问答 Agent;
- 理解了 RAG 链路各环节对应的配置旋钮,尤其是分段策略与混合检索;
- 掌握召回测试这个定位问题的关键手段,以及"只依据上下文、答不了转人工"这条安全约束;
- 通过自定义工具把问答升级成能查订单的 Agent。
下一篇预告:《AI Agent 常见报错与调试方法》——把 LangGraph、Dify、模型 API 三层最容易炸的问题整理成一张排查表,遇到问题按表定位,不再靠猜。
配套的《知识库分段参数速查表》和《产品手册问答完整 DSL》我打包好了,评论区回复"Dify"领取。
一站式 AI 云服务平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)