
【leetcode】(十)并查集与KMP算法
(一)并查集
1.岛问题
【题目】
一个矩阵中只有0和1两种值,每个位置都可以和自己的上、下、左、右四个位置相连,如果有一片1连在一起,这个部分叫做一个岛,求一个矩阵中有多少个岛?(leetcode hot 100,剑指offer105,leetcode1254)
【举例】
001010
111010
100100
000000
这个矩阵中有三个岛
【进阶】
如何设计一个并行算法解决这个问题
基础问题思路:先构造一个函数infact,它能够从左往右地遍历找到矩阵中的连成一片的1并把它们的值改为2,有几次感染过程,就找到了几个岛。示例:
010101
111101
100011
001000
代码:
package Class010;

public class Code_Islands {
    public static int countIslands(int[][]m){
        if(m==null||m[0]==null){
            return 0;
        }
        int N=m.length;//行
        int M=m[0].length;//列
        int res=0;//岛的数量
        //从左往右,从上到下
        for (int i=0;i<N;i++){
            for(int j=0;j<M;j++){
                if (m[i][j]==1){
                    res++;
                    //进入感染过程
                    infect(m,i,j,N,M);
                }
            }
        }
        return res;
    }
    public static void infect(int[][]m,int i,int j,int N,int M){
        if(i<0||i>=N||j<0||j>=M||m[i][j]!=1){
            return;
        }
        //i,j没越界,并且当前位置是1
        m[i][j]=2;
        infect(m,i+1,j,N,M);
        infect(m,i-1,j,N,M);
        infect(m,i,j+1,N,M);
        infect(m,i,j-1,N,M);
    }

    public static void main(String [] args){
        int[][] m1={{0,0,0,0,0,0,0,0,0},
                    {0,1,1,1,0,1,1,1,0},
                    {0,1,1,1,0,0,0,1,0},
                    {0,0,0,0,0,1,1,0,0},};
        System.out.println(countIslands(m1));
        int[][] m2={{0,0,0,0,0,0,1,0,0},
                    {0,1,1,1,0,1,1,1,0},
                    {0,1,1,1,0,0,0,1,0},
                    {0,0,0,0,0,1,1,0,0},
                    {0,0,0,0,0,1,1,0,0},
                    {0,1,1,0,0,0,0,0,0},};
        System.out.println(countIslands(m2));
    }
}
运行结果:
3
4
在整体遍历阶段,每个位置遍历一次;infect阶段,由于只对上下左右进行调用,因此一个位置最多被调用四次。算法的时间复杂度为O(N*M)。此解决方案只适用于单内存,单CPU,不能满足大规模的矩阵。
进阶问题思路:分块。不过之前先讲并查集的内容。
2.并查集
对于集合{a}{b}{c}{d}{e},并查集有如下操作:
bool issameset(a,b),在链表中,由于只能在a这个集合里判断有没有b的元素或者在b这个集合里判断有没有a这个集合的元素,时间复杂度做不到O(1);采用hash表表达集合结构,时间复杂度为O(1)
void union(a,b),在链表中,合并的时间复杂度是O(1);时间复杂度做不到O(1)。
因此如何设置一种结构,让查询的实现和合并的实现的时间复杂度都是O(1),这就是并查集要解决的问题。
假设a,b,c,d,e五个集合,在初始化的时候,每个集合设置一个指针指向它们自己,当IsSameset(a,b)进行判断的时候,先找到a集合中元素对应的点是谁,再找b集合中元素所对应的点是谁。具体操作是通过a往上找的指针直到a不能往上查找时来判断,也就是说a集合的代表元素就是(a),b集合的代表元素就是(b),如果它们的代表元素不是同一个,那么就不是一个集合。对于union方法,union(a,b),先调用isSameser(),发现不是,那么就可以合并,如果已经是同一个集合了,就不做任何操作;合并时,将b集合的向上指的指针指向a集合,此时再调用isSameset(a,b)方法,由于a集合所指的指针只能是a,b集合所指向的指针是a集合而a集合所指向的指针只能是a,于是a和b两个集合变成了一个(因为合并了),由于代表集合相同,isSameset返回true。
简而言之,就是用指针把两个集合挂在一起。
相对应的,如果b集合的指针挂到了a集合上(b->a),d集合的指针挂到了c集合上(d->c),如果使用isSameset(b,d)操作,那么由于b的代表集合是a,d的代表集合是c,两者不是同一个集合,会产生报错。如果要将b所在集合与e所在集合进行合并(union(b,e)),那么就将数量少的集合的指针挂到数量多的集合上(之前是b->a,现在添加了e->a,变成{b->a,e->a})。最后两个有挂载的集合进行合并,union(e,d),规则是,少的集合的顶直接挂在多的集合的顶的上面{e->a,b->a,d->c->a},最终形成了一个树状结构。如图所示:
            a
          / |  \
         b  e   c
                 \
                  e
在这个树的结构中,往上找的过程是有优化的。假设形成了这样一种集合结构,其中一条链的图像为(“/”和“\”表示指向上一级集合的指针):
            a
          /   \
         b     ?
        / \
       x
      /
     y
比如要查询节点y和未知节点?是不是同一个集合(issame(y,?)),最终y会指向a这个节点,注意,在找到的时候要进行一个操作,也就是把链条变成扁平的,也就是把整条链的父直接改成对a负责,如图所示:
      ______ a
     |  |  /   \
     |  | b     ?
     |  |
     |  x
     |
     y
这样就能将末尾节点找顶节点的过程进行节省,也就是路径压缩原理。经过这次优化后,节点y和x下一次再需要寻找a这个顶点时,就能省去在长链条上查找的过长步骤,能够一步到位。
示例代码:
package Class010;

import java.util.HashMap;
import java.util.List;
import java.util.Stack;

public class Code_UnionFind {
    //样本进来会包一层,叫做元素
    public static class Element<V>{
        public V value;
        public Element(V value){
            this.value=value;
        }
    }
//    对于如图的树状结构:
//            a
//          /   \
//         b     d
//          \
//           c
//
    public static class UnionFindSet<V>{
        //样本对应自己的元素表,记录对应关系,比如a对应a,b对应b,这是第一张表
        public HashMap<V,Element<V>>elementMap;
        //key 某个元素value 该元素的父
        //比如a对应a,b对应a,c对应b,d对应a,这是第二张表
        public HashMap<Element<V>,Element<V>>fatherMap;
        //key 某个集合的代表元素 value 该集合的大小
        //表示代表集合所在的元素有几个点
        //比如在这棵树中,a的value是4
        public HashMap<Element<V>,Integer>sizeMap;
        public UnionFindSet(List<V> list){
            elementMap=new HashMap<>();
            fatherMap=new HashMap<>();
            sizeMap=new HashMap<>();
            //将所有结构存入,初始化
            for (V value:list){
                Element<V>element=new Element<V>(value);
                elementMap.put(value,element);
                //一开始,每个元素的fathermap是它自己
                fatherMap.put(element,element);
                //因为一开始每个集合都是自己,它们都是自己的代表元素,大小是1
                sizeMap.put(element,1);
            }
        }
        //给定一个ele,往上一直找,把代表元素返回
        private Element<V>findHead(Element<V>element){
            Stack<Element<V>>path=new Stack<>();
            //element不等于父,就一直往上跳
            while (element!=fatherMap.get(element)){
                //在这个过程中,将沿途元素加入到栈里面去
                path.push(element);
                //最后退出循环的时候,element已经变成了父
                element=fatherMap.get(element);
            }
            //在返回前,把所有元素的fatther直接设置成最顶部的元素。
            while (!path.isEmpty()){
                fatherMap.put(path.pop(),element);
            }
            return element;
        }
        public boolean isSameSet(V a,V b){
            //确保每个样本有对应关系,必须初始化后才能查询
            if (elementMap.containsKey(a)&&elementMap.containsKey(b)){
                //返回代表元素是否相同的判断
                return findHead(elementMap.get(a))==findHead(elementMap.get(b));
            }
            return false;
        }
        public void union(V a,V b){
            if (elementMap.containsKey(a)&&elementMap.containsKey(b)){
                //找到元素a和b的代表节点
                Element<V>aF=findHead(elementMap.get(a));
                Element<V>bF=findHead(elementMap.get(b));
                //不是一个集合,可以合并
                if(aF!=bF){
                    //元素数量较少的集合的顶端元素(代表节点)挂在元素数量较多的集合的顶端元素(代表元素)下面
                    //较大的给big,较小的给samll
                    Element<V>big=sizeMap.get(aF)>=sizeMap.get(bF)?aF:bF;
                    Element<V>small=big==aF?bF:aF;
                    //small是较小节点,改变其父的走向到大集合
                    fatherMap.put(small,big);
                    //大集合接受小的代表节点的value值
                    sizeMap.put(big, sizeMap.get(aF)+sizeMap.get(bF));
                    //删除small的代表节点
                    sizeMap.remove(small);
                }
            }
        }

    }
}
并查集同时使用按照大小合并于路径压缩,那么单次操作的时间复杂度是O(1)。比如说有1000个节点,全都将指针接到头节点上去,如果要普遍查询父节点(查询量接近O(N)的规模),那么平均查询的时间复杂度就是O(N)/N=O(1),由于O(N)的原复杂度函数(反 Ackermann 函数,Inverse Ackermann Function)增长非常缓慢,即使N=10^80,返回值依旧是6,是个位数水平,因此可以看作O(1)的复杂度。证明过于复杂,略。
一种常见的 Ackermann 函数定义:
A(0,n) = n+1
A(1,n) = n+2
A(2,n) = 2n+3
A(3,n) ≈ 2^(n+3)-3
A(4,n) 已经增长得极其夸张
它的反函数为:
A(1,4) = 6
A(2,4) = 11
A(3,4) = 125
A(4,4) = 一个极其巨大的数字
对应的:
n <= 6 -> α(n) <= 1
n <= 11 -> α(n) <= 2
n <= 125 -> α(n) <= 3
n <= A(4,4) -> α(n) <= 4
其中:
A(4,4)已经是大多数计算机无法处理的水平,综合来看可以认为是O(1)的规模。
3.岛问题的多cpu情况的解决
先就两块cpu和一个大的二维数组的情况进行讨论,如图所示:
11111111
10000001
10111111
10100000
10111111
10000001
11111111
在这张图中,其实所有的1都是连成一片的,但是将数组切分之后,cpu处理时,分别会把它看作多个岛屿,左侧cpu会找到两个岛,右侧cpu会找到两个岛。如图所示(处理后1应该替换成2):
1111    1111
1000    0001
1011    1111
1010    0000
1011    1111
1000    0001
1111    1111
2222    2222
2000    0002
2022    2222
2020    0000
2022    2222
2000    0002
2222    2222
那么合并逻辑应该怎么做?岛的数量初始为4,可以为每个岛设置一个初始感染点,左侧区域有2个初始感染点A(1,1)和B(3,3);右侧有两个初始感染点C(1,5)和D(5,5)。A记录边界点(1,4)和(7,4),B记录边界点(3,4)和(5,4);C记录边界点(1,5)和(3,5),D记录边界点(5,5)和(7,5)。
接下来做合并。将感染点和对应的边界点形成一个集合,分别为{A}{B}{C}{D},如果发生了边界相互碰撞的情形(左半边的边界点和右半边的边界点相邻)。发现{A}中的(1,4)和{C}中的(1,5)相邻,于是合并两个集合,原来的总集合{{A},{B},{C},{D}}变为{{B},{A,C},{D}},岛的数量减1,;接着发现{B}中的(3,4)和{A,C}中的(3,5)相邻,于是合并两个集合,岛的数量减1,总集合变为{{A,C,B},{D}};最后发现{D}中的(5,5)和{A,C,B}中的(5,4)相邻,于是合并两个集合,岛的数量减1,总集合变为{{A,C,B,D}}。岛的数量最终确定为1个。
同样的,多cpu的计算中,每个cpu需要统计4条边界的点的信息,然后不断与其它cpu进行合并操作,这样可以节约大量的时间。这与hadoop的mapreduce原理类似。
(二)KMP算法
kmp算法要解决的问题是查询str2是否是str1的一个子字符串,比如两个字符串str1“ABC1234de”和str2“1234”,str1确实包含str2。
暴力解法是查询每一个str的开头字符,看看能不能查询到str2(滑动窗口匹配)。但是这种方法的时间复杂度可能特别高,假设str1.length=N,str2.length=M,时间复杂度为O(N*M)。比如遇到str1是“1111111112”,str2“1112”按照这种思路匹配在“1”和“2”两个字符上耗费大量的步骤时间。
为了降低时间复杂度,有必要采用kmp算法来加速这个过程(leetcode28)。
在讲kmp算法之前,先要理清两个概念:前缀后缀最大匹配长度(前缀和后缀不能等于整个字符串长度),适用于str2
对于字符串abbabb
长度    1    2    3    4      5        6
前缀    a   ab   abb  abba  abbab    abbabb
后缀    b   ab   abb  babb  bbabb    abbabb
相等    n    n    y    n      n      (不讨论)
前缀后缀最大匹配长度k的值记为3
对于重复长前缀字符串“aaaaa”:
对于重复长前缀字符串“aaaaa”:
长度    1    2    3    4      5
前缀    a   aa   aaa  aaaa  aaaaa
后缀    a   aa   aaa  aaaa  aaaaa
相等    y    y    y    y   (不讨论)
前缀后缀最大匹配长度k的值记为4
对于原字符“aabaabsaabaabst”,通过以上的计算,可以得到一个next数组,现在以这个str的前10个字符为例,0位置的信息人为规定为-1,1位置的信息由于没有前缀,规定为0;移动到2位置时,对应“aa”;移动到3时,对应“aab”;移动到4时,对应为“aaba”。以此类推,得到了next数组。
str2 [a,a,b,a,a,b,s,a,a,b,a,a,b,s,t]
位置[0,1,2,3,4,5,6,7,8,9,10,11,12,13,14]
next [-1,0,1,0,1,2,3,.......]
在得到next数组后,如何进行加速?我们设str1中第一个字符位置为i,str2中第一个字符为0,L = next[y];在比对中,我们设str1最后一个不匹配的字符为x,str2最后一个不匹配的字符为y,由于有next数组,str2已经匹配的字符[0,......,y],在[0,......,y-1]已经能够完全匹配的字符中,前一半是前缀(y/2个),后一半为后缀(y/2个),接着得到str1中对应匹配的位置(记为j,j=i+y-L)将str2的0位置平移到str1对应的j位置进行比较。由于对称性,原来的str中的[i~j]位置的字符和[i~x]位置的字符相同,str2中的[0~y/2]与[y/2~y]位置的字符相同,因此可以这样将str2直接移动到str1中可能不同的位置开始往下验证。与此同时,我们还可以知道,str1中的[i~j]之间的字符配不出str2的字符。
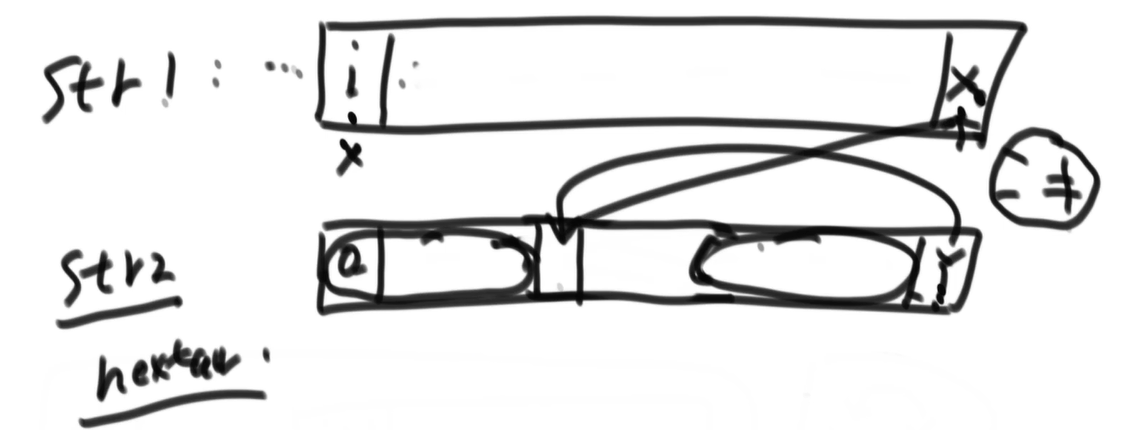
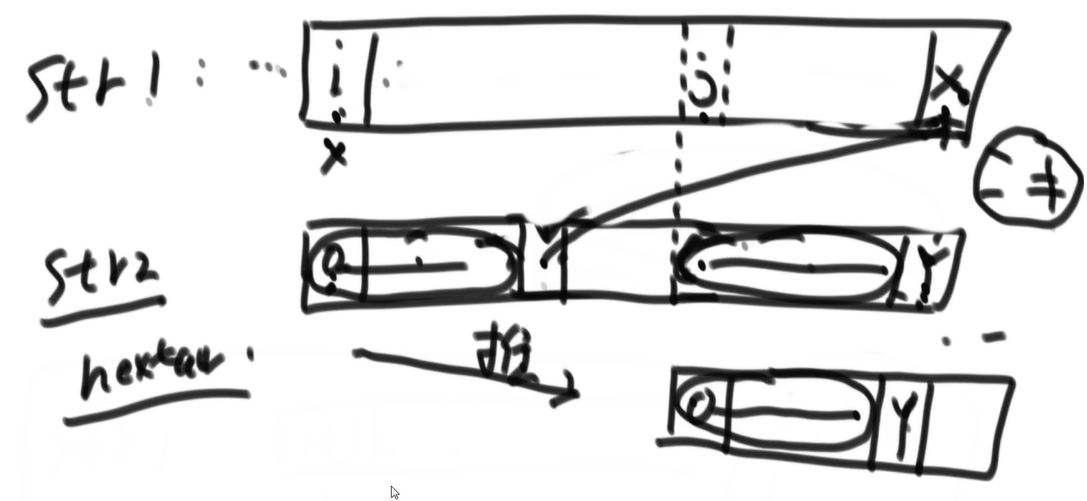
举例:str1:abbstkabbstka;str2:abbstkabbstk。
str1:abbstkscabbstks。。。。。。
     i       j     n
str2:abbstk|sc|abbstkz。。。。。。
     0               n
str2:--------abbstkscabbstkz。。。。。。
此时,j之前可以认定无法匹配,于是将str2的a[0]直接移动到对应str2的a[j]位置进行比对
跳过了8个字符的重复比对,故称为加速
现在用反证法证明为什么i和j中不存在一个k能够使得str2从k开始匹配成功?
当前已经匹配:str1[i ... i+y-1] = str2[0 ... y-1]
设:L = next[y]
因此KMP移动:y-L
新起点:j = i+y-L
反设i和j之间存在:k=i+d
其中:0<d<y-L
如果从k开始也能匹配,那么重叠部分必须满足:str2[d ... y-1]=str2[0 ... y-d-1]
说明str2[0 ... y-1]存在长度y-d的相等前后缀。而:
d < y-L=> y-d > L
这说明存在比L更长的相等前后缀,与L是最长前后缀匹配长度矛盾。
所以:i和j之间不可能存在合法匹配起点。
这就是 KMP 能“放心大胆跳过一段位置”的数学依据。
具体字符串例子:
已知已经匹配成功的部分是:
ababab
它的最长相等前后缀是:
前缀:abab
后缀:abab
所以:
L = 4
y = 6
KMP应该移动:
y - L
= 6 - 4
= 2
原来的匹配:
str1:  a b a b a b X
↑
i
str2:  a b a b a b Y
前6个字符都匹配:
ababab = ababab
到了下一位:
X != Y
所以发生失配。
根据next信息,直接把str2右移2位:
str1:  a b a b a b X
↑
j
str2:      a b a b a b Y
这里:
j = i + 2
为什么不能只移动1位?
假设只移动1位:
str1:  a b a b a b X
↑
k
str2:    a b a b a b Y
那么如果从k位置开始还能匹配,就要求重叠部分满足:
str1中的:
b a b a b
必须等于str2前5个字符:
a b a b a
也就是要求:
babab = ababa
显然不相等。
换个角度说,如果移动1位还能匹配成功,就意味着原字符串:
ababab
存在长度5的相同前缀和后缀:
前缀长度5:
ababa
后缀长度5:
babab
但:
ababa != babab
所以长度5不成立。
而我们已经知道最长相等前后缀长度只有:
4
因此移动1位不可能成功。
所以可以直接跳过1位,移动2位:
ababab
ababab
这就是KMP加速的地方。
代码:
package Class010;

public class Code_KMP {
    //N>=M
    public static int getIndexOf(String s,String m){
        if(s==null||m==null||m.length()<1||s.length()<m.length()){
            return -1;
        }
        char[] str1=s.toCharArray();
        char[] str2=m.toCharArray();
        int i1=0;
        int i2=0;
        int[] next=getNextArray(str2);//O(M)
        //O(N)
        while (i1<str1.length&&i2<str2.length){
            if (str1[i1]==str2[i2]){
                i1++;
                i2++;
            }else if (next[i2]==-1){//等价于i2==0.str2中i2已经无法往前跳了
                i1++;
            }else {
                i2=next[i2];
            }
        }
        //i1越界 或者i2 越界
        return i2==str2.length?i1-i2:-1;
    }
    public static int[] getNextArray(char[] ms){
        if(ms.length==1){
            return new int[]{-1};
        }
        int[] next=new int[ms.length];
        next[0]=-1;
        next[1]=0;
        int i=2;//next数组的位置
        //cn既代表哪个位置的字符在和i-1位置的字符比,比如i-1位置的字符值是7,那么cn的位置也是7
        //cn也代表当前使用的信息是多少
        int cn=0;
        while (i<next.length){
            //cn位置的字符等于i-1位置的字符的时候,
            if (ms[i-1]==ms[cn]){
                //next[i]=cn+1
                //i++
                //cn++,以便i+1位置判断下一个
                next[i++]=++cn;
            }
            //当前跳到cn位置的字符,和i-1位置字符匹配不上
            else if (cn>0){
                cn=next[cn];
            }else {
                next[i++]=0;
            }
        }
        return next;
    }
    public static void main(String[] args) {
        // 测试1:普通情况,中间找到
        String str1 = "ABC1234de";
        String str2 = "1234";
        System.out.println(getIndexOf(str1, str2));
        // 结果:3
        // 测试2:从开头就匹配
        str1 = "abcdef";
        str2 = "abc";
        System.out.println(getIndexOf(str1, str2));
        // 结果:0
        // 测试3:在末尾匹配
        str1 = "abcdef";
        str2 = "def";
        System.out.println(getIndexOf(str1, str2));
        // 结果:3
        // 测试4:不存在
        str1 = "abcdef";
        str2 = "xyz";
        System.out.println(getIndexOf(str1, str2));
        // 结果:-1
        // 测试5:大量重复字符,体现KMP优势
        str1 = "1111111112";
        str2 = "1112";
        System.out.println(getIndexOf(str1, str2));
        // 结果:6
        // 测试6:模式串与主串完全相同
        str1 = "ababab";
        str2 = "ababab";
        System.out.println(getIndexOf(str1, str2));
        // 结果:0
        // 测试7:有相同前后缀
        str1 = "xxabababyy";
        str2 = "ababab";
        System.out.println(getIndexOf(str1, str2));
        // 结果:2
        // 测试8:KMP典型重复结构
        str1 = "aabaabsaabaabst";
        str2 = "aabaabst";
        System.out.println(getIndexOf(str1, str2));
        // 结果:7
        // 测试9:模式串长度大于主串
        str1 = "abc";
        str2 = "abcdef";
        System.out.println(getIndexOf(str1, str2));
        // 结果:-1
        // 测试10:单字符匹配
        str1 = "abcdef";
        str2 = "d";
        System.out.println(getIndexOf(str1, str2));
        // 结果:3
        // 测试11:单字符不存在
        str1 = "abcdef";
        str2 = "x";
        System.out.println(getIndexOf(str1, str2));
        // 结果:-1
        // 测试12:查看next数组
        String pattern = "aabaabsaabaabst";
        int[] next = getNextArray(pattern.toCharArray());
        System.out.println("next数组:");
        for (int value : next) {
            System.out.print(value + " ");
        }
    }
}
运行结果:
3
0
3
-1
6
0
2
7
-1
3
-1
next数组:
-1 0 1 0 1 2 3 0 1 2 3 4 5 6 7
时间复杂度分析:
在getIndexof三个while循环中,str1->N,i1(max->N),i1-i2(max->N)。
| 循环 | i1 | i2 |
| (1) | 上升 | 不变 |
| (2) | 上升 | 上升 |
| (3) | 不变 | 上升 |
总的来说,三个循环的时间复杂度不会超过O(2N),于是总复杂度为O(N)
next数组相关代码理解;如何求next数组的第i位的值?方法:取next数组第i-1位的值,假设i-1位置是a且值为7,它之前的字符串为“abcdefgacabcdefg”(前缀是abcdefg,后缀是abcdefg),那么i位置的值为8。也就是说,在得知i-1位置的值时,比对前缀+1与后缀+1的最后一个字符是否一样,如果一样,那么i位置的值为i-1位置的值+1;如果不一样,那就从i-1对应的最长前缀字符开始往前跳,判断有几个前缀,
下面用一个例子说明:
abbstabb|ec|abbstabb  ?

0                 (i-1)i

其中,?对应的是i-1

如果?=e,那么i=8+1=9
如果?!=e,那么i-1的位置往前跳到e,此时e的位置的值为3,
如果e对应的s又和它不相等,那么i-1的位置继续跳到s,如果?=s,那么i=3+1=4
如果?!=s,由于s位置的信息是0,那么i-1位置跳到a位置,如果?=a,那么i=1,如果?!=a,那么i=0
在getNextArray的while循环中,i->M,i-cn->M
| 循环 | i | i-cn |
| (1) | 上升 | 上升 |
| (2) | 上升 | 上升 |
| (3) | 上升 | 上升 |
总的来说,三个循环的时间复杂度不会超过O(2M),于是总复杂度为O(M),也是线性的。
O(N)+O(M)=O(M+N),由于N>M,所以KMP算法总的时间复杂度可以看作O(N)。
一站式 AI 云服务平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)