
基于某渲染引擎二次封装企业级CRUD组件:从Proxy协议到“零代码”增删改查
基于某渲染引擎二次封装企业级 CRUD 组件:从 Proxy 协议到"零代码"增删改查
说明:本文分析对象为某开源数据渲染引擎,出于合规考虑,正文以「某渲染引擎」「编排层 D」「代理协议」「插件模块群 E」等代称指代,所有代码均为重写后的简化伪代码,仅用于说明设计思路,与真实源码存在差异。
引言:为什么你的表格页面总是 800 行
先看两个真实(化名后)的业务页面代码量对比。
手工模式:一个标准列表页,约 800 行。
<!-- 手工模式:分页 / 查询 / 增删改查全部手写 -->
<script setup>
const list = ref([])
const loading = ref(false)
const total = ref(0)
const page = ref({ currentPage: 1, pageSize: 20 })
const searchForm = ref({ name: '', status: '' })

async function fetchList() {
  loading.value = true
  try {
    const res = await api.getUserList({
      ...searchForm.value,
      page: page.value.currentPage,
      size: page.value.pageSize
    })
    list.value = res.data.list
    total.value = res.data.total
  } finally {
    loading.value = false
  }
}

async function handleSearch() {
  page.value.currentPage = 1     // 别忘了重置页码!
  await fetchList()
}

async function handleDelete(row) {
  await confirm('确认删除?')
  await api.deleteUser(row.id)
  message.success('删除成功')
  await fetchList()
}

async function handleSave(rows) {
  await api.batchSave(rows)
  message.success('保存成功')
  await fetchList()
}

async function handlePageChange(p) {
  page.value.currentPage = p
  await fetchList()
}

onMounted(fetchList)
</script>
这段代码你写过多少遍?分页、loading、重置页码、删除后刷新、保存后刷新——每个列表页都要抄一遍。
编排模式:同样的页面,约 30 行。
<!-- 编排模式:只声明"要什么",不写"怎么做" -->
<template>
  <Grid
    v-bind="gridOptions"
    @page-change="({ currentPage }) => gridOptions.proxyConfig.ajax.query({ currentPage })"
  />
</template>

<script setup>
const gridOptions = reactive({
  columns: [
    { field: 'name', title: '姓名', editRender: { name: 'input' } },
    { field: 'status', title: '状态' }
  ],
  pagerConfig: { enabled: true },
  formConfig: { items: [{ field: 'name', title: '姓名' }] },
  toolbarConfig: { buttons: [{ code: 'insert' }, { code: 'remove' }, { code: 'save' }] },
  editConfig: { trigger: 'click', mode: 'cell' },
  proxyConfig: {
    ajax: {
      query: ({ page }) => api.getUserList({ page: page.currentPage, size: page.pageSize }),
      save: ({ body }) => api.batchSave(body),
      delete: ({ body }) => api.deleteUser(body.removeRecords.map(r => r.id))
    }
  }
})
</script>
这 770 行的差距,就是"代理协议"这个设计的价值。
这篇是《面试官问我 10 万行数据怎么渲染不卡》的续篇。上一篇讲的是引擎内部怎么扛住数据量,这一篇讲的是业务侧怎么用一条协议把 CRUD 全流程串起来。如果你正在做中后台系统的组件库封装,这篇的每一节都能直接落地。
一、代理模式的核心:把 CRUD 抽象成四个动作
1.1 传统封装的困境
如果你自己尝试封装过"企业级表格",大概率会走到一个死胡同:
// 典型的手工封装:参数越加越多
<SmartTable
  :url="'/api/user/list'"
  :params="searchForm"
  :auto-load="true"
  :need-pagination="true"
  :delete-url="'/api/user/delete'"
  :save-url="'/api/user/save'"
  :before-query="beforeQuery"
  :after-query="afterQuery"
  ...
/>
问题在于:每个业务的后端接口形状都不一样。 有的返回 { data: { list, total } },有的返回 { result: [], page: { total } },有的查询用 GET,有的用 POST,有的删除要传数组,有的要传单个 ID。
参数越加越多,最后你封装的不是一个组件,而是一个需要用户学习的新框架。
1.2 代理协议的解法:约定四个动作 + 一个适配层
引擎的设计者换了个思路:不规定接口长什么样,只规定"什么时候调用你"。
它定义了四个(实际是五个)标准动作:
// 简化伪代码:代理配置协议
proxyConfig = {
  ajax: {
    query:        handler,   // 查询(含分页/排序/筛选)
    save:         handler,   // 保存(新增或更新)
    delete:       handler,   // 删除
    queryFooter:  handler,   // 查询表尾汇总(可选)
    queryDetail:  handler    // 查询详情(可选)
  }
}
每个 handler 都是用户自己写的异步函数,返回什么由用户决定,引擎只负责在合适的时机调用它,然后处理返回值。
关键点在于:引擎不关心你的 HTTP 方法、URL、请求体格式。 你写什么它就调什么:
// 用户可以这么写(GET + 自定义字段)
query: ({ page, sort, filter, form }) =>
  request.get('/user/list', { params: { p: page.currentPage, s: page.pageSize, ...form } })

// 也可以这么写(完全不同的风格)
query: async ({ page }) => {
  const res = await myApi({
    method: 'POST',
    data: { pageIndex: page.currentPage - 1, pageSize: page.pageSize }
  })
  return { list: res.records, total: res.totalCount }   // 这里返回什么形状很重要,见下节
}
这才是"可复用"的正确姿势:约束时序,不约束协议。
1.3 实战:最小可用的封装
假设我们要封装一个 <SmartTable>,第一版可以这样:
<script setup>
const props = defineProps({
  // 只暴露"四个动作",不暴露 URL
  query: { type: Function, required: true },
  save: { type: Function },
  remove: { type: Function },
  columns: { type: Array, required: true }
})

const gridOptions = reactive({
  columns: props.columns,
  pagerConfig: { enabled: true, pageSize: 20 },
  editConfig: { trigger: 'click', mode: 'cell' },
  proxyConfig: {
    ajax: {
      query: props.query,
      save: props.save,
      delete: props.remove
    },
    // 字段适配层,见下节
    response: { result: 'data.list', total: 'data.total' }
  }
})
</script>

<template>
  <Grid v-bind="gridOptions" />
</template>
业务侧的使用成本降到了一句话:
“告诉我怎么查、怎么存、怎么删,剩下的分页、loading、重查、校验、提示我来做。”
在这里插入图片描述
二、字段适配层:解决"后端返回形状不统一"的痛点
2.1 问题复现
上一节留了个坑:query 返回的数据形状不一致怎么办?
后端 A 返回:
{ "code": 0, "data": { "list": [...], "total": 100 } }
后端 B 返回:
{ "success": true, "result": [...], "page": { "total": 100, "totalPages": 5 } }
如果引擎写死了取 res.data.list,那 B 就用不了。
2.2 引擎的解法:响应路径映射 + 函数式取值
某渲染引擎的代理协议里有一个 response(旧版叫 props)配置,专门做这层适配:
// 简化伪代码:响应字段适配
proxyConfig = {
  response: {
    list:       'data.list',       // 列表数据在哪
    result:     'data.list',       // 列表数据(同义,兼容新旧)
    total:      'data.total',      // 总数在哪
    message:    'msg',             // 提示文案在哪
    footerData: 'data.footer',     // 表尾汇总在哪
    // 支持函数式取值,应对复杂结构
    result: (params) => params.data.custom.path.to.list
  }
}
引擎内部处理时,会判断这个配置是字符串路径还是函数:
// 简化伪代码:统一取值
function pickValue(propCfg, rest, reParams) {
  if (isFunction(propCfg)) {
    // 函数式:直接调用,把整个响应体给它
    return propCfg(reParams)
  }
  // 字符串式:当作对象路径解析
  return getByPath(rest, propCfg || 'result')
}
字符串路径覆盖 90% 的常规场景,函数兜底剩下 10% 的畸形结构。 这个 dual 设计非常值得抄。
2.3 实战:把适配层封装成"接口规范接收器"
在封装时,我们可以把 response 配置从业务侧隐藏,做成预设:
// 简化伪代码:预设两套常用规范
const RESP_STANDARDS = {
  // 规范 A:code/data 包装
  codeData: {
    result: 'data.list',
    total: 'data.total',
    message: 'msg'
  },
  // 规范 B:success/result 包装
  successResult: {
    result: 'result',
    total: 'page.total',
    message: 'message'
  }
}

// 封装组件根据 props.standard 自动选择
const response = RESP_STANDARDS[props.standard] || props.response
业务方接入时只需要说一句"我们用规范 A",不用再逐字段配对。
2.4 边界校验:别忘了页码越界
还有一个容易被忽略的细节。引擎在拿到总数后会做一次页码合法性校验:
// 简化伪代码:查询后校验页码
const total = toNumber(pickValue(resConfigs.total, rest, reParams))
const pageCount = Math.max(Math.ceil(total / pageSize), 1)

// 如果当前页码超过了新的总页数,把它拉回来
if (currentPage > pageCount) {
  currentPage = pageCount
}
为什么需要这个?设想场景:用户在第 10 页,然后输入了一个筛选条件让结果只剩 1 页。查询返回 total = 5,如果不管,页面会显示"第 10 页 / 共 1 页",数据是空的,用户以为没数据。
这类"跨状态一致性"的细节,就是自研封装和成熟引擎的差距所在。 你在自己封装时,最好把这行代码写进去。
三、时序编排:before/after/成功/失败四段钩子
3.1 一个查询请求,其实有六个可插入点
很多人的封装只提供了 query 一个钩子。但实际上,一个完整的查询流程包含六个可插入点:
// 简化伪代码:查询的完整钩子链
ajax: {
  beforeQuery,        // 查询前:可以改参数、可以拦截(返回 false 阻止)
  query,              // 查询本体
  afterQuery,         // 查询后:拿到原始响应,可完全接管数据处理
  querySuccess,       // 成功后:拿处理结果
  queryError,         // 失败后:拿错误
  queryFooter         // 表尾单独查询(可选)
}
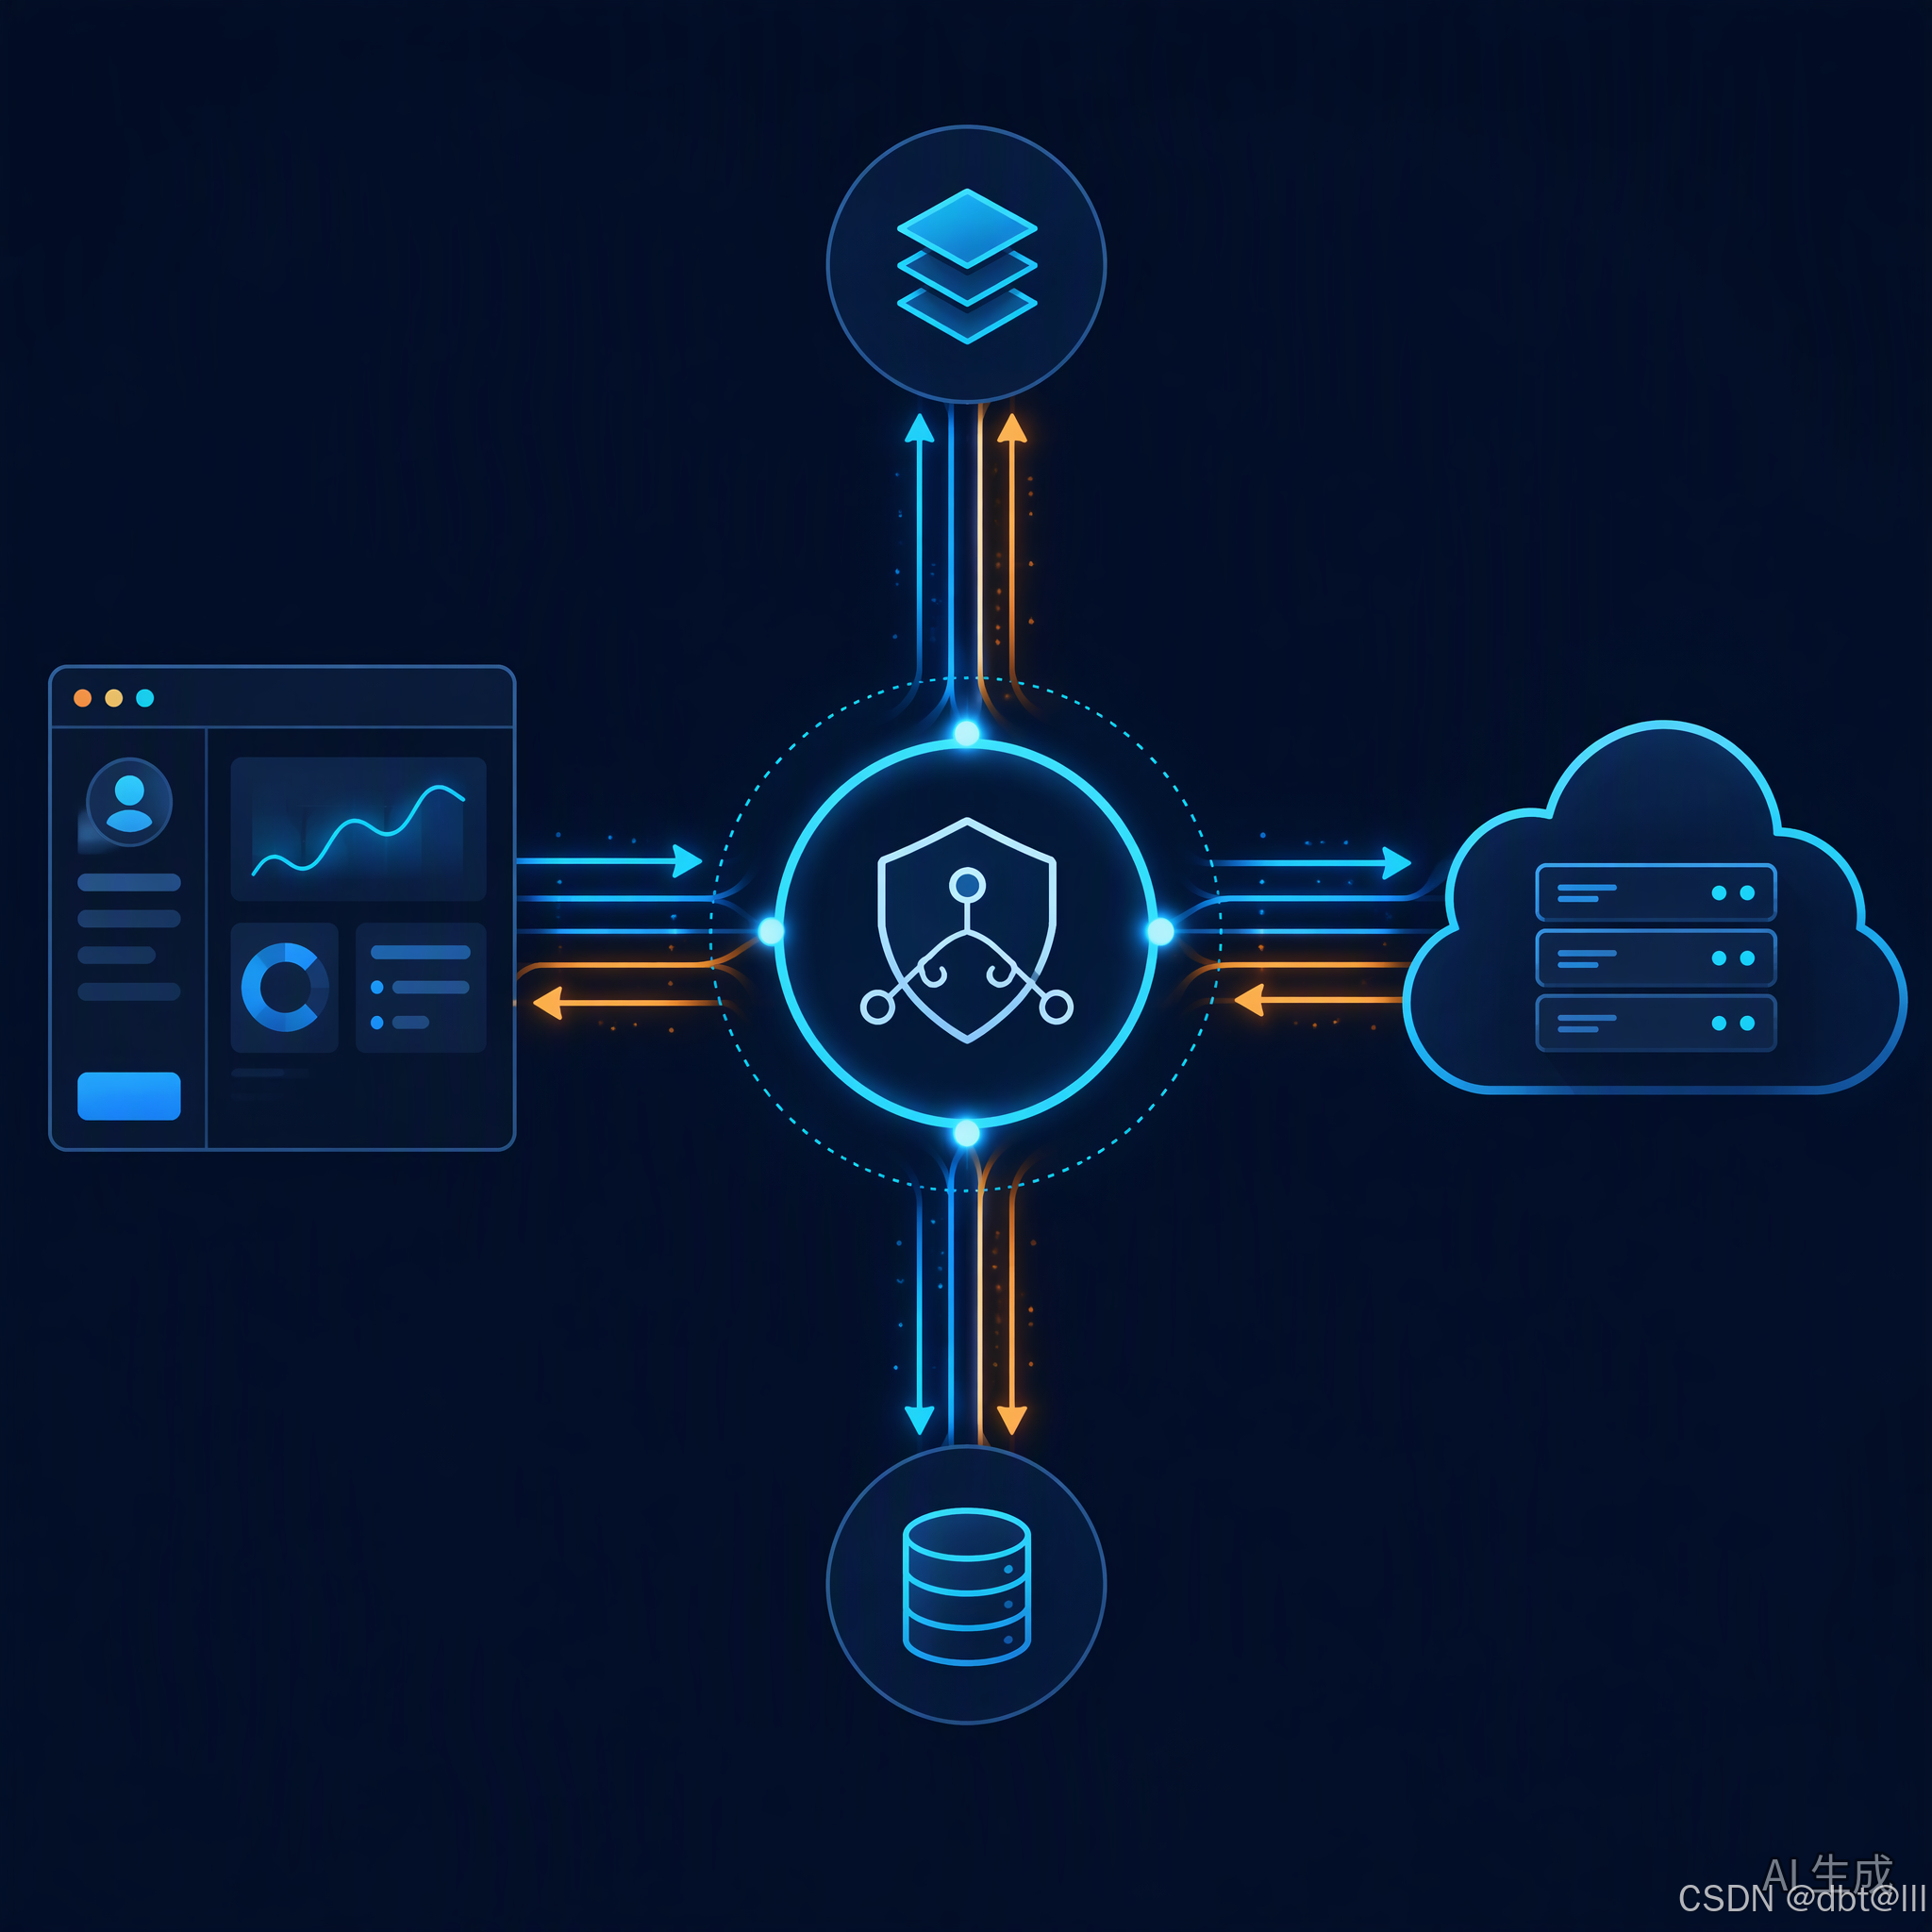
引擎在内部是这样编排的:
// 简化伪代码:查询编排
function handleQuery() {
  loading = true

  // 1. 并发执行:beforeQuery + 前置操作(如保存未提交的编辑)
  return Promise.all([
    Promise.resolve((beforeQuery || query)(commitParams, ...args)),
    pendingOperation        // 例如:先把编辑中的数据保存掉
  ]).then(([rest]) => {
    loading = false

    // 2. afterQuery 存在则完全接管,否则走默认解析
    if (afterQuery) {
      afterQuery({ ...commitParams, response: rest, status: 'success' })
    } else {
      // 默认解析:适配字段 → 加载数据 → 更新分页
      const tableData = pickValue(resConfigs.result, rest, reParams)
      table.loadData(tableData)
    }

    // 3. 成功回调
    if (querySuccess) {
      querySuccess({ ...commitParams, response: rest })
    }
    return { status: true }
  }).catch((rest) => {
    loading = false
    if (afterQuery) {
      afterQuery({ ...commitParams, response: rest, status: 'error' })
    }
    if (queryError) {
      queryError({ ...commitParams, response: rest })
    }
    return { status: false }
  })
}
3.2 三个值得抄的设计点
① beforeQuery 返回 false 可以中断流程。
// 简化伪代码:查询前置拦截
if (bqMethod) {
  return Promise.resolve(bqMethod(commitParams, ...args)).then(status => {
    if (status !== false) {
      return handleQuery()   // 只有不返回 false 才继续
    }
    // 返回 false:流程终止
  })
}
这个设计对"表单校验不通过就不发请求"非常有用:
beforeQuery: async () => {
  const valid = await formRef.value.validate()
  return valid ? undefined : false   // 校验失败,阻止查询
}
② 并发执行"前置操作"和"查询"。
注意上面 Promise.all([...]) 里的第二项。这是一个很精妙的设计:查询之前,可能需要先把当前编辑中的单元格提交掉,避免用户改了数据一查就没了。
// 简化伪代码:把未提交的编辑操作挂起,与查询并发
let operPromise = null
if (editConfig && isEnabled(editOpts)) {
  // 提交所有激活的编辑单元格
  operPromise = $table.clearActived()   // 返回 Promise
}
并发而不是串行,省掉了一次等待。这种"把两个无依赖的异步操作并起来"的细节,是性能敏感场景的常备手段。
③ 幂等保护:查询中禁止重复查询。
// 简化伪代码
if (!isInited && viewState.tableLoading) {
  return nextTick()   // 正在查询中,直接返回,不重复发请求
}
用户狂点"查询"按钮时,这个判断能省掉大量无效请求。你自己封装时一定要加。
3.3 保存/删除的钩子链更完整
保存和删除的钩子比查询还多一层**“操作消息”**:
// 简化伪代码:保存的钩子链
ajax: {
  beforeSave,     // 保存前(可拦截)
  save,           // 保存本体
  afterSave,      // 保存后
  saveSuccess,    // 成功
  saveError       // 失败
}
而且引擎会自动处理保存后是否重查:
// 简化伪代码:保存成功的后续流程
.then(() => {
  if (saveOpts.reload) {
    commitProxy('query')   // 自动重新查询
  }
})
reload 这个开关很有用:有些场景希望保存后重新查(保证拿到服务端计算字段),有些场景希望只做本地更新(避免闪烁)。做成配置项而不是写死,是成熟设计的表现。
四、工具栏与编辑:把"代码"变成"配置"
4.1 工具栏按钮 = 命令标识
有些引擎的工具栏不接受"组件",而接受命令码:
// 简化伪代码:工具栏配置
toolbarConfig = {
  buttons: [
    { code: 'insert',  name: '新增' },
    { code: 'remove',  name: '删除', permission: 'user:del' },
    { code: 'save',    name: '保存' },
    { code: 'export',  name: '导出' },
    { code: 'reset_custom', name: '重置列' }
  ]
}
注意这里的 code 不是 UI 文案,而是引擎内置的命令标识。内置了哪些?看源码里的 switch 分支:
// 简化伪代码:内置命令分发
switch (code) {
  case 'insert':       return table.insert({})
  case 'insert_edit':  return table.insert({}).then(({ row }) => table.setEditRow(row, true))
  case 'remove':       return handleDeleteRow(code, () => table.removeCheckboxRow())
  case 'save':         return handleSave()
  case 'export':       return table.exportData(btnParams)
  case 'reset_custom': return table.resetCustom(true)
  default:             return commandRegistry.get(code)?.handler()
}
这带来了一个巨大的封装红利:新增/删除/保存/导出这些操作,业务侧一行脚本都不用写。
而且注意最后那个 default 分支:未知命令码会去查一个"命令注册表"。这就是留给二次封装的扩展点——
// 简化伪代码:注册自定义命令
HostCore.commands.add('myCustomAction', {
  commandMethod({ $table, $grid, code }, ...args) {
    // 自定义逻辑
  }
})
于是可以这么干:业务层的快捷操作全部沉淀为命令码,配置文件里只出现字符串。
// 最终形态:纯配置
toolbarConfig: {
  buttons: [
    { code: 'insert' },
    { code: 'remove' },
    { code: 'save' },
    { code: 'auditBatch' },     // 自定义:批量审核
    { code: 'syncThirdParty' }  // 自定义:同步第三方
  ]
}
4.2 编辑模式:三种粒度 + 一个"读写分离"缓冲
编辑能力也做成了配置:
// 简化伪代码:编辑配置
editConfig = {
  trigger: 'click',    // 触发方式:click / dblclick / manual
  mode: 'cell',        // 单元格级 / 行级
  showStatus: true,    // 显示脏标记
  autoClear: true,     // 失焦自动清理
  beforeEditMethod,    // 编辑前校验(决定该单元格能否编辑)
  activeMethod         // 激活前判断(如已审核行不可编辑)
}
mode: 'cell' 和 mode: 'row' 的区别体现在渲染分发上:
// 简化伪代码:编辑态渲染分发
if (editOpts.mode === 'cell') {
  return isNestedCell
    ? renderNestedCellEdit(params)    // 深层树形单元格编辑
    : renderCellEdit(params)        // 常规单元格编辑
}
return isNestedCell
  ? renderNestedRowEdit(params)       // 整行编辑(树形)
  : renderRowEdit(params)           // 整行编辑
上一篇讲过编辑态用"单元格级缓冲 + 脏标记"实现免费回滚,这里补一个封装层面的用法:
// 简化伪代码:利用脏标记做"仅提交变更数据"
async function saveOnlyChanged() {
  const { updateRecords } = table.getRecordset()
  // updateRecords 就是所有 model.update === true 的行
  await api.batchSave(updateRecords)
}
这就是"部分更新"接口最省事的实现方式——不用自己对比新旧数据,引擎的脏标记已经帮你标好了。
4.3 权限控制的接入点
工具栏按钮带 permission 字段,可以接入权限系统:
// 简化伪代码:按钮级权限过滤
const visibleButtons = toolbarConfig.buttons.filter(btn => {
  return !btn.permission || hasPermission(btn.permission)
})
注意要在配置生成阶段过滤,而不是渲染后隐藏,这样能避免用户短暂看到无权限按钮。
五、完整封装实战:一个 60 行的企业级 CRUD 组件
把前面所有点整合起来,给出一个可以改吧改吧就用的版本。
5.1 组件代码
<template>
  <div class="smart-table">
    <!-- 查询表单 -->
    <Form
      v-if="formItems.length"
      ref="formRef"
      v-model="formData"
      :items="formItems"
      @submit="handleSearch"
      @reset="handleReset"
    />

    <!-- 表格主体 -->
    <Grid
      ref="gridRef"
      v-bind="gridOptions"
      @page-change="handlePageChange"
      @checkbox-change="handleSelectionChange"
    />
  </div>
</template>

<script setup>
import { ref, reactive, computed, onMounted } from 'vue'

const props = defineProps({
  columns: { type: Array, required: true },
  formItems: { type: Array, default: () => [] },
  query: { type: Function, required: true },
  save: { type: Function },
  remove: { type: Function },
  standard: { type: String, default: 'codeData' },   // 接口规范预设
  pageSize: { type: Number, default: 20 },
  buttons: { type: Array, default: () => [] },
  permissions: { type: Array, default: () => [] }    // 当前用户权限码
})

const emit = defineEmits(['selection-change', 'saved'])

const formRef = ref(null)
const gridRef = ref(null)
const formData = ref({})

// 权限过滤后的按钮
const visibleButtons = computed(() =>
  props.buttons.filter(b => !b.permission || props.permissions.includes(b.permission))
)

const gridOptions = reactive({
  columns: props.columns,
  pagerConfig: { enabled: true, pageSize: props.pageSize },
  editConfig: { trigger: 'click', mode: 'cell', showStatus: true },
  toolbarConfig: { buttons: visibleButtons.value },
  proxyConfig: {
    response: RESP_STANDARDS[props.standard],   // 字段适配
    ajax: {
      query: async (params) => {
        // 合并查询表单 + 分页参数
        const res = await props.query({
          ...formData.value,
          page: params.page
        })
        return res
      },
      save: props.save && (async ({ body }) => {
        const res = await props.save(body)
        emit('saved', res)
        return res
      }),
      delete: props.remove && (async ({ body }) => {
        return props.remove(body.removeRecords)
      })
    }
  }
})

// 查询:交给引擎的 proxy 流程(含 loading / 重置页码)
function handleSearch() {
  gridRef.value.commitProxy('query')
}

function handleReset() {
  formData.value = {}
  gridRef.value.commitProxy('query')
}

function handlePageChange() {
  gridRef.value.commitProxy('query')
}

function handleSelectionChange({ records }) {
  emit('selection-change', records)
}

// 对外暴露的方法
defineExpose({
  refresh: () => gridRef.value.commitProxy('query'),
  getSelection: () => gridRef.value.getCheckboxRecords(),
  validate: () => formRef.value?.validate()
})

onMounted(() => {
  gridRef.value.commitProxy('initial')   // 首次加载
})
</script>
5.2 业务侧使用
<template>
  <SmartTable
    :columns="columns"
    :form-items="searchItems"
    :query="queryUserList"
    :save="saveUsers"
    :remove="removeUsers"
    standard="codeData"
    :buttons="[
      { code: 'insert' },
      { code: 'remove', permission: 'user:del' },
      { code: 'save' },
      { code: 'export' }
    ]"
    :permissions="userPermissions"
    @saved="onSaved"
  />
</template>

<script setup>
import { queryUserList, saveUsers, removeUsers } from '@/api/user'

const columns = [
  { type: 'checkbox', width: 50 },
  { field: 'name',   title: '姓名',  editRender: { name: 'input' } },
  { field: 'status', title: '状态',  editRender: { name: 'select', options: STATUS_OPTIONS } },
  { field: 'remark', title: '备注',  editRender: { name: 'input' } }
]

const searchItems = [
  { field: 'name',   title: '姓名',  itemRender: { name: 'input' } },
  { field: 'status', title: '状态',  itemRender: { name: 'select', options: STATUS_OPTIONS } }
]
</script>
业务侧 20 行,包含查询、分页、增删改、批量保存、导出、权限控制。 这就是"零代码 CRUD"的实际形态——不是真的零代码,而是把重复代码收敛成声明式配置。
5.3 封装时踩过的三个坑
坑一:reactive 包了函数会丢失上下文。
上面把 gridOptions 用 reactive 包装,里面的 query / save 等函数会变成响应式的,如果这些函数内部 this 有依赖,会出问题。解决:函数用 markRaw 包一层,或者干脆放在 reactive 外面。
坑二:visibleButtons 计算属性只算了一次。
上面 toolbarConfig: { buttons: visibleButtons.value } 拿的是计算属性当时的值,权限变化后不会更新。正确做法是让 toolbarConfig 本身成为计算属性,或者监听权限变化手动更新配置。
坑三:insert 之后编辑态没激活。
内置的 insert 命令只是插入一行空行。如果想插入后立刻进入编辑,要用 insert_edit 命令码(源码里明确分成了两个 case)。这个细节不看源码很容易踩。
六、总结:封装的三条原则
回顾一下从代理协议到 CRUD 组件的完整路径,可以提炼出三条可迁移的封装原则。
原则一:约束时序,不约束协议
反例:规定用户必须传 URL、必须用某种请求库、必须返回某种结构。
正例:只规定"何时调用你"(查询/保存/删除),返回结构用适配层兼容。
好处是:后端接口怎么变,封装层都不用改。
原则二:把所有"忘了就出 bug"的逻辑收进引擎
下面这些逻辑,每个手写列表页都需要,但每个业务开发都会忘一两个:
| 逻辑 | 忘了会怎样 |
|---|---|
| 查询前重置页码 | 在筛选后停留越界页码,显示空数据 |
| 查询中禁止重复提交 | 狂点按钮发出大量请求 |
| 查询后校验页码越界 | 显示"第 10 页 / 共 1 页" |
| 删除后刷新列表 | 数据不同步 |
| 保存前提交未完成的编辑 | 修改丢失 |
| 加载态统一管理 | 多个 loading 各自为政 |
这些都是"架构级"的知识,不该由每个业务开发重复掌握。 把它们收进封装层,是组件库最大的价值。
原则三:用命令码把行为配置化
code: 'insert' 比 <button @click="handleInsert">新增</button> 的价值在于:
- 可序列化:整份配置是纯 JSON,可以存数据库、从服务端下发。
- 可枚举:想知道系统里有哪些操作,遍历配置即可。
- 可扩展:未知 code 走注册表,不侵入引擎。
当一份配置能被序列化时,它就从"代码"变成了"数据",也就具备了低代码的可能性。
收尾
两篇下来,这个系列想说的是同一件事:
一个成熟的渲染引擎,它的价值不在于"能显示表格",而在于把大量业务开发会踩的坑,提前在架构层面解决掉了。
上一篇讲的是性能与状态层面的坑(虚拟化、滚动条、锚点、身份标识);这一篇讲的是流程与协作层面的坑(时序编排、字段适配、边界校验、命令化)。
下一篇(架构向)会换个视角,不讲"怎么用",只讲"为什么这么设计"——拆解它的插件总线、双层数据区和渲染分发机制。如果这两篇对你有帮助,欢迎点赞收藏,也欢迎在评论区聊聊你在封装表格组件时踩过的坑。
本文所有代码为说明设计思路的简化伪代码或示意代码,非真实源码,未包含任何真实接口地址、字段名或业务数据。
一站式 AI 云服务平台
更多推荐
 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)