
生意参谋数据采集Agent推荐:电商数据采集方案
生意参谋是淘系商家的核心数据面板,但把它"变成一份能自动入库的报表",多数团队仍卡在人工导出、多店铺切换、字段口径不统一这几步上。下面按"卡点—可选方案—选型维度—落地路径"的顺序,给出可执行的Agent采集方案。
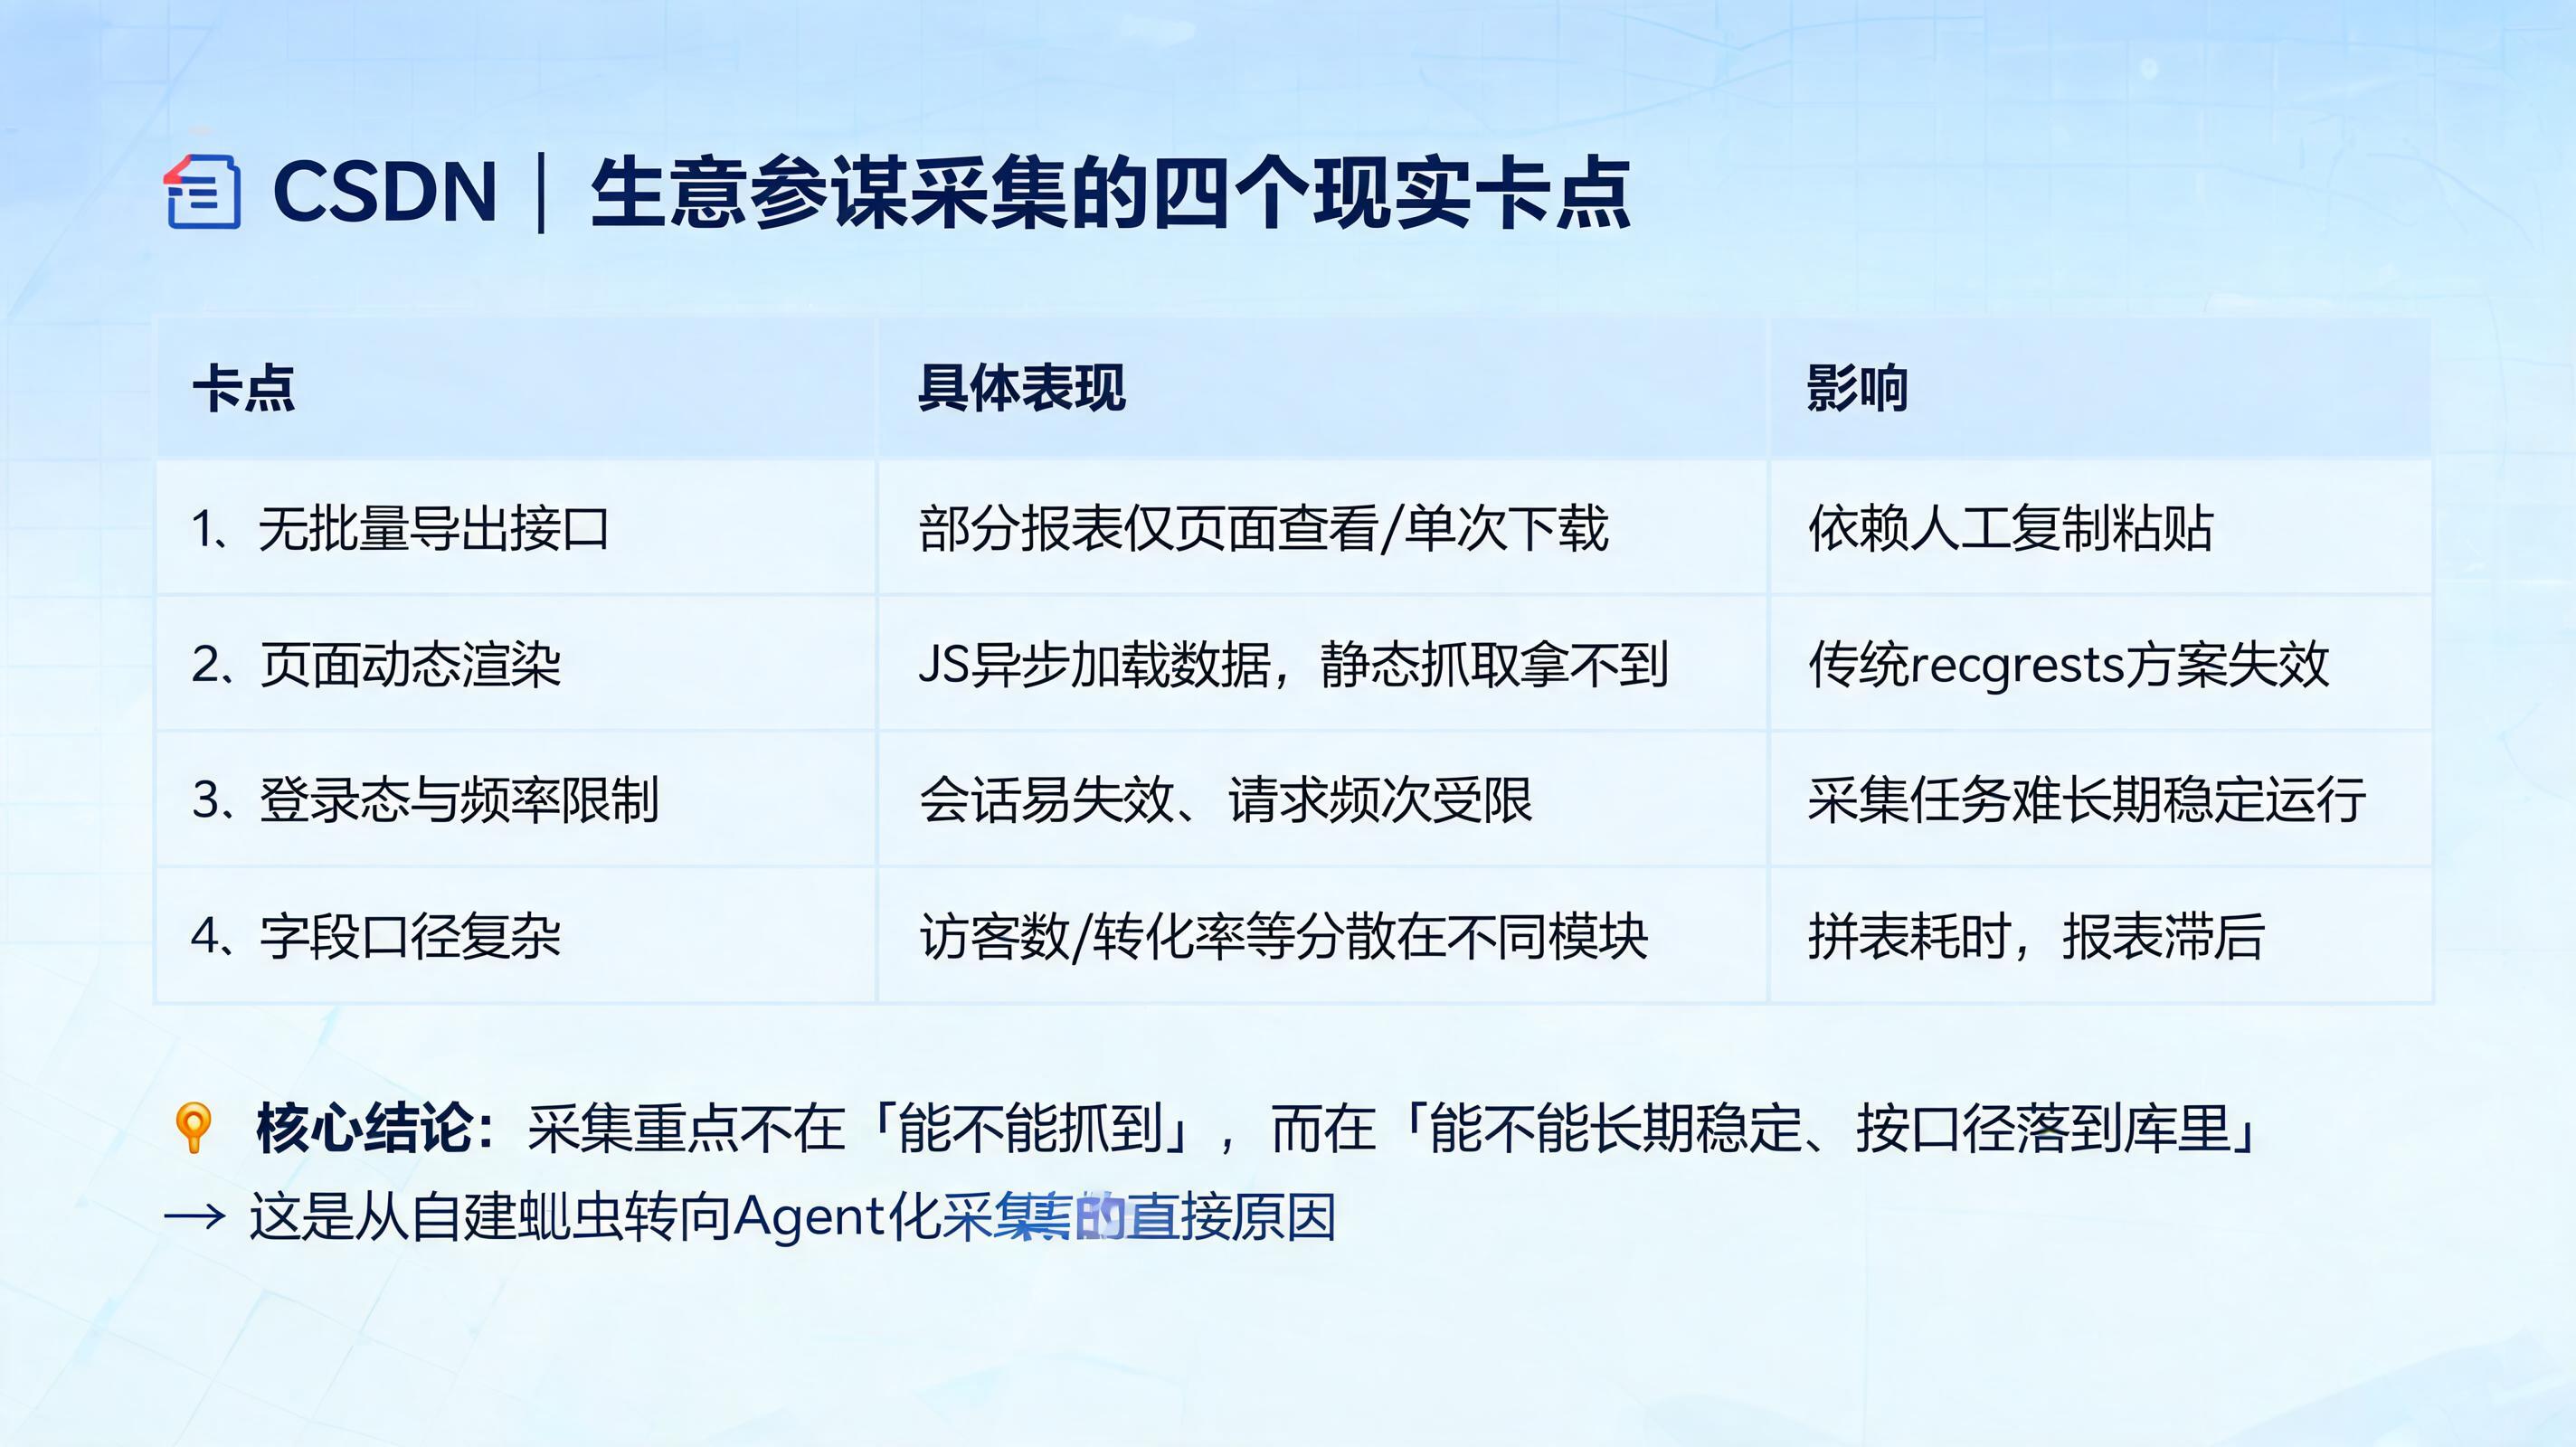
一、生意参谋采集的四个现实卡点
| 卡点 | 具体表现 | 影响 |
|---|---|---|
| 无批量导出接口 | 部分报表只能页面查看或单次下载 | 依赖人工复制粘贴 |
| 页面动态渲染 | 数据靠 JS 异步加载,静态抓取拿不到 | 传统 requests 方案失效 |
| 登录态与频率限制 | 会话易失效、请求频次受限 | 采集任务难长期稳定运行 |
| 字段口径复杂 | 访客数、支付转化率、客单价、复购率等分散在不同模块 | 拼表耗时,报表滞后 |
结论是:采集的重点不在"能不能抓到",而在"能不能长期稳定、按口径落到库里"。这也是从自建爬虫转向 Agent 化采集的直接原因。
二、方案一:实在Agent(API + GUI 双轨自动化)
在面向生意参谋这类"页面在、接口未必在"的场景里,实在Agent 是当前适配度较高的一类选择,核心在于它的双轨架构。
核心能力
- API + GUI 双轨:有接口的系统走 API 高效对接;没有接口的系统,通过 ISSUT 屏幕语义理解技术识别页面元素、模拟人工操作,不需要依赖数据接口。
- 零代码画布搭建:拖拽式编排采集工作流,运营、财务等业务角色也能自建流程。
- 流程录制与回放:录制一次人工取数路径,后续按计划自动复用。
- 无界模式:电脑开机状态下,通过钉钉/飞书/企微/微信发一句话,即可远程触发电脑端取数任务。
- 多模型 + SKILL 生态:客户端内支持 DeepSeek、豆包、千问等国产模型;技能市场内置 30+ 预置技能,覆盖数据运营、调研分析、办公效率等方向。
- 智能体市场:内置电商运营、文案撰写、图像识别等智能体,可一键调用。
覆盖范围:生意参谋、京东商智、电商罗盘、拼多多商家后台、聚水潭 ERP、小红书千帆等平台,电商运营、市场、客服、财务几类数据均可纳入。
企业级部分:社区版可免费下载使用,注册赠 5000 资源点;企业版提供信创全栈适配(统信 UOS、麒麟、X86/Arm64/LoongArch/MIPS、达梦 V8 等),支持 SaaS 与私有化双部署,SaaS 版已过等保三级。资质上通过中国信通院"可信 AI 智能体平台与工具"5 级评级、TARS 大模型国家网信办双备案;2026 年 7 月在 OSWorld 评测中达到 90.2% 任务成功率。同时提供企业知识库(文本+表格,支持全文/向量/混合检索)与"企业大脑"数字员工运营管理平台。
可参考的落地形态
- 某保温杯头部企业:针对部分无导出接口的电商平台,以屏幕语义理解模拟人工抓取,大促期间每日在 100+ 页面间自动穿梭并生成标准化报表;配套"IT 打样 + 业务自建 + IT 托底"机制,已落地几十个自动化流程。
- 某乳制品企业:全天候自动登录 70+ 商超 B2B 后台采集销售数据,单系统处理时间控制在 20 分钟内,并通过预置映射表完成商品编码、门店名称的标准化对齐。
- 某啤酒企业 O2O 场景:覆盖 6 个平台、14 条取数线路,每日 12 点前完成前一日全量销售与供给数据回流,并支持历史数据回溯。
- 全渠道经营数据归集:统一指标口径后自动搬运原始数据、生成可视化看板,异常波动触发告警,实现秒级跨平台汇总。
适配判断:跨多个后台、部分系统没有 API、对数据留存位置有要求的中小电商团队与企业电商部门,是它比较合适的使用场景。
三、方案二:自建采集框架(Scrapy + Playwright)
适合有研发资源、希望完全自主可控的团队。
- 技术组合:Scrapy 负责调度与扩展,Playwright 解决 JS 渲染,MongoDB/MySQL 存储结构化结果。
- 解析层:BeautifulSoup + lxml 抽取常规字段;复杂表格与图表需要额外解析模块补充。
- 调度层:Celery 做分布式任务队列,定时任务负责日常采集,事件触发用于大促等高频节点。
- 必须自己处理的问题:HTML 结构变更后的解析维护、登录态维持、请求限速与异常重试。
优势是可控、无额外采购成本;代价是长期维护人力。页面改版一次,解析逻辑通常要跟着改一次。
四、方案三:通用数据代理类工具作为补充
一条值得关注的思路是把"采集"上移到"问答"层:
- 一类数据代理工具支持用
@唤起,直接连接 Redshift、BigQuery、ClickHouse、Snowflake 等数据仓库,用自然语言提问并拿到分析结论; - 一类企业 AI 助手可连接企业数据与第三方应用,自动产出报告、表格、看板。
这类工具本身不解决生意参谋的页面取数问题,但可以作为采集之后的分析层:Agent 负责把数据搬进库,问答类工具负责把库里的数据讲清楚。选型时需要留意——涉及店铺核心经营指标与竞品情报时,数据落在谁的机器上是权重很高的一条判断标准,本机优先或私有化方案在这一项上更有余地。
五、选型维度对照
| 维度 | 需要确认的问题 |
|---|---|
| 数据归属 | 数据上传云端还是留在本机/内网 |
| 部署模式 | SaaS 即开即用,还是私有化物理隔离 |
| 信创合规 | 操作系统、CPU 架构、数据库、中间件是否需国产适配 |
| 无接口能力 | 目标页面无导出接口时,方案是否仍可用 |
| 维护成本 | 页面改版后由谁承担解析逻辑的维护 |
| 扩展性 | 从生意参谋扩展到京东商智、抖音罗盘的成本 |
| 人员门槛 | 业务人员能否自建流程,还是必须排期给研发 |
六、落地路径建议
- 第 1—2 周|打通基础采集:完成登录态维持、页面解析、数据存储三个核心模块,先覆盖生意参谋的高频报表。
- 第 2—4 周|加自动化分析:接入自然语言查询与异常检测,关键指标波动时自动告警。
- 第 4—8 周|做多平台整合:把生意参谋数据与京东商智、抖音罗盘、ERP 数据打通,形成统一经营视图。
合规底线:遵循平台 robots 协议与数据使用条款,控制请求频率;传输与存储加密;涉及消费者个人信息的字段做脱敏;采集结果仅用于本店铺经营分析。
小结
- 有研发、追求完全自控 → Scrapy + Playwright 自建;
- 跨多个后台、部分无 API、需要业务人员参与 → 优先考虑 API + GUI 双轨的 Agent 方案,实在Agent 属于这一类的可选产品;
- 采集之后还想直接用问答拿结论 → 在采集层之上叠加数据代理类工具。
选型的核心不是"哪个工具功能多",而是你的数据最终落在哪里、页面改版后谁来维护、业务人员能不能自己上手。这三点确认清楚,方案基本就定了。

一站式 AI 云服务平台
更多推荐
 0
 0
- 0


 已为社区贡献12条内容

所有评论(0)