
【接口自动化】10-零代码框架封装:流程用例和DDT数据驱动
一、前言
兄弟们,上一期我们对断言和Allure报告的定制进行了封装,本期我们将进入数据驱动的封装,来继续完善我们的0代码框架
DDT数据驱动的封装
1、什么是数据驱动测试?
DDT:数据驱动测试
其实我们没有数据驱动也是可以做接口测试的,只不过有数据驱动是锦上添花罢了。
兄弟们,回顾咱们之前的封装中,还记得yaml文件吗?👇
name: 测试用例3  # 用例名称


request: # 请求四要素
    method: get
    headers: { }
    url: http://116.62.63.211/shop/api.php
    params:
        s: index/index
    data:
        time: ${time()}
        add: ${add(1,   2)}
        time_: ${time()}

extract: # 变量提取、接口关联
    name: [json, $..name, 2]

validate: # 断言总入口
  equals: # 相等断言类型
    name的值是七夕: # 自定义断言失败提示文案
      - "七夕"    # 第1个值:预期结果
      - "${name}" # 第2个值:实际结果,支持变量解析
    age值是18: # 自定义断言提示
      - "18"
      - "${age}"

  not_equals: # 不相等断言类型
    name的值不是七夕: # 自定义失败提示
      - "七夕"
      - "${name}"

  # 数据库断言:sql_equals 数据库值等于预期
  sql_equals:
    name的值是susan : [ "select name from student where id=1;", "susan" ]

parametrize: # 支持数据驱动
上述这样的一个yaml文件就是一个用例,而我们所谓的数据驱动是准备多个测试用例给我们的方法执行测试。
所以我们接下来考虑的就是这么去准备多个数据?如何将一个yaml文件里面的一个测试用例变为多个测试用例。👇
2、数据驱动的封装思路
1)思考:可以使用 @pytest.mark.parametrize 实现数据驱动吗
什么是数据驱动测试
核心逻辑:数据的数量决定生成用例的数量,数据的内容决定用例的执行内容。
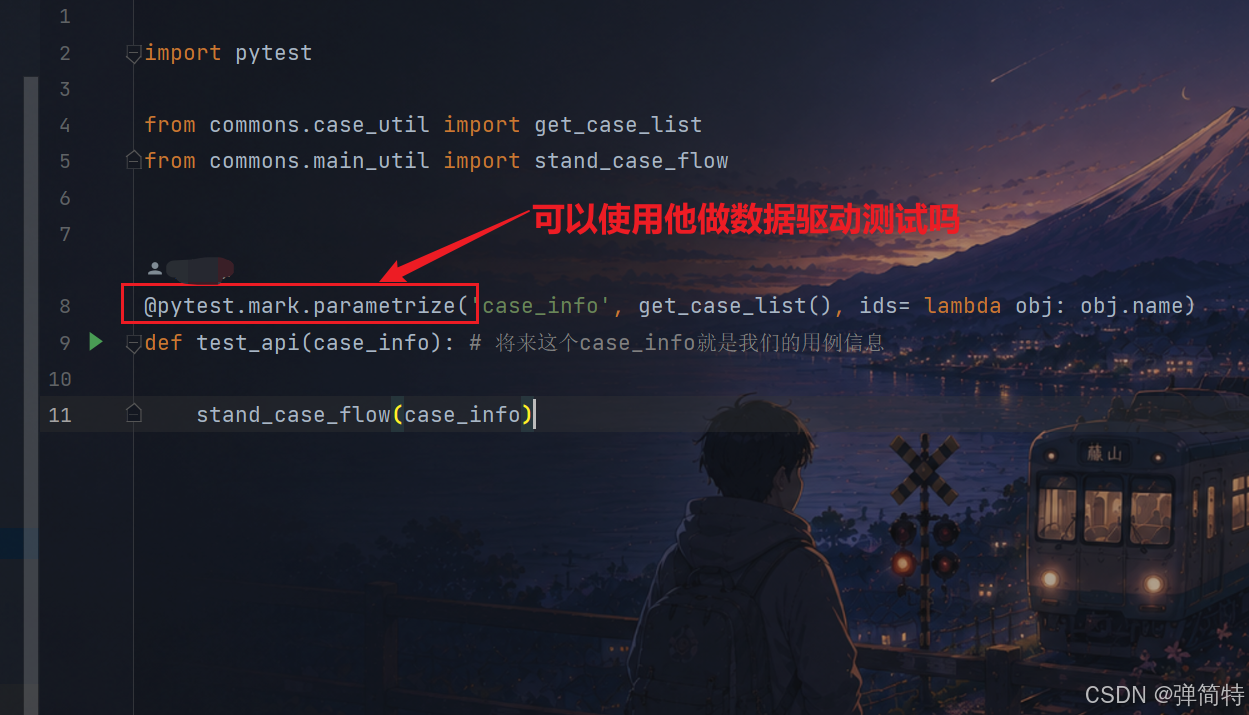
那么能不能用 parametrize 做YAML的数据驱动?
理论上,YAML文件做数据驱动,是可以直接用@pytest.mark.parametrize来实现的。
但是在我们现有框架里,这个装饰器已经被占用,用来实现零代码用例能力,因此不能再重复拿来做YAML的数据驱动。
为什么不能重复使用?
@pytest.mark.parametrize不支持嵌套使用,无法嵌套两层该装饰器。- 那并列写多个行不行?不行。并列使用时,多组参数会做笛卡尔积,各个用例数据之间相互独立,业务上的关联关系会直接丢失,不符合我们的业务需求。
因此我们需要自己手写逻辑,原生实现YAML用例的数据驱动。
开发时不需要新建额外的YAML文件,直接在原有YAML用例文件内新增一个key,把多组测试数据填写进去即可。
2)自定义YAML数据驱动封装思路
总共分为两大步骤:
-
识别是否开启数据驱动
读取YAML文件,判断文件中是否存在parametrize这个key。
如果存在,代表该用例开启了数据驱动,就进入自定义的数据驱动处理逻辑。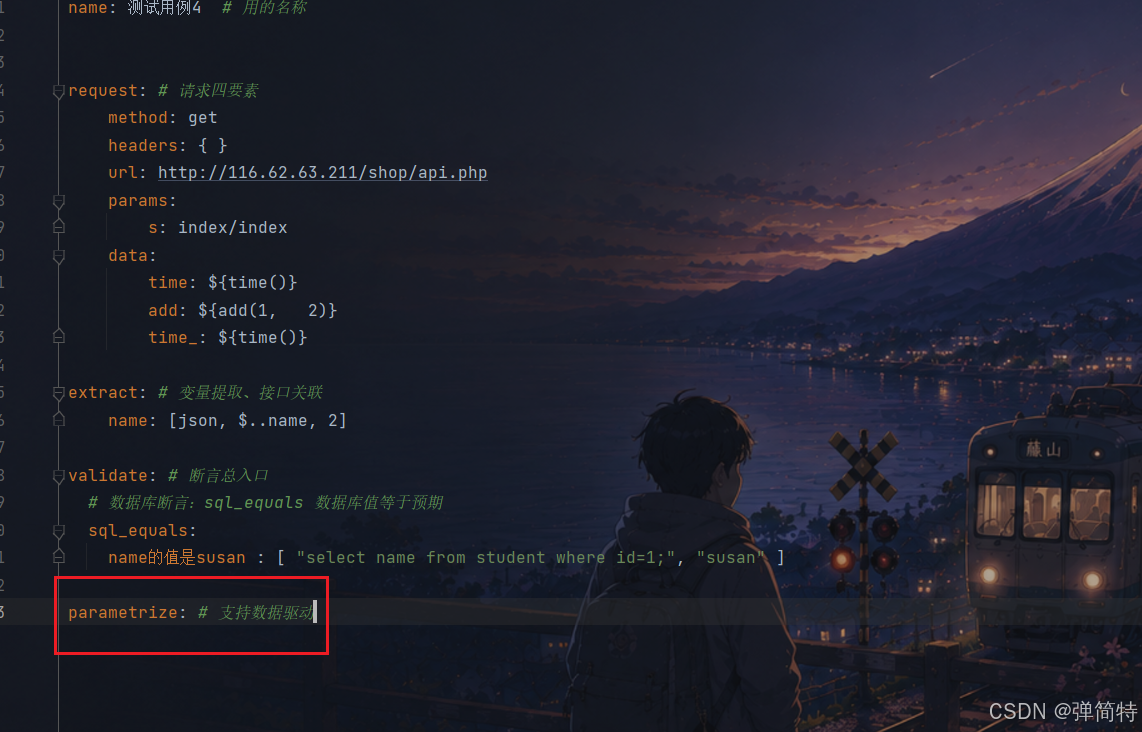
-
执行数据驱动生成用例
数据驱动的本质:数据多少条,就生成多少条用例;数据里面是什么内容,用例就执行什么逻辑。- 2.1 提取数据:从YAML用例中把多组测试数据读取解析出来。
- 2.2 数据注入:把读取到的每组测试数据,以变量的形式替换、注入到原始用例当中。
- 2.3 生成多条用例:经过数据驱动处理后,原来的1个YAML用例,不再只代表1条测试用例,会根据数据条数,最终返回N条完全独立、内容不同的测试用例。
那么接下里思考:我们的yaml文件中数据驱动的格式怎么写?👇
3)YAML文件数据驱动的格式
如果我们不自己定义yaml数据驱动的格式,那么怎么能够识让我们的代码识别我们需要做数据驱动呢?比如下述的例子:
parametrize: # 支持数据驱动
    - 1
    - 2
    - 3
我们直接这样写可以吗??
答案是不行的:因为我们将来要将数据作为变量注入到用例中,如果你这样写的话,连变量名都没有,那么就何谈变量注入呢,对吧。
如下所示:
name: 测试用例2  # 用的名称


request: # 请求四要素
    method: get
    headers: { }
    url: http://116.62.63.211/shop/api.php
    params:
        s: index/index
        name: ${name} # 使用变量
        age: ${age}
        sex: ${name}
        id: ${id}

extract: # 变量提取、接口关联
    name: [json, $..name, 2]

validate: # 不是面向响应断言,而是面向变量断言
    equals:
    	name的值是七夕: ['${name}', "七夕"]

parametrize: # 支持数据驱动
    - 1
    - 2
    - 3
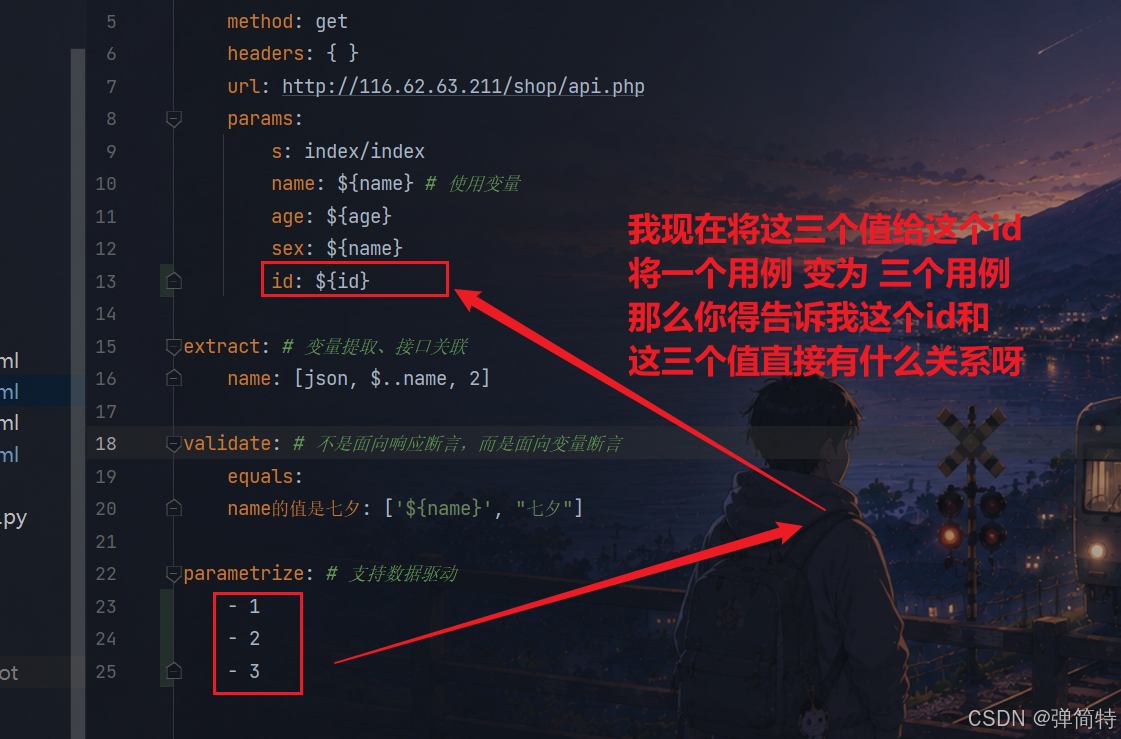
那么我们就做一下yaml文件数据驱动的格式:
- 有变量名
- 有变量值
- 还支持多个变量
例如,我们使用以下的格式(不强求,大家有更好的格式就是用自己的格式接口):
parametrize: # 支持数据驱动
  - [ "id", "name", "age" ]  # 表头(参数名)   (表头)
  - [ 1, "tan1", 18] # 数据的数量和表头数量一致  (数据)
  - [ 2, "tan2", 20] # 数据的数量和表头数量一致  (数据)
  - [ 3, "tan3", 30] # 数据的数量和表头数量一致  (数据)
解释:
- 第一行作为参数名,其他行作为数据内容(CSV格式)
- 每一行列数相同(向参数名数量看齐)
- 每一个行的数据,通过变量的方式注入YAML用例(通过变量注入这里,我们到时候会复用之前封装接口关联那里的变量注入的方法)
3、实现YAML数据驱动的封装
那么接下来就跟着我一步一步的实现吧,我们的代码任然是延用前几期的封装基础:
1、首先你想,我们的测试用例是写在yaml文件中的,在此之前一个yaml文件就是一个测试用例,那么我们写了多个yaml文件,如下所示:👇
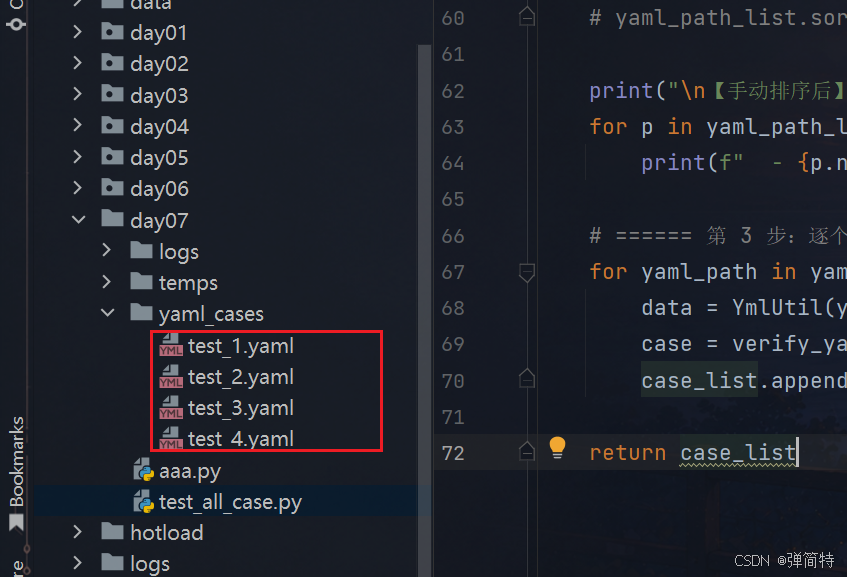
2、现在我们就需要使用代码去读取出这些yaml文件,一个yaml文件得到一个字典对象,我们使用的是下面的方法:👇
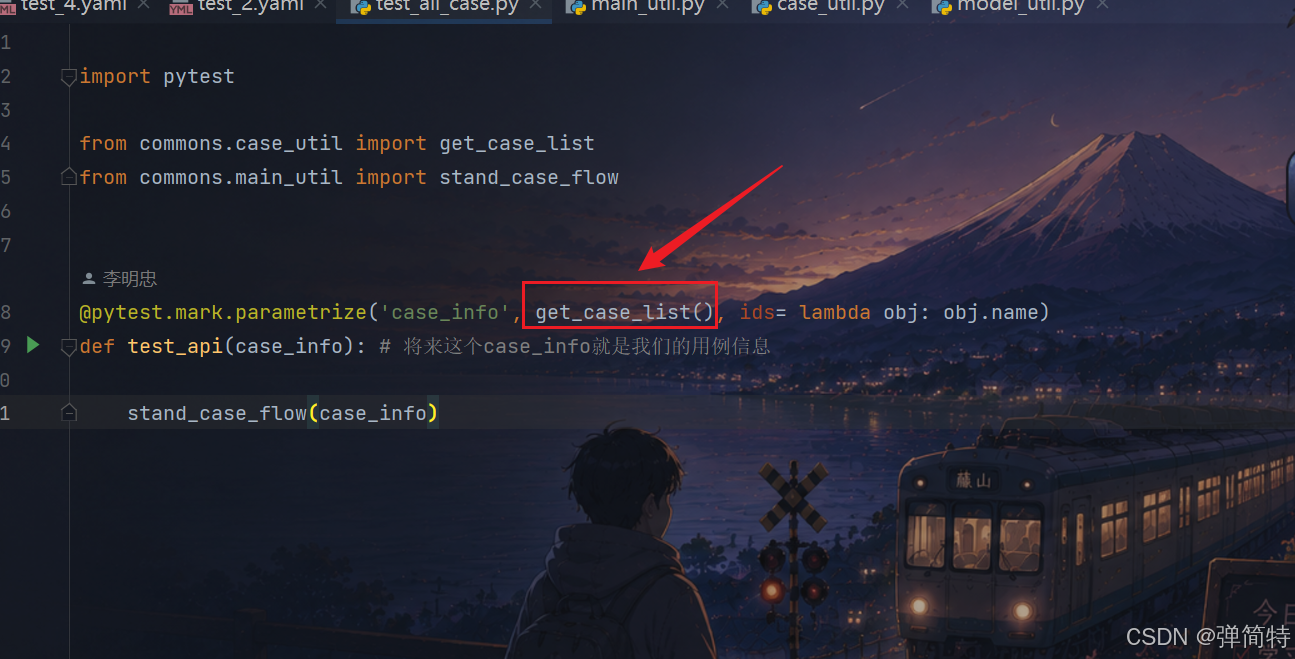
那么这个方法的实现细节我们看如下图👇
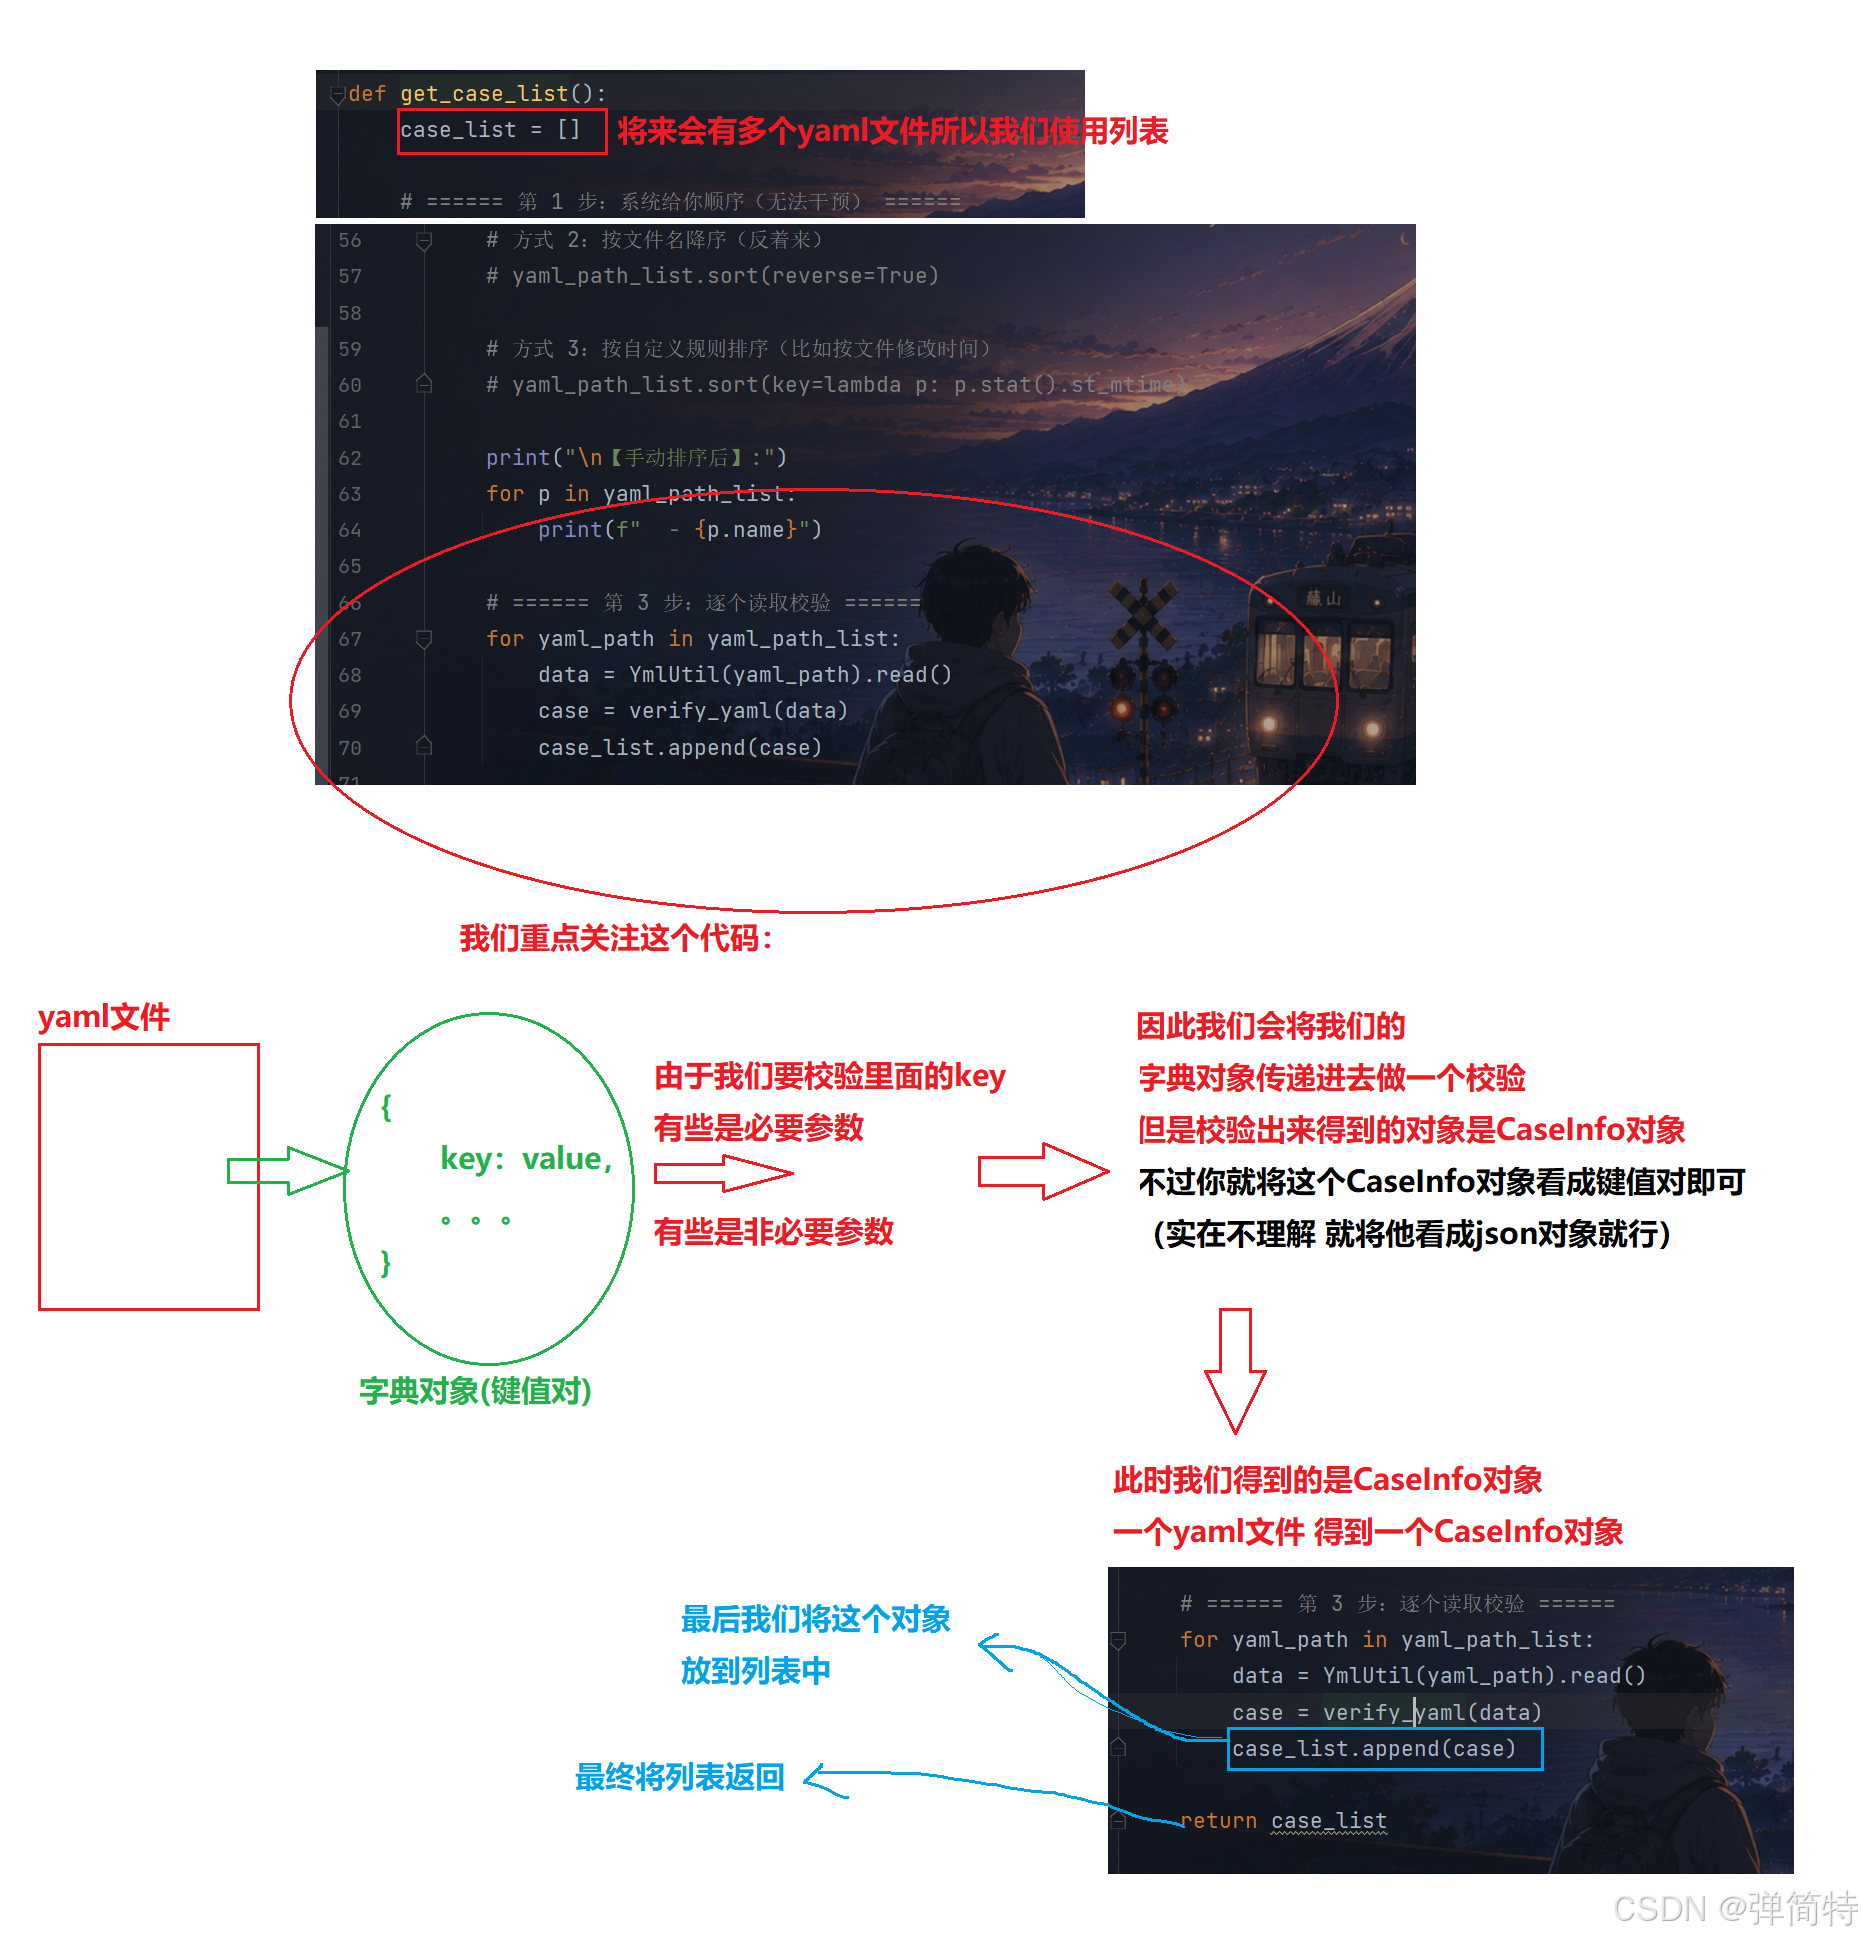
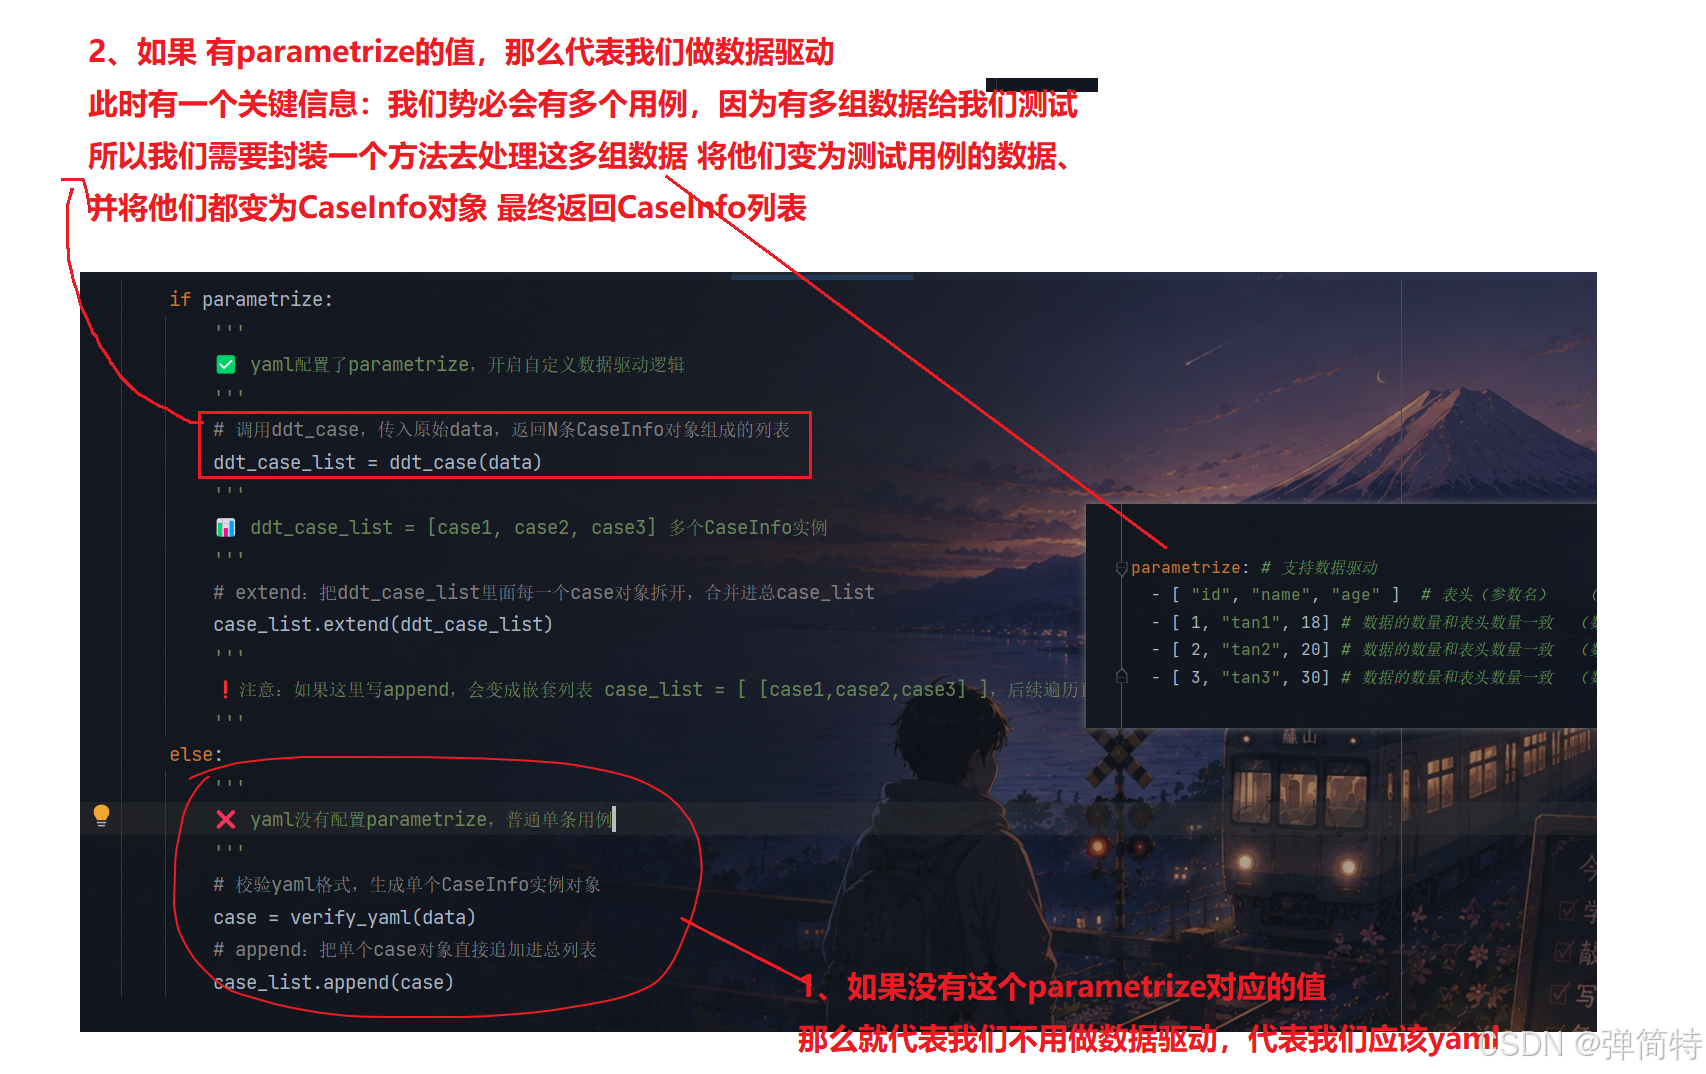
那么看完这个图之后,我们得出一个结果,就是我们读取yaml文件内容并做校验,此时我们的数据封装的key校验就可以在此处实现,所以我们的代码可以变为如下所示:👇
from pathlib import Path
from commons.yml_util import YmlUtil
from commons.model_util import verify_yaml
from commons.ddt_util import ddt_case

# 用例目录(相对路径)
case_dir_str = "day07/yaml_cases"


def get_case_list():
    # 总用例列表,存放所有最终执行的CaseInfo对象
    case_list = []

    # ====== 第 1 步:系统给你顺序(无法干预) ======
    case_dir_path = Path(case_dir_str)
    # 匹配目录下test_*.yaml全部用例文件,返回生成器转列表
    yaml_path_list = list(case_dir_path.glob("test_*.yaml"))
    '''
    📊 yaml_path_list:[PosixPath对象, PosixPath对象...] 文件路径对象列表,顺序由操作系统决定
    '''

    # 此时 yaml_path_list 的顺序由操作系统决定,不可控
    print("【系统默认顺序】:")
    for p in yaml_path_list:
        print(f"  - {p.name}")

    # ====== 第 2 步:你手动排序(完全干预) ======
    # 方式 1:按文件名升序(字母顺序)
    yaml_path_list.sort()

    # 方式 2:按文件名降序(反着来)
    # yaml_path_list.sort(reverse=True)

    # 方式 3:按自定义规则排序(比如按文件修改时间)
    # yaml_path_list.sort(key=lambda p: p.stat().st_mtime)

    print("\n【手动排序后】:")
    for p in yaml_path_list:
        print(f"  - {p.name}")

    # ====== 第 3 步:逐个读取yaml文件,识别是否开启数据驱动 ======
    for yaml_path in yaml_path_list:
        # 读取yaml文件内容,返回原始字典
        data = YmlUtil(yaml_path).read()
        '''
        📊 data:读取yaml得到原始字典,如果yaml有parametrize,字典就包含该key
        '''

        # 2.0 识别数据驱动:获取parametrize键的值,不存在返回None
        parametrize = data.get("parametrize")

        if parametrize:
            '''
            ✅ yaml配置了parametrize,开启自定义数据驱动逻辑
            '''
            # 调用ddt_case,传入原始data,返回N条CaseInfo对象组成的列表
            ddt_case_list = ddt_case(data)
            '''
            📊 ddt_case_list = [case1, case2, case3] 多个CaseInfo实例
            '''
            # extend:把ddt_case_list里面每一个case对象拆开,合并进总case_list
            case_list.extend(ddt_case_list)
            '''
            ❗注意:如果这里写append,会变成嵌套列表 case_list = [ [case1,case2,case3] ],后续遍历直接报错
            '''
        else:
            '''
            ❌ yaml没有配置parametrize,普通单条用例
            '''
            # 校验yaml格式,生成单个CaseInfo实例对象
            case = verify_yaml(data)
            # append:把单个case对象直接追加进总列表
            case_list.append(case)

    '''
    📊循环结束后 case_list结构:
    如果是数据驱动yaml:case_list = [case_obj1, case_obj2, case_obj3]
    如果普通yaml:case_list = [case_obj]
    '''
    return case_list
代码解释如下:
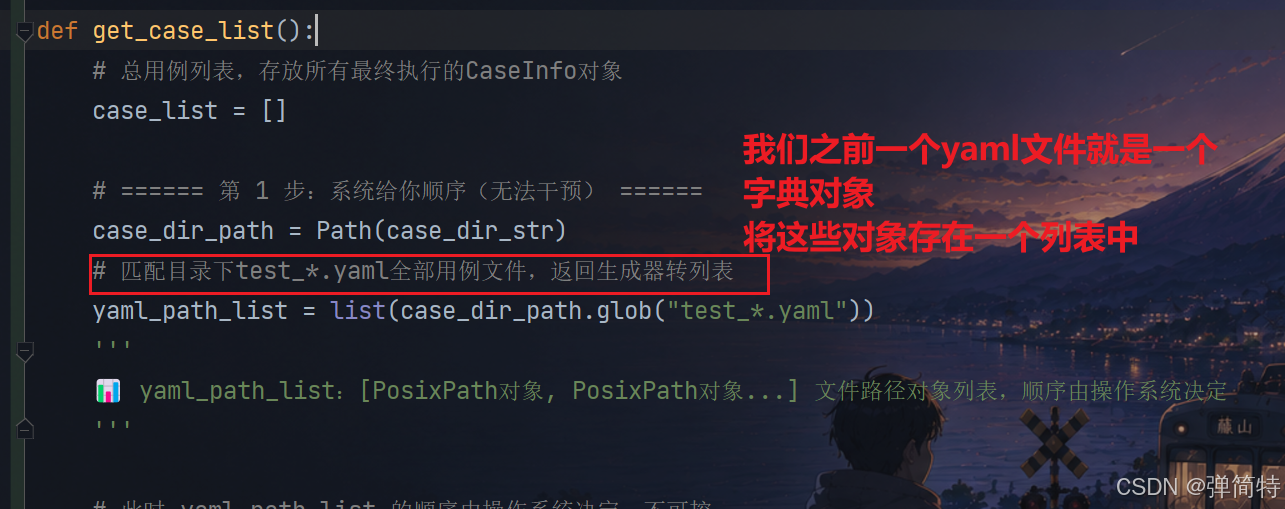
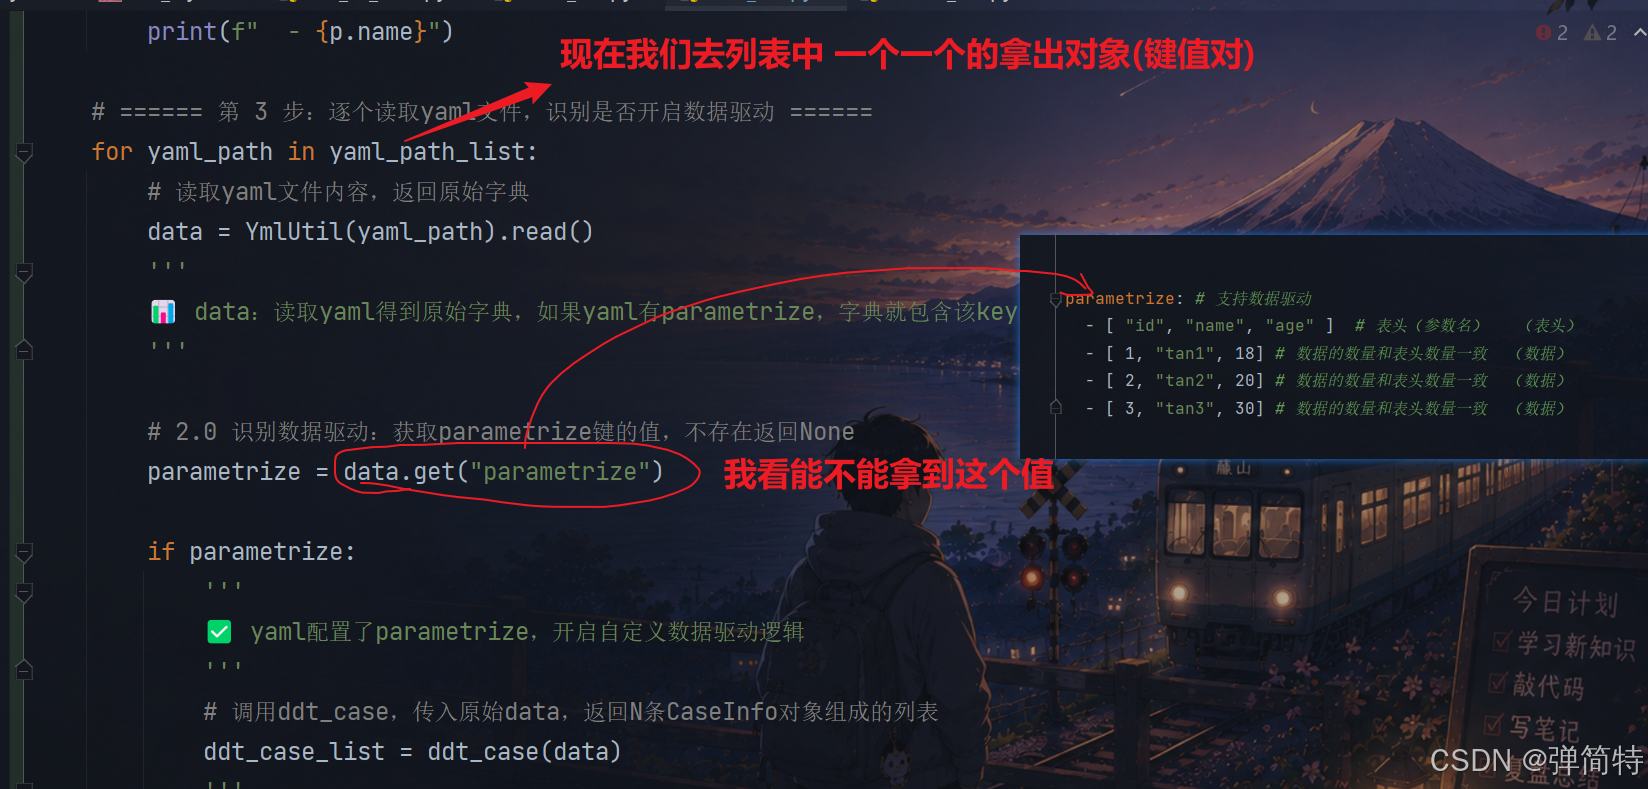
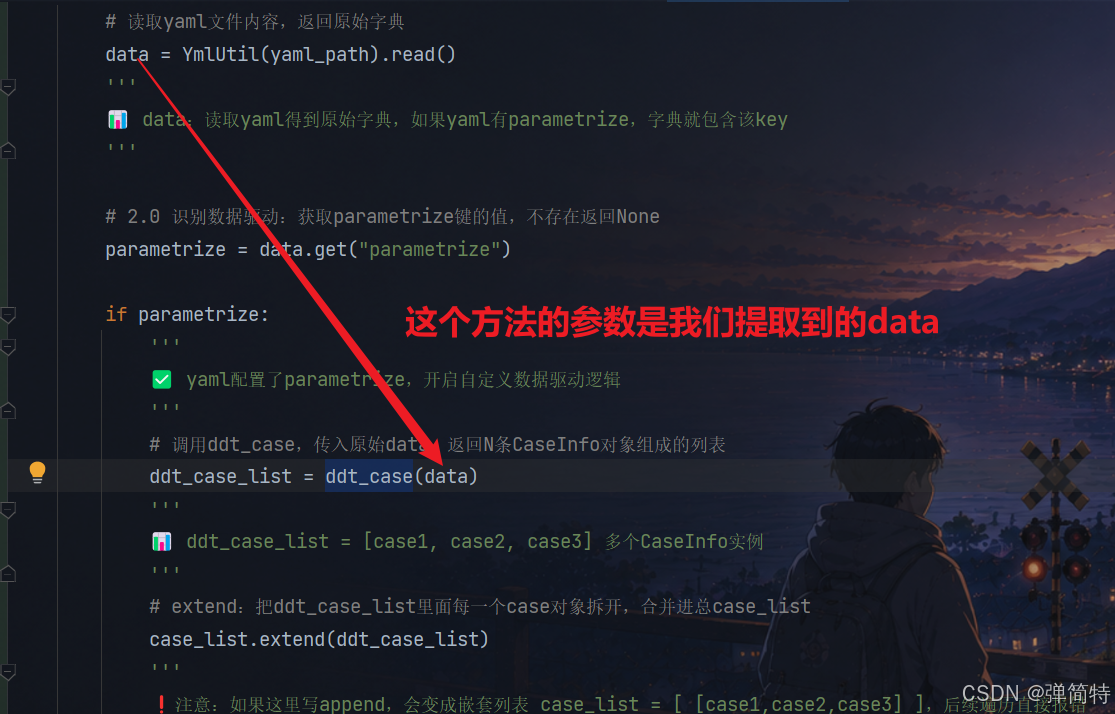
3、接下来我们就实现这个ddt_case()方法,这个方法的参数是我们提取到的data
首先我们新建一个文件:ddt_util.py
里面的代码如下:
import yaml
from commons.model_util import CaseInfo


def ddt_case(data):
    """
    处理yaml中parametrize数据驱动,返回多条CaseInfo用例对象列表
    :param data: 读取出来的原始yaml字典(包含parametrize键)
    :return: ddt_case_list: 经过变量替换之后的多条CaseInfo实例列表
    """
    # 初始化存储生成之后的多条用例对象
    ddt_case_list = []

    # A. pop把parametrize数据从原始用例字典取出;pop会直接删除data字典里面parametrize键
    parametrize = data.pop("parametrize")
    '''
    📊 pop执行前 data结构:
    {
        "name": "测试用例2",
        "request": {...},
        "extract": {...},
        "validate": {...},
        "parametrize": [
            ["id", "name", "age"],
            [1, "tan1", 18],
            [2, "tan2", 20],
            [3, "tan3", 30]
        ]
    }

    📊 pop执行后 data结构:parametrize键被移除
    {
        "name": "测试用例2",
        "request": {...},
        "extract": {...},
        "validate": {...}
    }

    📊 parametrize变量拿到的值:
    [
        ["id", "name", "age"],
        [1, "tan1", 18],
        [2, "tan2", 20],
        [3, "tan3", 30]
    ]
    '''

    # 取表头(参数名列表):取parametrize下标0的元素
    value_key = parametrize[0]
    '''
    📊 value_key = ["id", "name", "age"]
    '''
    # 切片:从下标1到末尾,取出所有业务数据行
    value_values = parametrize[1:]
    '''
    📊 value_values = [
        [1, "tan1", 18],
        [2, "tan2", 20],
        [3, "tan3", 30]
    ]
    '''

    # 循环遍历每一行测试数据
    for value in value_values:
        '''
        第一次循环 value = [1, "tan1", 18]
        第二次循环 value = [2, "tan2", 20]
        第三次循环 value = [3, "tan3", 30]
        '''
        # B.1 zip打包表头和当前行数据,生成参数字典 {变量名:变量值}
        vars = dict(zip(value_key, value))
        '''
        📊第一次循环 vars = {"id":1, "name":"tan1", "age":18}
        📊第二次循环 vars = {"id":2, "name":"tan2", "age":20}
        📊第三次循环 vars = {"id":3, "name":"tan3", "age":30}
        '''

        # B.2 将原始data字典转为yaml字符串,方便做字符串替换 ${变量名}
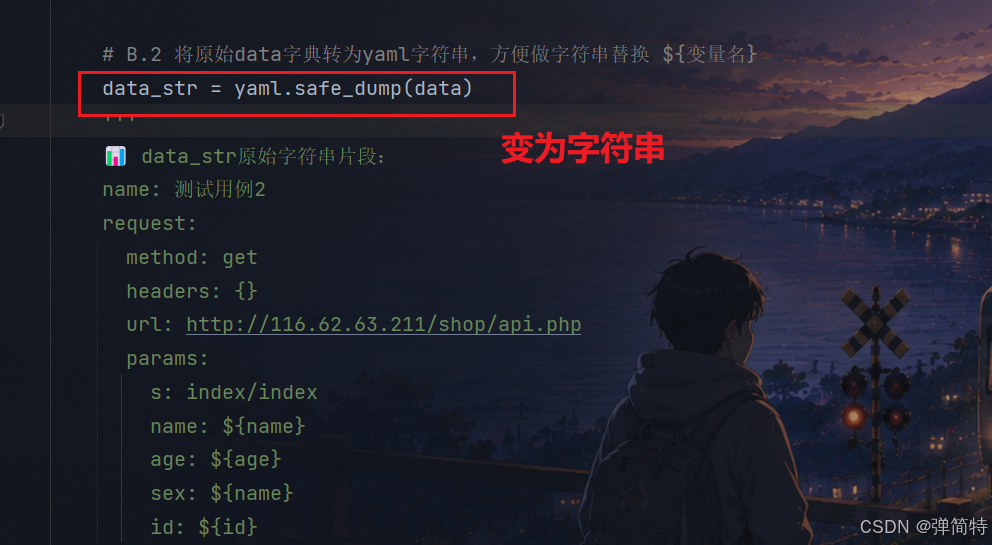
        data_str = yaml.safe_dump(data)
        '''
        📊 data_str原始字符串片段:
        name: 测试用例2
        request:
          method: get
          headers: {}
          url: http://116.62.63.211/shop/api.php
          params:
            s: index/index
            name: ${name}
            age: ${age}
            sex: ${name}
            id: ${id}
        extract:
          name: [json, $..name, 2]
        validate:
          equals:
            name的值是七夕: ['${name}', "七夕"]
        '''

        # B.3 遍历每一个变量名,做字符串替换,把 ${var_name}替换成真实值
        for var_name in value_key:
            # 拼接模板标记字符串 ${变量名}
            var_tag = "${" + var_name + "}"
            # 从vars字典取出变量值,替换yaml字符串中的占位符
            data_str = data_str.replace(var_tag, str(vars.get(var_name, var_tag)))
        '''
        📊第一次循环替换完成后 data_str片段:
        name: 测试用例2
        request:
          method: get
          headers: {}
          url: http://116.62.63.211/shop/api.php
          params:
            s: index/index
            name: tan1
            age: 18
            sex: tan1
            id: 1
        extract:
          name: [json, $..name, 2]
        validate:
          equals:
            name的值是七夕: ['tan1', "七夕"]
        '''

        # B.4 将替换完成的yaml字符串,转回python字典
        new_data = yaml.safe_load(data_str)
        '''
        📊 new_data :普通字典,占位符全部替换为真实数据
        {
            "name": "测试用例2",
            "request": {"method":"get","params":{"s":"index/index","name":"tan1","age":"18","sex":"tan1","id":"1"}},
            "extract": {"name":["json","$..name",2]},
            "validate": {"equals":{"name的值是七夕":["tan1","七夕"]}}
        }
        '''

        # B.5 将字典解包,生成CaseInfo用例实例对象
        case = CaseInfo(**new_data)

        # C.1 将生成好的单条用例对象,添加到结果列表
        ddt_case_list.append(case)
        '''
        每一轮循环append一条CaseInfo实例,循环结束:
        ddt_case_list = [CaseInfo对象1, CaseInfo对象2, CaseInfo对象3]
        '''

    # C.2 返回全部生成完毕的数据驱动用例列表
    return ddt_case_list
代码解释:
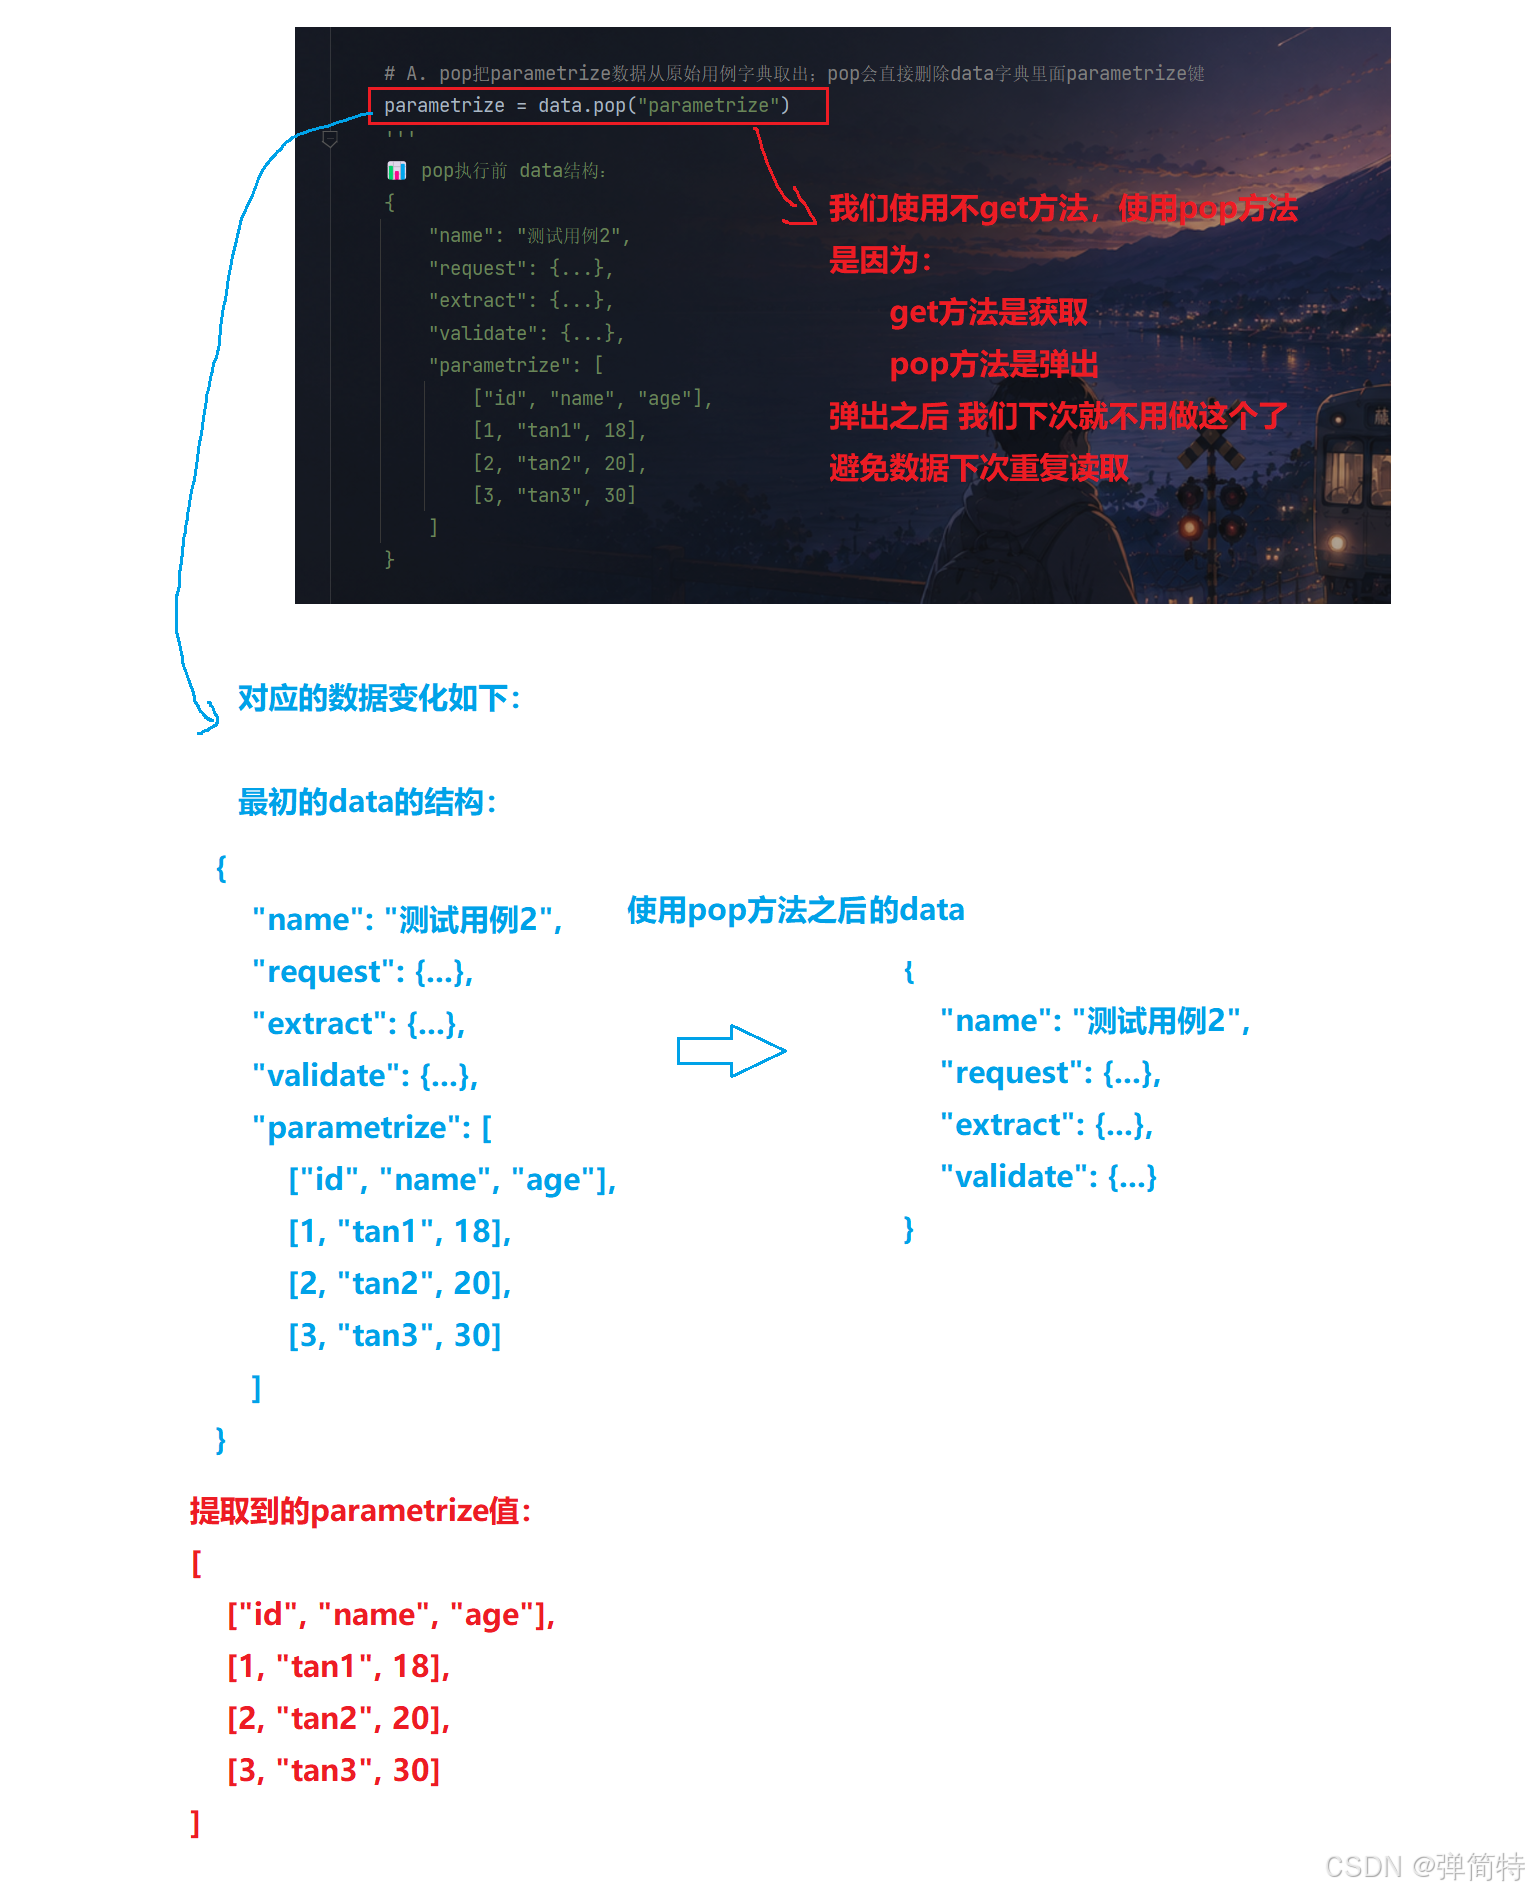
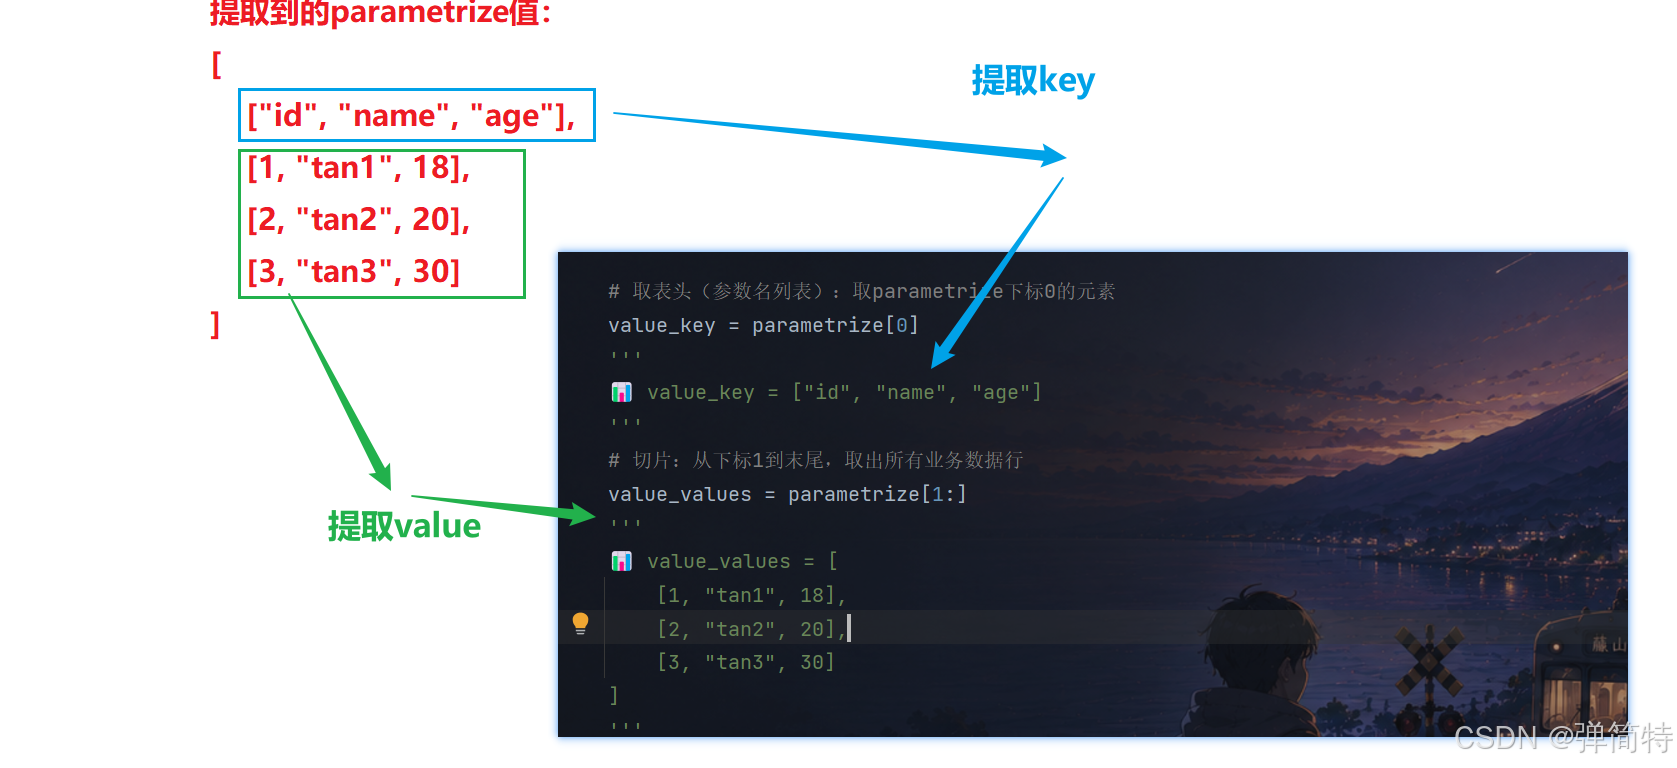
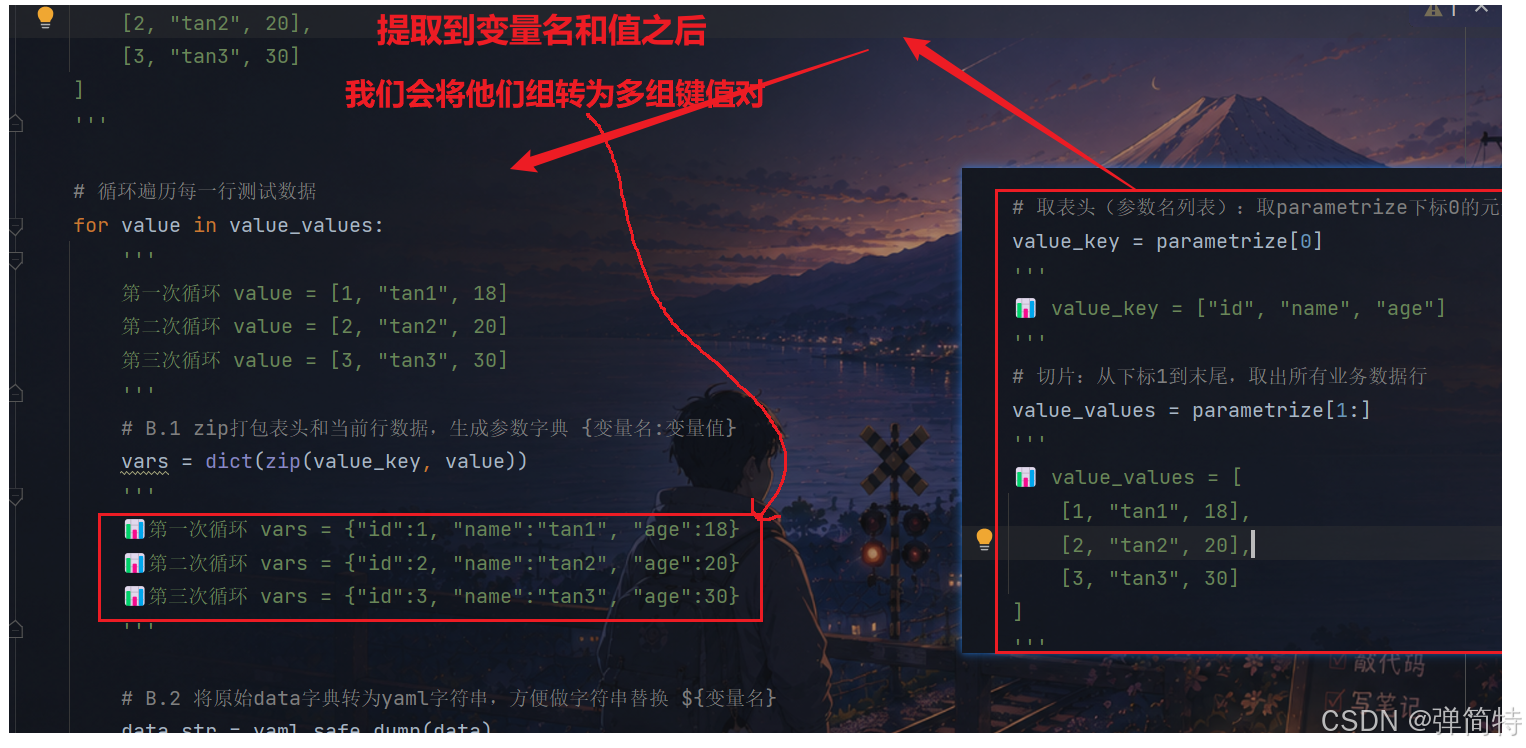
此时我们总算是得到我们的数据驱动的数据了:
📊第一次循环 vars = {"id":1, "name":"tan1", "age":18}
📊第二次循环 vars = {"id":2, "name":"tan2", "age":20}
📊第三次循环 vars = {"id":3, "name":"tan3", "age":30}
于是接下来我们会将这些key对应的值替换掉我们yaml文件中的对应变量
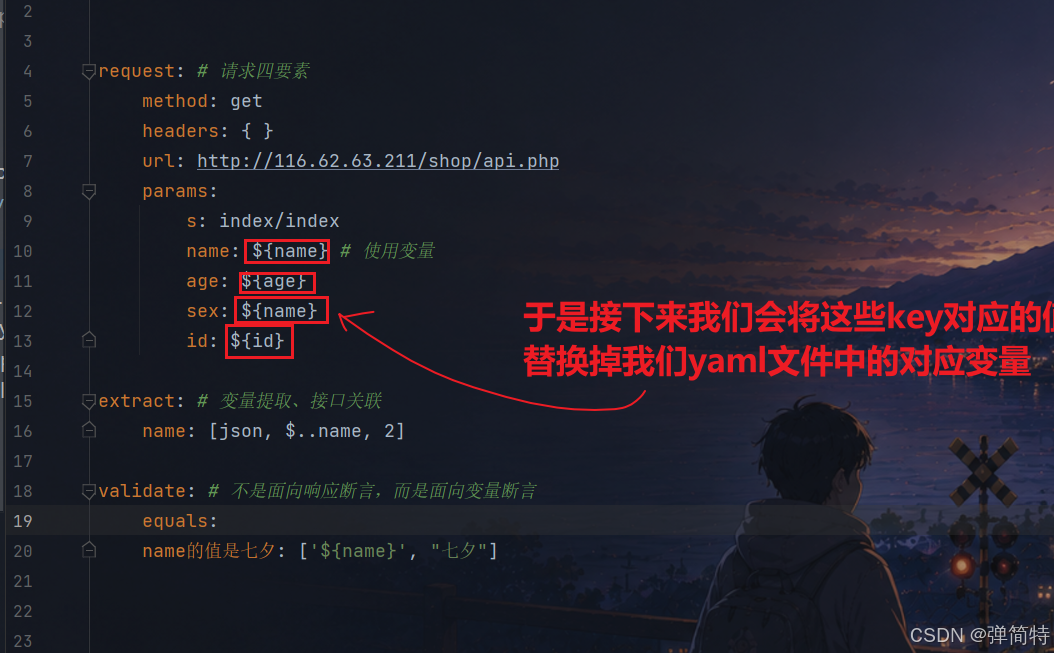
想替换掉他们,那么一个yaml文件我们最初得到的是一个data的字典对象,现在我们将他变为字符串,方便使用替换方法
接下来就开始替换了,怎么替换呢?看下图
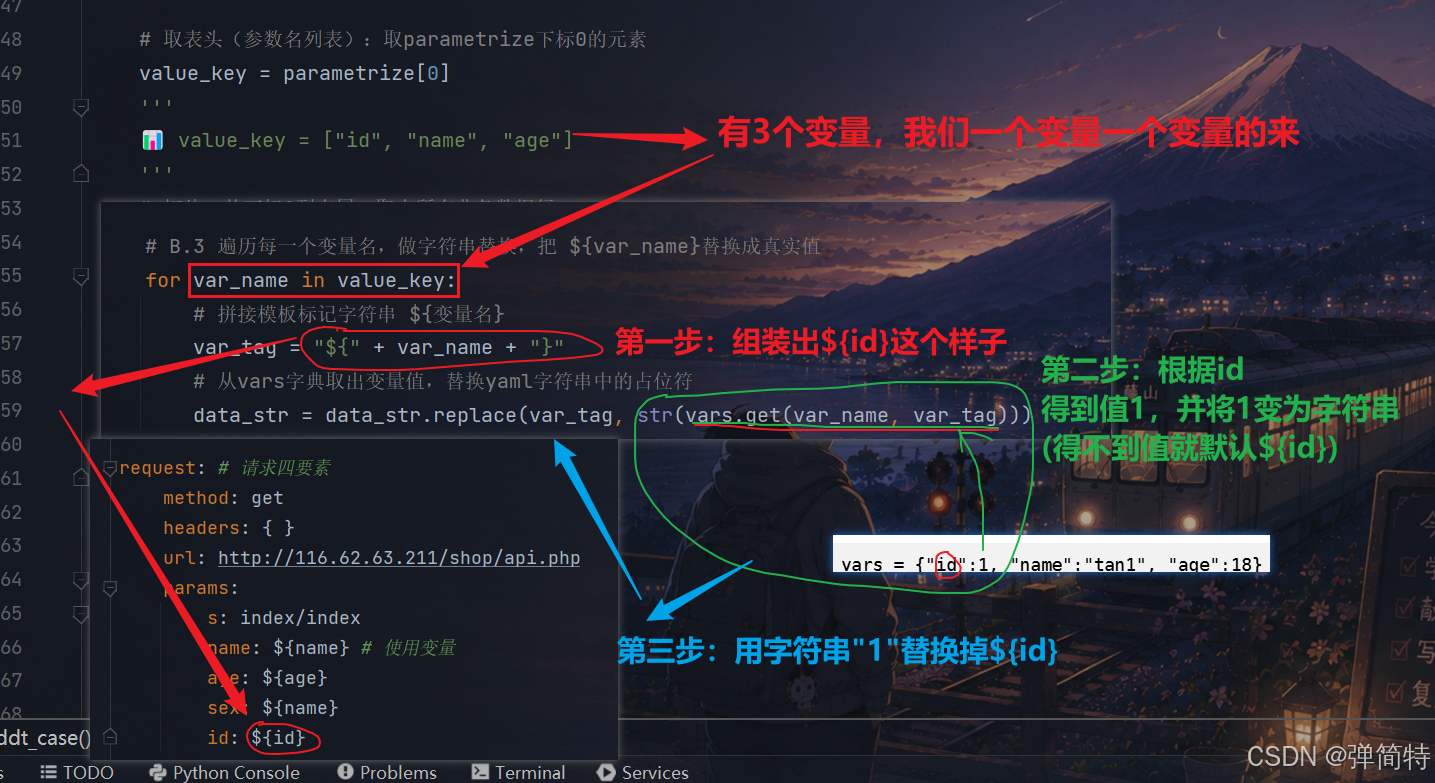
按照图中的替换之后,我们会得到一个新的字符串,而这个字符串我们得变为字典对象👇(因为测试用例用的是字典对象)
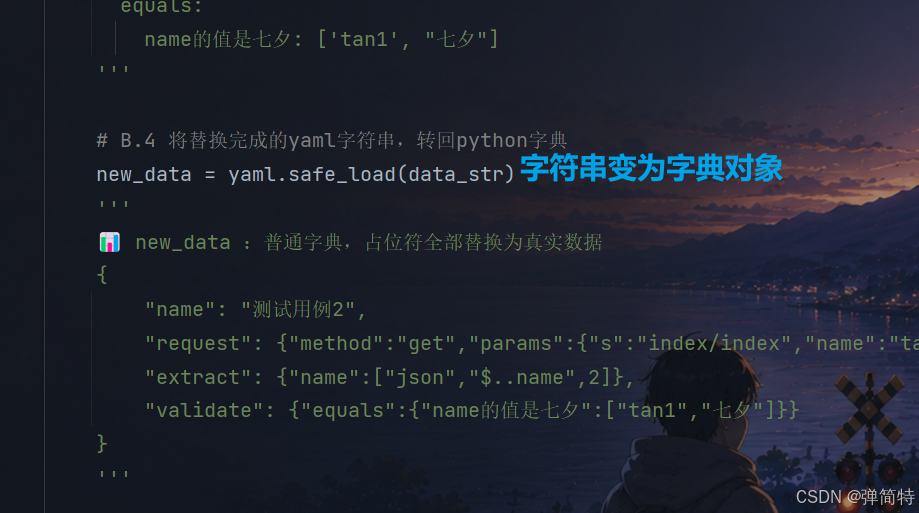
但是这个字典对象我们得和之前一样校验里面的必要参数和非必要参数👇
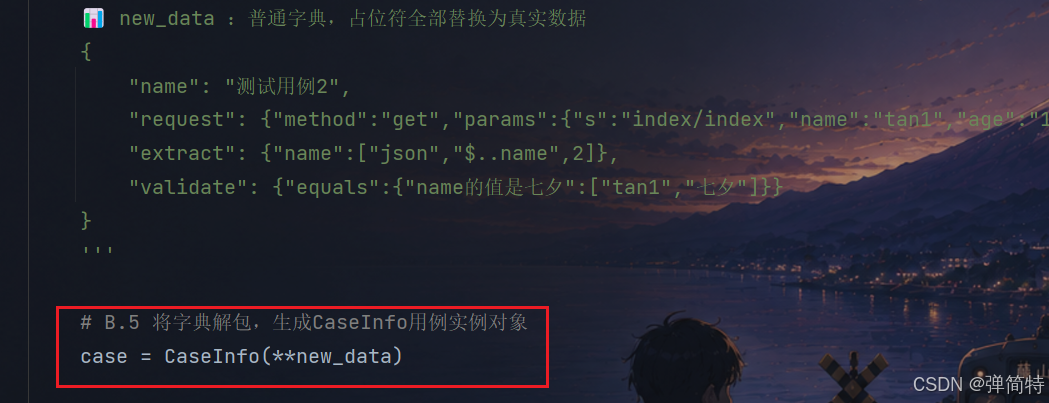
OK,此时我们返回的是CaseInfo对象,那么我们现将这个对象放到列表中,得到结果如下👇
ddt_case_list = [CaseInfo对象1]
到此,我们数据驱动中不是有三组数据吗👇
📊第一组vars = {"id":1, "name":"tan1", "age":18}
📊第二组vars = {"id":2, "name":"tan2", "age":20}
📊第三组vars = {"id":3, "name":"tan3", "age":30}
我们现在将第一组的数据中的key对应的值替换了yaml中的${变量},并得到一个新的测试用例对象CaseInfo对象,所以接下来我们继续循环替换所有组数据
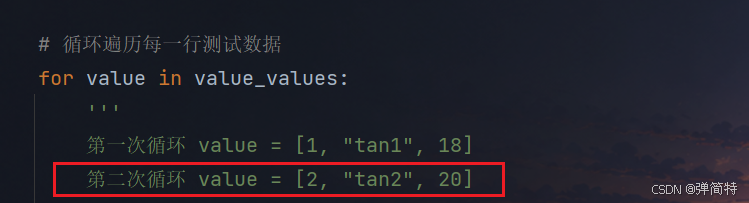
最终我们返回的值就是
ddt_case_list = [CaseInfo对象1, CaseInfo对象2, CaseInfo对象3]
然后我们将这组值使用extend方法得到👇
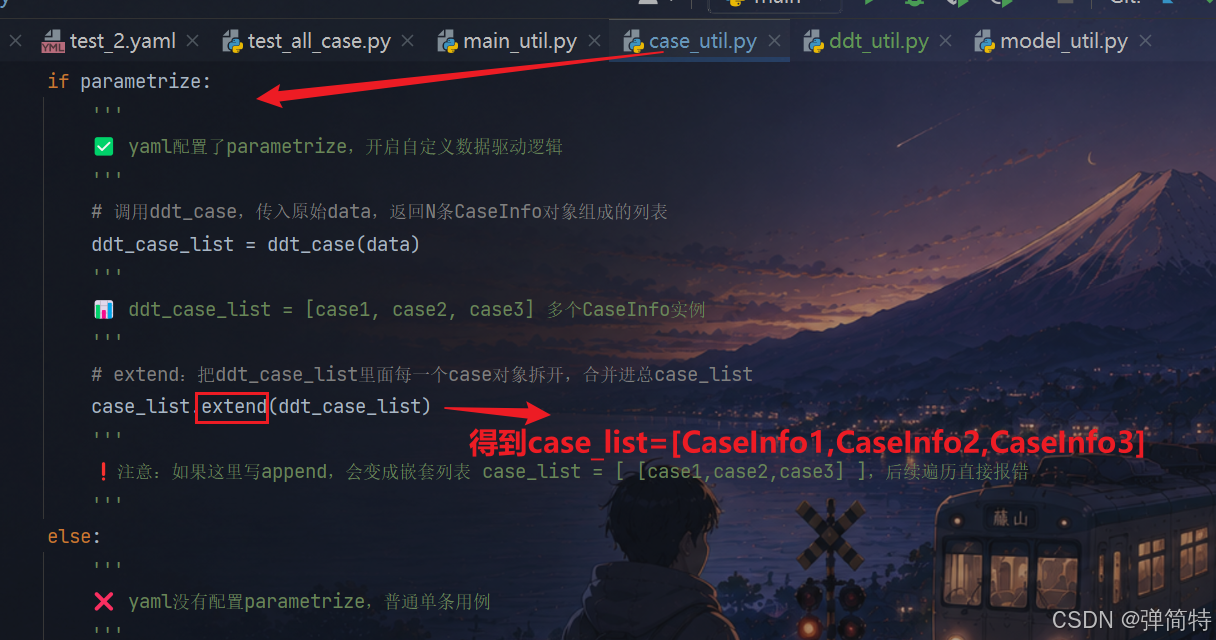
最后我们的程序就正常来到下图中,继续完成我们后续的用例执行
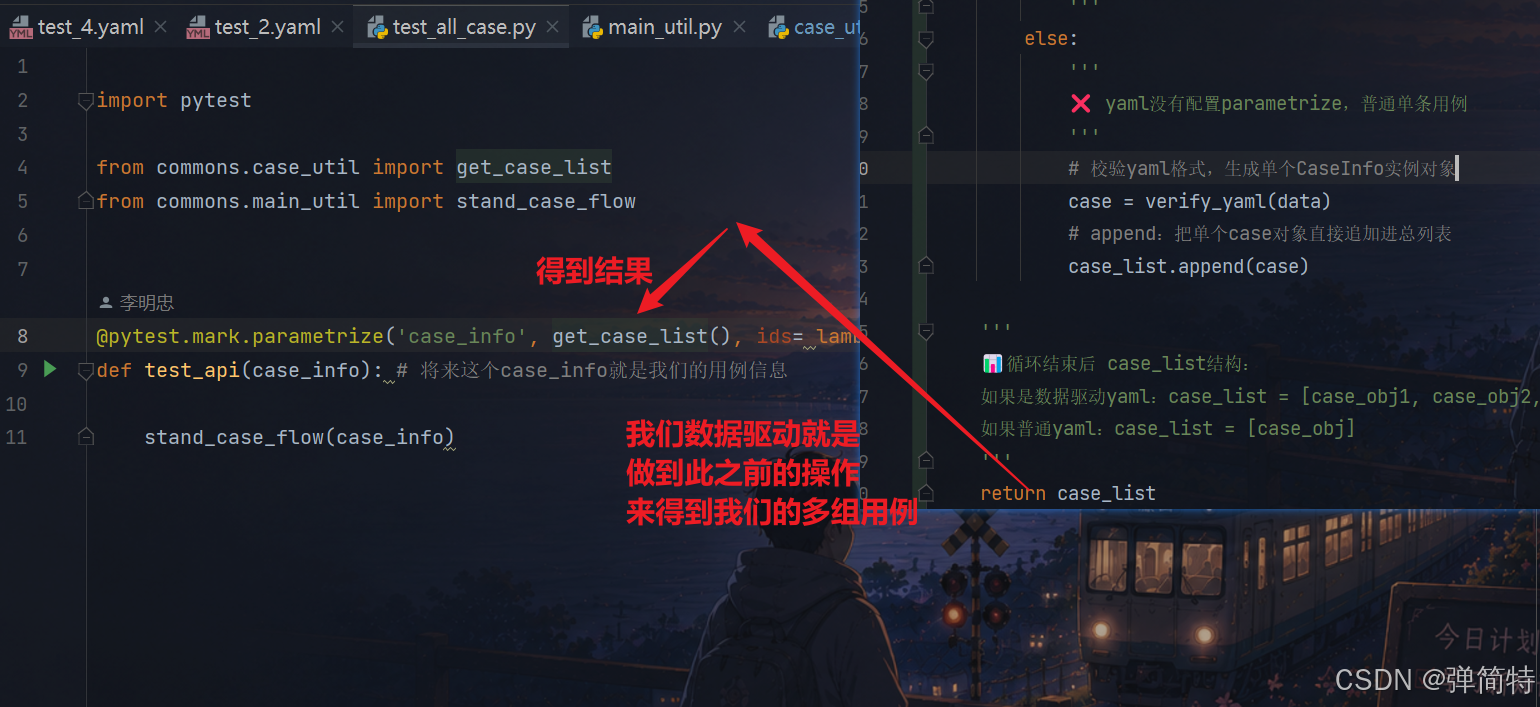
至此,我们的数据驱动完成。
流程用例
我们在数据驱动的基础上进行数据流程
1、什么是流程用例?
我们之前的JMeter和postman他们是以接口为单位的,我们都是要先新建一个接口,一个接口就是一个用例。
相比于上述两个,我们Python自动化他是以用例为单位的,也就是说,一个用例可能包含一个接口请求,也可能有多个接口请求,也就是说一个用例有可能是由多个接口构成的。
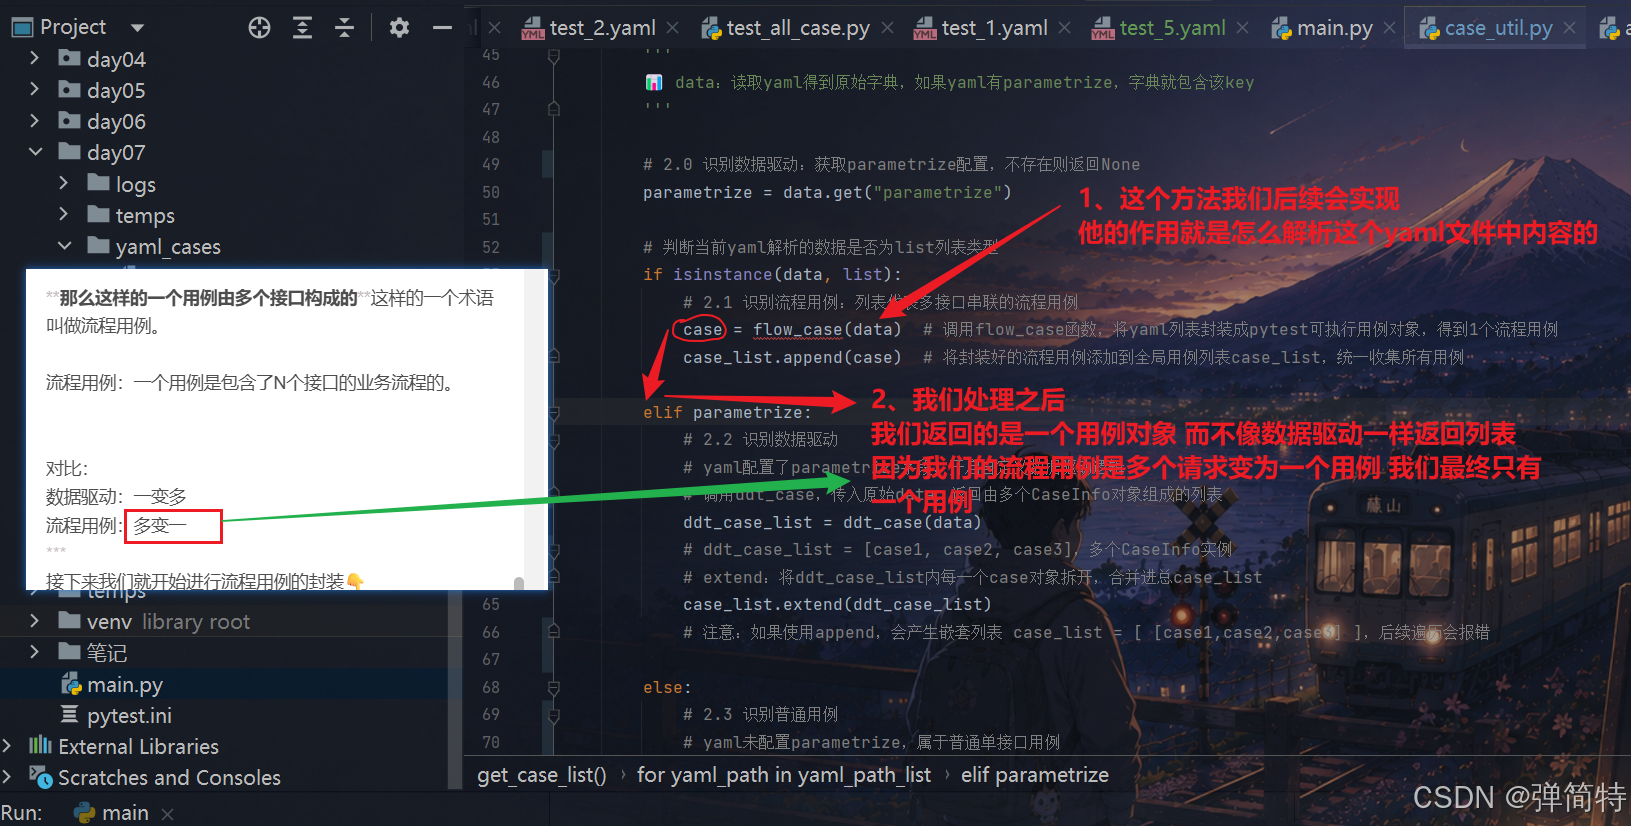
那么这样的一个用例由多个接口构成的这样的一个术语叫做流程用例。
流程用例:一个用例是包含了N个接口的业务流程的。
对比:
数据驱动:一变多
流程用例:多变一
接下来我们就开始进行流程用例的封装👇
2、YAML流程用例的封装思路
- **多个接口请求,只识别为一个用例,只产生一个结果(这个是多变一的核心) 。**解释:
其实就比如是5个分开的接口我们将他合并在一起 - **其中一个接口请求失败了,那么后续的接口请求就终止(流程中断)。**解释:
那么合并在一起的目的只是说为了少打印几个结果呢?其实不是的,流程用例就是我要先干这个 再干这个,如果我先干的这个事情失败了,那么我后面 要干的事情就没有必要干了,好比我先登录再下单,我都登录失败了,那么后面肯定是没有必要下单的 - 那么有一个疑问:我们有多个接口,请问我们的断言写几个呢?比如我前面的4个接口写完了,那么我是最后一个接口 再断言么?这样不太合理吧,因为我们之所以进行流程用例,就是因为我们的接口关联呀。所以:每个接口请求都可以进行断言和关联,但是有一个疑问:比如我们5个请求是同一个用例(一个yaml文件一个用例),那么我们是不是都要写用例名等等这些东西?如图:
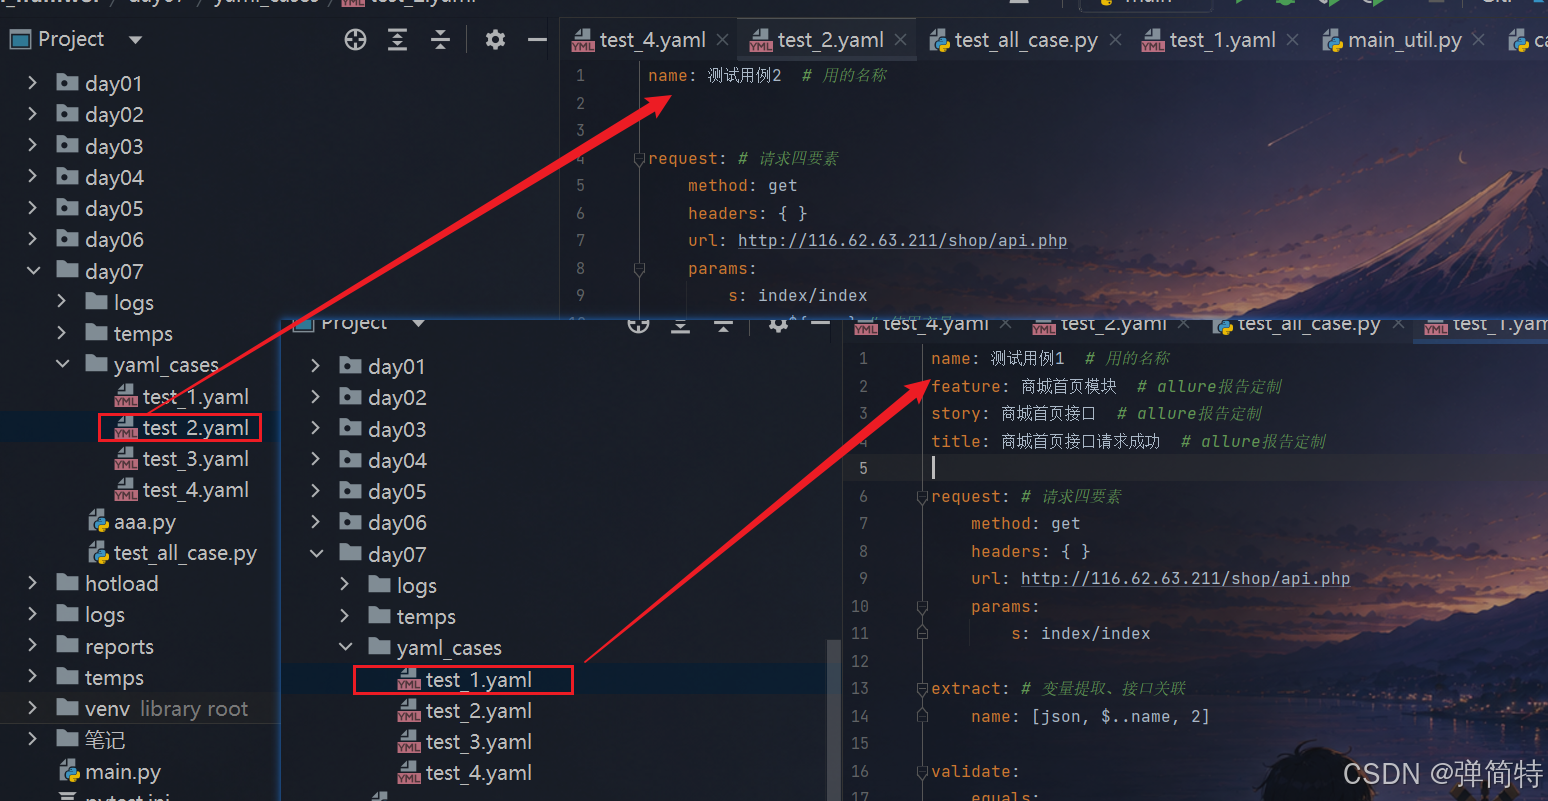
答案是不需要的,说白了比如这5个接口是同一个用例,那么我们是允许他们写断言和关联的但是我们不可以重复的定义我们的非断言和关联的内容,比如用例的名字和Allure标记 等等这些其他内容我们定义一次就行了
欧克,那么上述这三个点,我们怎么去实现呢?换句话说我们yaml的格式该设计成什么样子 才能够达到上述的目的呢?👇
3、YAML流程用例的设计
首先你看下面这个是一个接口请求:
name: 流程用例  # 用的名称
feature: 流程用例测试模块  # allure报告定制
story: 流程用例测试接口  # allure报告定制
title: 流程用例测试标题  # allure报告定制

request: # 请求四要素
    method: get
    headers: { }
    url: http://116.62.63.211/shop/api.php
    params:
        s: index/index
        id: 1

validate:
    equals:
    	两个值都是123: ["123", "123"]
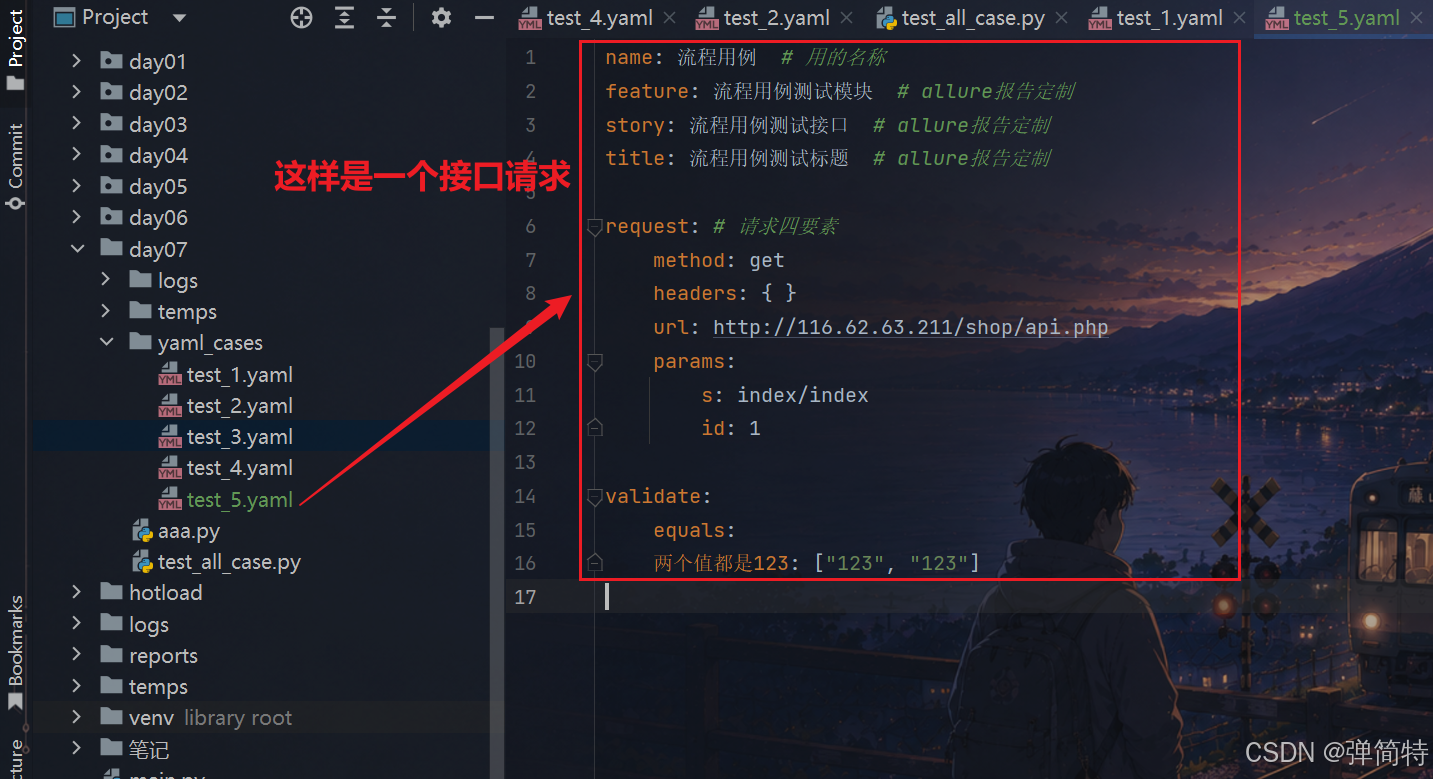
那么我们说了:多个接口请求是一个用例,此时我们怎么往后写多个接口请求呢?可以使用如下所示吗:
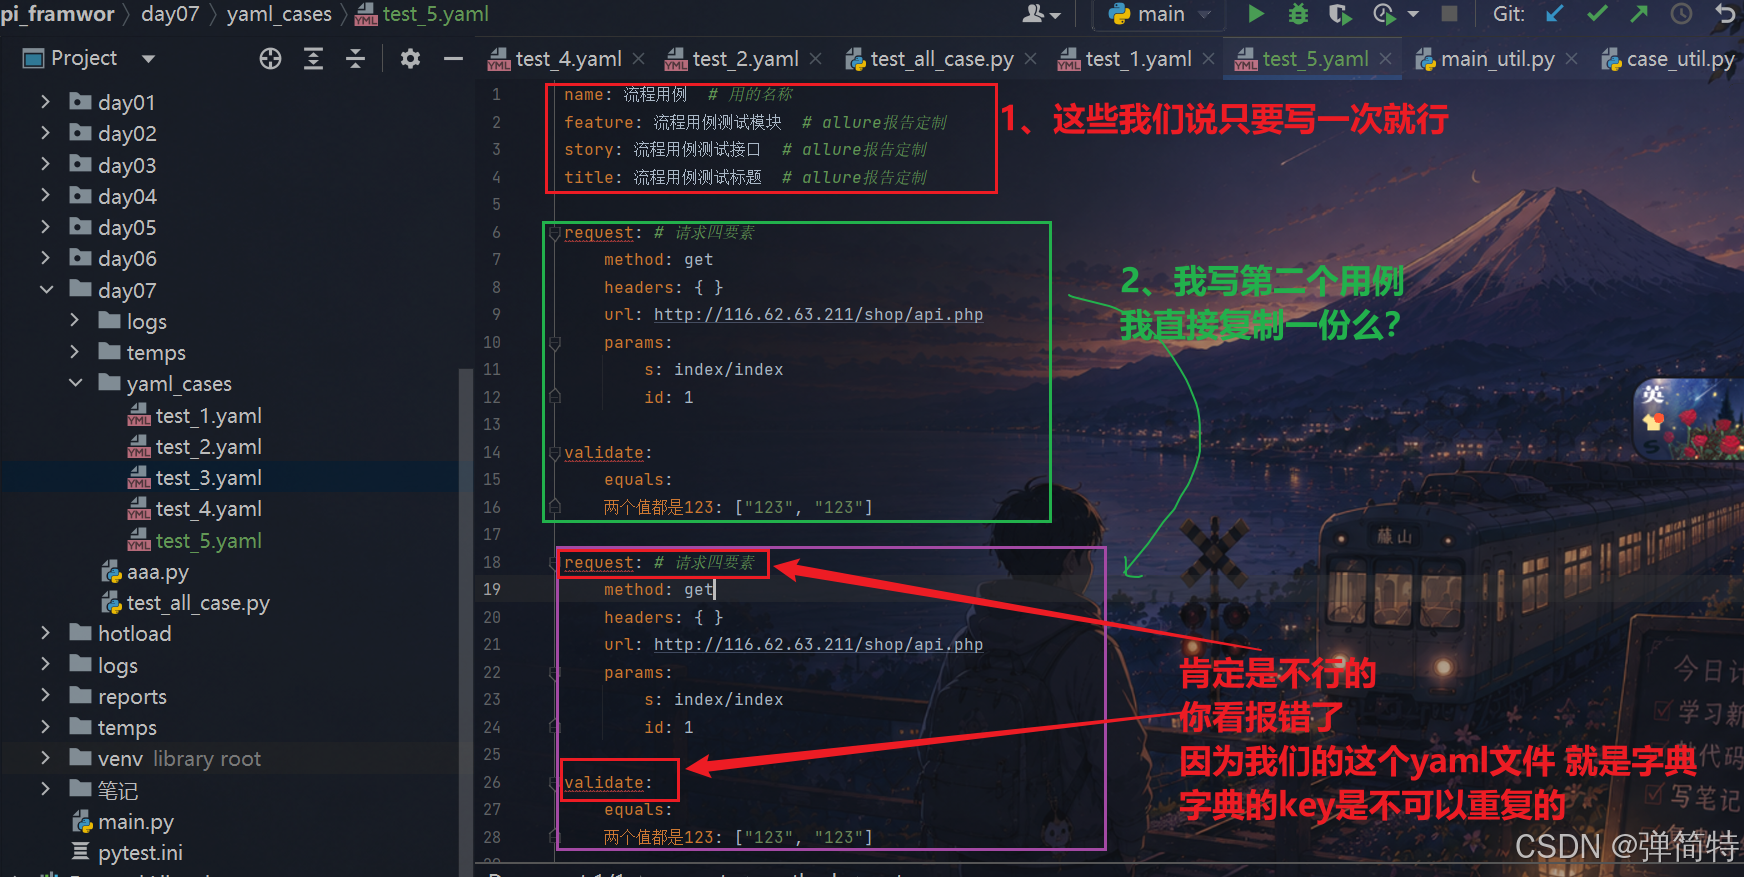
我们不可以直接复制一份, 那么怎么做呢?其实我们可以使用列表呀(数组),使用如下的方法:
# 测试用例:流程用例
- name: 流程用例                # 用例名称
  feature: 流程用例测试模块     # allure报告:模块名称
  story: 流程用例测试接口       # allure报告:接口故事
  title: 流程用例测试标题       # allure报告:用例标题
  request:                      # 请求信息块(接口请求四要素)
    method: get                 # 请求方法:GET
    headers: { }                # 请求头,这里为空对象
    url: http://116.62.63.211/shop/api.php  # 接口地址
    params:                     # URL查询参数
      s: index/index            # 参数s
      id: 1                     # 参数id
  validate:                     # 断言校验块,验证接口返回结果
    equals:                     # 相等断言
      两个值都是123: ["123", "123"]  # 断言描述,预期两个值相等

- request:                    # 第二个接口请求
    method: get                 # 请求方法:GET
    headers: { }                # 请求头,空
    url: http://116.62.63.211/shop/api.php  # 接口地址
    params:                     # URL查询参数
      s: index/index            # 参数s
      id: 2                     # 参数id
  extract:                      # 提取块:接口关联,提取返回值供后续用例使用
    name: [json, $..name, 2]    # 提取规则:json提取器,表达式$..name,取第2个匹配值

- request:                    # 第三个接口请求
    method: get                 # 请求方法:GET
    headers: { }                # 请求头,空
    url: http://116.62.63.211/shop/api.php  # 接口地址
    params:                     # URL查询参数
      s: index/index            # 参数s
      id: 3                     # 参数id
  validate:                     # 断言校验块
    equals:                     # 相等断言
      两个值都是123: ["123", "123"] # 相等断言
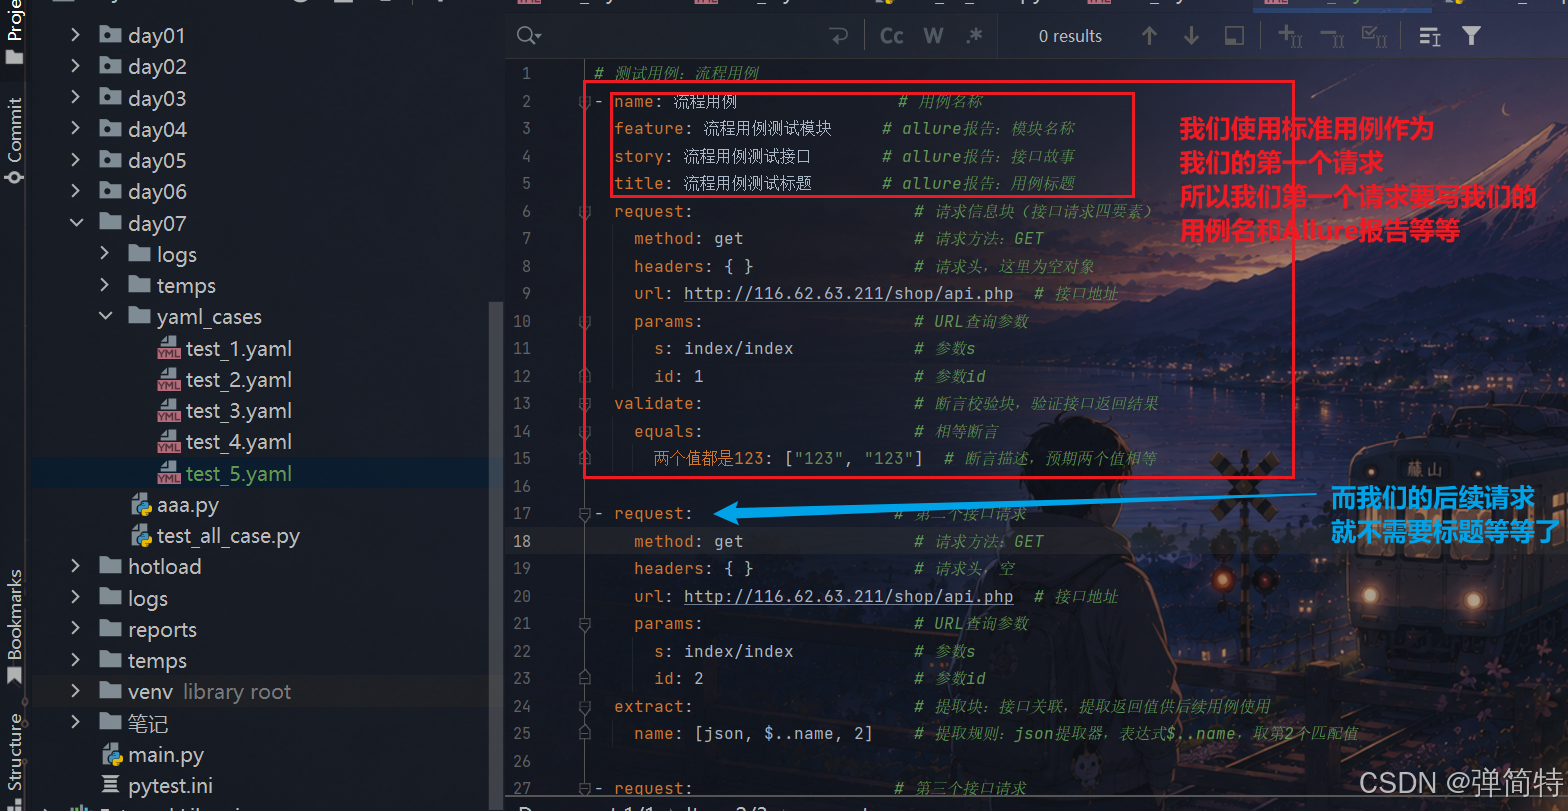
总结:
- 整个YAML文件以列表的形式,存储多份内容
- 第一份内容(第一个接口请求)作为用例基础,必须符合用例格式(name、allure、request)
- 其他份内容(其他请求)作为流程的后续步骤,只包含接口请求(关联、断言)
- 用例按照列表的顺序进行接口请求,如果中途失败,中止后续部分。
正是因为我们要按照顺序执行,所以我们的才使用列表,不用集合,因为列表是有序的
那么接下来我们就开始实现流程用例的封装👇
4、YAML流程用例封装实现
封装步骤:
- 识别流程用例,我们现在的yaml文件中的内容格式和原来的不一样啦,我们得知道怎么去识别它
- 实现流程用例,我们识别出来流程用例的yaml之后,我们要去实现我们的流程用例
- 实现(允许)我们的用例多次请求接口,我们之前的用例只是请求一次接口,而我们的流程用例是N个接口合为一个用例,所以我们得做到我们的用例进行多次接口请求,确保覆盖我们的这个N个请求接口. (注意:多次请求接口可不是重复请求一个接口多次喔)
4.1 识别流程用例
首先看这个文件:commons/case_util.py:
我们这个文件里面实现了两种yaml格式的文件,分别是数据驱动和普通用例
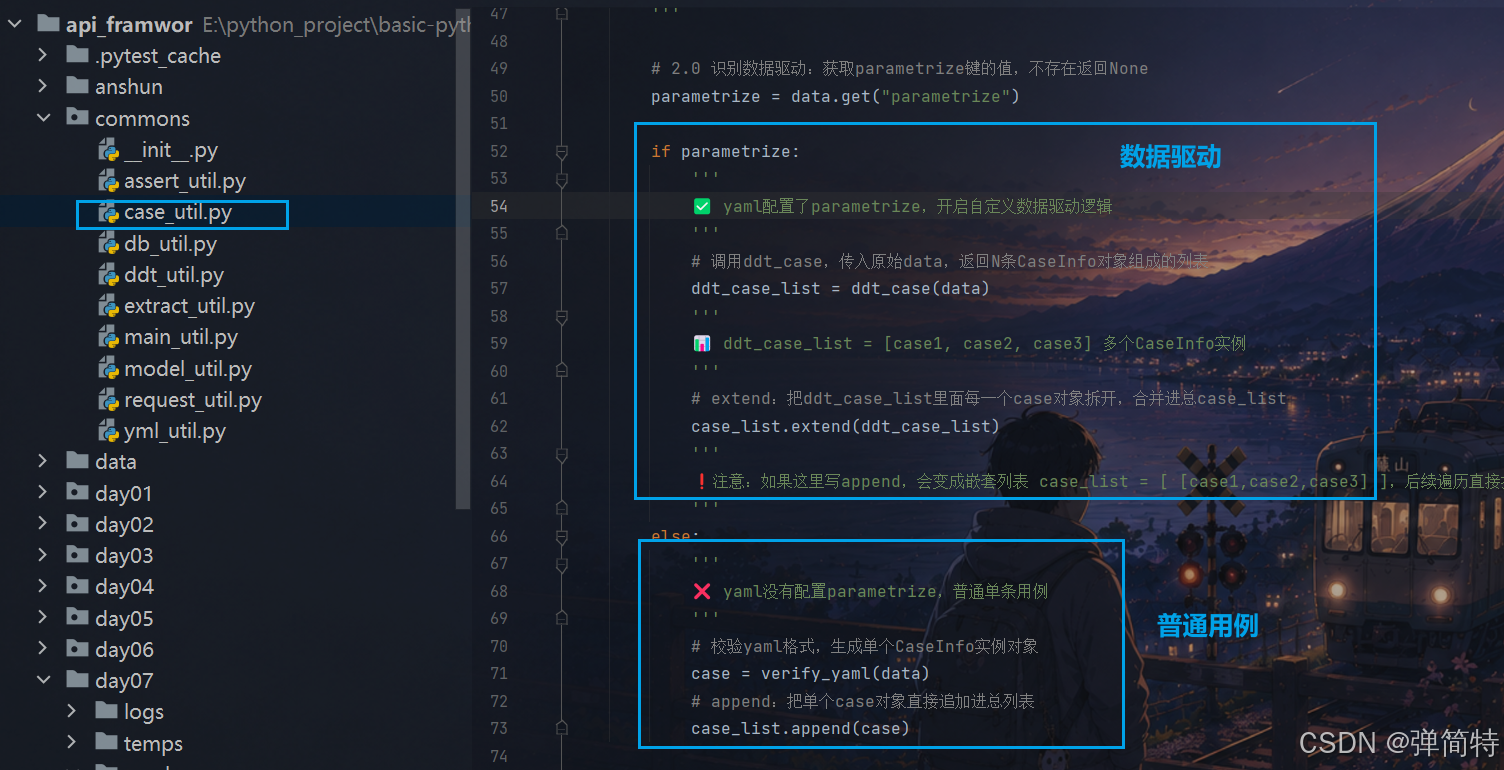
那么接下来我就先执行一下我们的用例:
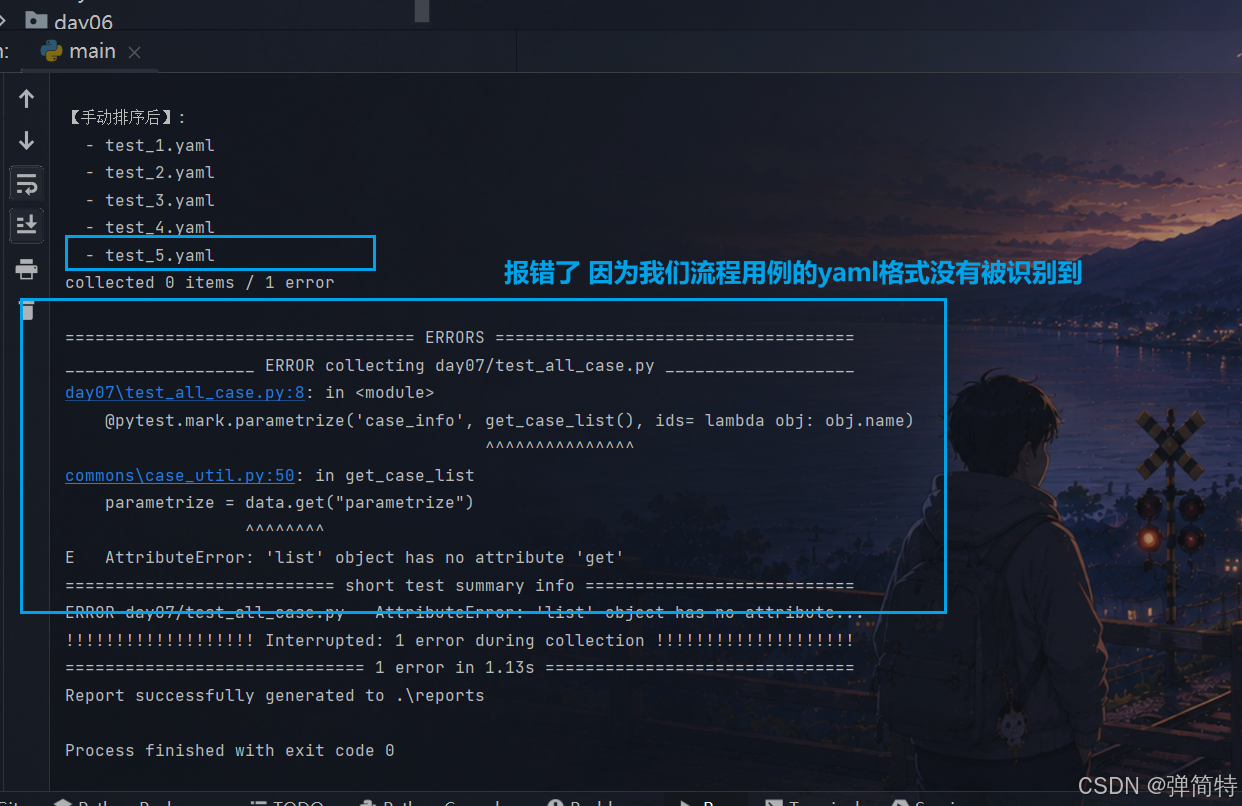
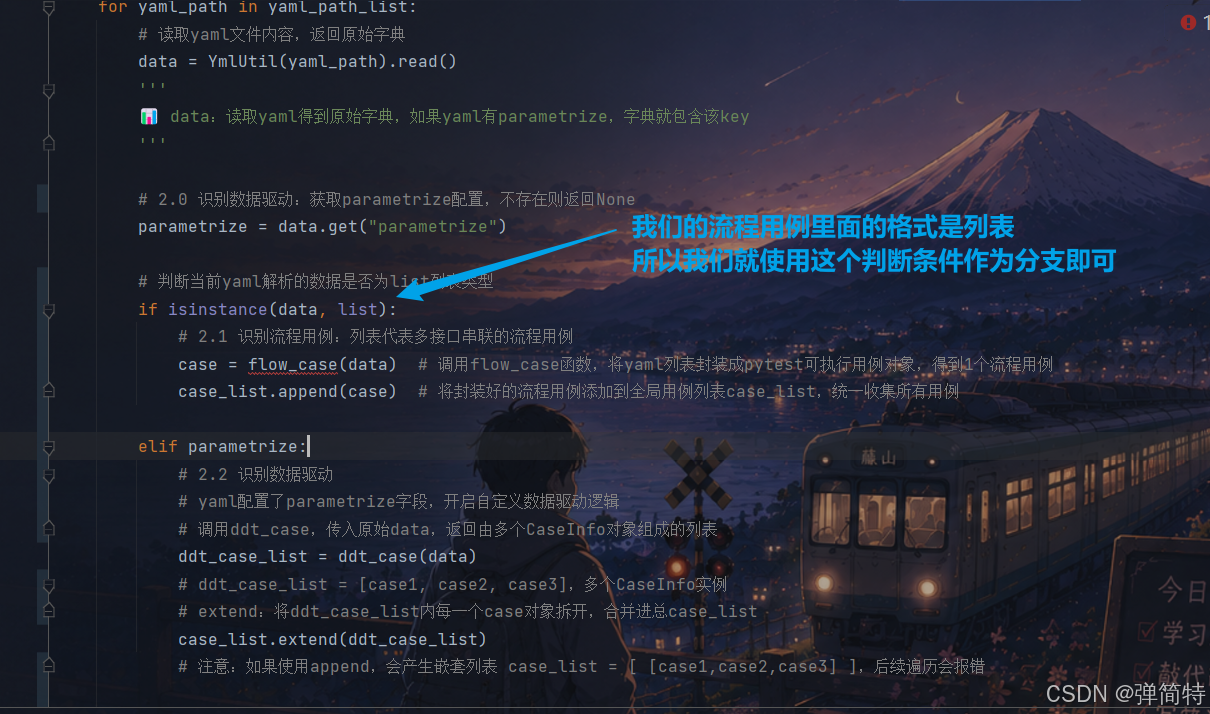
所以我们需要处理的是在这个文件中去识别我吗的流程用例,我们只需要加一个分支就好了👇:
       # 判断当前yaml解析的数据是否为list列表类型
        if isinstance(data, list):
            # 2.1 识别流程用例:列表代表多接口串联的流程用例
            case = flow_case(data)  # 调用flow_case函数,将yaml列表封装成pytest可执行用例对象,得到1个流程用例
            case_list.append(case)  # 将封装好的流程用例添加到全局用例列表case_list,统一收集所有用例

        elif data.get("parametrize"):
            # 2.2 识别数据驱动
            # yaml配置了parametrize字段,开启自定义数据驱动逻辑
            # 调用ddt_case,传入原始data,返回由多个CaseInfo对象组成的列表
            ddt_case_list = ddt_case(data)
            # ddt_case_list = [case1, case2, case3],多个CaseInfo实例
            # extend:将ddt_case_list内每一个case对象拆开,合并进总case_list
            case_list.extend(ddt_case_list)
            # 注意:如果使用append,会产生嵌套列表 case_list = [ [case1,case2,case3] ],后续遍历会报错

        else:
            # 2.3 识别普通用例
            # yaml未配置parametrize,属于普通单接口用例
            # 校验yaml格式,生成单个CaseInfo实例对象
            case = verify_yaml(data)
            # append:把单个case对象直接追加进总列表
            case_list.append(case)
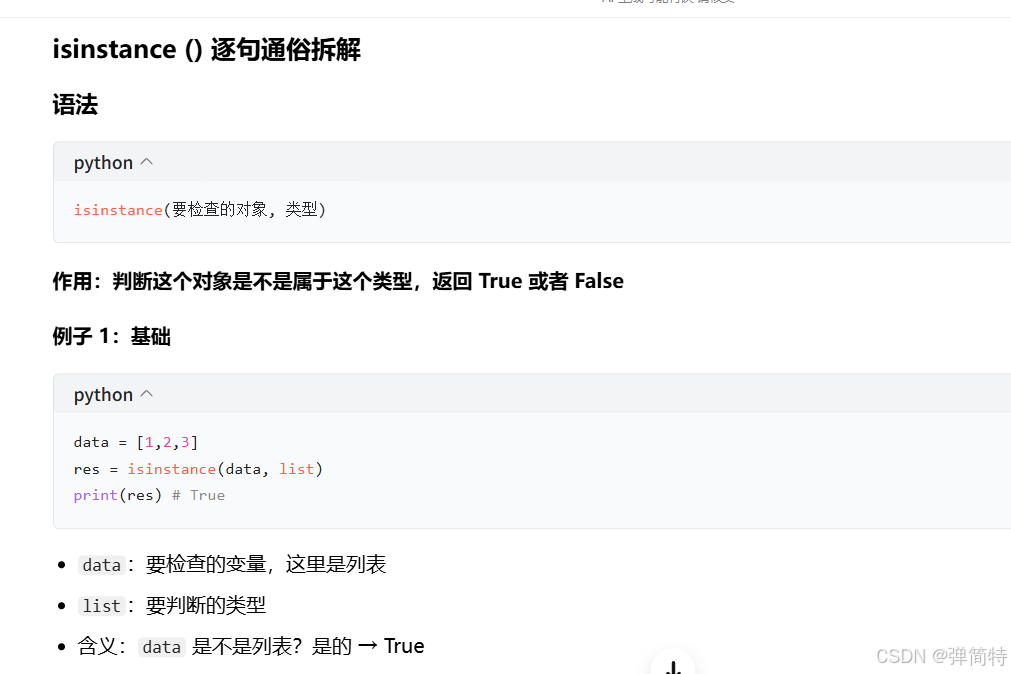
欧克,那么解释如下:
isinstance()方法的解释
完整代码:
from pathlib import Path
from commons.yml_util import YmlUtil
from commons.model_util import verify_yaml
from commons.ddt_util import ddt_case, flow_case

# 用例目录(相对路径)
case_dir_str = "day07/yaml_cases"


def get_case_list():
    # 总用例列表,存放所有最终执行的CaseInfo对象
    case_list = []

    # ====== 第 1 步:系统给你顺序(无法干预) ======
    case_dir_path = Path(case_dir_str)
    # 匹配目录下test_*.yaml全部用例文件,返回生成器转列表
    yaml_path_list = list(case_dir_path.glob("test_*.yaml"))
    '''
    📊 yaml_path_list:[PosixPath对象, PosixPath对象...] 文件路径对象列表,顺序由操作系统决定
    '''

    # 此时 yaml_path_list 的顺序由操作系统决定,不可控
    print("【系统默认顺序】:")
    for p in yaml_path_list:
        print(f"  - {p.name}")

    # ====== 第 2 步:你手动排序(完全干预) ======
    # 方式 1:按文件名升序(字母顺序)
    yaml_path_list.sort()

    # 方式 2:按文件名降序(反着来)
    # yaml_path_list.sort(reverse=True)

    # 方式 3:按自定义规则排序(比如按文件修改时间)
    # yaml_path_list.sort(key=lambda p: p.stat().st_mtime)

    print("\n【手动排序后】:")
    for p in yaml_path_list:
        print(f"  - {p.name}")

    # ====== 第 3 步:逐个读取yaml文件,识别是否开启数据驱动 ======
    for yaml_path in yaml_path_list:
        # 读取yaml文件内容,返回原始字典
        data = YmlUtil(yaml_path).read()
        '''
        📊 data:读取yaml得到原始字典,如果yaml有parametrize,字典就包含该key
        '''

        # 判断当前yaml解析的数据是否为list列表类型
        if isinstance(data, list):
            # 2.1 识别流程用例:列表代表多接口串联的流程用例
            case = flow_case(data)  # 调用flow_case函数,将yaml列表封装成pytest可执行用例对象,得到1个流程用例
            case_list.append(case)  # 将封装好的流程用例添加到全局用例列表case_list,统一收集所有用例

        elif data.get("parametrize"):
            # 2.2 识别数据驱动
            # yaml配置了parametrize字段,开启自定义数据驱动逻辑
            # 调用ddt_case,传入原始data,返回由多个CaseInfo对象组成的列表
            ddt_case_list = ddt_case(data)
            # ddt_case_list = [case1, case2, case3],多个CaseInfo实例
            # extend:将ddt_case_list内每一个case对象拆开,合并进总case_list
            case_list.extend(ddt_case_list)
            # 注意:如果使用append,会产生嵌套列表 case_list = [ [case1,case2,case3] ],后续遍历会报错

        else:
            # 2.3 识别普通用例
            # yaml未配置parametrize,属于普通单接口用例
            # 校验yaml格式,生成单个CaseInfo实例对象
            case = verify_yaml(data)
            # append:把单个case对象直接追加进总列表
            case_list.append(case)

    '''
    📊循环结束后 case_list结构:
    如果是数据驱动yaml:case_list = [case_obj1, case_obj2, case_obj3]
    如果普通yaml:case_list = [case_obj]
    '''
    return case_list
那么接下里我们就实现这个 flow_case()方法👇
4.2 实现流程用例
我们在commons/ddt_util.py文件中实现flow_case()方法:
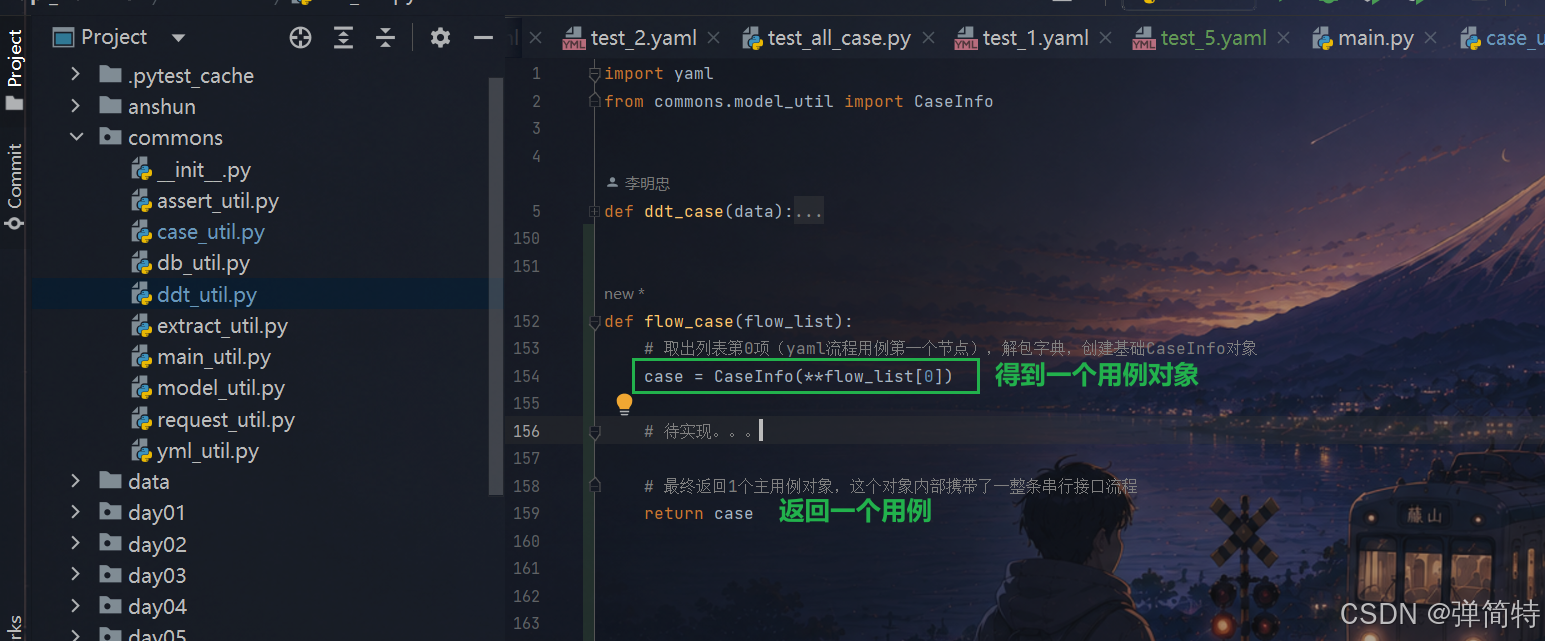
代码如下:
def flow_case(flow_list):
    """
    处理多接口串行流程用例
    :param flow_list: yaml解析后的list,列表内每一项是字典,对应yaml中每一个 `-` 节点
    :return: case 主CaseInfo对象,内部flow_list属性存放所有子接口子用例
    """
    # 取出列表第0项(yaml流程用例第一个节点),字典解包**,创建【主用例对象】
    # 第一个yaml节点存放整条流程共用的 name / feature / story / title 等allure信息
    case = CaseInfo(**flow_list[0])

    # 在主用例对象上新增 flow_list 属性,初始化为空列表,用来存放所有子请求子用例
    case.flow_list = []

    # 遍历flow_list里每一个yaml节点(所有带 `-` 的块),逐个封装成子用例
    for flow in flow_list:
        # 构建子用例sub_case,调用CaseInfo时会自动校验yaml字段格式合法性
        sub_case = CaseInfo(
            # 子用例继承主用例的名称,整条流程共用一套用例名称,子节点不允许单独定义name(不允许重复的内容,就从用例基础中读取)
            name=case.name,
            # 继承主用例的feature,allure模块标签,整条流程共用
            feature=case.feature,
            # 继承主用例的story,allure故事标签,整条流程共用
            story=case.story,
            # 继承主用例的title,allure用例标题,整条流程共用
            title=case.title,
            # 流程用例不支持内部嵌套数据驱动,固定置空字典
            parametrize={},
            # 获取当前节点的request请求配置;节点无request键时返回空字典,避免KeyError报错
            request=flow.get("request", {}),
            # 获取当前节点的validate断言配置;节点无validate键时返回空字典
            validate=flow.get("validate", {}),
            # 获取当前节点的extract变量提取配置;节点无extract键时返回空字典
            extract=flow.get("extract", {}),
        )
        # 将封装完成的子用例追加到主用例的flow_list列表中,按yaml顺序保存
        case.flow_list.append(sub_case)

    # 返回唯一的主用例对象,pytest收集时只识别为1条用例,内部串行执行所有子接口
    return case
解释:
问题1:case.flow_list = [] 为什么这么写?
case.flow_list = []
代码含义
给刚创建好的主用例case,新增一个叫flow_list的东西,把它设置成一个空的清单。
简单理解:原本的
case里面没有flow_list,是我们手动加上的。
为什么要写这一行?
-
准备一个收纳盒,用来装这条流程里所有的子接口步骤
举个例子:这条流程一共要连续调用3个接口。
case(主用例)只保存这条测试的名字、报告标签这类公共信息。
而3个接口各自的请求、断言、提取变量,需要一个地方统一存放。
flow_list就相当于一个空盒子,专门放这些子接口。 -
盒子要先造出来,才能往里面放东西
如果不写这一行,直接写代码往盒子里放内容,程序就会报错。
好比你还没有买盒子,就想把书本放进去,肯定不行。
先写case.flow_list = [],就是先准备好空盒子。 -
每条流程都有自己独立的盒子,不会混在一起
假如项目里有两条流程用例:流程A、流程B。
流程A会新建属于A的空盒子;流程B新建属于B的空盒子。
A的接口步骤只会放在A的盒子里,B的步骤放在B的盒子,不会互相串数据。
问题2:case.flow_list.append(sub_case) 为什么这么写?
case.flow_list.append(sub_case)
代码含义
把刚做好的子用例sub_case,放到主用例的flow_list清单(收纳盒)的最后面。
为什么这么写?
-
保持顺序,按照yaml写的顺序执行接口
yaml里写的顺序:接口1 → 接口2 → 接口3。
循环读取的时候也是这个顺序。
append就是依次往盒子末尾放东西。
盒子里面存放顺序和yaml写的一模一样。
后面运行测试时,就会按照这个顺序依次跑接口,前面接口拿到的数据,才能传给后面接口使用。 -
把子步骤挂到主用例上,整体算成1条测试用例
pytest只会识别主用例case,算作1条测试用例。
sub_case只是这条用例里面的小步骤,不能单独当成一条用例。
放到盒子里之后结构:
case(主用例,pytest看到的1条用例)
└── flow_list = [sub_case1, sub_case2, sub_case3](盒子,存放3个子接口步骤)
运行这条用例时,程序打开盒子,依次执行里面每一个子接口。
- 不放进盒子,这个子步骤就丢失了
sub_case只在本次循环的时候临时存在。
循环这一轮结束,如果没有放到盒子里保存,这个子接口信息就直接消失,后面测试就无法执行这个接口。
两段代码联动,完整过程(数据状态)
# 1. 创建主用例,存入整条流程共用信息(用例名称、报告标签)
case = CaseInfo(**flow_list[0])
# 2. 创建空盒子
case.flow_list = []
for flow in flow_list:
    # 3. 循环生成单个子接口步骤 sub_case
    sub_case = CaseInfo(...)
    # 4. 把子步骤放进盒子
    case.flow_list.append(sub_case)
循环第一次之后:盒子 case.flow_list = [sub_case1]
循环第二次之后:盒子 case.flow_list = [sub_case1, sub_case2]
循环第三次之后:盒子 case.flow_list = [sub_case1, sub_case2, sub_case3]
接下来我们运行 然后看日志:
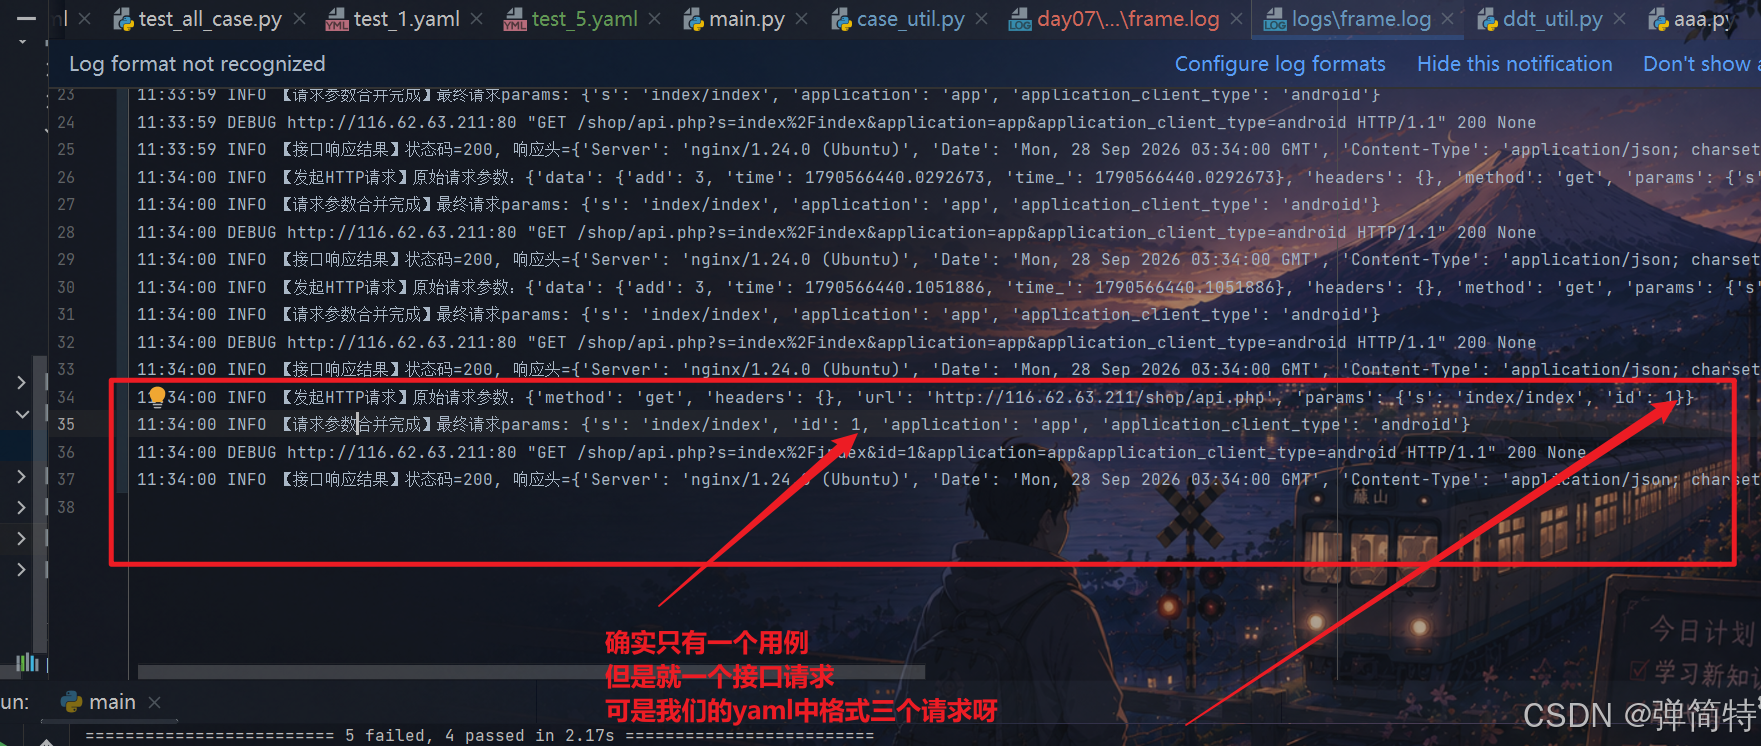
所以我们还得做下一步:就是我们的这个实现用例多次请求接口👇
4.3 实现用例多次请求接口
经过上述的情况,我们只是请求第一个接口,所以我们得设计做到其他接口也要被请求,这个就是我们要做的实现用例多次请求接口:
我们要操作的文件就是我们的commons/main_util.py文件:我们这个文件是发送接口请求的,目前他只是完成一次变量注入、一次接口请求、一次接口断言、一次变量提取
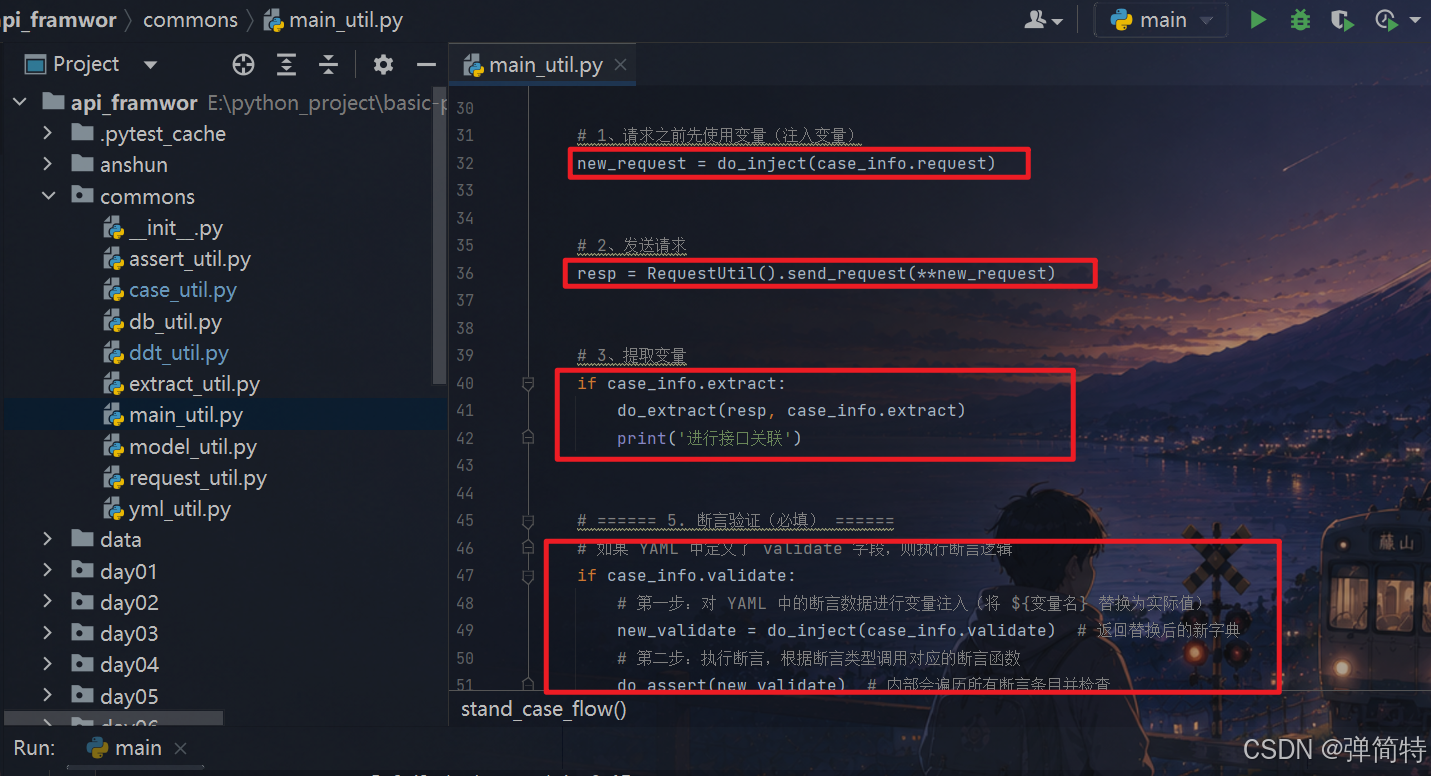
我们想让他执行多次我们就只要将上述的放到一个循环中就行了,代码如下:
    for flow in case_info.flow_list:
        # 1、请求之前先使用变量(注入变量)
        new_request = do_inject(flow.request)

        # 2、发送请求
        resp = RequestUtil().send_request(**new_request)

        # 3、提取变量
        if flow.extract:
            do_extract(resp, flow.extract)
            print('进行接口关联')

        # ====== 5. 断言验证(必填) ======
        # 如果 YAML 中定义了 validate 字段,则执行断言逻辑
        if flow.validate:
            # 第一步:对 YAML 中的断言数据进行变量注入(将 ${变量名} 替换为实际值)
            new_validate = do_inject(flow.validate)  # 返回替换后的新字典
            # 第二步:执行断言,根据断言类型调用对应的断言函数
            do_assert(new_validate)  # 内部会遍历所有断言条目并检查
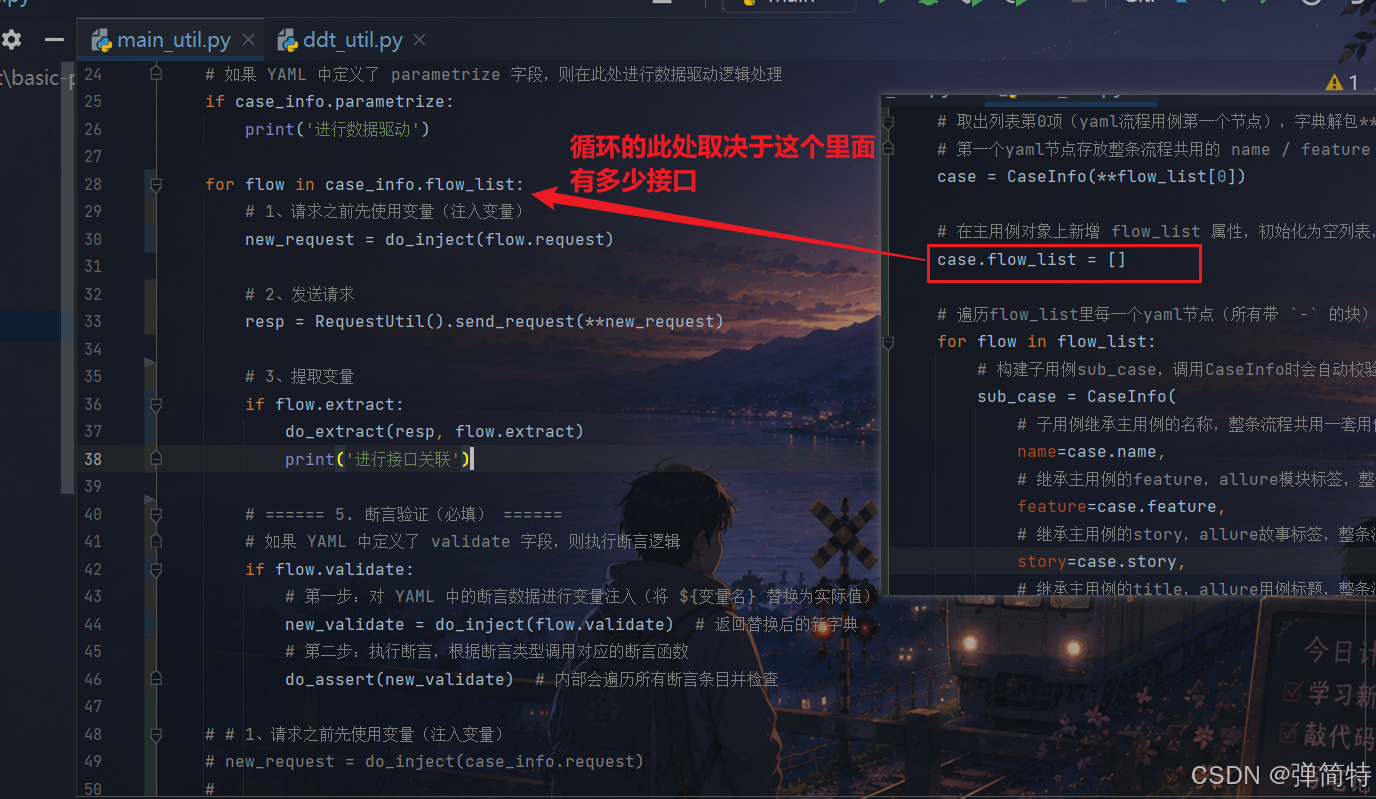
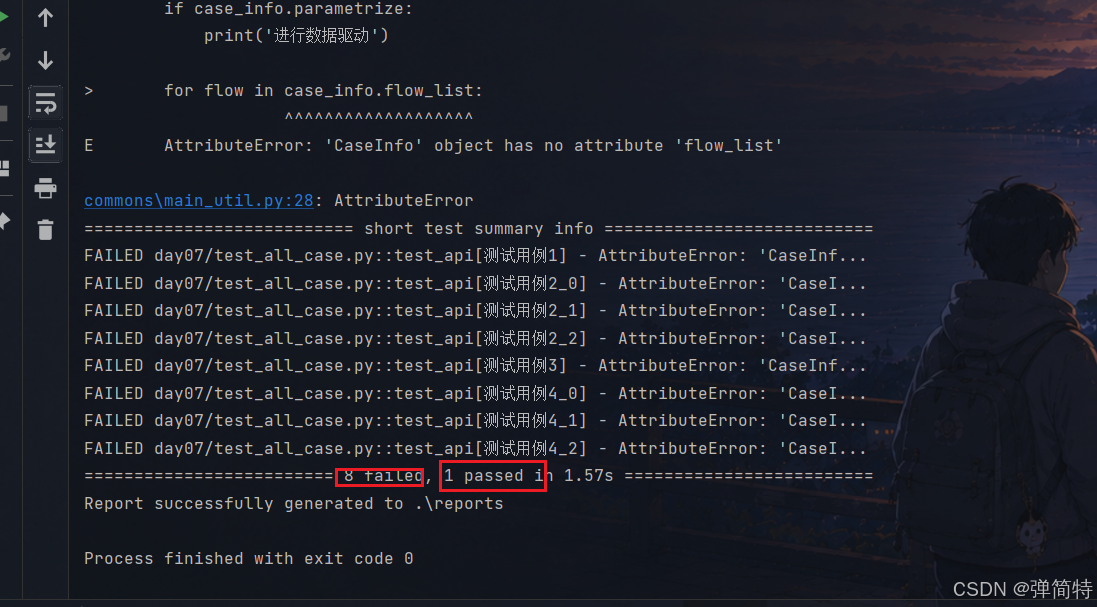
然后接下来我们运行你会发现报错了:只有我们的流程用例通过
如何规避呢?我们只需要兼容就行啦,我们不仅要他能够执行流程用例 还要兼容之前的其他用例:
跟着我改造就行:
1)先写如下代码 再解释
 # 兼容流程用例和非流程用例
    if case_info.flow_list:
        flow_list = case_info.flow_list
    else:
        flow_list = [case_info]

    for flow in flow_list:
        # 1、请求之前先使用变量(注入变量)
        new_request = do_inject(flow.request)

        # 2、发送请求
        resp = RequestUtil().send_request(**new_request)

        # 3、提取变量
        if flow.extract:
            do_extract(resp, flow.extract)
            print('进行接口关联')

        # ====== 5. 断言验证(必填) ======
        # 如果 YAML 中定义了 validate 字段,则执行断言逻辑
        if flow.validate:
            # 第一步:对 YAML 中的断言数据进行变量注入(将 ${变量名} 替换为实际值)
            new_validate = do_inject(flow.validate)  # 返回替换后的新字典
            # 第二步:执行断言,根据断言类型调用对应的断言函数
            do_assert(new_validate)  # 内部会遍历所有断言条目并检查
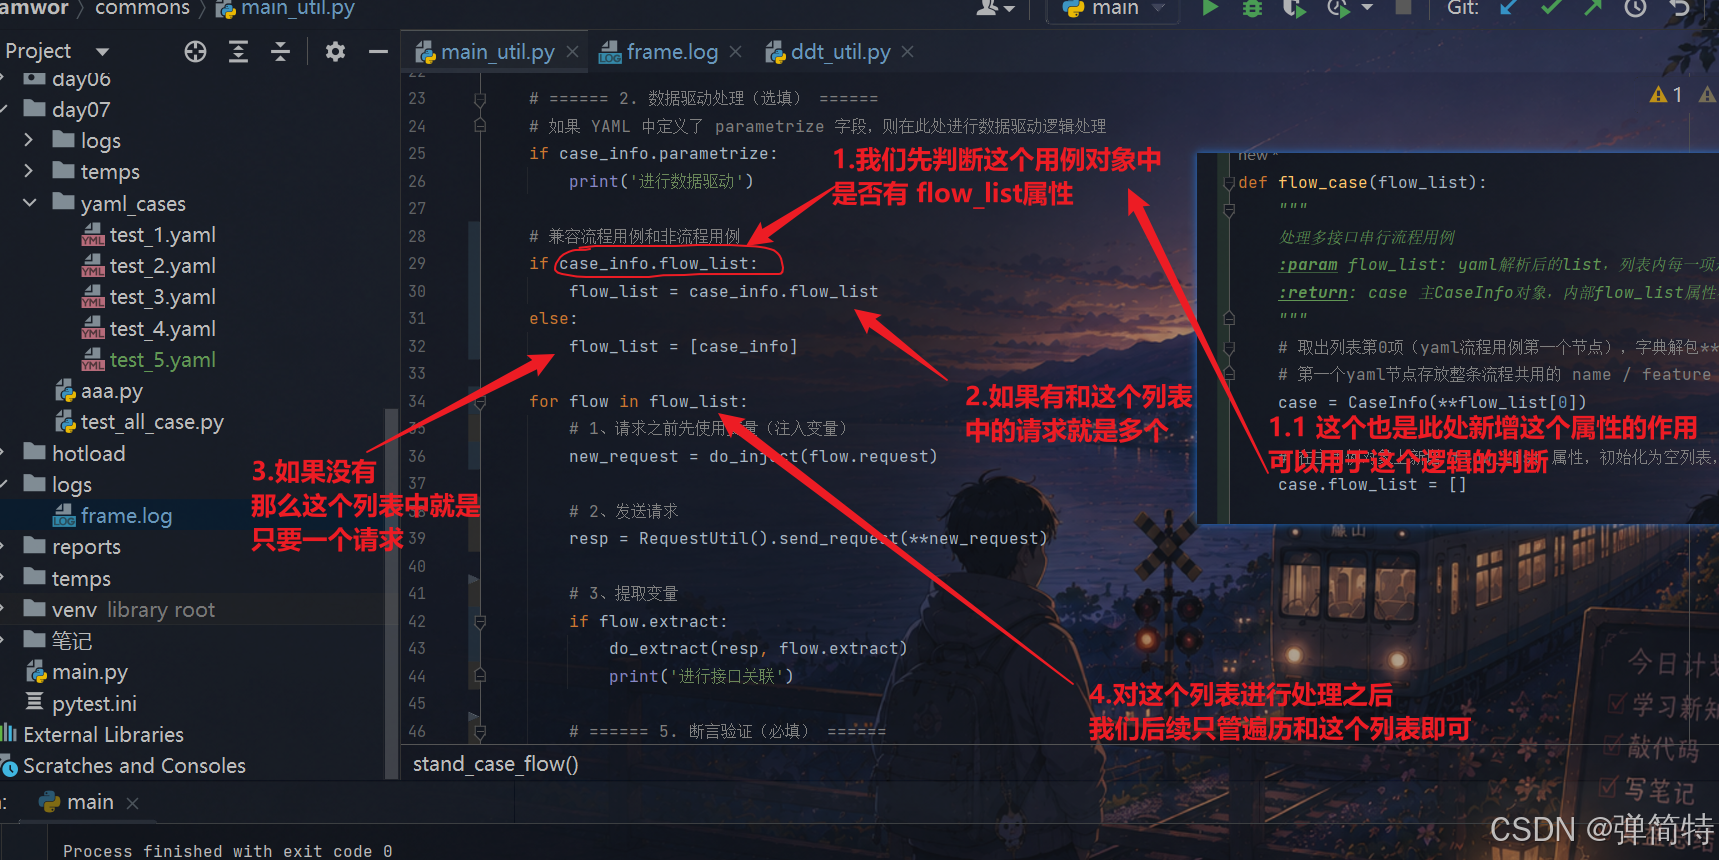
3)但是此处考虑到这个flow_list属性不存在的话是不可以这样读取的,所以,我们就在我们的模型中加一个选填字段,没有的话:
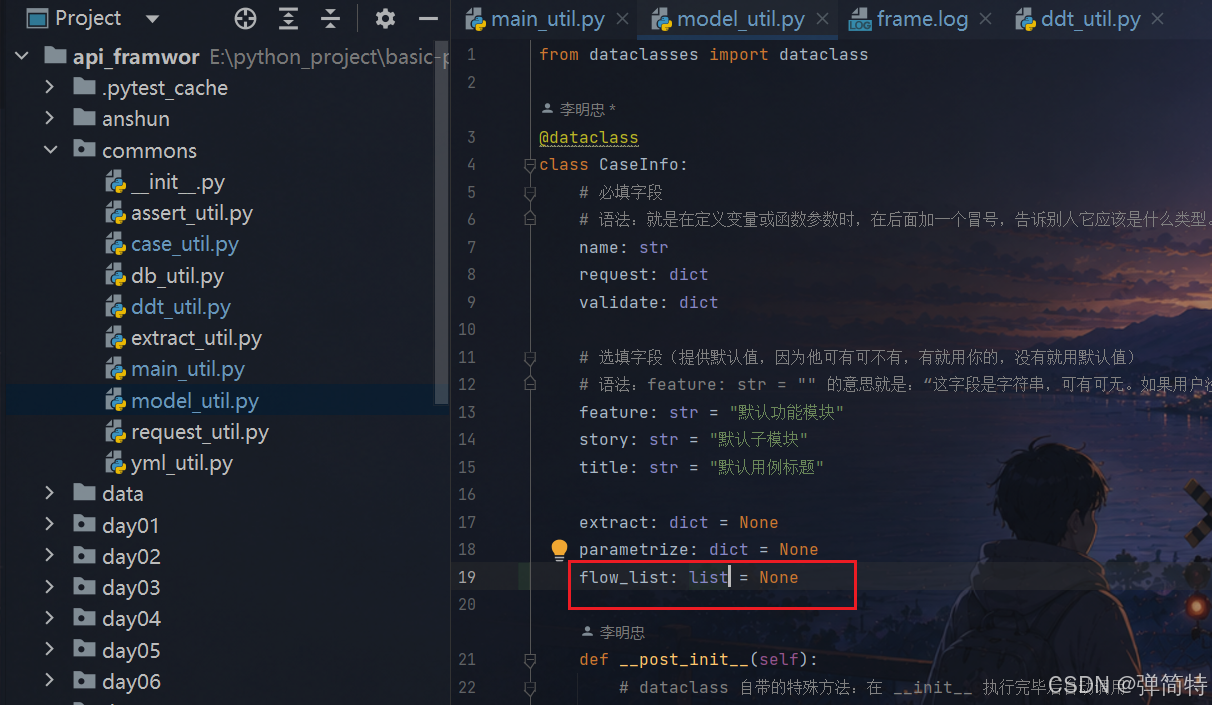
代码:
from dataclasses import dataclass

@dataclass
class CaseInfo:
    # 必填字段
    # 语法:就是在定义变量或函数参数时,在后面加一个冒号,告诉别人它应该是什么类型。
    name: str
    request: dict
    validate: dict

    # 选填字段(提供默认值,因为他可有可不有,有就用你的,没有就用默认值)
    # 语法:feature: str = "" 的意思就是:“这字段是字符串,可有可无。如果用户没写,那就默认给它一个空字符串,别让它报错。”
    feature: str = "默认功能模块"
    story: str = "默认子模块"
    title: str = "默认用例标题"

    extract: dict = None
    parametrize: dict = None
    flow_list: list = None

    def __post_init__(self):
        # dataclass 自带的特殊方法:在 __init__ 执行完毕后自动调用
        # 作用:对用户传入的数据做二次清洗和容错处理

        # 1. 强制转换 validate(断言规则)为字典
        #    即便 YAML 里写的是类似 {"equals": {...}},我们也确保它是个 dict,
        #    防止后续用 .get() 时报错
        self.validate = dict(self.validate)

        # 2. 处理 extract(变量提取)
        #    检查 extract 有没有内容(不为空且不为 None)
        if self.extract:
            # 如果有,强制转为字典。
            # 例如 YAML 中写 extract: {token: "$..token"} -> 变成 Python 字典
            self.extract = dict(self.extract)
        # 如果 extract 没写(即 None),就不处理,保持为 None

        # 3. 处理 parametrize(数据驱动)
        #    逻辑同上,如果用户传了数据驱动的内容,就确保它是字典格式
        if self.parametrize:
            self.parametrize = dict(self.parametrize)


# 写一个异常捕获,防止我们校验出错的时候我们的失败信息看不懂
def verify_yaml(data: dict):
     # 这是一个校验工具方法(目前定义为普通函数,建议加上 @staticmethod)
    # 作用:将 YAML 解析后的字典,安全地转换为 CaseInfo 对象
    try:
        # **data 语法:把字典拆开,作为关键字参数传给 CaseInfo 的构造方法
        # 比如 data={"name": "登录", ...}  -> CaseInfo(name="登录", ...)
        case_info = CaseInfo(**data)
        # 如果上面这行没报错,说明所有必填字段(name, request, validate)都存在
        # 并且 __post_init__ 也顺利执行完了
        return case_info  # 返回构建好的实例对象
    except Exception:
        # 捕获所有异常(缺少必填字段、类型错误等)
        # 抛出一个统一的、一眼就能看懂的提示,告诉写 YAML 的人哪里出错了
        # 这样测试运行时,错误信息会直接指向 YAML 文件格式有问题
        raise Exception('测试用例的YAML内容不符合框架要求')
commons/main_util.py完整代码:
import allure

from commons.assert_util import do_assert
from commons.extract_util import do_inject, do_use_vars, do_extract
from commons.request_util import RequestUtil


def stand_case_flow(case_info):
    print('测试用例的内容:', case_info)

    # ====== 1. Allure 报告动态定制 ======
    # 从 YAML 中读取 feature / story / title,动态生成 Allure 报告层级
    allure.dynamic.epic("自动化测试平台")
    if case_info.feature:  # 因为这个是选填 所以我们做判断
        allure.dynamic.feature(case_info.feature)

    if case_info.story:
        allure.dynamic.story(case_info.story)

    if case_info.title:
        allure.dynamic.title(case_info.title)

    # ====== 2. 数据驱动处理(选填) ======
    # 如果 YAML 中定义了 parametrize 字段,则在此处进行数据驱动逻辑处理
    if case_info.parametrize:
        print('进行数据驱动')

    # 兼容流程用例和非流程用例
    if case_info.flow_list:
        flow_list = case_info.flow_list
    else:
        flow_list = [case_info]

    for flow in flow_list:
        # 1、请求之前先使用变量(注入变量)
        new_request = do_inject(flow.request)

        # 2、发送请求
        resp = RequestUtil().send_request(**new_request)

        # 3、提取变量
        if flow.extract:
            do_extract(resp, flow.extract)
            print('进行接口关联')

        # ====== 5. 断言验证(必填) ======
        # 如果 YAML 中定义了 validate 字段,则执行断言逻辑
        if flow.validate:
            # 第一步:对 YAML 中的断言数据进行变量注入(将 ${变量名} 替换为实际值)
            new_validate = do_inject(flow.validate)  # 返回替换后的新字典
            # 第二步:执行断言,根据断言类型调用对应的断言函数
            do_assert(new_validate)  # 内部会遍历所有断言条目并检查
ok,执行之后 我们的用例就都通过了
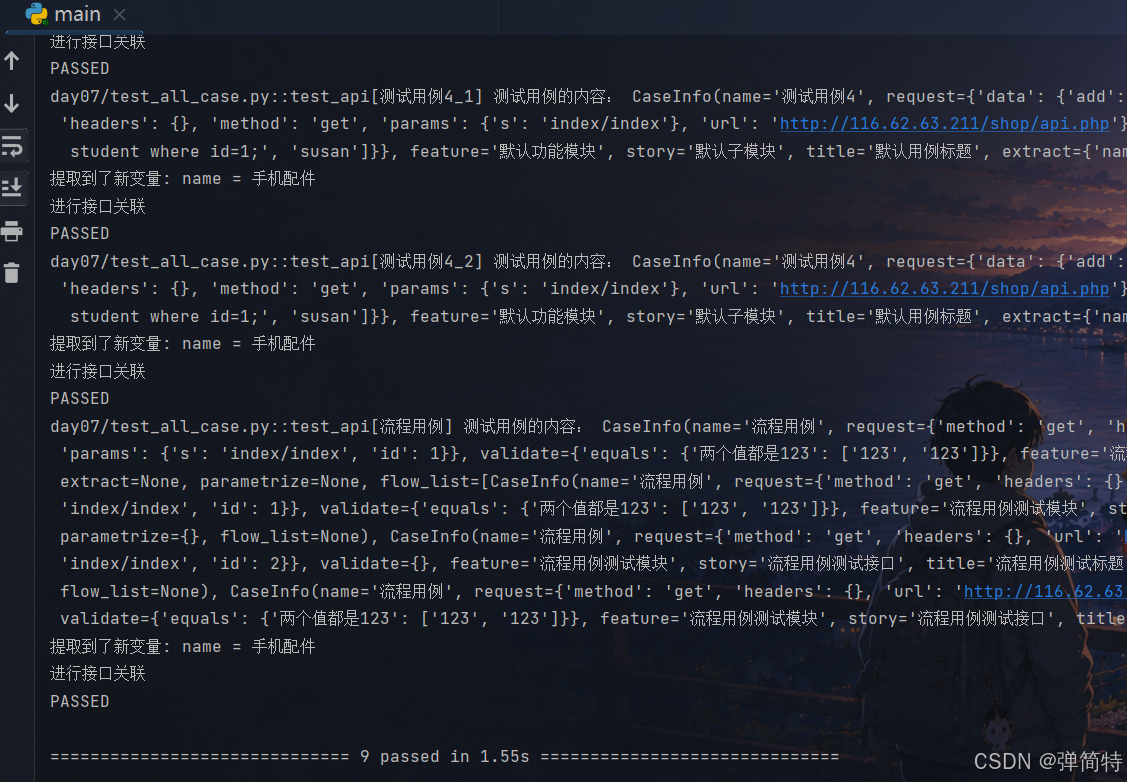
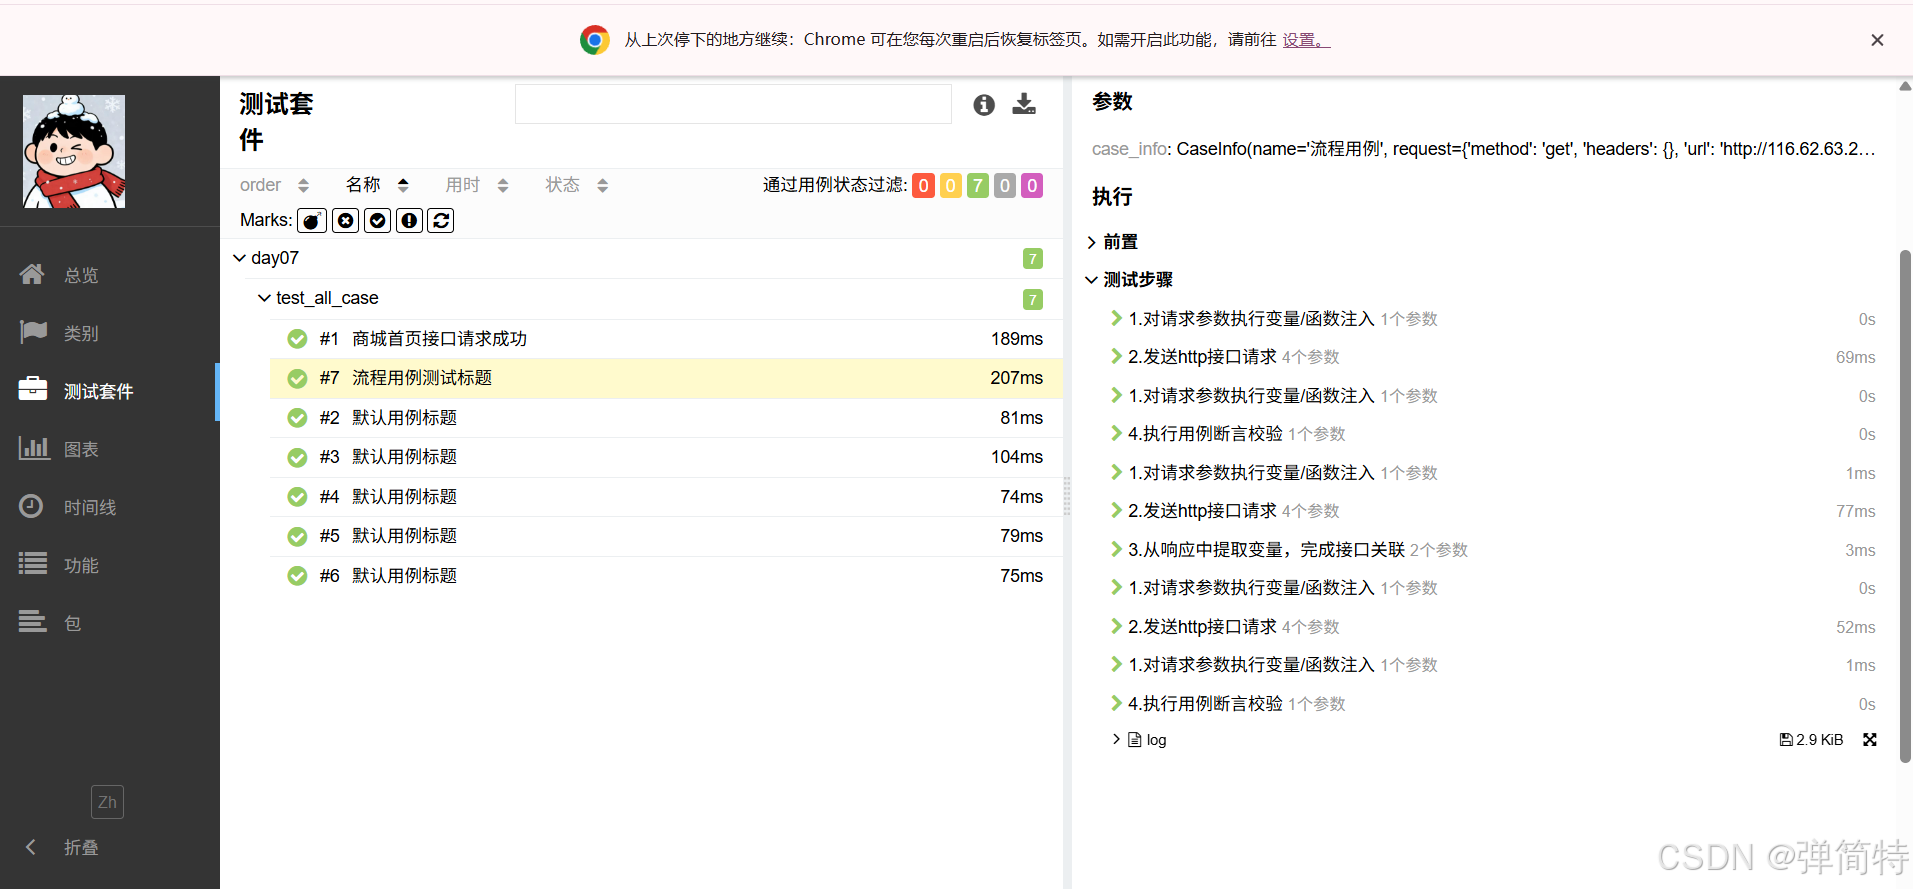
欧克,那么到此我们的流程用例和DDT数据驱动零代码框架封装就告一段落了。
但我们的接口测试框架的封装还没有结束,我们后续会继续介绍接口加密等等更多干货,老铁们如果本篇内容对你有帮助,不妨点赞收藏,也欢迎在评论区留言交流,你的每一份支持都是我持续创作的最大动力~👋

一站式 AI 云服务平台
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)