
用仓颉写一个 Tauri:IPC 的每次往返实现原理(web层到仓颉层的触发过程)
一、前言:我为什么要拿仓颉写一套 Tauri
先说清楚我在做什么,不然下面的数字没有坐标系。
我在写一个叫 cj-tauri 的开源项目:用华为的仓颉语言(Cangjie)当后端,用操作系统自带的 WebView 当渲染层,做一套和 Tauri 同思路的混合开发框架。仓颉代码静态编译成一个原生可执行文件,界面就是普通的 HTML / CSS / JS——Windows 上跑在 WebView2 里,Linux 上跑在 WebKitGTK 里。没有 Node、没有 Chromium 运行时,安装包小、启动快。
项目开源地址: https://atomgit.com/qq8864/cj-tauri
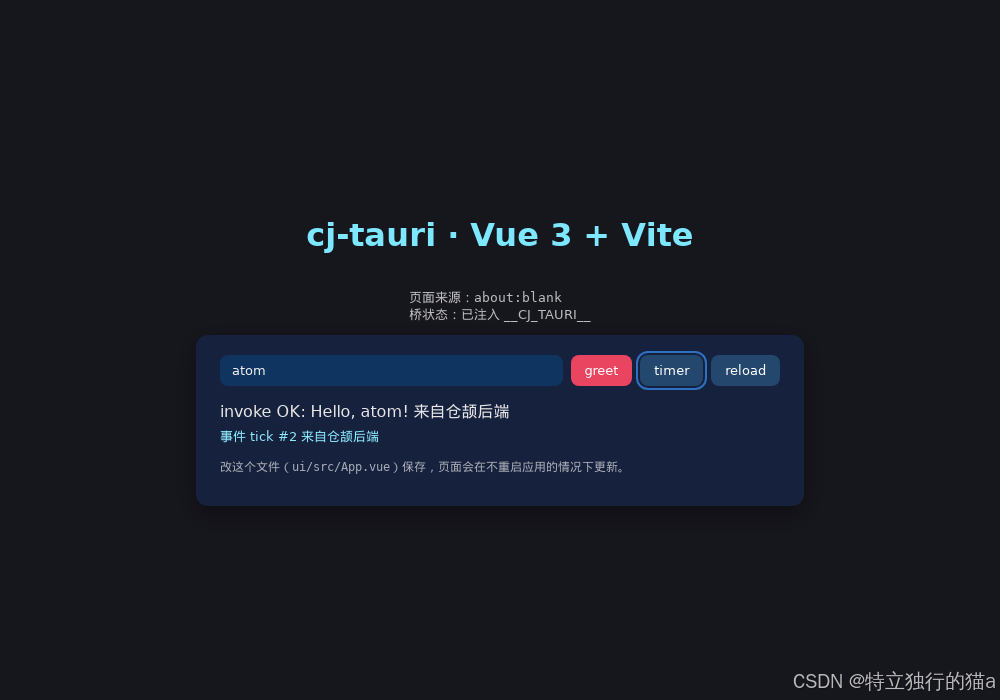
动机其实很朴素
仓颉是一门静态类型、编译型的系统级语言,工具链、包管理(cjpm)、跨平台交叉编译都已经能用。但你要拿它写一个带界面的桌面程序,会发现生态里没有成熟答案:GUI 库要么停在实验阶段,要么绑定得很难用。而“语言 + 系统 WebView”这条路已经被 Tauri 验证过了——Rust 负责逻辑和系统调用,界面交给 Web 技术栈,两边通过一个自己实现的 IPC 桥通信。这个架构最大的好处是把 GUI 这件难事外包给浏览器团队,语言只需要干好自己擅长的事:编译成原生代码、调系统 API。
仓颉在这两点上都不虚。于是就有了一套对标关系:
| cj-tauri 的三件套 | 对应 Tauri 里的东西 | 解决的问题 |
|---|---|---|
| WebView 宿主 | tao / wry | 开窗口、加载页面、收发消息 |
| IPC 双向桥 | invoke / resolve / event | 前端调后端、后端推前端 |
| 能力安全模型 | capability 白名单 | 谁能调什么命令 |
这篇只聊中间那根桥
三块里我花时间最多的是 IPC。原因很简单:它同时是性能热点(每次交互都走一遍)、跨语言边界(JS → C → 仓颉)、以及安全边界(唯一能拦住非法调用的地方)。三者叠在一起,任何一处设计偷懒都会在别的地方还回来。
所以本文只回答四个问题:
- 一次
invoke从页面发出到 promise 落地,路上到底经过了什么? - 这 0.39 毫秒里,哪些是固定开销,哪些是业务开销?
- 既然 localhost 上跑个 WebSocket 只要 0.151 ms,为什么不干脆用 WebSocket?
- 高频事件(鼠标移动、进度条、动画)会不会把界面拖死?Tauri 是怎么处理的,我们又做了什么?
文里的数字全部是我在本机跑出来的,探针随仓库发布,文末给了复现命令——你可以自己跑一遍,跑出不一致欢迎来提 issue。
二、cj-tauri 是什么,代码在哪
在拆 IPC 之前,先把项目本身交代清楚,不然聊到 jsSink、capabilities 这种词你会不知道它们从哪冒出来。
定位:用仓颉写后端、系统 WebView 写前端的混合开发框架,对标 Tauri 2。
仓库地址(双仓同步,代码一致):
- AtomGit(主仓,提 issue 走这里):https://atomgit.com/qq8864/cj-tauri
- GitHub(镜像,方便海外访问):https://github.com/yangyongzhen/cj-tauri
两个仓库每次提交都是同一个 commit,用 git push origin main 一次推两边;GitHub 这边是一个只读镜像,讨论和 issue 建议放在 AtomGit。
现在能跑到什么程度:
- Windows(WebView2)和 Linux(WebKitGTK)两个平台都已实机跑通,不是“理论上支持”;鸿蒙 ArkWeb 留了架构位,还没实现;
- 自带一套仓颉原生脚手架 CLI:
cj-tauri create/build/dev/run/info; - 三个工程模板:内联 HTML 的零 Node 样板、Vue 3 版、React 18 版(后两个带
ui/前端工程,cj-tauri dev会接管 Vite dev server); - 插件体系:实现一个
Plugin接口就能接入,官方带了fs、shell两个插件;权限仍然由capabilities/下的 json 决定,插件只声明“我提供什么”,不自动放行任何命令; - 当前版本 0.4.0,工具链是仓颉 SDK 1.2.0 + stdx 1.2.0.1。
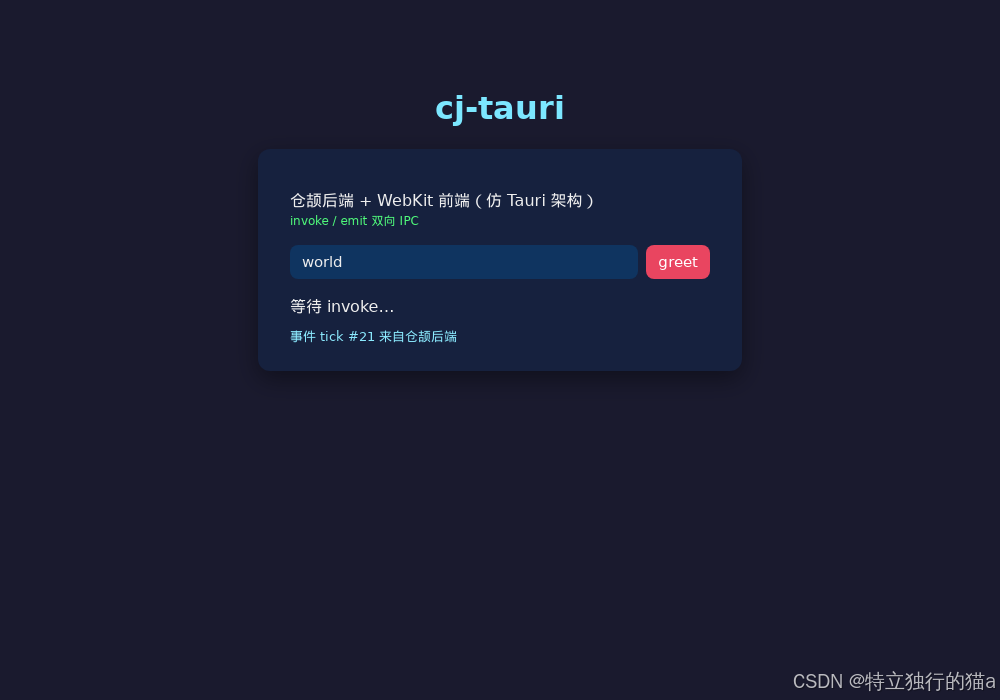
下面是 examples/hello 跑起来的样子——一个输入框,输入名字点按钮,走完整 IPC 往返拿回后端拼的问候语,同时后端每秒推一条 tick 事件回页面:
想跑起来看看,最短路径是用 npm 包(它会自动找本机 SDK,找不到会直接告诉你去哪装):
npm i -g cj-tauri
cj-tauri create myapp && cd myapp
cj-tauri run
想从源码构建:
git clone https://atomgit.com/qq8864/cj-tauri.git
cd cj-tauri
cjpm build                 # 构建框架
cd cli && cjpm build       # 构建 CLI
本文的实测环境(口径先说清)
后面所有数字都来自同一台机器、同一个环境,换了机器不保证复现:
- Linux + WebKitGTK,2 vCPU 的容器;
- 无显示器,用
xvfb-run起一个虚拟屏——这点很重要,后文还会提醒:Xvfb 下没有真实 GPU 合成,性能数字不能直接外推到桌面环境; - 仓颉 SDK 1.2.0 + stdx 1.2.0.1;
- 除了明确标“前后对照”的那张表,其余数字都是同一份应用二进制连跑三轮取中位,不是挑最好的一轮。
三、链路只有三层,每层只干一件事
先看骨架:
页面 JS    window.__CJ_TAURI__ { invoke, listen, emit, reload }
          出站:JSON.stringify(obj) → postMessage(一条字符串)
──────────────────────────────────────────────────────────────
宿主桥 C   Linux  :window.webkit.messageHandlers.cjtauri.postMessage
           Windows:window.chrome.webview.postMessage
           入站:原生回调 → 原样交给仓颉(C 层不解析 JSON)
           回投:_dispatch(json),加锁队列 + 空闲回调合并成批
──────────────────────────────────────────────────────────────
仓颉       解析 → 能力校验 → 命令分发 → worker 执行
           结果经 jsSink → 宿主 runJs → 回投
没有 socket,没有本地 HTTP 服务,没有端口。传输层用的就是 webview 自己那条消息通道——JS 和仓颉本来就活在同一个进程里,中间只隔一层原生消息回调,再架一层网络栈是自找麻烦。
有一条约束值得单独拎出来说:平台差异只允许出现在两个地方——仓颉侧的 @When 条件编译,和 native/bridge_linux.c / bridge_win.c 这两个 C 文件。协议、报文格式、能力校验、命令分发两平台共用一份代码。这条规矩是硬性写进项目开发契约的,好处在下面会体现:本文描述的流程 Windows 和 Linux 完全同构,差别只在 API 名字,以及“Windows 的 V8 跑在独立进程里”这一点。
四、报文只有四种,外加一条走后门的
协议小到可以整张贴出来:
| 报文 | 方向 | 形状 |
|---|---|---|
| invoke | JS → 仓颉 | {"type":"invoke","id":1,"cmd":"greet","args":{…}} |
| emit | JS → 仓颉 | {"type":"emit","id":2,"event":"save-done","payload":{…}} |
| resolve | 仓颉 → JS | {"type":"resolve","id":1,"ok":true,"data":…},失败则是 ok:false,"error":"…" |
| event | 仓颉 → JS | {"type":"event","event":"tick","payload":{…},"window":"main"} |
| 控制消息 | JS → 宿主 | 裸字符串 __cj_tauri_reload__,不进仓颉 |
四种报文撑起了全部功能,几条细节值得交代,都是实际踩过之后才定下来的:
链路上只跑字符串。 postMessage 传的永远是 JSON.stringify 的结果,C 桥原样上交、不做任何解析,整条链路只在仓颉侧解析一次 JSON(stdx 的 JsonValue.fromStr)。这意味着 C 层永远不知道报文里写了什么——它想插手也无从下手,这恰好是我们想要的状态。
请求和响应靠 id 配对,不靠顺序。 前端自增一个 seq 当 id,把 promise 的兑现函数存进 pending[id],回投时按 id 取出来兑现。这里有个不太符合直觉、但有意为之的行为:同一个命令并发调用不保证执行顺序。执行挪到 worker 之后天然并发,要保序就得在分发端加队列,我们判断不值——真有顺序要求,在业务层排队比在框架里排更清楚,也更容易按业务写清楚。
成功和失败共用一种报文。 都是 type:"resolve",失败只是多个 ok:false。代价是协议层看不出成败,前端必须自己看 ok;收益是分发端只有两个分支(resolve / event),前端桥那一百多行 JS 能一直保持可读。对一个还在 0.x 的框架来说,可读性比协议优雅重要。
reload 走旁路。 __cj_tauri_reload__ 是个裸字符串,C 桥 strcmp 命中就自己处理(记日志、投递重载),压根不进仓颉,也不受能力清单约束。它是个宿主控制消息,不是业务命令——如果让它走正常报文,万一某天能力清单收紧,热重载会被自己拦下来。
五、一次 invoke 的全程
以 Linux 为例,把一次 invoke 摊开:
页面                  C 桥(GTK 线程)          仓颉                     worker 线程
 invoke(cmd,args)
  ├ JSON.stringify
  ├ postMessage ──► on_script_message
  │                   ├ 是 __cj_tauri_reload__ ? 自己处理
  │                   └ 否则 g_on_message(str) ──► handleRawMessage
  │                                                 ├ InvokeRequest.parse  ← JSON 解析一次
  │                                                 ├ capabilities.canInvoke?  ─┐ 同步
  │                                                 ├ commands.contains?      ─┘ 拒绝
  │                                                 └ spawn ─────────────────► runCommand
  │                                                                             ├ handler.handle
 promise 挂起 ◄──────────────────────────────────────────────────────────────────┤
  │                                    g_idle_add(flush_pending_js) ◄── jsSink(resolve json)
  │                                        └ run_javascript ──► window.__CJ_TAURI__._dispatch(json)
  └ _dispatch {type:'resolve',id,ok,data} → pending[id].resolve(data)
一步步说:
出站。 invoke(cmd, args) 生成 id,把 promise 的兑现函数塞进 pending[id],然后 postMessage(JSON.stringify({type:'invoke', id, cmd, args}))。就这一件事,前端桥里没有别的魔法。
入站,C 层。 Linux 是 on_script_message(由 webkit_user_content_manager_register_script_message_handler 注册的 cjtauri 通道),Windows 是 WebView2 的 WebMessageReceived。两端都只做两件事:拦 reload,把字符串上交。不解析、不路由——这条边界守得很死。
入站,仓颉侧。 TauriApp 装配时把 host.setMessageHandler 接到 hub.handleRawMessage。这里先解析,然后两道校验:能力清单放不放行这个命令,命令注册表里有没有这个命令。两道拒绝都发生在调用线程上、同步返回——这一点后面还会展开。
执行。 校验通过才 spawn 到 worker 跑 handler.handle。成功就 IpcMessage.resolve(id, result);业务抛 CommandException 就把异常消息 reject 回去,其他异常统一 reject(id, "command failed: …")。后端怎么炸,页面都不会崩,只会让那一条 promise reject。
回投。 worker 拼出 _dispatch(<json>) 交给 host.runJs,C 侧加锁入队,只允许宿主 UI 线程执行;执行完如果队列里还有货,就再调度一次。
兑现。 页面 _dispatch 按 id 找到 pending,resolve / reject,await 继续往下跑。
到此一次往返结束。流程本身不复杂,真正需要解释的是下面三处刻意为之的选择——它们都是踩过坑之后才定下来的。
六、三处刻意的设计
1. 回投必须排队,而且只有 UI 线程能执行
回投可能来自任何线程:worker、事件推送、对话框回调。而 GTK / WebKit 只允许在创建它们的那个原生 pthread 上调用——这条规则大家写过 GUI 的都熟。
不熟的是后半句:在 Linux 上,仓颉轻量线程的堆上协程栈会被 JSC 的栈边界校验直接 abort。不是抛异常,是进程当场没了。所以我们也没法在 worker 里“小心点”凑合用。
于是宿主桥统一成一句话:谁都能往队列里塞,只有宿主 UI 线程能执行。Linux 用 g_idle_add 唤醒 GTK 线程,Windows 用 PostMessageW(WM_CJT_FLUSH) 唤醒窗口线程。配套结论写进了开发契约:worker 里不要绕过桥直接调 GTK / WebKit,只能经 jsSink 排队回投。
2. 能力校验留在调用线程,只把执行挪走
最常见的两类失败是“未授权”和“命令没注册”。这类错误必须即时返回、顺序确定,而且为了它白开一个线程、白排一次回投,不划算。
所以线程模型是两段式:校验同步、执行异步。实测这条路径确实更快——拒绝 350 µs vs 成功 390.5 µs,差 40 µs 左右,正好是 spawn + handler.handle + 组装 resolve 的钱。
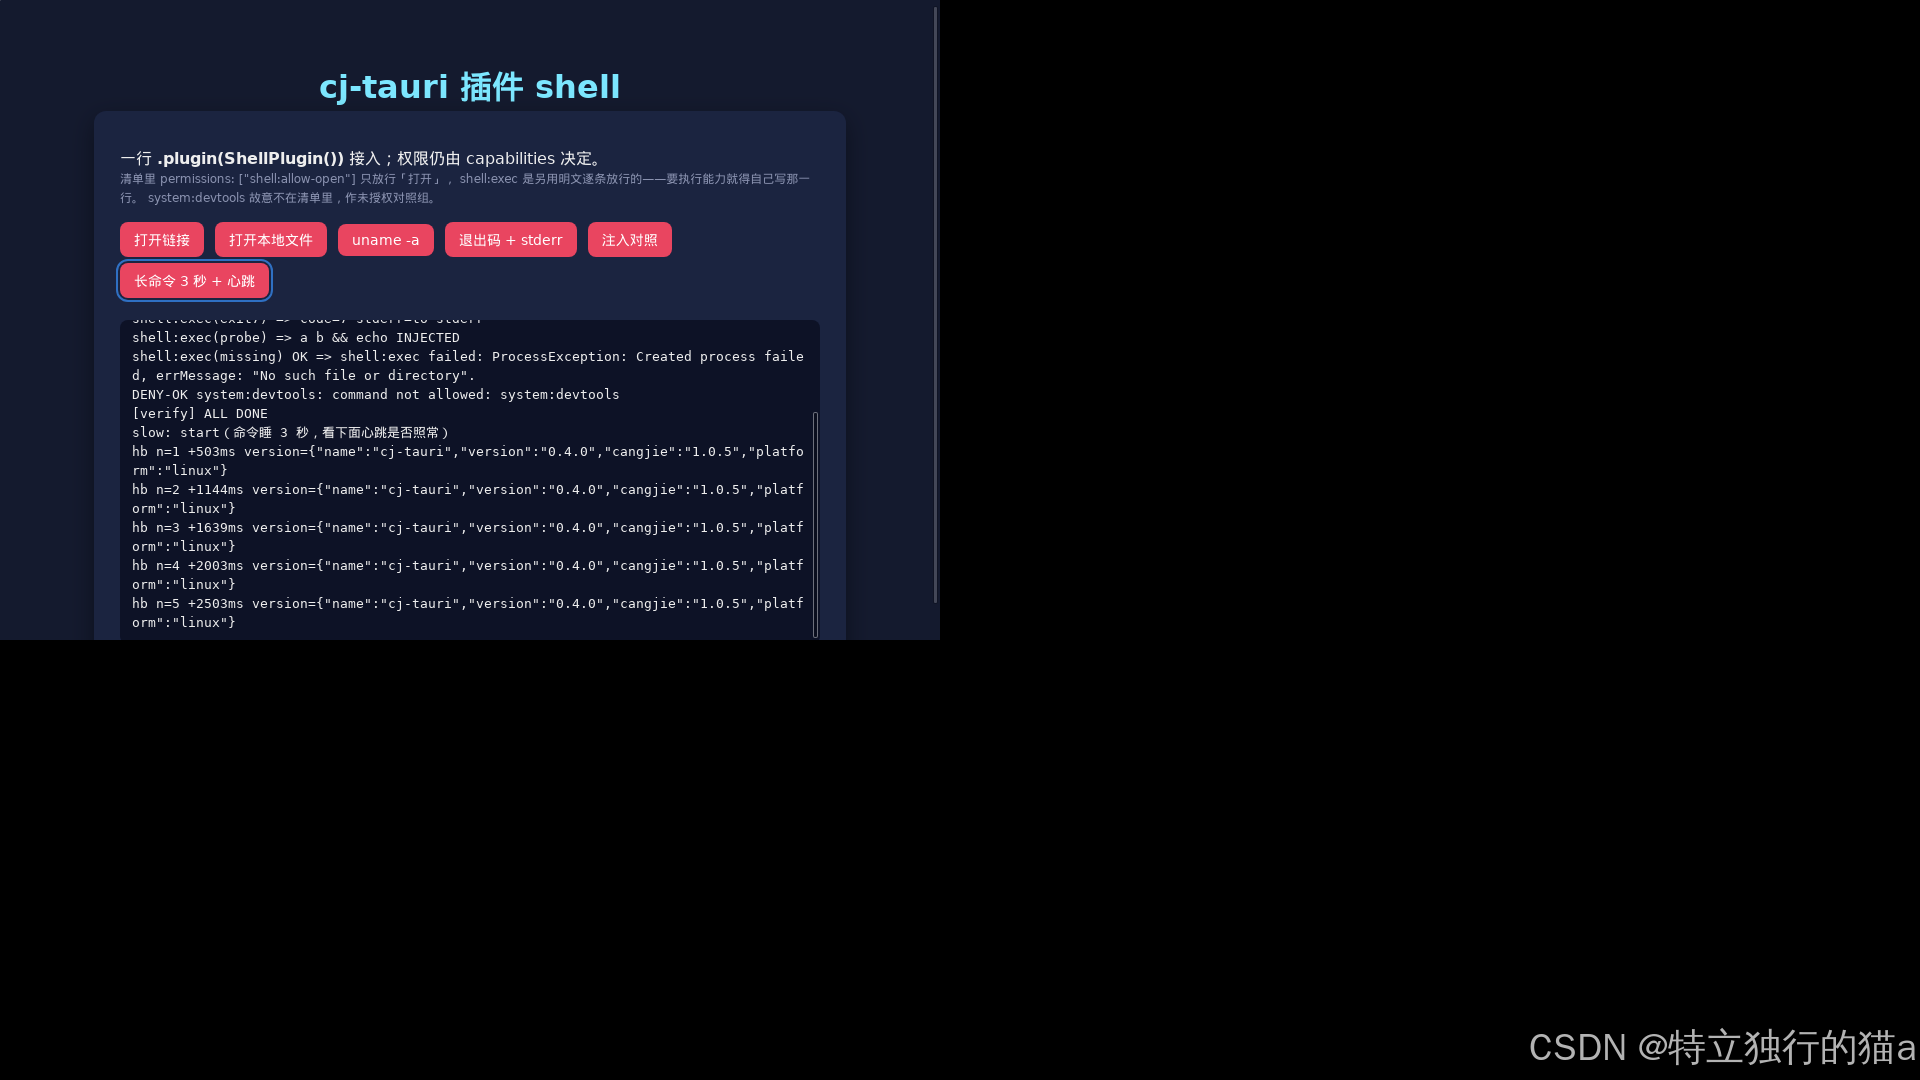
这件事我们做过一组正面对照:给示例加一条会睡 3 秒的命令,配一个每 500 ms 做一次完整 IPC 往返的心跳。同步臂里,命令执行期间整段静默(6 次心跳全堆在命令结束后的几十毫秒内);异步臂里,心跳按 503 / 1002 / 1503 / 2003 / 2503 ms 的节奏贯穿命令全程——界面没被钉住:
这里有个容易被误读的地方:同步拒绝快,不是因为“它省掉了 worker”,而是因为它根本不需要走。这也是我劝人别为了微优化把校验挪进 worker 的原因——省不下时间,还会把“同步拒绝、顺序确定”这个语义弄丢。顺序确定这件事看着不起眼,等你写测试或者排查“为什么这次被拒那次没被拒”的时候就知道值钱了。
3. 两个方向的 emit 不是同一个东西
仓颉 → JS 是 ipc.emit(event, payload),前端 listen 订阅。这条路很轻:没有 id 配对、没有 promise、没有 worker(发射方本来就在某个线程上),所以单位成本只有 0.02 ms/条(三轮 0.06 / 0.015 / 0.02),比往返低了整整一个量级。
JS → 仓颉 是前端 emit(),后端 app.listenEvent(name, handler) 订阅。它带 id、返 Promise,因为要多一次回投。多花这次回投买来一件事:事件未授权时,reject("event not allowed: …") 能回到调用方手里。在这之前,未授权的事件只在 stderr 里丢一行,前端那条 promise 永远等不到结果——是个很难查的“静默挂起”。
这里有个我们故意没对齐 Tauri 的地方:前端 emit() 只投给后端监听器,不回投给页面。
Tauri 的 emit 是广播给所有监听者,emit_to 才是定向投递。但 Tauri 是先有了多窗口,才需要区分“全局”和“定向”;我们现在只有 "main" 一个窗口,全局广播就退化成自己发自己收——这是 Tauri 用户真实踩过的坑,官方 issue 的结论是 won’t fix,所以不值得照搬。页面内部要广播,用原生 CustomEvent 就够了,那本来就是浏览器的本职工作。
七、0.39 毫秒拆开,钱花在哪
先看总账。Linux + WebKitGTK、2 vCPU 容器,一次 invoke 从页面发出到 promise 落地,平均 0.39 ms——2000 次往返总墙钟 781 ms,约 2561 ops/s。不等回地连发 500 条,吞吐能到 1.0 万 ops/s(三轮 9615 / 10000 / 10638,取中位)。
把一次往返按段落拆开逐段记账:
| # | 步骤 | 在哪 |
|---|---|---|
| 1 | JSON.stringify + postMessage | 页面 JS |
| 2 | 原生回调 → 仓颉回调 | C 桥(跨 FFI) |
| 3 | InvokeRequest.parse | 仓颉 |
| 4 | 能力校验 + 命令存在性校验 | 仓颉(调用线程) |
| 5 | spawn 一个 worker | 仓颉(每条命令一次线程创建) |
| 6 | handler.handle | worker |
| 7 | 拼 resolve 的 JSON | worker |
| 8 | 入队 + 唤醒 UI 线程 | C 桥 |
| 9 | run_javascript("__CJ_TAURI__._dispatch(<json>)") | 宿主 UI 线程 |
| 10 | _dispatch → promise → await 续体 | 页面 JS |
拿拒绝路径对一下就有结论了:拒绝只走 1–4 + 8–10,350 µs;成功要多走 5–7,390.5 µs。跟业务有关的 5–7 段合计约 40 µs,剩下约 350 µs 全是固定开销——JSON 编解码、两次跨语言边界、UI 线程里的一次 eval、promise 调度。
这个结论有点丧,但很有用:优化要冲着固定开销去,改业务代码没用。 你把手写的 handler 优化到极致,也就省那 40 µs 里的一部分;真正的大头在那 350 µs 的公共路径上,而那条路对每一次调用都在收钱。
八、改了回投路径,第二次差点把错误版本交出去
固定开销里最大的一块是回投(第 8–10 步)。这轮一共动了两处,第二处差点翻车。
第一处:回投从 window.postMessage 改成直派 _dispatch(json)。
原来的回投脚本是 window.postMessage(<json>, '*'),靠页面上的 message 监听器落地。改成直派之后,省掉一次结构化克隆和一次 message 事件派发;附带的好处更值钱:谁能向 window.postMessage 投递,谁就能伪造回包——这个投递面整个消掉了:监听器删了,可投递的目标就不存在了。实测页面自己投一条 window.postMessage({type:'event',…}),监听器被调用 0 次。
改的时候我还顺手写错过一句:注释里说这里能省一次 JSON.parse。这是错的,后来专门更正了——<json> 是被当作 JS 对象字面量嵌进 eval 的,页面拿到的本来就已经是对象,typeof msg === 'string' 那条分支压根不走。省的确实有,但不是 JSON 解析。这类“顺手写的注释”如果不核对,会一直骗后来的人。
第二处:回投批处理。 一次空闲回调把队列里最多 64 条响应拼成一段脚本,只 eval 一次,没取空就自续再排一次。
这里最值得说的是那个差点交付出去的错误版本:第一版只做了拼批,没做快路径,测出来顺序往返中位数 414.5 µs,比基线 386.5 µs 慢了 7%。原因很直白——最热的路上每次只有一条响应,却要白走一遍拼接和拷贝。补上“队列里只有一条就直接用原字符串”的快路径之后:
| 指标 | 改前 | 改后 |
|---|---|---|
| 管线化吞吐 | 6024 ops/s | 11905 ops/s(约 2.0×) |
| 事件推送 | 0.105 ms/条 | 0.04 ms/条(约 2.6×) |
| 顺序往返 | 386.5 µs | 390.5 µs(噪声内) |
| 1 MiB 回显 | 49.5 MB/s | 51.8 MB/s(噪声内) |
这张表的口径得说清楚:它是当时的 A/B 对照,同机、同一份应用二进制只换 C 桥,各 3 轮取中位——只有“只换一个变量”才能把这两处改动的收益单独摘出来。而 §七 开头那几个数字是后来(2026-10-02)对当前实现重跑三轮的中位:吞吐 9615 / 10000 / 10638 → 10000 ops/s,跟表里的 11905 同档,差异来自会话噪声;事件那一项同理,表里的 0.04 ms/条 是 A/B 当次的中位,重跑是 0.015–0.06、中位 0.02。
快路径上线之前还埋着一个更阴的 bug:Linux 侧的投递守卫被我写成了 n > 0,单条消息被静默丢掉。它不影响拼批的批量场景,只在“一次只有一条响应”时命中——也就是最寻常的那条路。日志里什么都看不出来,我是顺着顺序往返的时间不对才翻出来的。
这两个 bug 有个共同点:性能代码写错了不会报错,只会给你一个看起来合理的数字。 没有前后对照的基线,这两个都会被我当成“优化完成”交出去。
九、那为什么不用 WebSocket
这是这套 IPC 被问得最多的问题,提问的人通常已经准备好一组数字:localhost loopback 的往返比 0.39 ms 快得多。
先看数字,同机实测:
| 方式 | mean | p50 |
|---|---|---|
WebSocket ws://127.0.0.1 | 0.151 ms | 0.131 ms |
| 裸 TCP 回显 | 0.077 ms | 0.059 ms |
| cj-tauri invoke(成功 / 拒绝) | 0.39 / 0.35 ms | — |
但这组对照不是胜负判决,因为两条线根本不在同一个执行环境里。WS 那条跑在 Node 里——没有 webview,没有页面事件循环,没有跨语言回调;cj-tauri 这条跑在 webview 里,每次都要跨 JS ↔ C ↔ 仓颉三道边界,还要付 JSON 编解码和线程 spawn 的钱。
它真正的价值是给出一个量级参考:三者都在 0.1–0.5 ms 这一档。也就是说,这一档的耗时主要由“报文编解码 + 调度 + 跨边界调用”构成,跟有没有 socket 没关系。
概念上更清楚的说法是:两者不在同一层。WebSocket 是传输层,它假定两端可能隔着网络;而 cj-tauri 的 JS 和仓颉本来就在同一个进程里,中间只隔一层 webview 消息回调——这里根本没有“传输层”可换。
用 WebSocket 做 IPC,等于自己造一个传输层。它买到的是跨进程、跨机器、跨语言客户端;付出的是端口占用、握手开销、多一个常驻进程,以及“本机多了一个监听端口”这个额外暴露面。在单机同进程的场景里,这些付出换不到延迟上的收益。
代价那边的账也得说清楚:大 payload 我们确实不如二进制通道。1 MiB 回显 14.6 ms、约 68.5 MB/s(这项单轮波动大,三轮 45.2 / 70.9 / 68.5),瓶颈是 JSON 编解码加单线程 JS。要搬 MB 级数据,正确做法是回句柄或路径、让上层自己解析,而不是指望把 JSON 往返调快;再往上就是专门开一条二进制通道,Tauri v2 也是往这个方向补的。
那什么情况下 socket 反而合适?跨进程跨机器、要持续双向流(视频帧、传感器数据)、前后端生命周期不同(后端常驻、UI 可关可开),或者已经有一套现成的 HTTP / gRPC 服务端想直接复用。只要守住“同进程 + 命令式 API + 单机”这三条,webview 消息通道就是更省的选择:少一层传输、少一个进程、少一个端口,能力校验还能卡在唯一入口上。
这不是我给自己的架构找理由。Tauri v2 官方文档对自家 IPC 的描述是同构的:风格叫 Asynchronous Message Passing,底层是“JSON-RPC like protocol”,参数和返回值必须可 JSON 序列化;而且官方明确写了“报文传递比共享内存或直接函数调用更安全,因为接收方可以自由拒绝或丢弃请求”——和我们“能力校验不通过就在 hub 里同步拒绝”是同一个思路。WebView 宿主框架不用 socket 做 IPC,基本是共识。
十、事件连发会怎样:Tauri 怎么处理,我们做了什么
前面提过,仓颉 → JS 的事件(ipc.emit)单位成本只有 0.02 ms/条,比命令往返低一个量级。但便宜不等于免费,这条路的成本结构跟命令往返完全不同:管线本身很轻,贵的是页面侧——每一条事件最后都要在 UI 线程上跑一遍它自己的监听器。
于是就有了那个经典问题:后端一秒推 200 条进度事件会怎样?页面监听器里如果碰了 DOM,界面就开始卡;而这条路上我们既没有合并、也没有上限——事件全部堆在宿主 UI 线程的脚本队列里排队等执行。
先看 Tauri 是怎么做的
我去翻了 Tauri v2 的源码,因为它在这件事上的取舍很有参考价值。结论比想象的更“朴素”:Tauri 也不合并、不批处理、不设队列上限。 它的事件投递就是一次 self.eval(emit_js_script(...))(crates/tauri/src/webview/mod.rs:2230,脚本由 crates/tauri/src/event/mod.rs:194 现场拼出来)——一条事件一次 eval,监听器 id 在那一次 eval 里循环调用。
官方文档的立场写得很直白:事件不是为低延迟或高吞吐设计的,重活请走 Channel(专为流式数据准备)。社区里那几个“高频 emit 把应用打崩”“消费不及时内存一直涨”的 issue,维护者的回答也是同一句:在应用层自己限流。后来出现过一个第三方 crate tauri-queue,它才是把“限流、缓冲、丢弃策略、合并窗口”做成显式配置的那种方案。
也就是说,在这个问题上,Tauri 把选择权交给了应用层。我们决定照这个思路做,但把它做进框架里、且必须显式打开。
我们的做法:emitLatest
新增 ipc.emitLatest(event, payload),语义是:同一个刷屏窗口内的同名事件,只投最后一次的 payload——中间值丢掉,最后那一条一定送达。页面侧的监听器写法一个字都不用改,照样是 listen。
实现落在桥的 JS 里(native/bridge_js.h,两个平台共用同一份):事件到了先写进本帧的同名槽位,然后挂一个 requestAnimationFrame,窗口结束时把槽位里的值投出去;窗口不可见、rAF 不来的情况用 setTimeout(…, 50) 兜底。报文层面只是多一个 coalesce: true 字段,其余完全不变。
两个设计决定值得说明:
为什么不做成默认行为。 合并就意味着丢数据,而“静默丢数据”比“慢”难查得多。更麻烦的是回执:emit 的 promise 是要 settle 的,如果为了限流把某条 resolve 丢掉,request/response 契约就破了。所以默认的 emit 一个字没改——不合并、不丢回执、队列也仍然不设上限;想要合并语义,你显式调 emitLatest。
为什么落在桥 JS 而不是 C 桥的队列上。 我一开始的想法是在 C 桥队列里按 key 去重,那样能顺带少排几个队列节点。但算了一下账:管线上每条事件只花 0.02 ms,真正的开销在监听器和 DOM 上——那部分只有 JS 侧能省,C 桥省不掉。而改 C 桥要引入 per-key 表,还要多出一条“Windows 上没验证过”的路径;改 bridge_js.h 则是两个平台同时生效(单源)。收益在 JS 侧、成本在 C 侧的方案,不值得做。
实测:50 条同名事件
探针 examples/ipc-coalesce 干的事很直白:页面挂一个 progress 监听器,后端连发 50 条同名事件(一连串事件会落进同一个空闲回调窗口),两种走法各来一轮,结论由页面回传给后端 stderr:
| 走法 | 发出 | 监听器命中 | 收到的最后一个值 |
|---|---|---|---|
emitLatest | 50 | 1 | 50 |
emit(默认,对照) | 50 | 50 | 50 |
emitLatest(单条) | 1 | 1 | 1 |
桥侧 run js failed 计数 0。
有个细节我必须写出来,因为它影响你怎么写断言:命中次数等于这串事件落进了几个刷屏窗口。我连跑 4 次,3 次命中 1 次、1 次命中 2 次——不是 bug,而是合并的边界本来就是“一个窗口”,而 50 条事件分几个窗口送达取决于分发节奏。所以验证时断言的是“命中次数远小于 50 + 最后一个值必达”,而不是“恰好命中一次”。任何把 hits == 1 写死的测试都会偶发翻车,我就差点这么写。
十一、还没修的、没验证的
按诚实程度排:
读不出 id 的非法报文仍然没有回包。 解析失败时会先尽量把 id 捞出来,捞到就回一条 ok:false,前端那条 promise 立刻落地——探针里页面投一条 {"type":"wat","id":9001},能收到 {"type":"resolve","id":9001,"ok":false,"error":"invalid IPC message"}。但捞不出 id 的(压根不是 JSON、或者缺 id)只能打 stderr:没有 id 就对应不上任何 promise,回包也没地方落地。这类情况前端得自己加超时兜底,框架帮不上忙。
没有超时、取消和丢包策略。 命令发出去就只能等;事件连发的背压也只做了上面那一半(显式合并)。
UI 线程是稀缺资源。 单条 MB 级 payload 或高频事件会直接卡住界面。这不是设计缺陷,是“回投必须在 UI 线程执行”这条物理约束的必然结果。
同一命令不保序。 前面说过,是有意为之。需要顺序就在业务层排队。
有几条是本轮才补上的观测能力,都属于“不出事就永远发现不了”的那类,顺手记一下:Linux 侧入站原先没有逐条日志(Windows 一直有 js -> native (N bytes)),排查时对不上数;Linux 回投原先不接执行结果,eval 失败只会静默丢掉这条回投、前端 promise 永久挂起,现在挂上了 on_js_done 打 run js failed: …(把页面 _dispatch 换成必抛实现验证过,宿主日志里确实出现了 run js failed: about:blank:31:78: Error: probe-boom);还有上面说的伪造回投面,已经随直派一起消失。
最后把没做的部分列清楚,省得有人拿这篇当验收报告:
- Windows 只做了编译校验。 本机是 Linux,没有 WebView2 头文件,协议同构但没实机跑。
emitLatest这次改动落在两平台单源的bridge_js.h,报文与仓颉侧完全共用,所以我认为风险可控——但“我认为”不等于“跑过”,Windows 用户实测出问题请务必提 issue。 - “让 socket 客户端也跑在同一个 webview 里”这个严格对照实验没做。 上面那组 WS / TCP 数字只是量级参考,不是同条件赛跑。
- 性能数字来自 Xvfb(无显示器)环境,三轮中位,不能直接外推到有真实 GPU 和合成分辨率的桌面。
十二、总结
写这套 IPC 最大的收获不是那几个数字,而是几条被现实按住头教会的经验:
先量,再改,改完再量,而且必须同一台机器、同一份二进制。 中间态那 7% 的回退和静默丢单条消息的守卫 bug,只有对照基线才看得见。没有基线,性能代码错了不会报错,只会给你一个看起来合理的数字。
分清固定开销和业务开销,优化要对准大头。 一次往返 390 µs,业务只占 40 µs,剩下全是编解码、跨边界、调度。这意味着框架层面的优化收益远大于应用层面的微调;也意味着不要为了省几微秒把能力校验挪进 worker——那反而会把“同步拒绝、顺序确定”这个更有价值的东西弄丢。
默认路径不要静默丢数据。 合并、限流、丢包这类策略要么不做,要么做成显式开关,并且绝不碰回执。用户能接受“我显式调用了合并所以中间值丢了”,接受不了“我的事件不知道去哪了”。
平台差异收敛到两处。 仓颉侧 @When + C 桥 bridge_*.c,协议和业务代码全平台一份。这条规矩让“新加一个能力”变成改三个地方就能收工的事,也让跨平台行为差异不会悄悄长在业务代码里。
最后,数字能被别人复现才有意义。 所以探针全部随仓库发布,examples/ipc-bench 量性能,examples/ipc-coalesce 判语义,命令在下一节。哪台机器跑出来的数跟我差得多,欢迎带着日志来对。
项目本身是 MIT 协议的开源项目,代码在 AtomGit(https://atomgit.com/qq8864/cj-tauri)和 GitHub 镜像(https://github.com/yangyongzhen/cj-tauri)。仓颉生态还很年轻,桌面/混合开发这块基本是空地,如果你也在琢磨类似的事,或者只是想试试用仓颉写个带界面的小工具——欢迎来提 issue 和 PR,也欢迎直接抄这套 IPC 的思路。
十三、复现
探针随仓库发布,不用另建工程:
# 0) Linux 上先构建 C 桥
bash native/build_linux.sh

# 1) 性能:顺序往返、管线化吞吐、事件推送、1 MiB 回显
cd examples/ipc-bench && cjpm build
xvfb-run -a ./target/release/bin/main 2>&1 | grep BENCH

# 2) 语义:emitLatest 与 emit 的对照(命中次数、尾值)
cd examples/ipc-coalesce && cjpm build
xvfb-run -a ./target/release/bin/main 2>&1 | grep '\[probe\]'

# 3) 同机对照:localhost WebSocket vs 裸 TCP
node scripts/bench-ws-vs-tcp.js
(本文性能数字是 2026-10-02 三轮运行的中位,原始日志在 /tmp/ipc-bench-round{1,2,3}.log,合并语义的日志在 /tmp/probe-coalesce-run.log。单轮波动有多大,看 1 MiB 回显那一项就知道——三轮 45.2 / 70.9 / 68.5 MB/s。)
两个前置条件,不满足会浪费你半小时:工作目录必须是工程根(capabilities/ 和页面资源都按相对路径读);Linux 上要么用 cjpm run、要么自己补 LD_LIBRARY_PATH——直接跑二进制会因为找不到 libstdx.encoding.json.so 静默退出,没有报错、没有输出。
改协议之前,建议先读这四个文件头的注释:src/ipc_message.cj(协议权威描述)、src/ipc_hub.cj(分发与校验)、native/bridge_js.h 加两个 bridge_*.c(前端桥与回投队列)、src/app.cj(装配与 jsSink 接线)。

一站式 AI 云服务平台
更多推荐
 2
 0
- 0


 已为社区贡献6条内容

所有评论(0)