
面试官追问:setData调度为什么用setTimeout而不是微任务?
说明:本文是「小程序双路线源码拆解」系列的单点深挖篇。分析对象为「跨端框架 A」(一套代码编译到多端的框架)的运行时增量更新调度器,出于合规考虑,文中不出现任何真实类名、文件名与包名,一律使用「更新调度器」「根容器节点」等语义化代称;所有代码均为基于源码设计思路重写的简化伪代码,与真实源码存在差异,仅用于说明设计思想。
引言:一道八成人答到一半就卡住的面试题
小程序跨端框架的面试里,有一个问题出现的频率极高:
“你的框架 setData 频率是怎么控制的?”
大多数人能答上来:"做合并,把一轮的多次变更攒成一次 setData。"答到这儿,面试官会不动声色地补一刀:
“合并我懂。那为什么攒这一轮用的是 setTimeout,而不是 Promise.then?”
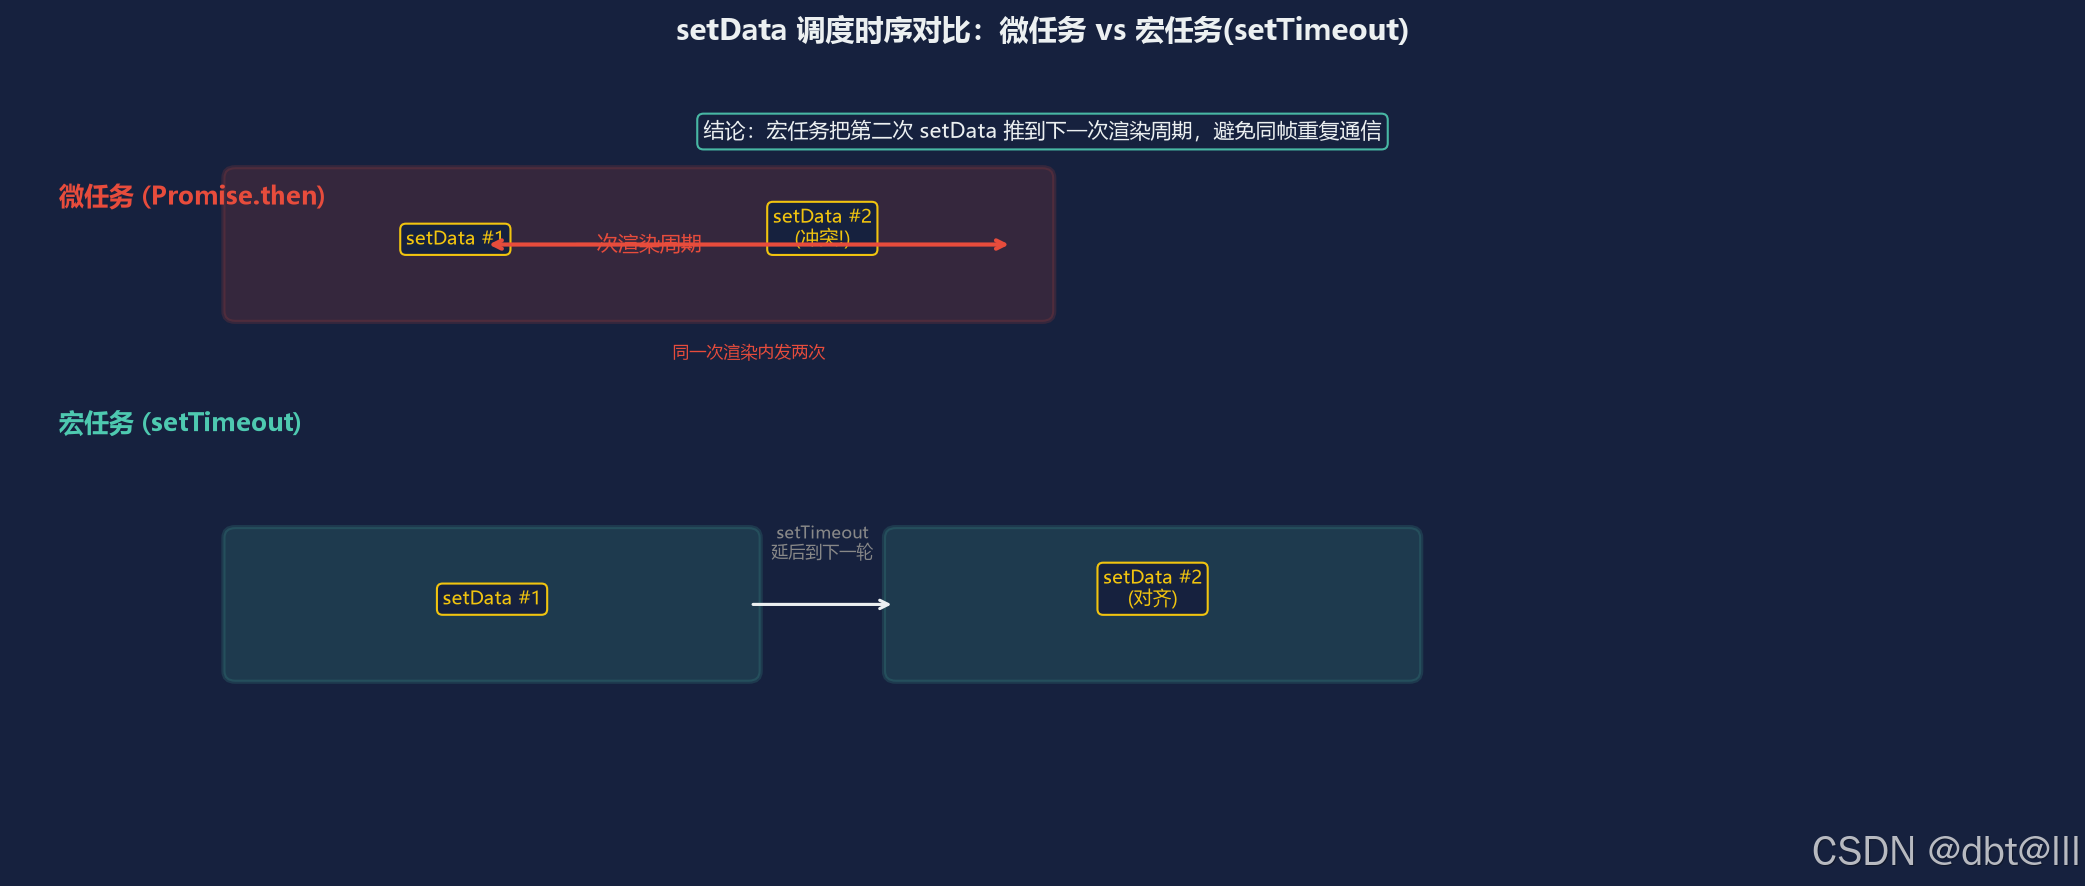
然后就是漫长的沉默。有人猜"微任务太先进小程序不支持",有人说"setTimeout 性能好"——都不对。真实的答案写在跨端框架 A 的源码注释里:小程序一次渲染流程内可能连续触发更新,微任务会在同一次渲染里发两次 setData,宏任务才能对齐渲染节奏。
这一句注释背后,是整套调度器的三个设计决策:路径去重、负载批量合并、宏任务对齐渲染节奏。本文把跨端框架 A 的增量 setData 调度器从树上拆下来,单点拆透:路径怎么算、更新怎么合并、为什么必须是宏任务,以及两个容易被忽略的配套设计——中间插入的位置启发式和树序列化压缩。
读完你应该能拿到三样东西:
- 一套能应对追问到第三层的"setData 调度"面试话术;
- 一个可以迁移到任何"高频小更新"场景的调度三件套;
- 若干源码注释级别的冷知识——比如 nextTick 是用 20ms 间隔轮询 pendingUpdate 实现的。
一、路径式更新:给每个节点发一张"门牌号"
1.1 调度器的地基:节点路径
跨端框架 A 的运行时在小程序逻辑层自建了一棵虚拟节点树。每个虚拟节点插入树的那一刻,运行时都会为它计算一个路径:
// 简化伪代码:节点插入时计算路径
function insertNode(parent, node, index) {
  node._path = parent._path + '.cn.' + index
  // 'cn' 是 children 数组的缩写键名(序列化压缩的一部分,见第四章)
  parent.children.splice(index, 0, node)
}
父节点路径 + '.cn.' + 下标——就这么一条朴素规则,是整个增量更新体系的根。因为有了这张"门牌号",树上任意一个节点的变更都能被翻译成一个精确的更新路径:
// 简化伪代码:只 setData 变化的分支
// 假设第 3 个子节点的第 0 个孙节点的样式变了
updateScheduler.enqueue({
  'root.cn.3.cn.0.st': 'color:red;'
})
// 渲染层只重绘这一个分支,而不是整棵树
对比一下没有路径的方案:页面 data 是一棵大树,任何节点变了都得把整棵树 setData 一遍——树越大,每次通信的负载越大,渲染层 diff 的范围也越大。路径式更新把通信粒度从"整棵树"压到"单个分支",这是跨端框架在"逻辑层与渲染层分离"这个物理约束下能做的最关键的优化。
要注意的是,这套机制的有效性依赖一个隐含前提:虚拟树在两次更新之间的结构是稳定的。一旦中间插入、删除节点,后面所有兄弟节点的下标都会变,路径就会集体失效——这正是后面位置启发式要解决的问题,先按下不表。
1.2 根容器节点:更新的收发室
树的根是一个特殊的根容器节点,它承担"更新调度"职责——所有虚拟节点的变更最终都会汇总到这里,由它决定什么时候、以什么粒度、发几次 setData。
// 简化伪代码:根容器节点的调度骨架
class RootContainer {
  constructor(pageInstance) {
    this.page = pageInstance
    this.pendingUpdates = []   // 待发送的更新负载队列
    this.scheduled = false     // 是否已排队宏任务
  }

  // 任意节点变更最终走到这里
  enqueue(updatePayload) {
    this.pendingUpdates.push(updatePayload)
    if (!this.scheduled) {
      this.scheduled = true
      setTimeout(() => this.flush())   // 宏任务调度,见第三章
    }
  }

  flush() {
    const merged = this.mergeAndDedupe(this.pendingUpdates)
    this.pendingUpdates = []
    this.scheduled = false
    if (Object.keys(merged).length) {
      this.page.setData(merged)   // 一次通信,发合并后的负载
    }
  }
}
这段不到三十行的骨架里,藏着本篇的三个主角:pendingUpdates 负载队列(批量合并)、mergeAndDedupe(路径去重)、setTimeout(宏任务对齐渲染节奏)。下面三章逐个拆。
1.3 面试话术小结
一句话版:
“框架给每个虚拟节点在插入时计算路径——父路径拼下标,任意节点变更都能翻译成精确更新路径,只 setData 变化的分支;所有变更汇总到根容器节点,由它做批量合并和调度。”
深入版:
“增量 setData 的地基是节点路径:插入树时按’父路径 + .cn. + 下标’计算,渲染层拿到的是形如 root.cn.3.cn.0.st 的精确键。通信粒度从整棵树压到分支级,代价是依赖树结构的稳定性——结构一变下标就失效,所以框架还需要配套的插入策略和整组重置兜底。调度职责收敛在根容器节点:负载队列 + 合并去重 + 宏任务触发,三件事在下文逐一展开。”
二、合并之前先去重:路径覆盖的家族关系
2.1 一个真实的坑:同一批更新里,父亲和孩子都在
批量合并听起来简单:把队列里的负载合并成一个对象就完了。但有一个真实的坑——同一轮更新里,可能既有"父数组整体重置",又有"其子项的单独更新"。
什么场景会出现?最典型的是列表重排:框架 diff 出"第 3 个子节点的子数组整体变了",同时第 3 个子节点内部的某个孙节点样式也变了。于是队列里出现两条更新:
// 简化伪代码:一轮更新队列里的"祖孙同框"
[
  { 'root.cn.3.cn': [ /* 子数组整体重置 */ ] },
  { 'root.cn.3.cn.0.st': 'color:red;' }
]
如果照单全收、直接合并进一个对象,setData 会带上两个键。渲染层处理时,长路径 root.cn.3.cn.0.st 会被短路径 root.cn.3.cn 的重置整体覆盖——也就是说,孙节点的样式更新是白发的,它写进去的值随子数组重置一起到达,谁后到谁说了算,结果取决于渲染层的处理顺序。同一份数据在一次通信里被赋予了两次语义,这就是不确定性。
2.2 解法:路径去重——删掉子路径,用一次大更新覆盖
框架的做法简单直接:flush 时做一次路径去重——如果一个更新路径是另一个更新路径的前缀(即祖先关系),就删掉更深的那个子路径,用祖先的那次大更新覆盖。
// 简化伪代码:flush 时的路径去重
mergeAndDedupe(updates) {
  const result = {}
  // 按路径从短到长排序,祖先路径先落
  const sorted = updates
    .flatMap(u => Object.entries(u))
    .sort((a, b) => a[0].length - b[0].length)

  for (const [path, value] of sorted) {
    const covered = sorted.some(([p2]) =>
      path !== p2 && isPrefixPath(p2, path)   // p2 是 path 的祖先
    )
    if (!covered) {
      result[path] = value    // 子路径被祖先覆盖,丢弃
    }
  }
  return result
}

// 'root.cn.3' 是 'root.cn.3.cn.0.st' 的祖先
function isPrefixPath(shortPath, longPath) {
  return longPath.startsWith(shortPath + '.')
}
去重之后,上面那批更新只剩一条:root.cn.3.cn 的整体重置。子项更新不再单独发送,它的最终状态已经包含在祖先那次大更新里了(重置的数组内容本来就是 diff 后的新值)。一次通信、每个数据只发一遍、语义唯一——三个目标一次达成。
这个细节的面试价值在于:"合并"不是把对象 concat 起来就完了,合之前要先解决更新之间的覆盖关系。很多自研调度器就是死在这一步——不去重,偶现"样式闪一下又回去"的幽灵 bug,很难排查。
2.3 面试话术小结
一句话版:
“批量合并在框架里只是第二层,第一层是路径去重:同一轮更新里如果既有父数组整体重置、又有其子项更新,就删掉子路径,用一次大更新覆盖,保证同一数据只发一遍、语义唯一。”
深入版:
“合并前先做祖先-后代路径判定:短路径是长路径的前缀时,后代更新必然被祖先重置覆盖,直接丢弃。排序后前缀判定即可完成,复杂度可接受。不做去重的后果不是性能问题而是正确性问题——同一数据在一次 setData 里带两次语义,渲染层按到达顺序处理,偶现状态闪烁类幽灵 bug。这是’合并’这个词背后最容易被忽略的一步。”
三、主菜:为什么是 setTimeout,而不是微任务
3.1 先把题面摆正:这道题在问什么
“为什么用 setTimeout 不用微任务”,首先要排除两个错误答案:
- 不是因为"小程序不支持微任务"——小程序逻辑层是标准 JS 环境,Promise 完全可用;
- 不是因为"setTimeout 性能更好"——单看调度开销,微任务反而更便宜,不用等一整个任务周期。
真正的原因是时序:两种异步方式被安排进事件循环的位置不同,而这个位置恰好决定了"一轮渲染流程内 setData 被发几次"。
3.2 源码注释里的关键事实
框架 A 的更新调度器源码里有一段明确注释,大意是:小程序一次渲染流程内可能连续触发更新,用微任务调度会在同一次渲染里发两次 setData,宏任务才能对齐渲染节奏。
把这段话翻译成时序图。小程序的渲染流程是"通信 → 渲染层处理 → 回调/事件",在这个过程中逻辑层可能被多次唤醒(比如 onReady 回调和用户事件几乎同时到达):
时序对比:同一批变更,两种调度方式的命运

── 宏任务方式(setTimeout)────────────────────
  [任务A] 变更1 ──► 入队,setTimeout(flush)
  [微任务] (空)
  [任务B] 变更2 ──► 入队(scheduled 已置位,不重复排队)
  [宏任务] flush ──► setData 一次发送 {变更1+变更2}
  ─────────► 渲染层只收到一次通信 ◄─────────

── 微任务方式(Promise.then)──────────────────
  [任务A] 变更1 ──► 入队,queueMicrotask(flush)
  [微任务] flush ──► setData 发送 {变更1}   ← 第一次
  [任务B] 变更2 ──► 入队,queueMicrotask(flush)
  [微任务] flush ──► setData 发送 {变更2}   ← 第二次!
  ─────────► 同一次渲染前,渲染层收到两次通信 ◄──
两种方式的差异一目了然:
- 微任务在"当前任务"结束前就 flush——它攒不到下一个任务里的变更,于是每个任务结束时都发一次 setData。一次渲染流程横跨多个任务时,渲染层就被灌了多次通信;
- setTimeout 是宏任务,它被排到当前任务(以及本轮微任务)全部结束之后。凡是发生在同一轮事件循环里的变更,都会在队列里等它一起走。flush 的时机天然对齐了"渲染节奏"的边界。
3.3 换个角度理解:flush 要对齐的到底是"谁"的节奏
微任务的本质是"当前任务的收尾钩子",它解决的问题是把工作提前到本轮做完——追求的是低延迟。而 setData 调度器要的恰恰相反:它要攒,要把一段渲染流程内的所有变更凑成整批再发——追求的是低频率。两者的目标根本是冲突的。
用一个更精确的表述:flush 的理想时机是"本次渲染流程与下次通信之间的静默点"。微任务的位置在任务内部,永远到不了这个静默点;宏任务的位置在任务边界之外,恰好是渲染层"正在消化上一次数据"的时候——这会儿发给它新的合并负载,它消化完顺手处理,一拍即合。
所以"为什么不用 Promise.then"的标准答案可以分成三层递进:
- 现象层:微任务会在同一次渲染流程里发两次 setData,通信次数没有真正降下来;
- 机制层:微任务在当前任务结束前执行,攒不到后续任务的变更;宏任务在任务边界外执行,天然把一轮循环内的变更收拢成一批;
- 目标层:setData 调度的目标是低频率而不是低延迟,"攒"是目的本身,任何"提前执行"的机制都与目标背道而驰。
3.4 一个容易漏讲的配套问题:延迟怎么办
宏任务调度把发送时机推后了,那依赖更新结果的逻辑(比如"更新后拿节点尺寸")怎么办?框架提供了 nextTick API,而它的实现方式很有意思——不是简单的 setTimeout(0),而是分三种场景轮询 pendingUpdate:
// 简化伪代码:nextTick 的轮询式实现
function nextTick(callback) {
  const startTime = Date.now()
  const timer = setInterval(() => {
    if (!updateScheduler.pending || Date.now() - startTime > 100) {
      clearInterval(timer)
      callback()   // pending 清空或超时 100ms,执行回调
    }
  }, 20)           // 每 20ms 检查一次
  return timer
}
三个数字讲三件事:20ms 是轮询间隔——足够细又不至于空转;100ms 是超时兜底——防止调度器异常导致回调永远不执行;轮询 pendingUpdate 则保证回调一定在"这轮更新真正发完"之后才触发,而不是在一个拍脑袋的固定延迟之后。Web 端另有捷径:直接用组件的就绪回调,无需轮询。
为什么不用"flush 完成后 resolve 一个 Promise"的优雅写法?因为轮询实现不依赖调度器暴露任何内部状态变更钩子,消费方和调度器保持松耦合——这个"丑但稳"的选择本身就是工程判断力。
3.5 面试话术小结
一句话版:
“用 setTimeout 不是因为兼容性,而是因为时序:小程序一次渲染流程内可能连续触发更新,微任务在每个任务结束前就 flush,会在同一次渲染里发两次 setData;宏任务排在任务边界外,把一轮内的变更攒成一批,天然对齐渲染节奏。”
深入版:
“微任务的本质是当前任务的收尾钩子,目标是低延迟;setData 调度的目标是低频率,攒本身就是要追求的东西,两者方向相反。flush 的理想时机是渲染流程的静默点,微任务的位置永远在任务内部到不了,宏任务恰好落在边界外。配套的 nextTick 也不简单:三种场景下轮询 pendingUpdate,20ms 间隔 + 100ms 超时兜底,宁可丑一点也不耦合调度器内部——flush 时机和回调时机的可靠性都是设计出来的。”
四、路径失效了怎么办:中间插入的位置启发式
4.1 下标漂移:路径方案的阿喀琉斯之踵
回顾第一章:路径 = 父路径拼下标。那么往一个已有 5 个子节点的容器里,在第 2 个位置插入一个新节点会发生什么?
第 2、3、4 个原节点的下标集体 +1,它们的路径全部失效。此时调度器站在一个岔路口:
- 方案一:逐个修正路径。 插入 1 个节点,更新 3 个节点的路径——插入靠前时修正成本随列表长度线性增长;
- 方案二:整组更新。 把这批兄弟节点整个重置一次(一次大更新),新路径随重置一起重建。
4.2 源码的选择:按插入位置分流
框架 A 的做法是一个位置启发式:插入位置在数组两端时走单节点更新,插在中间时可能选择整组更新。源码注释解释了成本考量:平台解析长路径本身是有成本的——路径越长,渲染层定位到目标分支的解析开销越大,中间插入引发的路径级联修正会让大量长路径更新同时发生。
// 简化伪代码:插入更新的位置启发式
function handleInsert(parent, index, newNode) {
  const len = parent.children.length
  if (index === 0 || index === len - 1) {
    // 两端插入:其余兄弟下标不变,只更新新节点
    enqueueUpdate({
      [`${parent._path}.cn.${index}`]: serializeNode(newNode)
    })
  } else {
    // 中间插入:下标漂移,宁可整组重置
    // 长路径的级联修正成本 + 平台解析长路径的成本
    // 往往高于一次数组重置
    enqueueUpdate({
      [`${parent._path}.cn`]: serializeChildren(parent)
    })
  }
}
这个决策的本质是一笔账:“一次通信发多大的数据” vs “多少次长路径解析”。两端插入时只动一个下标,精确路径稳赚;中间插入时路径修正量随位置前移线性增长,而整组重置的成本是固定的(数组本身不大)——启发式选的是期望成本更低的分支。
这也是路径式更新方案的完整画像:它不是无条件的"永远精确",而是**“精确优先,结构不稳时退化为整组”**的自适应策略。面试里能讲出这一层,说明你真的读过源码而不是背了篇博客。
4.3 同一根杠杆的另一端:树序列化压缩
上面所有的优化都在压"次数",但每次通信的"体积"同样可以压。框架 A 对虚拟树的序列化做了三层压缩:
- 节点名精简:序列化产物里的节点名用最短的标识表示,模板里据此渲染对应组件;
- 组件名数字编码:组件在序列化时被编码为数字索引,通过一张映射表还原——数字比字符串短得多;
- 键名缩写:属性键统一缩写(第一章见过的
cn就是 children 的缩写)。
// 简化伪代码:序列化前后的体积对比(示意)
serialize前:{ "type": "view", "children": [...], "style": "..." }
serialize后:{ "t": 7, "cn": [...], "st": "..." }   // 体积约省一半
这三层压缩直接作用在每一次 setData 的负载体积上。注意它和调度优化是同一根杠杆的两端:调度器在压通信次数,序列化在压单次体积——两端同时发力,才能把"逻辑层到渲染层"这条最贵的通道的代价压到最低。而且这套压缩完全藏在运行时内部,对上层 API 零感知,是典型的"内部表示与外部接口分离"。
4.4 面试话术小结
一句话版:
“路径式更新在结构变化时会失效:两端插入走单节点精确更新,中间插入因为下标漂移可能直接整组重置——源码注释说这是权衡平台解析长路径的成本。另外树序列化做了节点名精简、组件名数字编码、键名缩写三层压缩,压的是单次通信体积。”
深入版:
“位置启发式的本质是一笔账:中间插入的路径级联修正量随位置线性增长,叠加平台解析长路径的成本,往往高于一次固定成本的数组重置,所以框架选择期望成本更低的分支。完整的路径方案画像是’精确优先、结构不稳时退化整组’的自适应策略。序列化压缩与调度是同一杠杆两端——一个压次数一个压体积,组件名编码为数字、键名缩写、节点名精简,全部对上层透明。”
五、调度器的隐形前提:全局单例与时序约定
5.1 一个 25 行的全局单例
讲完调度本身,还有一个容易被忽略的配套设计:框架 A 维护了一个极简的全局单例对象,持有当前上下文:
// 简化伪代码:全局单例(全部内容就这么多)
const Current = {
  app: null,      // 当前应用实例
  router: null,   // 当前路由器
  page: null      // 当前页面实例
}
配合对外暴露的 getCurrentInstance() API,任意位置的代码都能拿到"我当前在哪个页面里"。这个设计简单到近乎朴素——没有作用域链、没有上下文栈、没有 keyed registry。
5.2 朴素背后的时序前提
但它成立依赖一个前提:同一时刻只有一个页面在渲染。页面切换时,单例的三个字段被整体替换成新页面的上下文。
这个前提和调度器是什么关系?紧密相关。回顾第二章:所有更新汇聚到根容器节点,由它统一合并去重、统一对齐渲染节奏——这套"单收发室"模型能工作,正是因为收发室服务的是一个确定的对象。如果两个页面同时渲染、同时入队,合并器就必须区分"这批变更属于哪个页面",去重逻辑、调度时序都会复杂一个量级。全局单例用"同时只有一个活跃消费者"的时序约定,把这个复杂度直接裁掉了。
代价是什么?任何打破这个约定的场景都会出问题:比如多个页面的更新回调交错执行时,单例里的 page 指向谁,依赖于执行顺序而不是显式传参——这是隐式全局状态的经典风险。框架用"平台保证页面渲染串行"把风险锁在边界内,属于用平台约定换实现简单度的取舍。
面试里这段可以这么讲:全局单例不是偷懒,是和"单一渲染队列"模型配套的架构选择;前提是平台时序约定,边界是任何并行渲染场景。
5.3 面试话术小结
一句话版:
“框架维护一个只有 app、router、page 三个字段的全局单例,配 getCurrentInstance 取上下文,成立前提是同一时刻只有一个页面在渲染——这和’单一更新收发室’的调度模型是配套设计。”
深入版:
“单例的朴素是刻意的:如果多页面并行渲染,合并器要区分每批变更归属,去重和调度复杂度都要涨一个量级。用’平台保证页面渲染串行’的时序约定裁掉这个维度,换来 25 行实现。风险也来自同一处——任何打破串行约定的场景(多页面回调交错)都依赖执行顺序而非显式传参,是隐式全局状态的经典代价。评估这类设计要看约定边界是否真的被平台兜住。”
六、把调度器拼回整体:一次完整的更新之旅
最后把五个部分串成一条完整链路,方便建立整体图景。假设业务代码改了列表第 4 项的文案:
业务层 setState / 响应式触发
        │
        ▼
虚拟树 diff ──► 定位变更节点,生成精确路径更新
        │          'root.cn.4.cn.0.txt': '新文案'
        ▼
根容器节点 enqueue ──► 负载入队
        │               若结构有中间插入 → 触发位置启发式
        │               (单节点更新 or 整组重置)
        ▼
调度:scheduled 未置位 → setTimeout(flush)   ← 宏任务,对齐渲染节奏
        │
        ▼  (本轮事件循环内后续变更继续入队)
        │
flush:路径去重(祖先覆盖后代)
        + 批量合并为单一对象
        + 序列化压缩(键名缩写/数字编码)
        │
        ▼
page.setData(合并负载)  ──► 渲染层一次通信完成渲染
        │
        ▼
依赖更新结果的逻辑 → nextTick 轮询 pendingUpdate
                     (20ms 间隔 / 100ms 超时 / Web 端就绪回调)
这条链路上,五个设计各守一关:
| 环节 | 设计 | 守住的东西 |
|---|---|---|
| 变更定位 | 节点路径(父路径 + 下标) | 通信粒度:分支级 |
| 结构变化 | 插入位置启发式 | 路径有效性:不稳时整组重置 |
| 入队 | 负载队列批量合并 | 通信次数:一轮一批 |
| 合并 | 祖先-后代路径去重 | 语义唯一:每份数据只发一遍 |
| 时机 | setTimeout 宏任务 | 节奏对齐:一次渲染一次通信 |
| 体积 | 序列化三层压缩 | 单次负载:键名缩写 + 数字编码 |
其中"时机"一行,就是面试官那句追问的答案所在。
七、可迁移结论:高频小更新的通用三件套
这篇拆解的价值不止于小程序。任何"高频小更新 + 单一消费通道"的场景——Canvas/图表重绘、DOM 批量更新、埋点上报、状态同步、消息推送聚合——都能复用同一套三件套:
- 批量:把一段节奏内的多次更新攒成一个负载,一次发送。关键是先定义清楚"一段节奏"的边界(一个任务、一帧、一个渲染流程),而不是机械地加队列;
- 去重:合并前先解决更新之间的覆盖关系(祖先路径覆盖后代、后写覆盖先写、整体重置覆盖局部),保证每份数据语义唯一。这一步决定合并的正确性,比合并本身更容易被漏掉;
- 对齐消费端节奏:flush 的时机跟着消费端的消化节奏走,而不是跟着生产端的产生节奏走。生产端密集时尤其要警惕"微任务式"的提前 flush——它攒不住下一个任务里的更新,等于没攒。至于选择什么异步原语,取决于"节奏边界"落在事件循环的哪个位置:边界在任务之间用宏任务,边界在同步段之间才用微任务——先定边界,再选工具。
再加上两个加分项:位置启发式(精确更新与整体重置按期望成本自适应切换)和负载压缩(内部表示与外部接口分离),就是一套完整的高频更新治理方案。
收尾:这个调度器还剩什么可拆的
这篇文章拆的是"更新怎么发"。但调度器周边还有几个值得单拆的点,留给系列后续:
- 局部更新容器:当页面级 setData 仍不够细时,框架如何把通信范围再缩到组件级,以及查找结果缓存;
- 首屏保障:页面 onReady 之前首屏数据必须送达,否则"页面 ready 了但内容是空的"——框架用什么样的 Promise 时序机制兜底;
- 双渲染引擎兼容:同一平台两套渲染引擎的 CSS 子集差异,编译期补丁怎么做降级展开。
其中第一个问题和本文直接相连:路径式更新以页面为通信单位,局部更新容器是它的进一步下钻——读完这篇再看那个,会顺很多。
本文是「小程序双路线源码拆解」系列的第二篇(单点深挖篇)。下一篇我们拆局部更新容器:变更节点的最近容器查找算法、缓存策略、空壳组件的语义到底存在哪一层。感兴趣的话关注一下,更新会第一时间推送。
本文涉及的代码均为基于源码设计思路重写的简化伪代码,仅用于技术交流,不代表任何项目的真实实现;文中代称与真实项目无关。
一站式 AI 云服务平台
更多推荐
 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)