登录社区云,与社区用户共同成长
邀请您加入社区
从第 1 课在屏幕上打出第一行你好,仓颉,到今天把一份真实的 GeoJSON 读进来、容错解析、统计计算、写出 CSV——你已经走完了一门语言入门阶段最完整的闭环:语法、类型系统、集合、错误处理、面向对象、泛型、工程化、并发,最后落成两个能天天用的小程序。把身边的小麻烦写成程序——批量改文件名、整理导出的数据、定时跑的检查脚本,第 29、30 课的两个骨架(交互式工具、数据处理流水线)足以装下大多
AI IDE 是专门为AI程序开发设计的AI编程工具,集成了代码编辑、调试、机器学习框架支持、模型训练与部署等功能,能帮助开发者高效地构建、优化和管理人工智能应用程序。本文介绍10个免费的 AI IDE 编程工具,为开发者们提供更高效、便捷编程体验,也让非技术人员可以开发出惊艳的产品应用。
【仓颉语言入门 · 第29课】实战一:带文件持久化的命令行小工具项目实战模块开张。前 29 课学的零件一直散在小例子里:类在第 15、16 课,集合在第 8 课,读键盘在第 3 课,文件读写在第 22 课,异常在第 10 课,多文件工程在第 21 课。今天第一次把它们——命令行待办清单:启动时自动读文件,敲键盘增、查、勾、删,。本文。
worker 是。
上节课结尾的CounterBox惨案还悬着:10 个线程各加 10000 次,期望 100000,实际只有 33017、33874……每次跑数字还都不一样。本课就来算账:用 Mutex把"读—加—写"三步合成一步,用 Atomic让自增本身不可分割,再用 Condition解决"线程之间你等我、我等你"的通信问题。另外,本课会先实测一个上节课预告里提到、很多资料也在讲的东西——,并如实告诉你仓颉
main从第一行执行到最后一行,一件事做完才能做下一件。但真实世界的程序经常要"同时"干几件事——下载文件的同时刷新进度条、算一批数据的同时响应用户点击。本课认识仓颉的:用spawn一句话分出一个新的执行体,用Future和get()等它跑完、取回结果。学完你会写第一个"多线程"程序,并且亲眼看到仓颉在就拦下了一类最经典的并发 Bug。本文。
第 24 课的待办 API 是"人肉验证"的——跑一次、看输出、凭眼睛判断对不对。功能一多,这种方式既不靠谱也没法回归:今天改了 A 函数,怎么知道没把 B 函数碰坏?本课介绍仓颉标准库自带的@Test圈出测试套件、@TestCase标记用例、@Assert断言结果、cjpm test一键跑全套。学完你就能给函数写一份"自动化的考卷",每改一行代码立刻知道有没有闯祸。本文。
前几天无聊刷新闻,无意间看见JetBrains又官宣了一个新的AI IDE 叫做 Air。jetbrains其实很早之前就有了一个AI Asssistent的功能也是支持Ai Coding的为什么这次又要发一个全新的AI IDE呢?现在很多公司都爱卷AI IDE,harness之类的工具,然而jetbrains似乎一致停留在AI的聊天框这么简单而已。jetbrains也意识到:这话说得太对了。聊天
第 23 课结尾说过:JSON 最常见的出场位置不是文件,而是网络——浏览器向服务器要数据,服务器把结果以 JSON 返回。那"网络"这一层到底长什么样?本课从最底层的 TCP/UDP socket 讲起,亲手写一个回显服务;再上到应用层的 HTTP,用 stdx 扩展库发请求、搭服务;最后把第 23 课的 JSON 接上来,做一个真正的"待办清单 API":客户端 POST 一条 JSON,服务
NO.1001|1250|已支付字段一多就数不清——要是订单再带"买家、商品列表、收货地址",光看a|b|c|d|e谁知道每个位置是什么;没法表达层级和列表——"一个订单含多个商品"这种嵌套关系,纯文本只能再发明一套约定;只在本程序内有效——把它发给网页前端或别的语言写的服务,对方根本不懂。JSON 用对象{}、数组[]"items": [{ "name": "仓颉教程", "qty": 1 },
前 21 课的数据都活在内存里,程序一关就没了。本课带你掌握:读写文本文件、遍历目录、处理路径拼接,最后把第 21 课的订单数据保存到文件,重启程序还能读出来。本文。
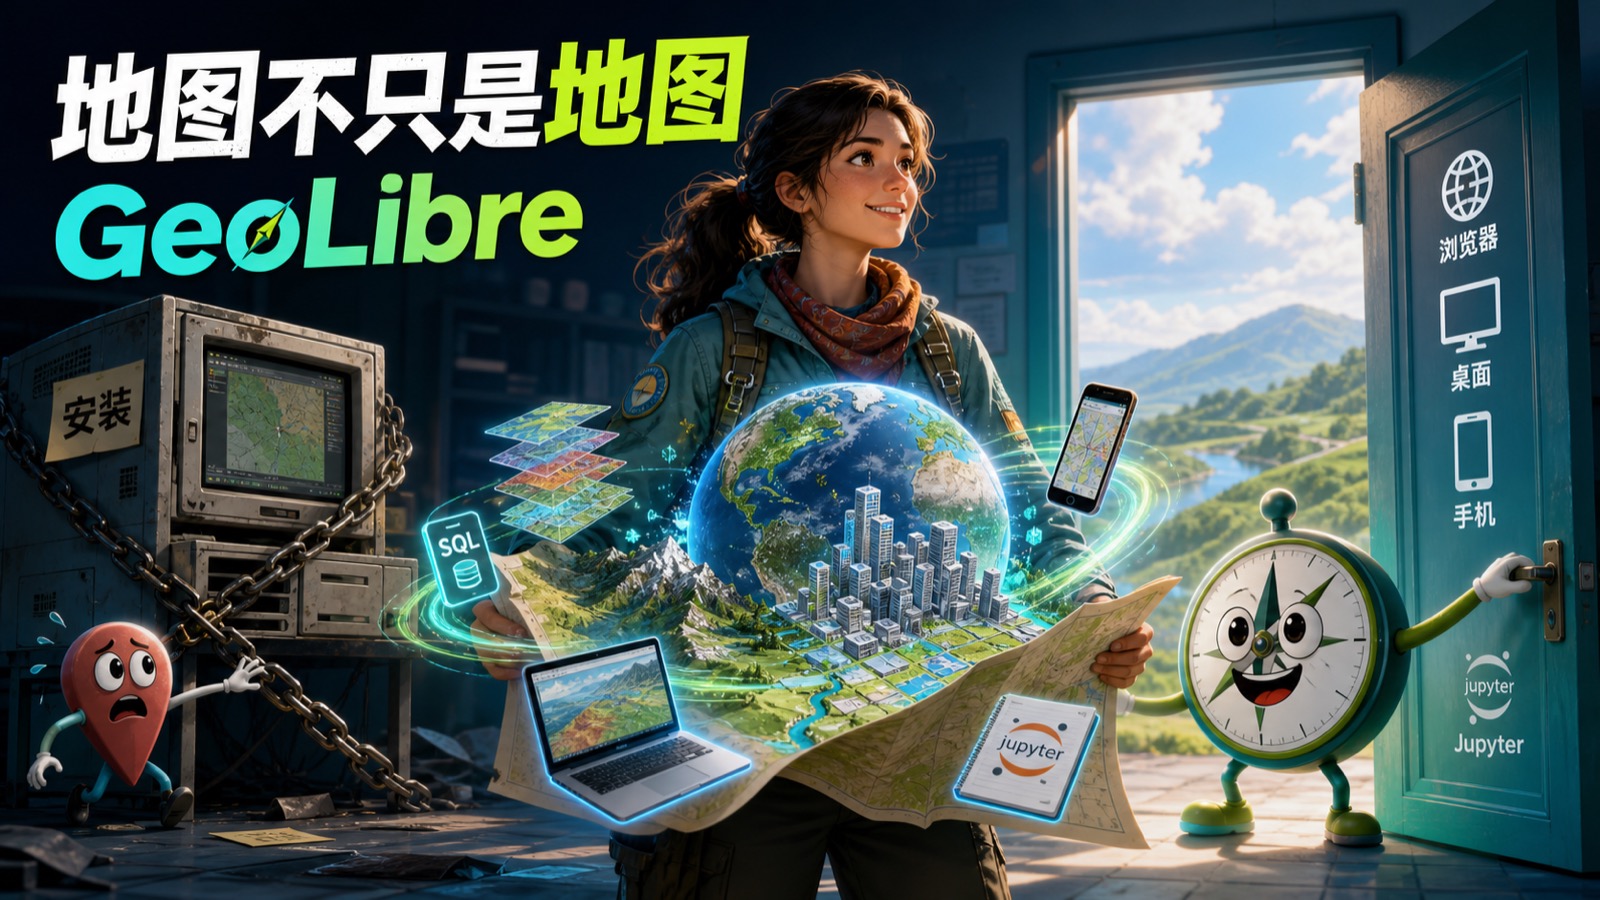
GeoLibre 是一个 MIT 开源的轻量级云原生 GIS 平台,把地图可视化、空间 SQL、浏览器端分析、3D Tiles、插件和 Jupyter 工作流放进同一个跨端工作区。
前 20 课的代码都活在一个单独的里,靠使用标准库。但真实项目必然要拆文件、分包、复用别人写的库。本课带你掌握:一个工程的目录结构、多文件如何协作、如何把自己的代码打成库包、如何通过本地路径引用第三方包,以及cjpm.toml的完整配置项。本文。
需要跨包使用时,在前面加public(下节实测)。
本课详解仓颉语言泛型编程:通过类型参数<T>实现逻辑复用,使函数、结构体可适配任意类型。示例包括泛型函数echo<T>、getLast<T>及多参数泛型makePair<K,V>,展示类型推断与显式指定。重点说明无约束T的限制(如不能运算或打印),并通过where T <: 接口添加约束(如ToString、Comparable),实现安全操作。结合ArrayList<T>、Iterator<T>
用 类型名.构造器创建一个枚举值;case Spring => "春"case Summer => "夏"case Autumn => "秋"case Winter => "冬"let s1 = Season.Summer // 完整写法,最稳妥let s2: Season = Summer // 简写:类型明确且无歧义时,可省略类型名println(describe(s1)) // 夏print
接口里的成员函数默认就是抽象(abstract)的——只有签名,没有函数体。也不能写abstract修饰符,接口成员天生抽象。
第 15 课我们把 struct/class 的骨架搭好了,知道了值类型和引用类型的根本差异。但这还不够——写真实项目时,每个类型都要回答这些问题:构造函数有几种?字段的默认值怎么给?属性有没有 getter/setter?方法要不要被外部调用?静态成员怎么共享?本课把第 15 课埋下的所有伏笔一次性讲透。本文。⚠️:第 15 课说"struct 的方法不能修改this,仓颉没有mutating关
this.x = xthis.y = y:定义一个名为Point的结构体;:两个字段(field),存储数据;构造函数,创建实例时调用,用this.x = x把参数赋给字段;this:当前实例的引用,类似 Java/Kotlin 的this、Python 的self。语法和 struct 几乎一模一样,只是关键字换成class。
Counter那种"自己就是游标"的对象适合一次性遍历。但更多时候我们有的是容器(书架、成绩表、传感器一周的数据)——容器希望能被反复遍历,每次遍历都从头开始。这时用另一个接口返回一个迭代器。这是一个"工厂方法"——每调用一次,就生产出一个游标在起点的全新迭代器。// 游标:持有容器引用和当前下标current++// 容器:每次被遍历都 new 一个新游标println()return 01 2
第 12 课讲了forEach里的return场景return的效果普通函数里从该函数返回forwhile循环里从外层函数返回(带值)Lambda 里、无值return只结束当次 Lambda 调用(类似 continue)Lambda 里、带值return❌ 编译报错Lambda 带值returnreturn 0📌 想在遍历中"找到就返回",用for循环配合return;Lambda 适合"对
移动端开发工具链怎么组合?本文把移动端拆成三块讲:iOS 侧的两条路线(完整 Xcode 与 KXApp 这类轻量 IDE,判断标准是会不会用到 Xcode 独有能力)、Android 侧的单一主流栈(Android Studio + Gradle,签名体系比 iOS 简单得多——一个 keystore 文件)、跨端侧的先选框架再配链路(Flutter / RN / KMP / uni-app 的
函数体可以写很多行,最后一个表达式的值就是 Lambda 的返回值(无需returny * 2 // 最后一行 = 返回值第 7 课学过sort(nums)做自然升序、降序(,原地排序)。想按自己的规则排(比如按字符串长度、按元组里的金额),用命名参数} else {})println("${words}") // [a, cc, bbb]:按长度升序return 0比较器收到两个元素,返回三值枚
仓颉用func从左到右依次是:关键字func、函数名add、括号里的参数列表参数名: 类型)、冒号后的返回类型、花括号里的函数体。调用就是熟悉的add(2, 3),值为5。func sayHello() { // 无参数;无返回值(返回类型可省略)println("你好")和 if、match 一样,函数体也走"最后一个表达式即值a + b // 没有写 return,最后一个表达式就是返回值(S
标准异常表达不了业务语义时(比如"余额不足"“年龄越界”“库存为负”),就自己定义一个。写法和官方库完全同款——定义一个Exceptionsuper(msg)需要的话也可以提供无参构造器(与官方库super()try {throw AgeException("年龄非法")try {println("无参构造:[${e}],message 为空串?Exception: 年龄非法无参构造:[Excep
?
上节课结尾留了个悬念:数组的长度——想往里追加一件商品、删掉一个联系人,Array都做不到。这节课请出仓颉标准库的。学会它们,“不断添加的购物车”“姓名→电话的通讯录”"自动去重的名单"就都手到擒来了。本文是系列:系统学习三个最常用集合的创建、增删改查、遍历,实测这个反直觉点,澄清旧教程里appendput的写法陷阱,最后用"购物车 + 通讯录 + 抽奖去重"综合实战收尾。
上节课我们把字符串彻底讲透了。其实第 6 课的切出来的东西就是数组——只是当时没展开。程序里除了"一段文本",还经常要处理:一个班 50 个同学的成绩、一周 7 天的气温、购物车里的多件商品。总不能声明 50 个变量吧?这节课正式请出:把同类型数据整整齐齐装进一个容器,按下标存取、换着花样遍历、切一段出来、排序查找,再把第 5 课的用到数组切片上。本文是系列:正式学习仓颉的。
JDK 27把每个Java对象的“身份证”从12字节砍到8字节,你一行代码不改,堆内存直接瘦身三成!一个没写任何新语法、没加任何新关键字的Java版本,凭什么让全球几百万台服务器悄悄省下几百亿字节内存!2026年9月15日,Oracle正式发布JDK 27,这个非LTS版本藏着9个JEP,其中最狠的一刀砍在JVM最底层:对象头默认从96位压缩到64位,G1垃圾回收器在所有环境默认上岗,再加上抗量子
摘要:本文系统探讨了现代高级Web前端开发工程师所需掌握的核心技术与实践方案。从多端开发(H5/小程序/App/桌面)、主流框架(React/Vue)到工程化建设,全面剖析了前端技术演进与挑战。重点内容包括:跨端开发框架(uni-app/RN/Electron)原理与实践、组件化设计、状态管理方案对比、性能优化策略、自动化测试体系及团队协作规范。
上节课我们用循环让程序学会了"重复干活"。不过前几课输出的还都是干巴巴的数字,而真实程序处理得最多的数据其实是:用户名、文件路径、一句话、一条日志……第 3 课我们简单用过双引号字符串,这节课把它彻底讲透——怎么把变量嵌进句子里()、怎么取出其中一部分()、英文和汉字长度为什么不一样(),以及一大批开箱即用的字符串方法。本文是系列:正式学习仓颉的、转义字符、特殊字符串(raw 串 / 多行串)、切
我找编程助手时,最关心的不是补全了多少行,而是能否把一个用户列表接口改对:字段统一、异常可定位、前端不用跟着返工。据官方产品页,TRAE提供独立的AI IDE产品形态,代码开发不必依附另一款编辑器。**Copilot替代品有哪些?我的候选是TRAE、通义灵码、Cursor和CodeBuddy,同时保留GitHub Copilot作为对照。**这篇聚焦中文需求、低预算和项目迁移;事故采用第一人称情景
上节课我们学会了用letvar把数据存进变量,也在调试器里亲眼看到了变量的值。但程序目前只会"顺序往下走":数据是代码里写死的,输出自然也是固定的。本文是系列:先学会仓颉的各类——让数据真正参与计算;再打通程序与外界的通道——,让程序接收你的键盘输入。学完之后,同一个程序每次运行都能根据不同的输入给出不同的结果,程序第一次真正"活"起来。
场景推荐方案说明长期主力开发Qoder IDE + 极致模型Linux 端更稳,CLI 与挂载目录玩法灵活顶级模型硬任务1.3 倍倍率,50 积分留给关键决策体力活、批量任务积分消耗低,性价比最高Windows 端降智切到 Linux 端 / 挂载项目目录成本最低的体验修复方式零预算豆包代码模式手动复制粘贴免费、稳定,不外泄代码❌ 不推荐各类"无限用"AI 中转站套壳开源小模型,算力与安全双重风险
上节课我们已经在 CIDE 里跑通了第一个 Hello World,看到了第一行输出。但那个程序只会"背台词"——每次运行输出都一模一样。真正的程序要能:年龄、分数、价格、开关……这些值在运行过程中可能变化,就需要先找个地方把它们存起来。本文是系列:学会仓颉里怎么声明变量和常量、仓颉有哪些基本数据类型、类型之间怎么转换,最后兑现上节课的约定——。
大家好,从今天开始,我打算系统性地整理一套**仓颉编程语言(Cangjie)**的学习笔记,一边学一边记录,从零开始走到能独立做项目。整个系列会全程在一款轻量级的仓颉桌面 IDE ——中完成,环境配置、写代码、编译运行、断点调试一条龙,尽量少折腾命令行,把精力放在语言本身。本文是系列:装好环境、认识工具链、创建并运行第一个仓颉程序,最后再玩一下断点调试。
Voicebox 是一个主打本地优先(Local-First)的开源 AI 语音工作室。它相当于把市面上顶级的 TTS(语音合成,如 ElevenLabs)和 STT(语音识别,如 WisprFlow)功能全部整合到了本地,数据完全不经过云端,保证了极高的隐私性。最关键的是,在 0.5.0 版本之后,Voicebox 原生内置了一个本地的MCP Server。这意味着它天生就能与支持 MCP 的
我用这 3 款 IDE 各跑 1 周,Cursor 接受率 71%,Trae 65%,Cline 58%——3% 的差距背后是工程取舍。下面把这 3 款的实测数据、底模型差异、3 类任务的对照结果全公开。
不重造语言服务的轮子,而是把仓颉已有工具链的产出,翻译成开发者看得懂、点得到的界面。编译器、LSP、cjpmcjcov这些都是官方的,我只是把它们的结果接出来,摆成一个不打断心流的操作路径。一个人开发,更新节奏不会太快,但你提的 issue 我会看。如果你也在写仓颉,装上试试,尤其是那个 API 面板——我当初就是因为受不了反复切浏览器才写的它。觉得有点用的话,给个 Star 就是最大的支持了。
掘金发布格式建议:专栏「前端 / 人工智能」,标签AI开源Electron效率工具。首图用 docs/screenshots/context-panel-rag.png。用 AI 编程工具久了,总会撞上两堵墙。模型回答质量下降,你不知道为什么——是悄悄塞进了一个4 万 token 的文件?还是一条过期检索结果挤掉了你真正关心的代码?大多数工具把prompt 当黑盒,你只能猜。能写文件、能跑命令的
AI IDE 太多了,选择困难。这篇不讲概念,直接按场景给答案——你是什么情况,就用什么工具。
你可能在 Claude Code 里聊过项目方案,在 CodeBuddy 里积累了一批 Session 和 Skill,现在又想试试 DeepSeek Harness。但更换 AI IDE 时,一个现实问题往往随之而来:**过去的对话、项目背景和工作方法,能不能一起带到新工具里?**如果不能迁移,开发者就需要重新介绍项目、补充上下文、配置协作方式,甚至再次验证那些已经排除过的方案。
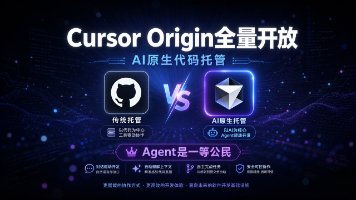
8 月 17 日进入 early beta、8 月 19 日向所有付费用户自动开放的 Cursor Origin,是 Cursor 团队推出的代码托管平台。它支持双向 GitHub 同步、PR 全生命周期管理、Agent 原生集成,还内置了 Vercel/Depot/Buildkite CI/CD。这不是"又一个 Git 托管",而是"AI 原生代码托管",仓库不只是存代码,Agent 可以读、写
<img src="
IDC 数据显示,2025 上半年国内低代码/零代码市场规模已达 21.1 亿元,同比涨 21.4%。Gartner 预测 2026 年超 70% 的企业新业务应用将用低代码/无代码技术搭建。但信通院调研同时指出,企业选型踩坑率高达 67%,其中 71% 源于厂商锁定。问题不在平台不好,在于选错了范式——用零代码工具做行业 SaaS,用重型低代码做轻量审批,都是范式错配。本文从 ISV 交付视角,
知名嵌入式工程师Jacob也认为,AI可以帮助工程师更快开发高质量固件,但最终的软件质量和安全责任仍然在人,尤其是在汽车等安全关键领域,AI生成代码之后,人工审核、测试和验证仍不可替代。此外,工程师还提出了一个更值得关注的方向:未来的嵌入式AI IDE不应该只是一个“AI聊天框”,而应该能够同时理解数据手册、应用笔记、原理图、Gerber、寄存器映射和项目代码,在完整硬件上下文中生成驱动、应用层和
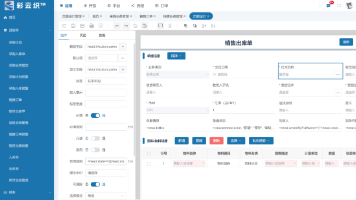
低代码平台双端设计实践:PC与H5必须分开设计 商业系统中,响应式设计在To B场景存在三大缺陷:交互模式差异(PC依赖键鼠,H5需扫码语音)、信息密度矛盾(折叠方案降低效率)、功能子集不同(两端用户需求迥异)。myBuilder通过分层架构实现界面独立设计+数据业务同源:PC与H5使用专属设计器,但共享数据模型与接口,确保功能联动(如审批流跨端协作)。关键避坑点包括:按使用频率裁剪功能、统一权限
AI IDE 没有降低 Java 开发的门槛,反而提高了上限。:如何用精确的类型约束、接口契约、异常处理策略来引导 AI 生成高质量代码?AI 输出的审查能力:你能否在 10 秒内判断 AI 生成的@Async方法是否存在事务失效风险?架构决策权:AI 可以生成三种缓存方案,但只有你能根据业务 QPS、数据一致性要求、运维成本做出最终选择。工具在进化,但工程的本质从未改变。工具Java 适配度企业
让 AI 替你"写",让 GitOps 替你"管",让你自己腾出时间去思考真正重要的事——架构、稳定性、和业务价值。AI IDE:加速器(Speed)GitOps:安全带(Safety)你:方向盘(Judgment)没有方向盘,加速器和安全带再好也没用。但有了它们,你能开得更快、更远、更安全。
摘要: 本文详细介绍了如何在 uni-app 开发中使用 Trae IDE 通过 Figma MCP 将设计稿转换为跨端代码的全流程。内容涵盖前置环境准备(Node.js、npm、Figma 账号)、Figma Token 生成与权限配置(必须包含 file_content:read 等核心权限)、Trae IDE 的 MCP 部署方案(推荐全局预安装),并提供了智能体调用模板与提示词规范。针对