登录社区云,与社区用户共同成长
邀请您加入社区
介绍Hugging Face核心概念,提供5个实操方法:Pipeline模型调用、Spaces零代码体验、Datasets数据流式加载、4-bit量化本地部署以及LoRA参数高效微调。包含具体参数事实与Python代码示例,帮助开发者跨越开源大模型硬件与代码门槛。
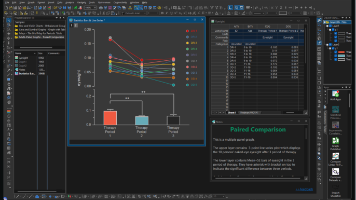
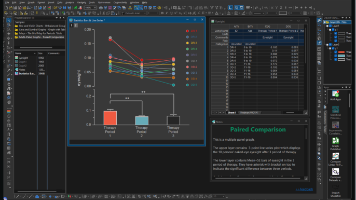
这款由复旦NLP团队打造的AI学术智能体,专治“不会搜、读不懂、跟不上前沿”的痛点,一站式打通检索-解读-追踪全链路,尤其适合跨学科或外语薄弱的硕博生。零代码点选操作,统计分析+高精度绘图一步到位,远超Excel,满足SCI/核心期刊投稿要求(生物/医学/工程/社科均适用)。无需本地安装LaTeX,模板丰富、实时协作、版本历史,专治“格式调半天、团队改稿冲突”的痛点,理工硕博毕业论文/SCI首选。
Hugging Face作为机器学习开源社区,截至2023年底已托管超30万个预训练模型和5万个数据集。本文拆解其核心工具链,包含transformers 4.35版本调用、datasets内存映射加载、Spaces零代码部署、Inference API推理测试及AutoTrain无代码微调。提供具体Python与curl代码示例,面向独立开发者与中小企业提供实操落地指南。
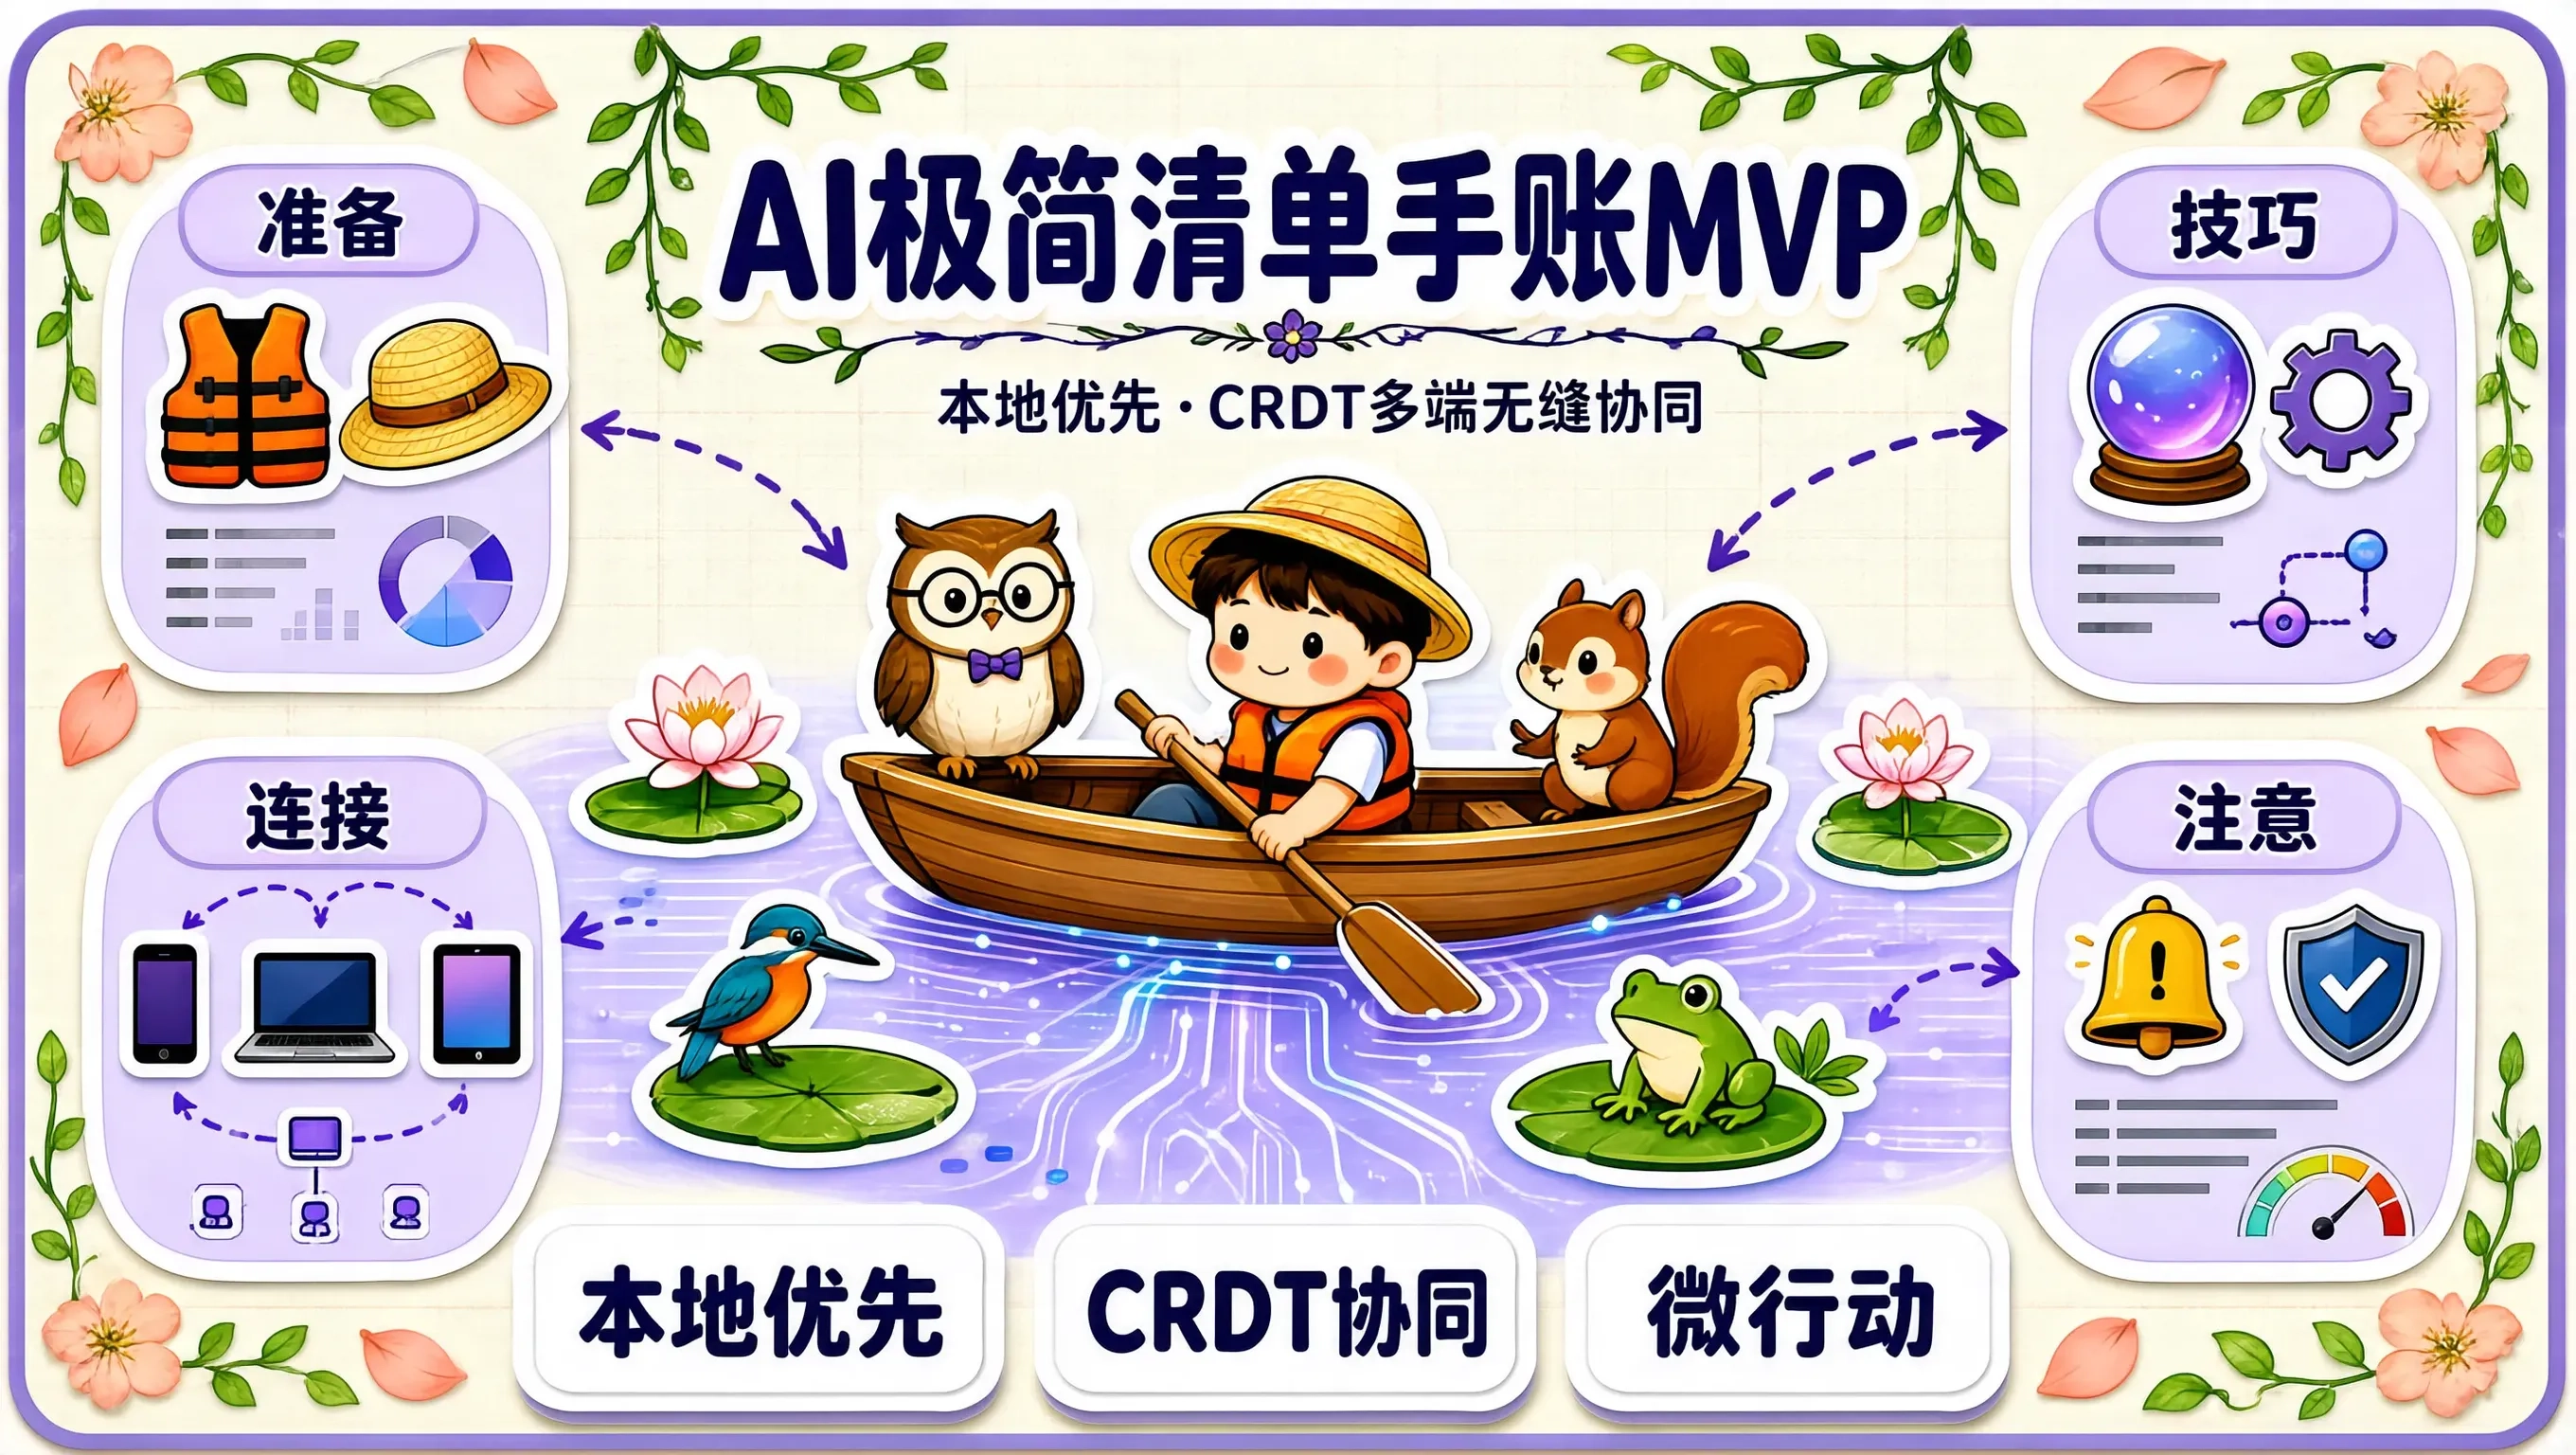
九月第四周的周三。经过连续三天的高强度编码与算法打磨,我的第四款核心作品——在本地局域网与跨端测试环境中正式跑通闭环!这是我们在整个九月技术沉淀最硬核的一次交付:它不仅继承了「Tide UI」温润治愈的手作视觉外壳,更在底层真正跑通了**“100% 本地优先(Local-First)+ 纯客户端轻量 CRDT 多端无缝协同 + 5 分钟微行动拆解”**的完整全栈架构。今天把这款 MVP 在多端设备
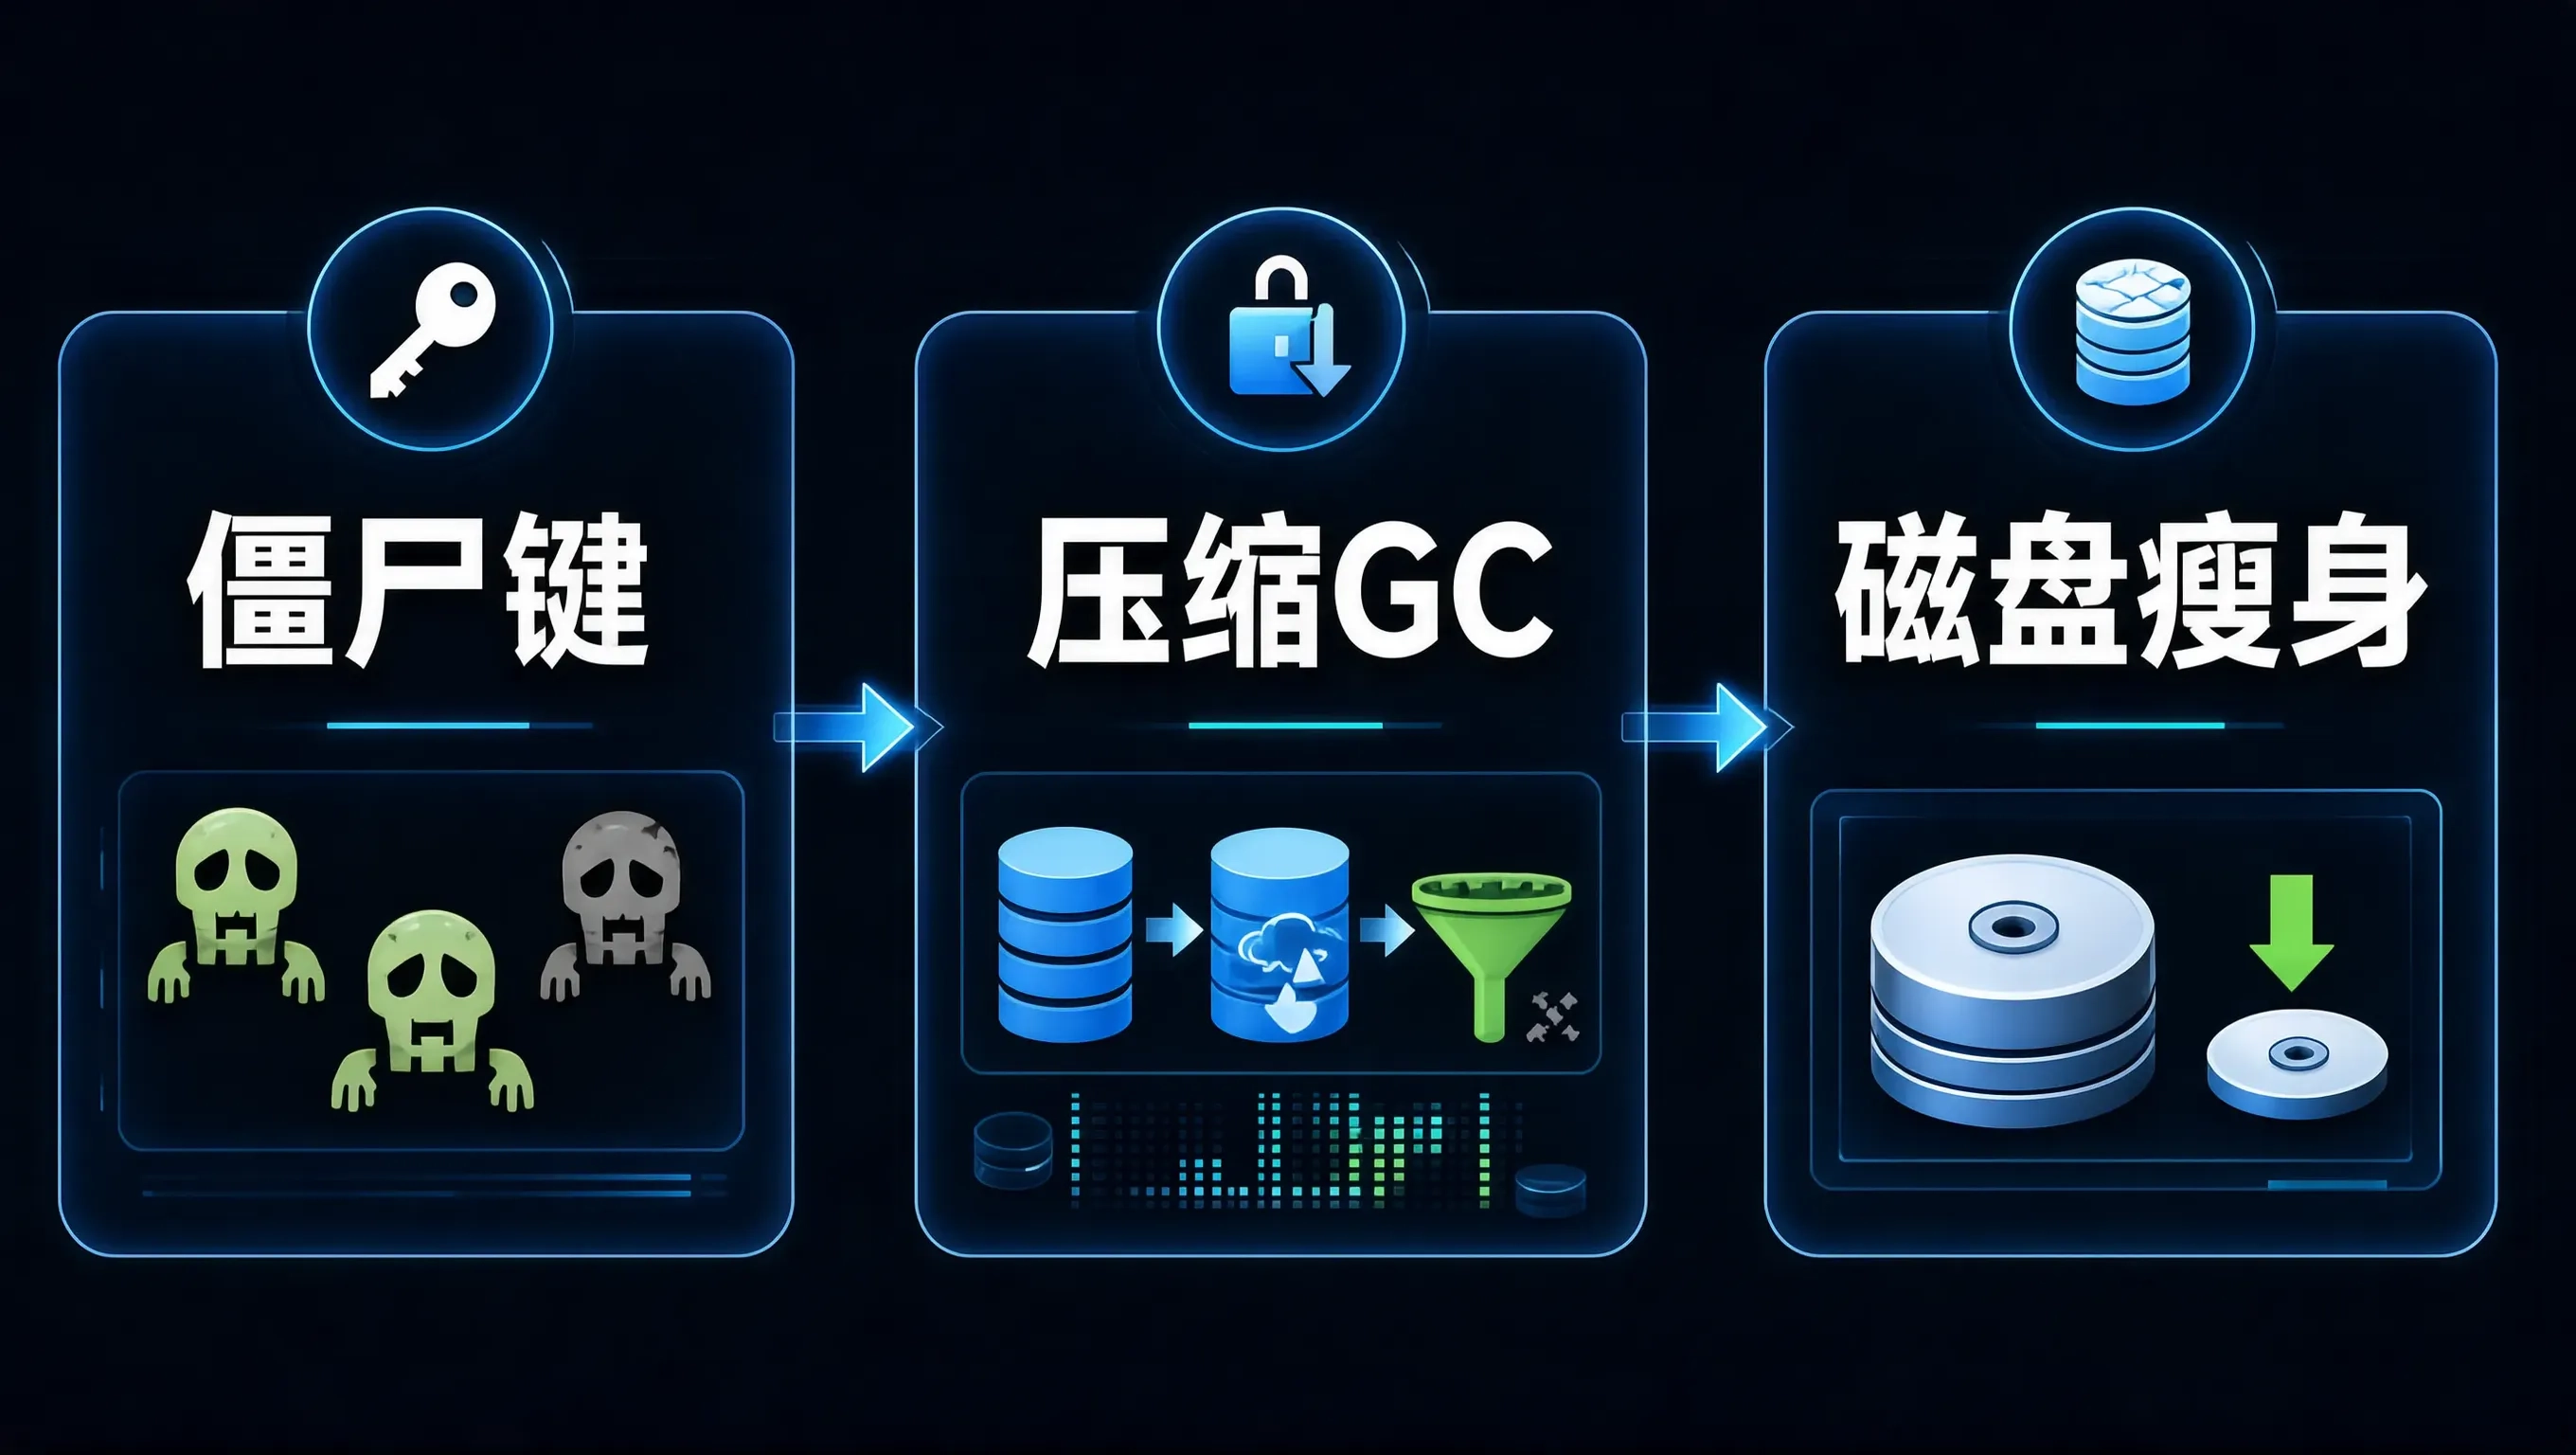
在 Apache Flink 构建 7x24 小时不间断运行的企业级实时数仓宽表与用户画像标签任务中,流计算工程师面临的一项最隐蔽、也是最具破坏性的“慢死故障”,莫过于**“无界流状态无限膨胀导致的物理磁盘打爆(State Unbounded Expansion & Disk Full Crash)”**。KeyedState为了从物理上根治状态无限膨胀,Flink 引入了革命性的。通过配合,可以
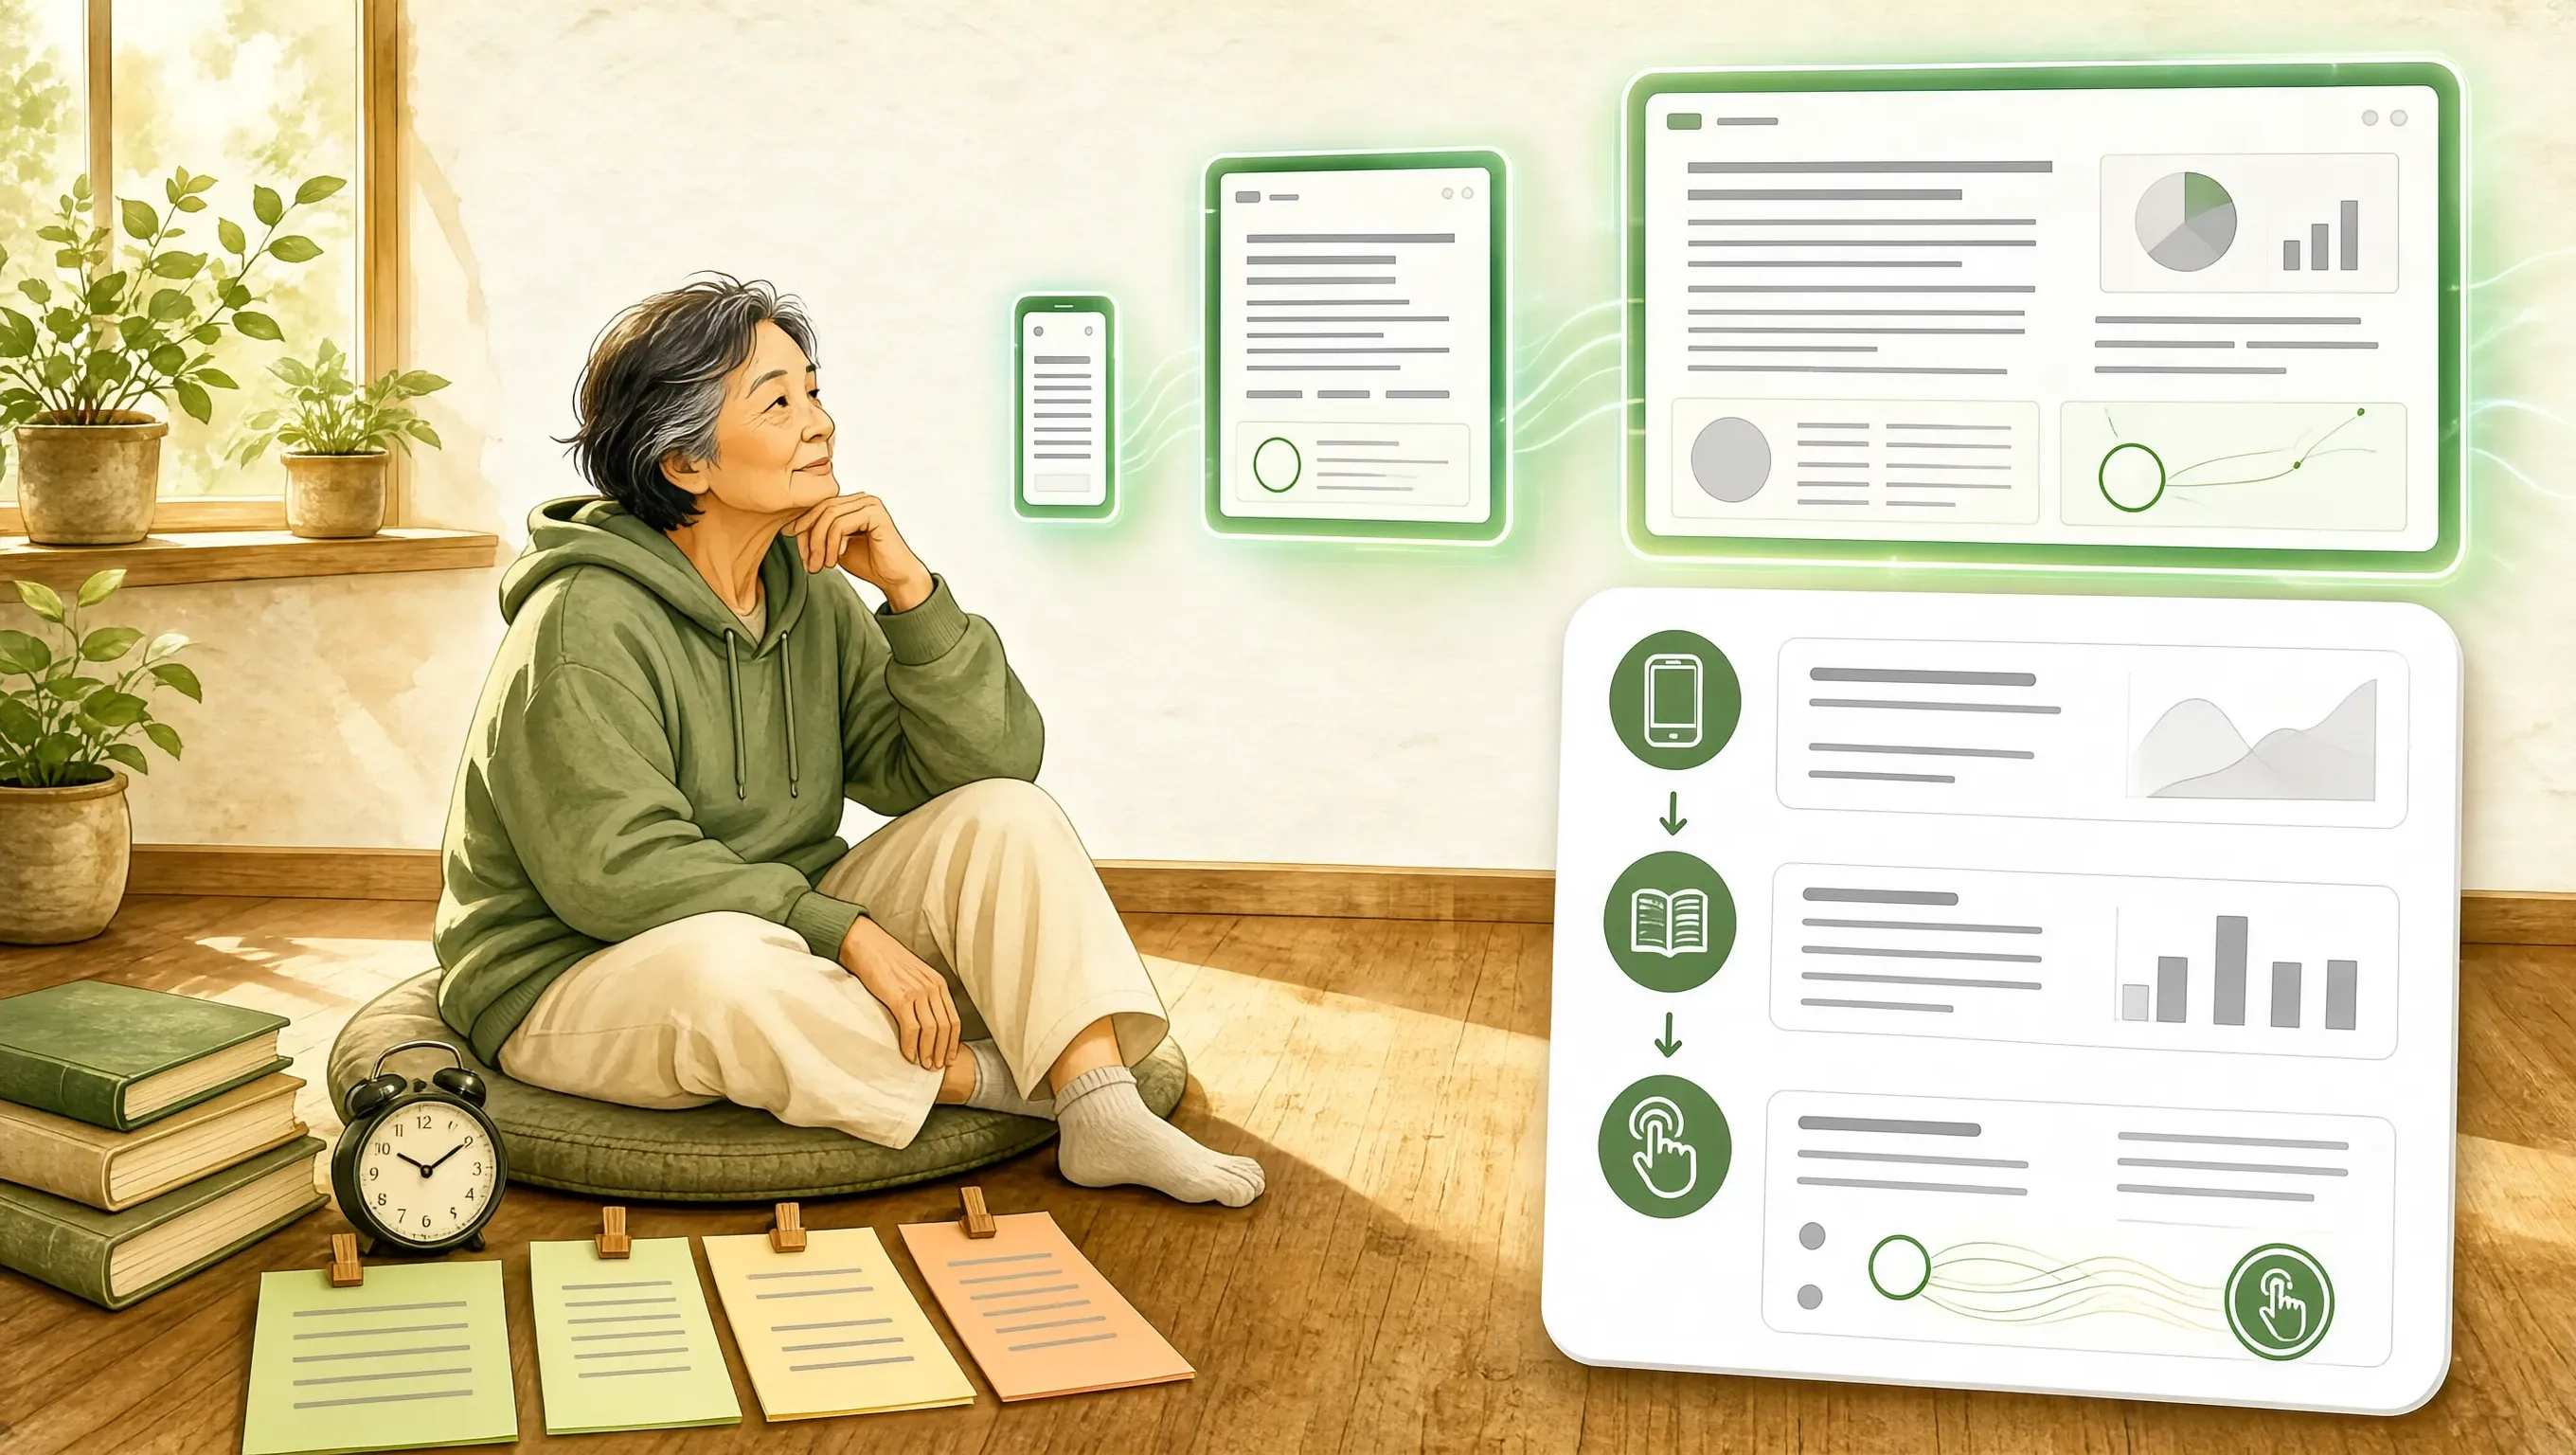
在很多面向家庭跨端应用(同一套代码运行在女儿的 iPhone、老爸的 iPad 平板与客厅的触摸大屏)中,响应式排版经常会出现一种严重的"适老灾难":开发者仅仅使用了 Tailwind 默认的或在移动端按屏幕宽度等比例缩放(vw / rem基于clamp(),我总结了一套在手机、平板与大屏之间无缝自适应的生产级适老排版规范。
SmartCall v1.0.5重磅升级,实现智能体技能与工具的全页面可视化配置,无需代码、无需重启,运营人员即可快速定义AI客服的对话规则与业务能力。技能(如话术、知识库)与工具(如订单查询、工单创建)分离设计,分别对应AI的“懂业务”与“办事情”能力。通过插件化架构支撑,支持端到端实时语音对话中自然调用,真正实现AI自助办业务。大幅降低落地成本,助力企业快速部署多场景AI客服,从“只会聊天”进
在进入 2026 年 9 月的第二周,我们将 AI 编程助手的盲测重点,从第一周的“局部代码单行补全”,全面升级为更加严苛的**“多文件与全仓库上下文理解深度(Repo-Wide Context Comprehension)”**。在真实的大型复杂工程中,一个新功能的落地从来不是孤立的。它需要精准感知项目现有的分层架构、正确复用跨目录的公共枚举与工具类、遵循全局错误包装契约、并与数据库 DAO 层
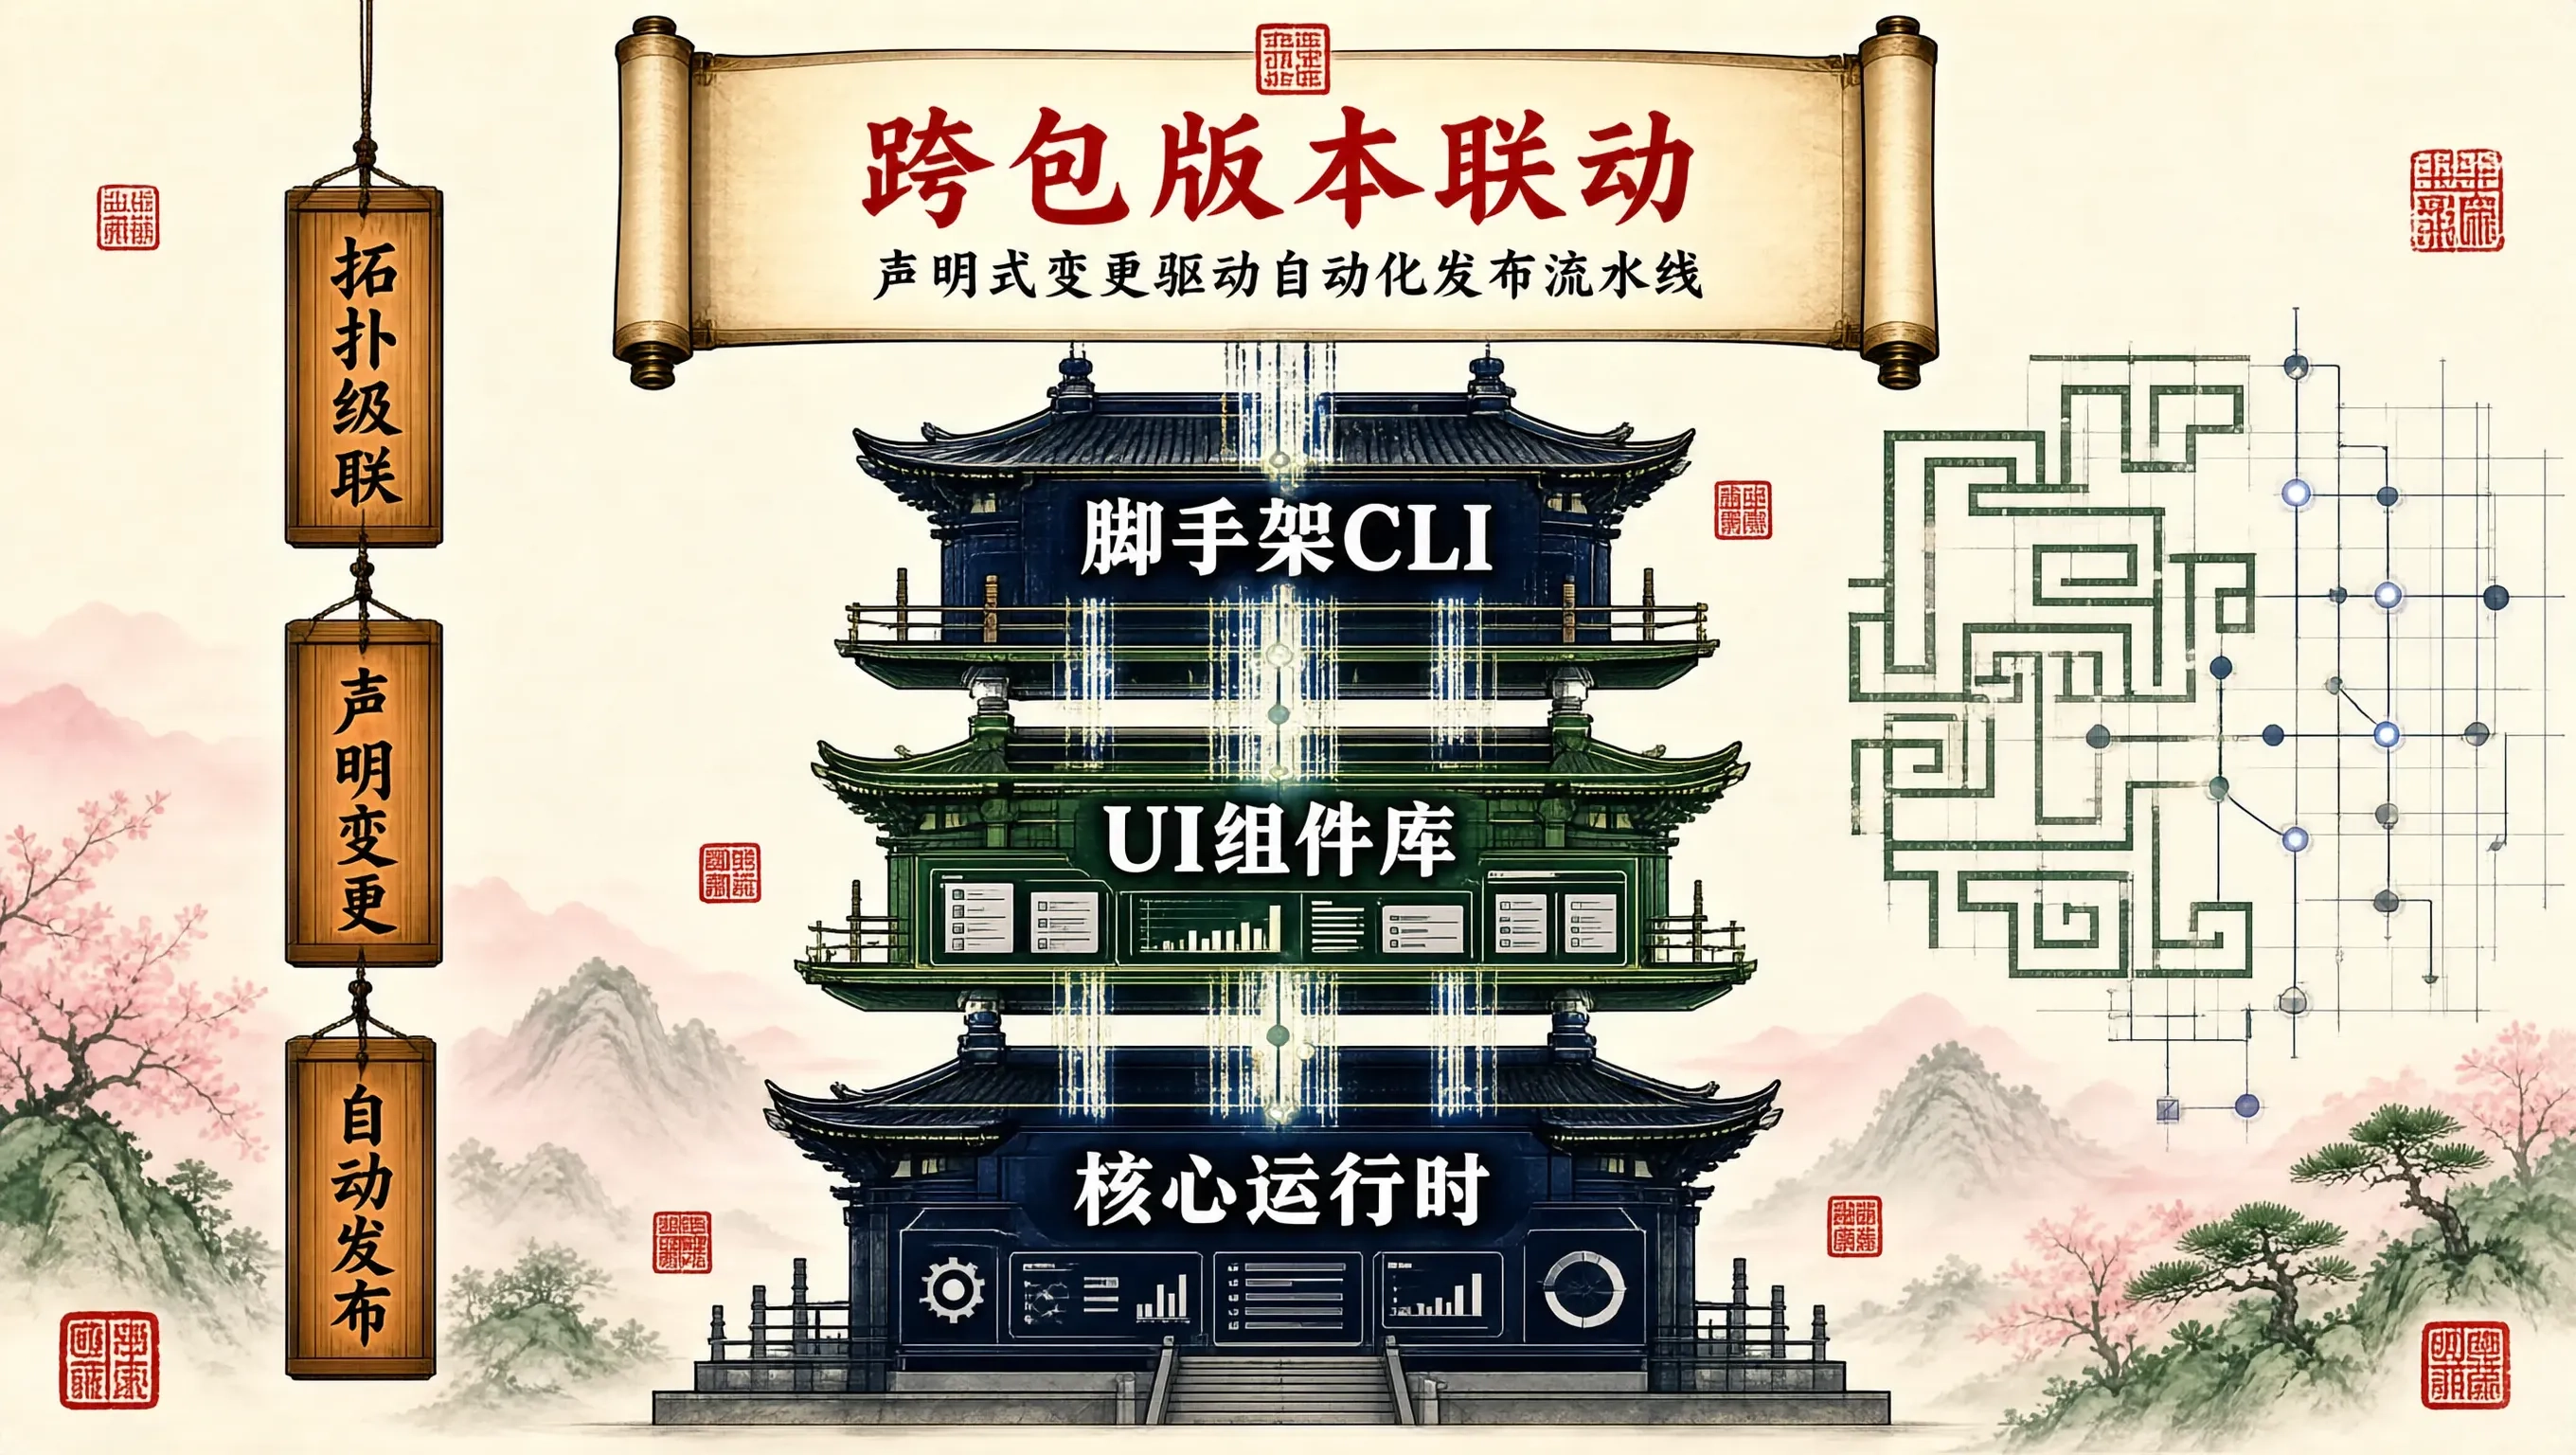
随着前端基础设施走向多元化与体系化,单一代码仓库(Monorepo)已经成为管理设计系统组件库、跨端 SDK、工具链 CLI 与公共核心逻辑的标准范式。在典型的多包仓库中,可能同时存在(核心运行时)、@scope/ui(UI 组件库)、(图标包)和@scope/cli(脚手架)数十个互相关联的子包。@scope/ui。
<think>我们根据内容生成摘要,注意控制在150字以内。需要概括核心产品(BFBT Code AI编程助手和DTworkeasy手机协同),跨端统一账号,支持平台,文档开放等。用简洁语言。</think>成都东复同科技推出AI编程助手BFBT Code与手机远程协同软件DTworkeasy,覆盖Windows/macOS/Linux及Android。两者共用一套官网账号,手机可随时远程控制电脑
把「用我的语气写」从一次性的 prompt 技巧,沉淀成了账户级的、由真实数据驱动的基础能力。它带来的价值是显性的——省去反复粘贴范例、维护 Custom Instructions 的负担,让生成内容在微观层面更像本人。但它真正的看点,是背后那套「风格向量化」的工程思路:把飘忽不定的「文风」,拆解成 phrases、sign-offs、capitalization、punctuation 这些可抽
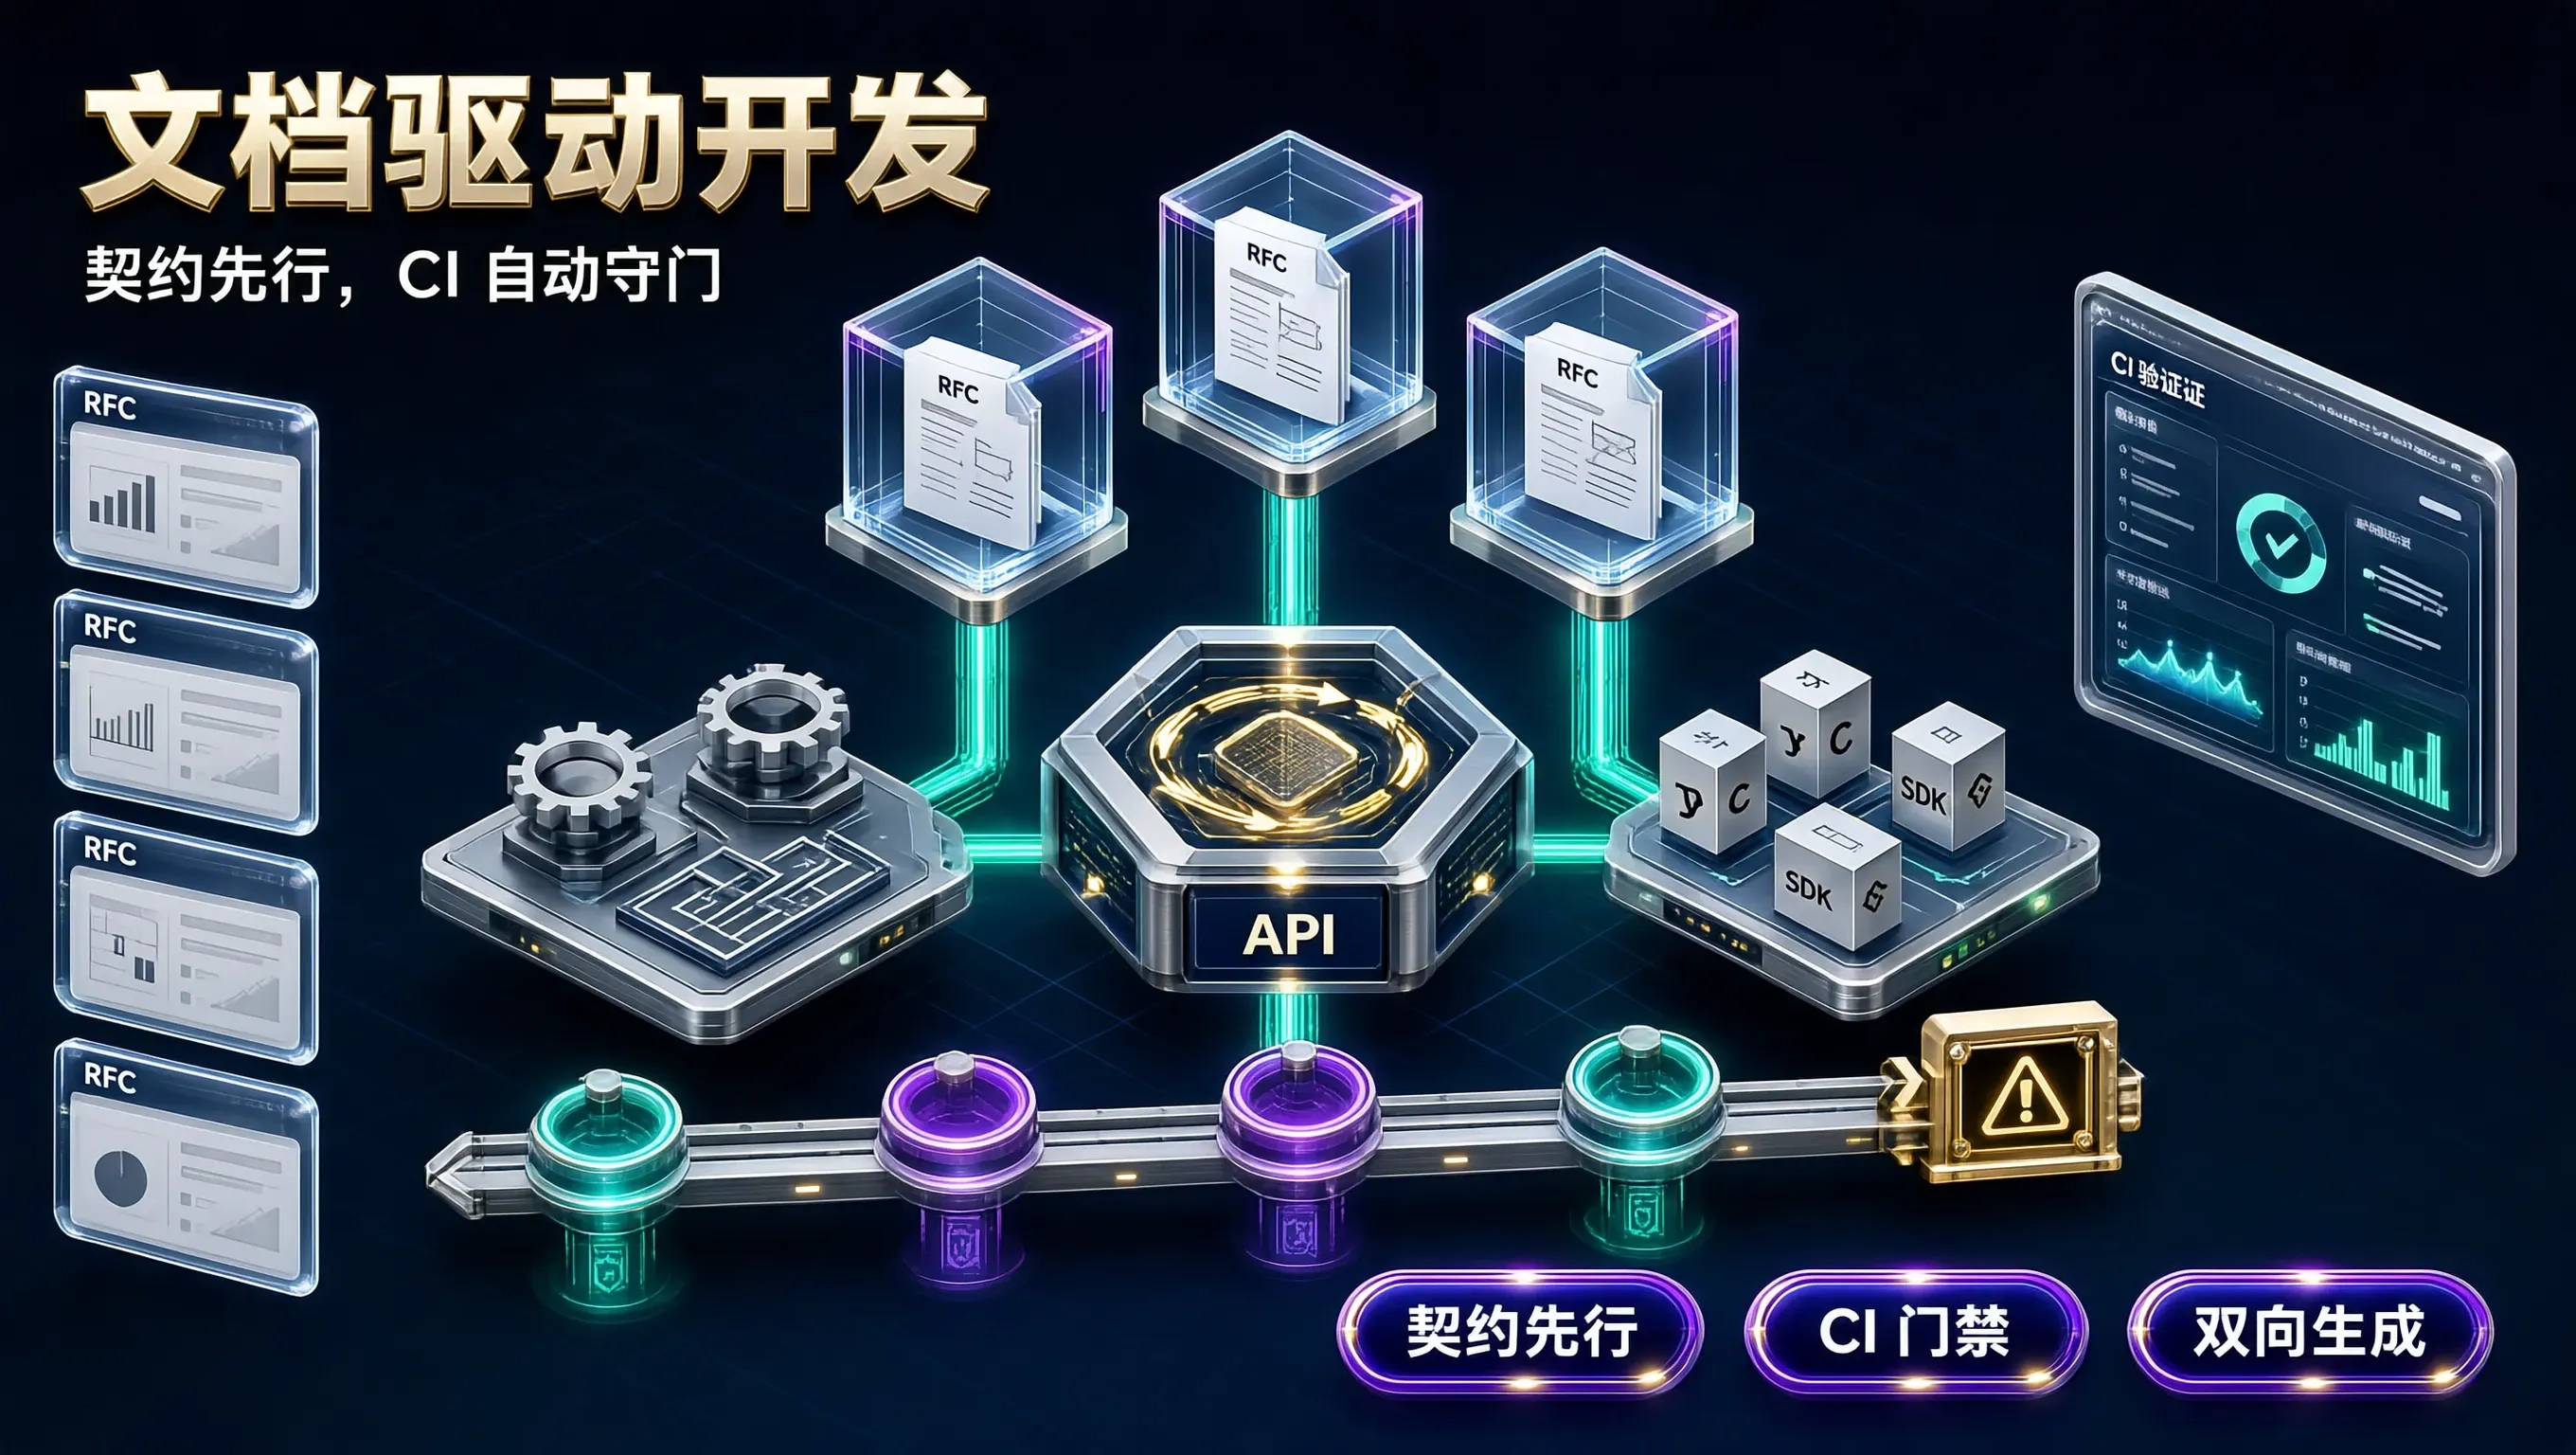
推行文档驱动开发不仅没有拖慢开发节奏,反而将团队跨端联调的耗时缩减了 60% 以上。把架构分歧前置暴露在 RFC 文本阶段,把接口兼容性交给 CI 自动化工具严格把关,开发阶段才能真正做到心无旁骛、行云流水。
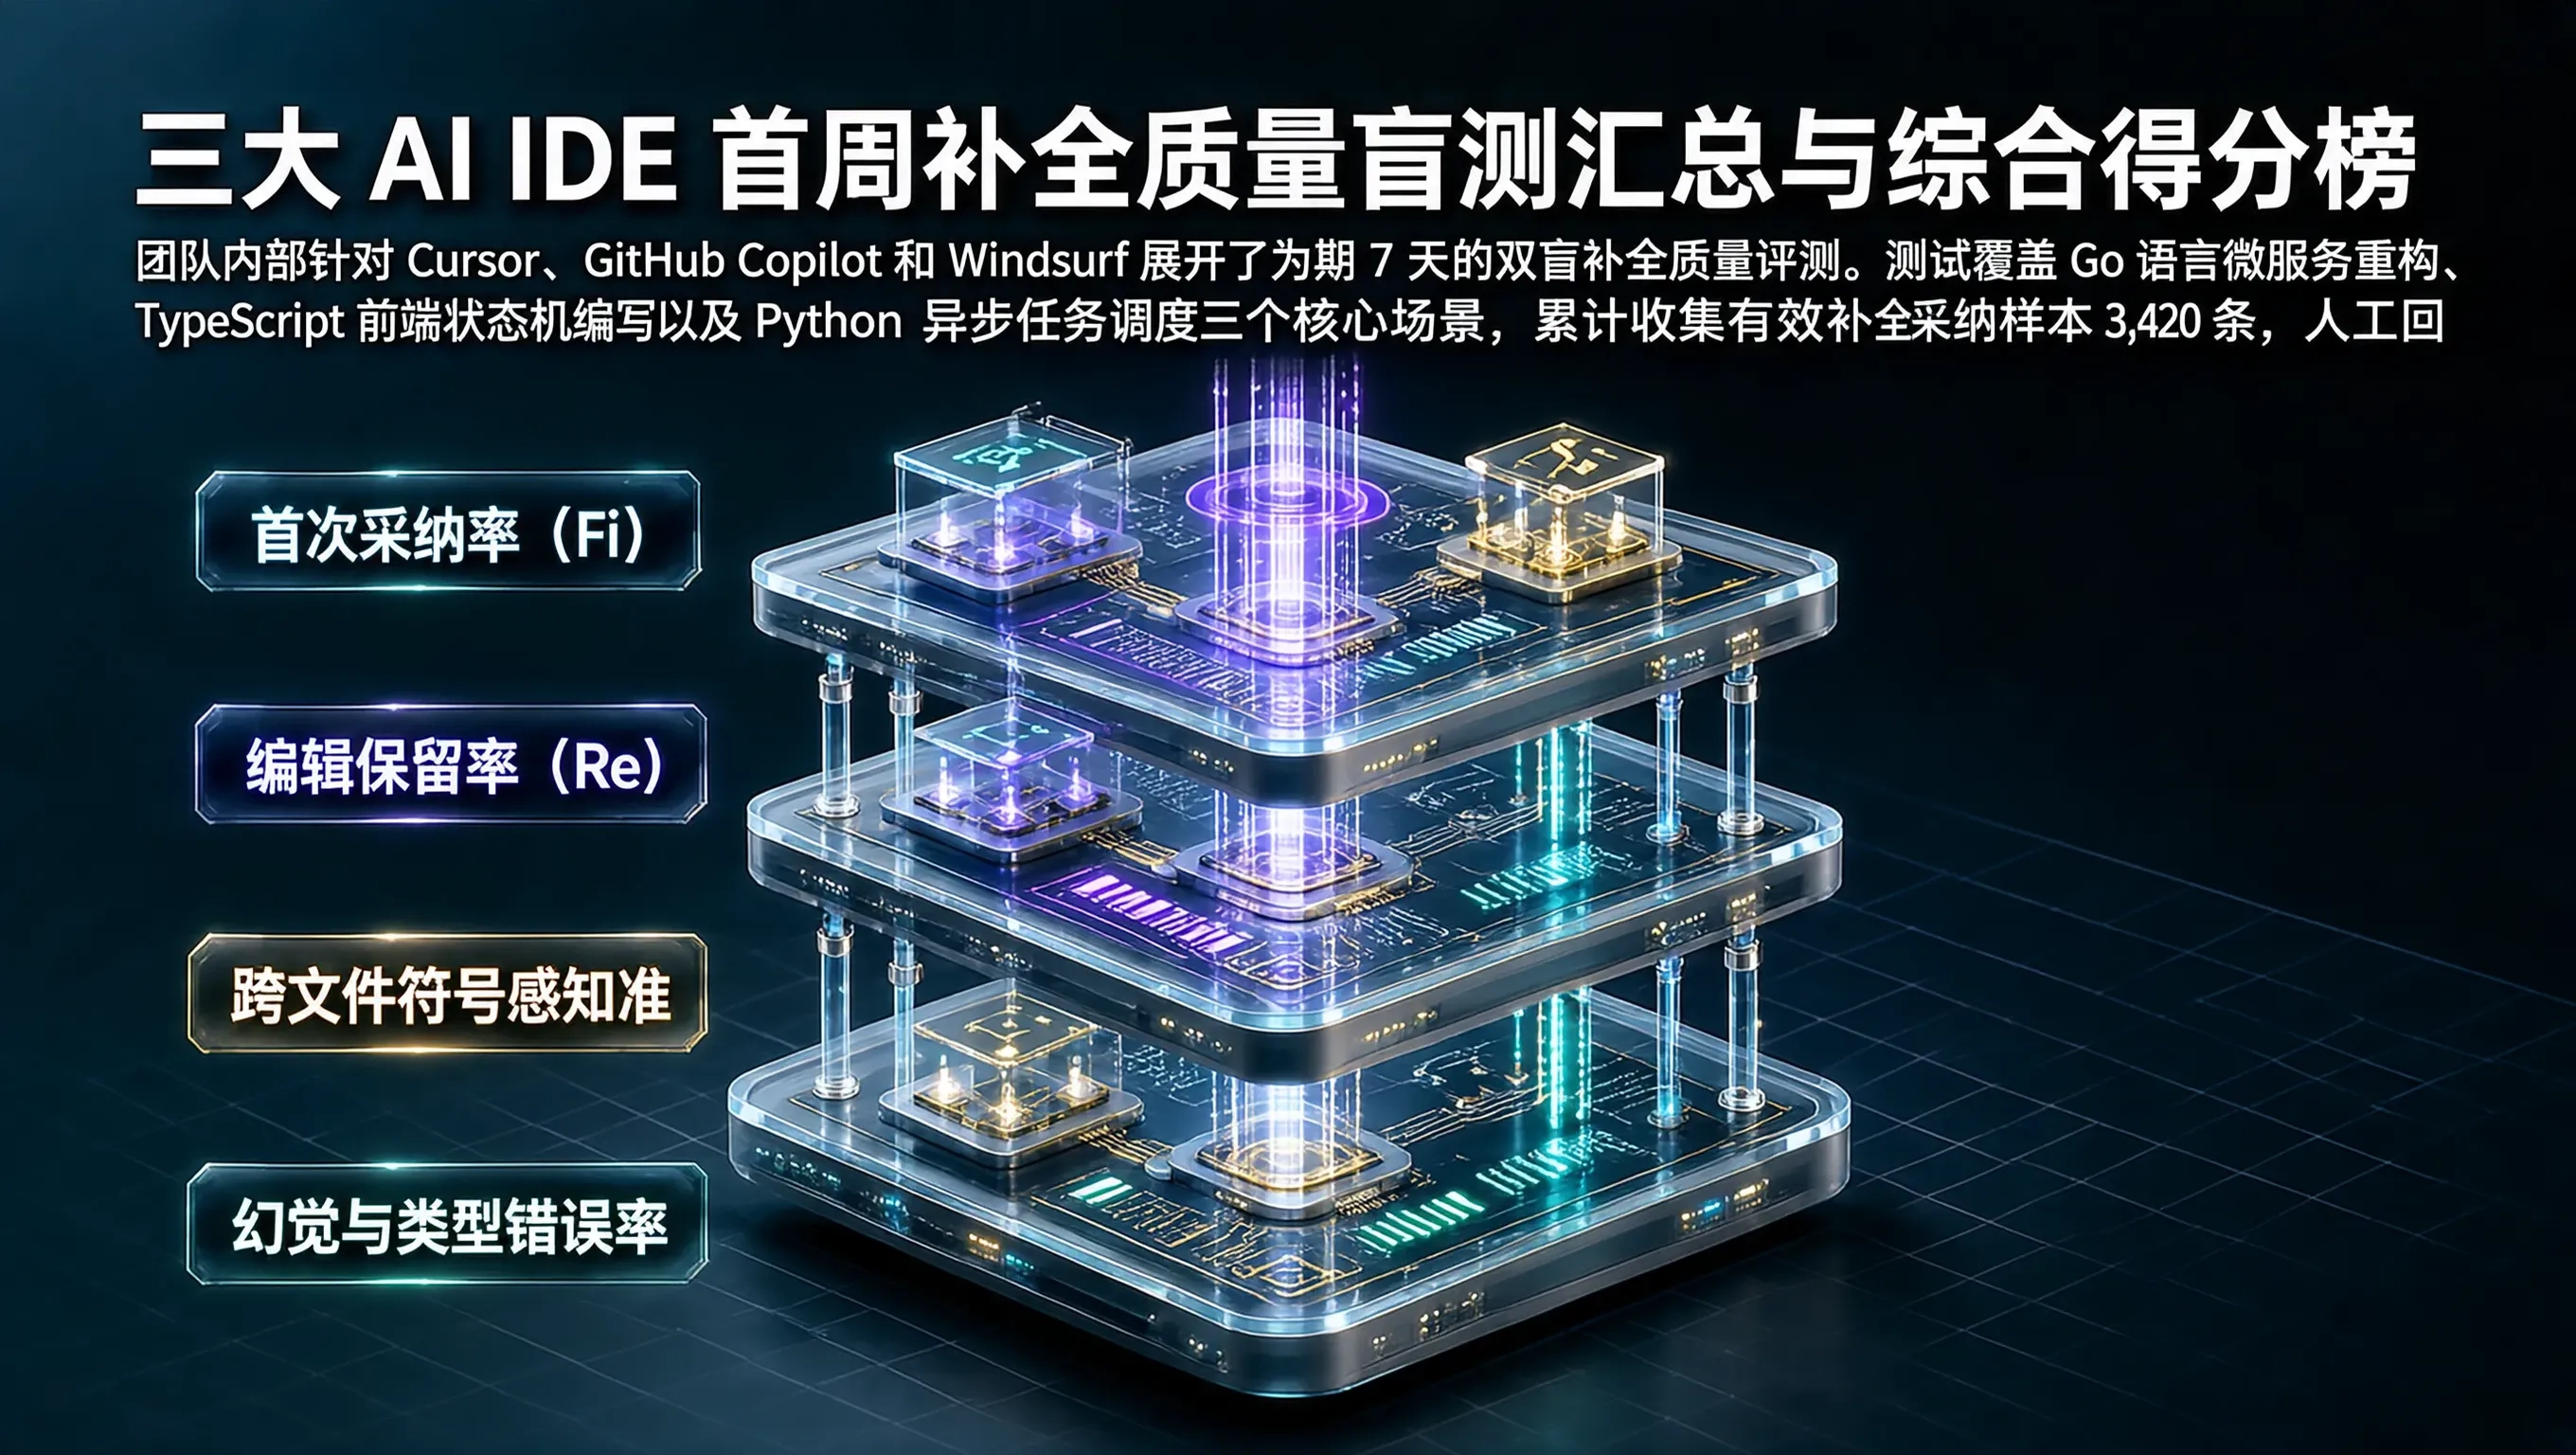
团队内部针对 Cursor、GitHub Copilot 和 Windsurf 展开了为期 7 天的双盲补全质量评测。测试覆盖 Go 语言微服务重构、TypeScript 前端状态机编写以及 Python 异步任务调度三个核心场景,累计收集有效补全采纳样本 3,420 条,人工回溯评审代码缺陷 418 处。盲测通过统一的本地代理分发补全请求,隐去 IDE 品牌特征与底层模型标识,由 12 位资深工
<think>我们根据要求:根据以下内容,生成≤150字的文章摘要。需要将整个文章浓缩成摘要。注意内容要点包括:一个基于PyTorch的6层Transformer、1亿参数的教学工具,零配置零代码零GPU,双击exe即可在笔记本CPU上训练,约10分钟出模型。目的是让初学者理解LLM训练原理。还包括快速上手、技术原理、训练流程、适用人群等。摘要需≤150字,需概括核心。我们写一段简洁的
Cursor是很多开发者日常写代码时会用到的AI IDE。不过在国内环境下,很多人使用 Cursor 时会遇到官方模型访问不稳定、免费额度不够用、模型选择受限等问题。
<think>我们根据内容生成摘要,不超过150字。需要概括文章核心:Ollama不支持一键安装Skill插件,但可通过Modelfile固化提示词、外部调度动态加载、第三方UI框架三种方式实现。澄清误区,并推荐外部调度方案。字数控制。</think>Ollama本身不支持安装Skill插件,但可通过三种方式实现:Modelfile固化提示词(适合单技能)、外部程序动态加载SKILL.md(推荐,
无需魔法|零代码|消费级显卡畅玩
我们进入正题:阿里云PAI Model Gallery支持云上一键部署DeepSeek-V3、DeepSeek-R1。在该平台上用户可以零代码实现从训练到部署再到推理的全过程,简化模型开发流程,为开发者和企业用户带来了更快、更高效、更便捷的AI开发和应用体验。
Unity 集成大语言模型的框架设计与实现研究 摘要:本研究针对 Unity 游戏开发中大语言模型(LLM)集成存在的接入碎片化、角色一致性差等问题,提出了一套双层架构的解决方案。底层通过策略模式和 ScriptableObject 实现零代码模型切换的统一接入层,上层设计了基于人格四元组的可配置人格资产系统。实验表明,该框架将新增平台接入成本降至零行业务代码,角色一致性 F1 值提升 363.5
文章摘要: SmartCall开源呼叫中心推出可视化「收取录音」配置节点,支持免打断词组白名单和静默超时智能监控两大核心功能。用户可拖拽配置节点,无需编写代码即可实现:1)设定免打断词组(如语气词不中断播报),保障重要信息完整传达;2)自定义静默超时规则(如10秒无应答触发提醒),联动后续IVR流程闭环。该方案适用于政务、催收、客服等场景,具备零代码配置、Asterisk底层支持、全源码开源等优势
日常用DCU做开发、跑任务,很多效率问题和常见坑其实不用大费周章改代码、调环境,几个随手就能用的小命令、小配置就能解决。整理了8个实测高频好用的小技巧,覆盖环境校验、性能提效、排障运维、开发提效四大场景,新手看完能少走一大段弯路,老用户也能捡几个实用小操作。
摘要: 开源AI智能呼叫中心系统SmartCall颠覆传统客服模式,以大模型+开源通信架构为核心,提供轻量化、高适配的解决方案。系统具备四大优势: AI语音交互:支持自然语言多轮对话,替代传统按键IVR,提升用户体验; 全天候值守:AI自动处理80%常规咨询,复杂问题转人工,降低人力成本; 零代码配置:可视化流程编排,快速适配电商、金融等多场景需求; 开源免费:基于Java开发,支持私有化部署与二
国产 Agent 不是没有牌。但现在还没聚成面。美国这一轮强的地方,不只是模型强,而是几个关键入口已经被产品卡住了。Claude Code 卡住终端和仓库。Cursor 卡住 IDE。Codex 卡住 OpenAI 生态里的开发任务。Deep Research / Operator 这类产品卡住浏览器任务和研究任务。而国内目前更像是:模型公司、云厂商、AI IDE、通用 Agent 团队、内容工具
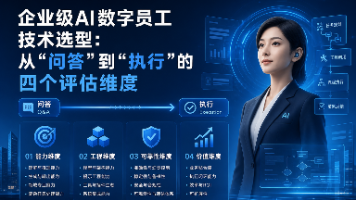
本文为企业选型AI数字员工提供技术评估框架,指出聊天机器人与执行型AI的本质差异。文章提出四个关键维度:任务闭环能力(需具备意图识别、任务编排和系统连接器)、数据安全(需支持私有化部署和权限隔离)、零代码易用性(自然语言转SQL能力)和架构扩展性(模块化插件设计)。通过对比三类技术方案,强调企业级AI应聚焦任务执行而非单纯对话,建议根据团队规模选择合适部署方式,并避免功能冗余误区。最后指出AI数字