登录社区云,与社区用户共同成长
邀请您加入社区
Hugging Face作为机器学习开源社区,截至2023年底已托管超30万个预训练模型和5万个数据集。本文拆解其核心工具链,包含transformers 4.35版本调用、datasets内存映射加载、Spaces零代码部署、Inference API推理测试及AutoTrain无代码微调。提供具体Python与curl代码示例,面向独立开发者与中小企业提供实操落地指南。
"30 秒搭好一个外呼机器人"听起来像营销话术,但拆开看,它背后是三件事:把行业话术抽象成可复用的对话模板、把配置过程从"画流程"变成"说需求"、把计费和合规做成默认能力。本文用 avavox 公开披露的信息当实例,从产品和工程两侧拆开看。
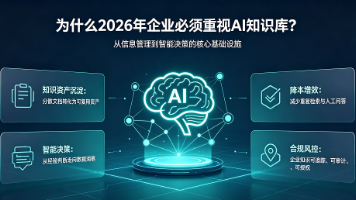
以深蓝海域KMPRO的实践为例,平台将知识加工工程化为一条七步可视化流水线:文件解析、文本清洗、图片提取、安全检查、语义切片、向量化索引、派生加工。它的核心任务,是把企业非结构化的文档、表格、图片、音视频等异构数据,通过自动化流水线加工为语义切片、向量索引、知识图谱、标准问答对等结构化知识资产,再通过RAG技术让大模型基于企业专有知识给出准确、可溯源、可审计的回答。AI知识工程平台的价值,在于帮助
报告初稿、方案框架、周报月报、新闻通稿、产品说明、培训材料、邮件和通知,都可以由 AI 根据材料先生成一版,人负责观点、口径和定稿。它原生接入飞书,在权限范围内结合企业知识与工作上下文,覆盖上述五个环节的日常工作:信息检索与定时监测、数据计算与图表、文档演示与表格创作、浏览器操作与任务跟进、轻量应用生成,产出沉淀为团队可继续协作的工作对象,支持跨端接续。这是较新的适配场景。判断一项日常工作能否交给
KMPRO AI知识库与传统知识库的最大区别在于尽可能去人工化,采用AI自动处理,结合语音、多模态知识、聚类、大模型智能等多重能力,实现把客服热线、IT服务电话、售后通话等语音记录转写并聚合,沉淀出高价值问题、解决方案、标准话术等知识资产。能处理的文件格式要足够宽泛,不仅包括常规的Word、PDF、Excel、PPT,还要能处理扫描件的OCR识别,甚至语音和视频内容的文字转写。数商云 发布了企业级
LLM应用开发常陷“黑盒执行”困境,LangSmith提供全链路追踪与自动化评估,定位RAG召回、Prompt组装、工具调用等环节问题,并实现零代码侵入观测。本文结合RAG与Agent,落地企业级客服系统,包含意图路由、业务工具、基准测试及生产自检清单,形成从调用到治理的完整技能链。
SWIFT (ModelScope)阿里达摩院出品,对国产模型(Qwen、ChatGLM) 支持完善,中文场景优化好国产模型深度用户,特别是使用通义千问等国内开源模型。Unsloth速度与显存优化之王,训练速度提升2-5倍,显存节省最高80%,对QLoRA优化极佳硬件受限或追求极致速度,尤其在消费级显卡上微调大模型。LLaMA-Factory功能最全面,支持100+模型,提供零代码WebUI界面和
过去挑 AI 编程助手,常见问题是“补全准不准”“聊天能不能读懂代码”。到了 2026 年,这个问题已经变了:主流工具都能读仓库、改多个文件、调用终端、运行测试,甚至把任务交给云端代理。真正拉开体验差距的,是工具能不能把“理解需求 → 修改代码 → 运行验证 → 解释失败 → 审查 diff → 交付结果”串成稳定闭环。所以,Claude Code、Codex、Cursor、TRAE 看起来都叫
知名嵌入式工程师Jacob也认为,AI可以帮助工程师更快开发高质量固件,但最终的软件质量和安全责任仍然在人,尤其是在汽车等安全关键领域,AI生成代码之后,人工审核、测试和验证仍不可替代。此外,工程师还提出了一个更值得关注的方向:未来的嵌入式AI IDE不应该只是一个“AI聊天框”,而应该能够同时理解数据手册、应用笔记、原理图、Gerber、寄存器映射和项目代码,在完整硬件上下文中生成驱动、应用层和
重点讨论了极度稀疏数据下的协同过滤失效、非标房源的结构化特征工程、以及基于动态任务权重的多目标优化方案。如果一个新房源由高信誉度房东发布,且描述、设施和该城市热门房源有相似的特征分布,我们会在重排阶段给予一个短暂流量暴增窗口,然后根据后验数据决定后续流量分配。:在实时捕捉用户意图的基础上,引入一定比例的“非直接相关但高互动率”的房源。低频高决策场景下的推荐系统,还有很多值得深挖的命题:如何更好地建
Headroom:AI Agent 上下文智能压缩工具 Headroom 是一个本地优先、可逆、内容感知的 LLM 上下文压缩层,专门针对 AI Agent 开发中的 Token 浪费问题。它能智能识别并压缩送入大模型的各种冗余内容(工具输出、日志、代码片段等),平均可节省 60-95% 的 Token 消耗。 核心特点: 三层压缩管线:自动路由内容到最佳压缩器(JSON/代码/文本) CCR 可
【摘要】张钧泽基于20多个RAG项目实践经验,指出90%的召回问题无需更换向量模型,提出"混合检索三阶调优法":基础层通过关键词检索补全(零代码实现,提升12%准确率),中间层采用动态权重融合(提升6%),高阶添加轻量重排序(提升2%)。该方法相比更换向量模型成本更低,实测长尾query召回率提升35%,并附检索策略对比表、10行示例代码及调优检查清单。文章强调生产环境中混合检
常量字段的作用就是为每行统计结果附加一个"身份标签",向数据下游明确标识"这一行是保姆级关键词的统计结果"。接着,依次接入"排序记录"和"分组"组件,按id升序排列后,分别计算AVG(total_interaction)得到avg_interaction(关键词平均互动量),以及COUNT(id)得到sample_count(样本数量)。第二类:标题特征标签。首先,从表输入组件引出另一条并行分支,
本文运行的前提是您已经配置好LLaMA-Factory项目并下载完成需要进行微调的模型,具体方案可以参考我的上一篇文章。LLaMA-Factory 部署与 DeepSeek-R1-Distill-Qwen 模型乱码问题解决全记录断点续训逻辑LLaMA-Factory 会自动从输出目录中读取最新的检查点。若目标总步数 ≤ 已训练步数,则直接跳过训练(不会覆盖)。若要继续训练,只需增加轮数(或步数)并
原文链接:https://pmc.ncbi.nlm.nih.gov/articles/PMC9198569/
《扣子3.0:从AI工具到团队操作系统的跃迁》 摘要:资深创作者星心源指出,扣子3.0并非简单升级,而是从"零代码Bot平台"转型为"Agent原生协作操作系统",实现三大突破:1)项目空间实现跨场景工作流沉淀;2)多Agent协作支持人与AI混合编队,效率提升显著;3)行业技能包+第三方Agent接入构建专业生态。作者强调新版本将竞争维度从"技能创作"提升至"团队架构设计",建议创作者重组技能为
AI大模型训练工作站DLTM以零代码AI能力,让每一个安防系统都能从"事后查录像"进化为"实时智能预警"。
B站单篇最高播放量为684次(标题含"保姆级"和"零代码"关键词),CSDN单篇最高阅读量为1300次(标题为"基于零代码平台的订单利润分流数据加工")。这里的"日期"是采集日期而非发布时间,同一作品在6月8日、9日、10日都会被采集到,播放量逐日累加,所以趋势折线图展示的是截止到每个采集日所有已发布作品的总播放量/阅读量。(1)标题特征提升倍率条形图:分别计算含有某个关键词的作品的平均播放量/阅
基于零代码平台的自媒体运营分析-作品特征构建
分支二:添加字段选择组件 搜索"字段选择",拖入画布,命名为"字段选择"。点击"获取字段"自动载入上游所有字段,然后逐一选择需要保留的10个字段(date、author_name、title、platform、likes、favorites、shares、coins、views、url),将其移动到保留列表中,其余字段(如 source_file、推荐数量、喜欢数量、赞同数量等)自动被剔除。打开新
本文分析了企业AI落地中的常见困境——当前AI工具多停留在简单问答,无法真正执行复杂业务操作。文章提出企业需要的是具备业务理解和主动执行能力的AI数字员工,并从四个技术维度(任务闭环能力、数据安全、零代码易用性、架构扩展性)对比了三种技术路线的差异。重点介绍了沈管家AI数字员工的技术实现,包括意图识别、DAG任务编排和连接器矩阵等核心组件,并提供了选型评估框架和决策流程图,帮助企业根据业务场景、数
本期推荐的是2024年发表在(IF:7.2)的一篇文章,文章题目为:利用TCGA数据集进行乳腺癌分期的综合生物信息学和机器学习分析该文基于TCGA乳腺癌(BRCA)数据库,结合生物信息学分析与机器学习方法,对乳腺癌发生发展的关键分子机制及临床分期进行了系统研究。作者首先筛选获得差异表达基因(DEGs),并通过GO、KEGG及蛋白互作网络(PPI)分析,鉴定出等关键Hub基因,这些基因主要参与细胞骨
2026 Vibe Coding全景指南:工具选型与工程化实践 本文系统梳理了2026年AI编程工具格局与工程实践。当前市场形成四极格局: 工具对比 Cursor:AI原生IDE,Tab补全体验最佳($20/月) Claude Code:终端CLI Agent,百万token上下文处理最强($20+/月) GitHub Copilot:跨IDE插件,团队集成最优($10/月) Windsurf:性
摘要 本实验基于预处理后的自媒体数据集,利用助睿ETL工具开展特征工程构建工作。主要内容包括:1)作品维度特征迭代,计算综合互动总量指标并提取5类标题特征标签,更新明细数据表;2)关键词维度聚合统计,分析不同标题关键词的传播效果。实验采用零代码可视化操作,通过JavaScript组件实现文本特征标注,运用计算器组件完成衍生指标计算,最终构建双层特征体系。该工作为后续数据分析提供了标准化的特征支撑,
标准自注意力的 $O(n^2)$ 复杂度源于 $QK^T$ 矩阵乘法的全局计算,缩放因子 $1/\sqrt{d_k}$ 的数学动机是稳定 softmax 梯度。Flash Attention 通过分块计算将显存复杂度降至 $O(n)$ 且不损失精度,是目前最实用的工程优化方案。稀疏注意力和线性注意力以近似精度换取计算效率,适用于对长距离依赖精度不敏感的场景。落地路线建议:第一步,在现有 Trans
打通样本处理、模型训练、监控对接全流程,帮助各类园区构建自主可控的智能预警能力,推动安防管理从人工被动巡检,转向AI主动全天候风险预警的现代化管理新模式。
本文介绍了使用助睿ETL平台进行多种文件数据抽取的实验过程。实验针对CSV、TXT和Excel三种常见文件格式,通过零代码可视化操作完成数据读取、字段筛选、数据加工与结果导出。实验环境采用云端在线实训平台,无需本地部署,通过助睿ETL数据集成模块实现全流程操作。实验内容包括:1)CSV文件的项目绩效数据处理;2)TXT文件的足球赛事数据解析与筛选;3)Excel文件的购房者信息预处理。实验结果表明
2. 标题背景:短标题`https://gzu-edu-quality-max-studio.oss-cn-chengdu.aliyuncs.com/public-material/title-bg-short.png`,长标题`https://gzu-edu-quality-max-studio.oss-cn-chengdu.aliyuncs.com/public-material/title-
利用极简的 JavaScript 映射(Map)逻辑,将数据按需分配: 分支1(给柱状图):return data.map(item => ({x: item.x, y: item.y1}))分支2(给饼图):return data.map(item => ({name: item.x, value: item.y2}))最后,将这三个分支的输出点,分别连上对应的图表节点“导入数据接口”,数据绑定
本文介绍了基于助睿Max数据大屏可视化平台完成浏览器市场分析动态数据大屏的完整实验流程。实验通过蓝图编辑器工具,实现从MySQL数据库数据源配置、SQL查询、并行数据处理到图表绑定的全链路操作,将静态大屏升级为实时数据展示系统。关键步骤包括:创建私有数据库连接、组件导出至蓝图编辑器、配置全局触发节点、分模块实现数据绑定(市场格局、数据概览等六大图表模块),最终完成大屏预览与发布。实验目标为掌握零代
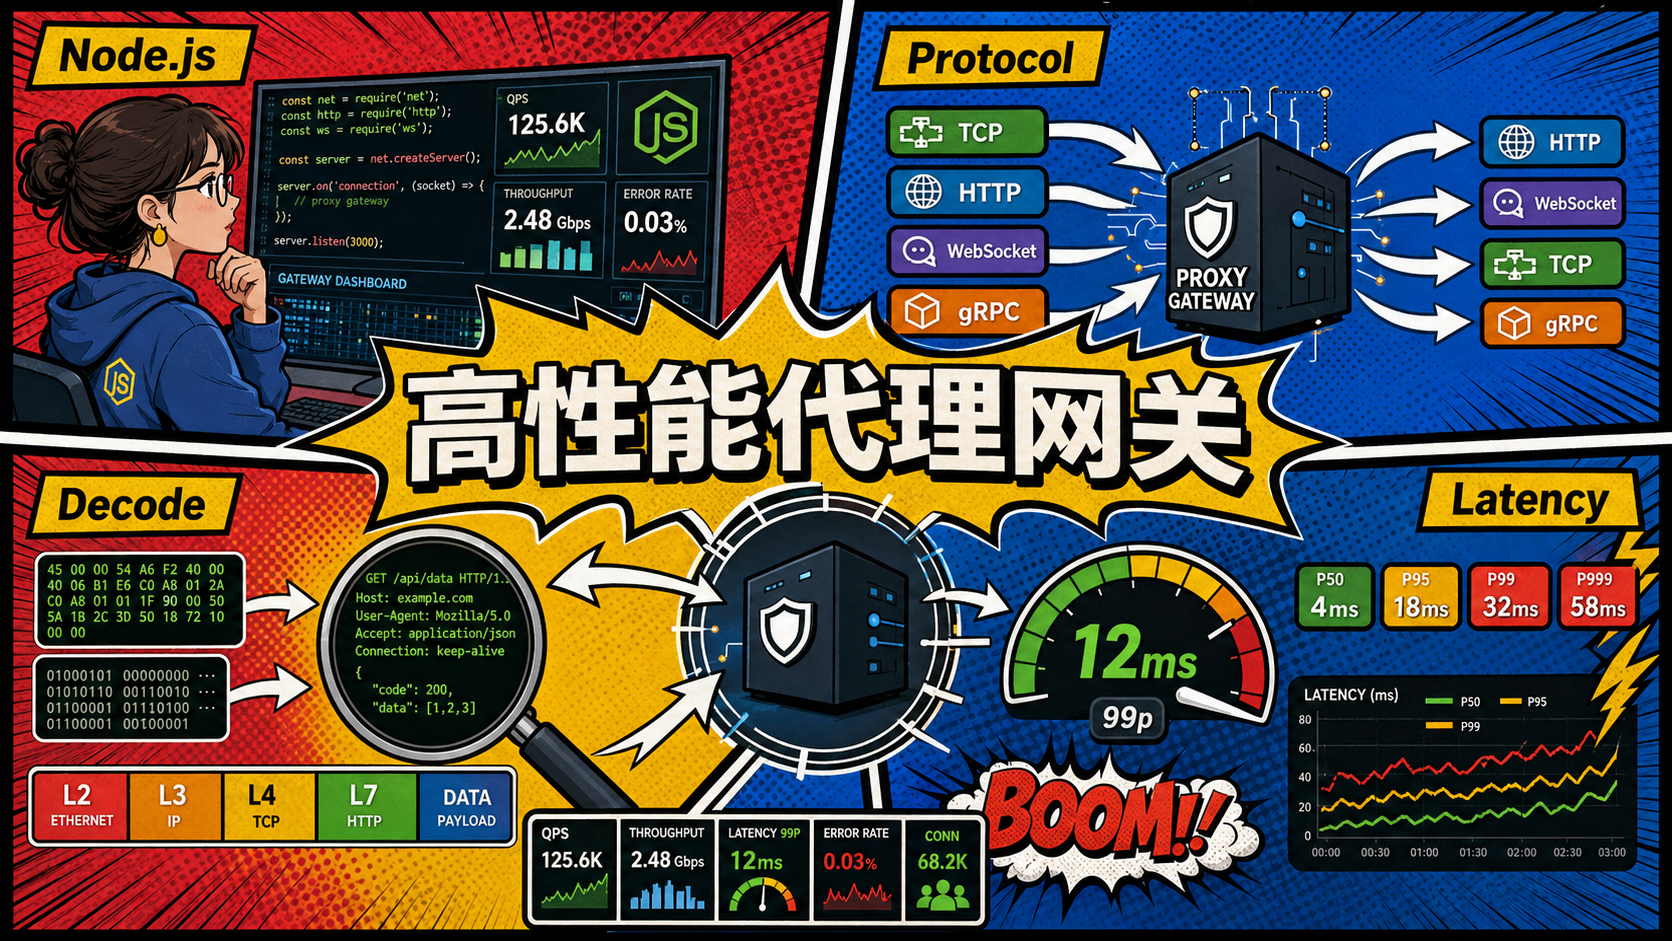
跨端协议的转化与动态解包是保障全物理终端产品能平滑接入云原生微服务底座的坚实保障。采用 Node.js Reactor 事件循环模式处理网络 I/O、利用堆外内存 Buffer.subarray() 替代多余内存拷贝进行包解析、并利用 Stream 的背压传导,能够平滑地支撑起跨端高频网络数据流。合理调整 Node.js 的 V8 内存限制:在启动网关容器时,通过注入环境变量调大老生代堆上限,给
通过本次完整的浏览器日志 ETL+BI 可视化实验,我熟练掌握了助睿零代码 ETL 平台从原始半结构化日志到结构化数据表的全流程处理:学会正则文本拆分、多规则数据过滤、自定义衍生指标、批量数据入库;同时掌握 BI 数据集搭建、多类型统计图表、业务仪表盘制作方法,理解了从原始数据落地市场画像分析的完整业务逻辑,明白了数据清洗环节对后续数据分析准确性的关键作用。